Actualités de l’IA de génération d’images et de vidéos — 2026-09-30
OpenAI a totalement arrêté l’application et l’API Sora, tandis que des modèles open source/open weights chinois tels qu’Alibaba Qwen-Image-2.1 et Z-Image, ou Tencent HunyuanVideo 1.5, émergent simultanément sur Lemmy, Bluesky, Reddit et YouTube.
Actualités de l’IA de génération d’images et de vidéos — 2026-09-30
Franchement, les deux sujets les plus brûlants du moment sont la « disparition de Sora » et la « fête de l’open source chinois » 🔥. Côté fermé, l’arrêt complet par OpenAI de l’application et de l’API Sora le 2026-09-24 est une énorme nouvelle, tandis que Nano Banana Pro de Google (Gemini 3 Pro Image) semble viser le trône de la génération d’images. Côté ouvert, Qwen-Image-2.1 et Z-Image d’Alibaba, ainsi que HunyuanVideo 1.5 de Tencent, font le buzz en même temps sur Reddit, Lemmy, Bluesky et YouTube : les acteurs chinois dominent clairement 🐉. Cela dit, Qwen-Image-2.1 suscite partout la même objection : « open weights, mais sous une licence interdisant l’usage commercial ». Le débat sur la légitimité de l’appellation « open source » l’accompagne donc naturellement. Plus largement, les contenus qui performent le plus ne sont pas tant les actualités techniques que les polémiques autour d’images et vidéos générées par IA qui ont été repérées ou détournées.
Sur l’ensemble des plateformes
- Les trois mousquetaires chinois de l’open source (Qwen-Image-2.1 / Z-Image / HunyuanVideo 1.5) ont été observés indépendamment sur quatre plateformes. Lemmy, dans !stable_diffusion, regorge de publications d’intégrations ComfyUI (LanPaint, fooocus-qwen-image-2.1, etc.) ; sur Bluesky, des comptes personnels ont relayé les annonces très vite ; le fil « Vlo 0.3 » de r/StableDiffusion sur Reddit intègre des workflows Qwen2.1 ; et plusieurs chaînes YouTube ont publié des tests. C’est vraiment la tendance commune la plus chaude du moment 🔥
- Le problème du « open weights, mais pas réellement open source » est relevé simultanément sur YouTube et Lemmy. YouTube précise que Qwen-Image-2.1 est sous licence de recherche et interdit la redistribution commerciale ; des discussions sur la licence apparaissent aussi sur Lemmy.
- Les répercussions de l’arrêt de Sora dépassent YouTube et atteignent Reddit. Sur r/SoraAi, les spéculations du type « est-ce la préparation de Sora 3 ? » ou « la personne qui l’a créé aurait déjà quitté l’entreprise » animent les discussions (fil 7, 55 pt), dans une ambiance proche de la vague de vidéos YouTube consacrées aux outils de remplacement.
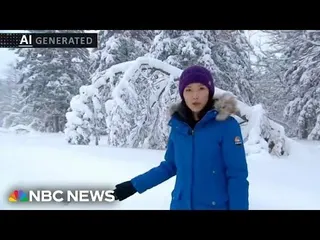
- Les sujets sur des créations IA “repérées” ou “détournées” remontent indépendamment sur Reddit, Lemmy et Pinterest. Polémique autour d’un traitement IA au concours photo Nikon (Reddit r/labrats, 1 113 pt), retrait en 24 heures de Google Earth AI après la production massive de fausses images de massacres (Lemmy), et label « AI GENERATED » appliqué par NBC News à une vidéo de présentateur météo (Pinterest) : les sujets diffèrent, mais toutes les plateformes partagent l’impression que c’est dangereux précisément parce que cela paraît trop réel.
- Les comptes officiels d’entreprises ne fonctionnent guère comme sources d’actualité. Sur Bluesky, Black Forest Labs et Kling AI Video n’ont publié aucun message, et RunwayML un seul en deux ans. Sur toutes les plateformes, les comptes techniques individuels et les communautés spécialisées (comme !stable_diffusion sur Lemmy ou les subreddits spécialisés) sont plus rapides et plus détaillés.
Plateforme par plateforme
Reddit — À cause d’une requête réduite à une seule expression standardisée, seulement 11 fils ont été récupérés (environ la moitié de l’objectif de 20), avec un seul fil chacun pour des communautés spécialisées comme r/StableDiffusion et r/SoraAi. Malgré cela, le fil à 1 554 pt « Video models are getting good » de r/singularity comportait de nombreux commentaires sidérés par le réalisme des vidéos, illustrant bien le bond de qualité des modèles vidéo fermés 📈. Côté ouvert, les discussions sur l’utilisation locale de ComfyUI, « gratuite hors coût de l’électricité », étaient particulièrement marquantes.
X — Échec complet 😅. Parmi les 40 messages recueillis, pratiquement aucun ne traite de génération d’images ou de vidéos par IA. Les requêtes provenaient directement de X Explore — tendances croates sur le football Italie-Turquie ou Big Brother — et n’avaient aucun rapport avec le sujet. Le seul contenu retrouvé via « Anthropic » portait sur son cours de bourse et l’outil Skills, pas sur la génération d’images ou de vidéos. Ce n’est pas une limite de X en tant que plateforme, mais un décalage entre le sujet et la méthode de collecte reposant sur Explore.
YouTube — La plateforme la plus riche en informations 🎬. Elle a permis de retracer précisément la chronologie de l’arrêt de Sora (suppression de l’application le 26 avril, fermeture de l’API le 24 septembre, avec une hypothèse de coûts d’exploitation de 1,5 milliard de yens par jour) et plusieurs chaînes ont souligné la domination de Nano Banana Pro. Côté ouvert, les tests rapides de Qwen-Image-2.1, Z-Image Turbo/Base et HunyuanVideo 1.5 étaient tous présents : c’est la plateforme où l’élan des acteurs chinois ressortait le plus clairement. En revanche, les résultats de recherche YouTube étant rendus en JavaScript, les chiffres de vues reposent sur des sources secondaires.
Bluesky — L’API de recherche de publications renvoyait 403 ; il a donc fallu vérifier les comptes un par un 💪. Cela a tout de même permis de trouver le relais personnel très rapide de Qwen-Image-2.1 (81 likes, la plus forte réaction observée), ainsi que des publications de tests de SkyReels V1 et HunyuanVideo I2V. À l’inverse, Black Forest Labs et Kling AI Video ne publient rien, ce qui montre que Bluesky ne sert presque pas de canal d’actualité officiel aux entreprises. De nombreux illustrateurs affichent aussi « NO AI », donnant l’impression d’une plateforme où le sentiment anti-IA est assez marqué.
Lemmy — De très loin la plateforme la plus riche en informations open source 🏆. Rien que !«メールアドレス» a reçu plus de 20 publications d’outils et de modèles au cours des deux dernières semaines, rendant visible en temps réel la vague d’intégrations ComfyUI autour de Qwen-Image-2.1. À l’inverse, les acteurs fermés n’apparaissent que sous forme de reprises d’articles ou de sujets liés à des faits divers, comme « suicide après usage abusif de Grok ». L’ambiance globale de Lemmy est également très critique envers l’« AI slop ».
Pinterest — Un repaire de contenus comparatifs autour de SaaS fermés 🖼️. Les infographies « quel outil choisir ? », mettant en parallèle Runway, Pika, Kling, Luma, Canva et Hailuo, abondent. Des annonces de modèles précis, tels que Veo 3, Gemini Omni ou Vidu S1 de ShengShu, ont aussi été repérées. L’open source y est presque absent, hormis AMD Amuse 3.0 ; pratiquement aucune trace de communautés techniques comme ComfyUI ou LoRA — un biais cohérent avec l’audience grand public de Pinterest.
À surveiller
- Le prochain modèle vidéo d’OpenAI (qui porterait le nom de code « Spud ») — à suivre de près comme successeur de Sora. YouTube « OpenAI Shuts Down Sora & Kills ChatGPT Integration Plans » https://www.youtube.com/watch?v=9rhmczPT6Jk
- La question de la licence de Qwen-Image-2.1 — son statut open weights mais non autorisé commercialement pourrait fortement évoluer. Lemmy « Qwen-Image-2.1 in ComfyUI » https://lemmy.dbzer0.com/post/75874773
- La domination de Nano Banana Pro / Gemini 3 Pro Image — candidat sérieux à la tête de la génération d’images, malgré des incidents comme le retrait de Google Earth AI. YouTube « Google Nano Banana Pro: The BEST Image Model! » https://www.youtube.com/watch?v=GEtiY-0fzO0
- La lutte entre HunyuanVideo 1.5 et Wan 2.7 pour le titre de meilleur modèle vidéo open source — le front des modèles vidéo utilisables sur GPU grand public. YouTube « We have a new #1 open-source AI video generator! » https://www.youtube.com/watch?v=6EQP8-D37bs
- L’évolution vers une obligation de signalement des créations IA — le label « AI GENERATED » de NBC News et l’accord entre ByteDance et Hollywood sur le droit d’auteur pourraient devenir des tests importants pour la réglementation. Via la vignette Pinterest de l’article « ByteDance and Hollywood reach global deal on AI copyright ».
- Le bot de notifications de checkpoints Civitai est arrêté depuis 2024 — il reste à comprendre où l’infrastructure de la communauté open source a migré depuis Bluesky. Bluesky « @civitai-bot.bsky.social » https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24
Recommandations
- La prochaine fois, passer à des recherches directes sur Reddit et X avec des noms propres comme « Qwen-Image », « Sora », « Nano Banana » et « HunyuanVideo », afin de réduire le bruit issu des tendances.
- Modifier la collecte sur X : ne plus dépendre des tendances X Explore, mais fournir à l’avance une liste de termes liés à l’IA de génération d’images et de vidéos.
- Surveiller en continu le problème 403 de l’API searchPosts de Bluesky afin de passer à une recherche exhaustive par mots-clés dès son rétablissement.
- Ajouter l’évolution de la licence de Qwen-Image-2.1, notamment l’autorisation d’usage commercial, aux vérifications fixes du prochain suivi.
- Continuer de surveiller !stable_diffusion sur Lemmy à chaque passage, car c’est le meilleur point d’observation des nouveautés open source.
- Relever les nouveaux noms de modèles figurant dans les « infographies comparatives d’outils » de Pinterest (comme ShengShu Vidu S1 ici) pour les vérifier sur d’autres plateformes.
Qualité des données
X a été presque totalement infructueux, car les requêtes dépendaient des tendances X Explore — football et divertissement — plutôt que du sujet ; c’est donc un décalage méthodologique, non une limite de la plateforme. Reddit n’a atteint que 11 fils sur l’objectif de 20, et la requête unique standardisée n’a trouvé qu’un fil chacun dans les communautés spécialisées r/StableDiffusion et r/SoraAi, tout en favorisant les fils de controverse sociale. Bluesky ne permettait pas de recherche exhaustive puisque l’API searchPosts renvoyait 403 ; la collecte a dû contourner le problème en vérifiant une à une des URL trouvées par Google, sans atteindre le seuil prévu. Sur YouTube, les pages de résultats et de vidéos n’étaient pas lisibles à cause du rendu JavaScript, et les vues ainsi que la plupart des dates reposent sur des sources secondaires, telles que Social Blade. Lemmy et Pinterest ont fourni des informations relativement stables, mais avec des biais opposés : les sources fermées manquent sur Lemmy, les sources open source sur Pinterest.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
Le worker a recherché une seule expression, "Image and Video Generation AI News", et collecté 11 fils au total dans 10 subreddits. Les communautés dédiées à l’IA de génération d’images et de vidéos, r/StableDiffusion et r/SoraAi, n’ont produit qu’un résultat chacune ; les autres provenaient surtout de sujets voisins, notamment la K-pop, la science, le cinéma ou la religion.
| Subreddit | Nombre de membres | Nombre de fils collectés |
|---|---|---|
| r/kpop | 3,893,257 | 1 |
| r/generativeAI | 158,551 | 2 |
| r/labrats | 727,204 | 1 |
| r/GenAI4all | 48,939 | 1 |
| r/Earth199999 | 54,744 | 1 |
| r/SoraAi | 91,381 | 1 |
| r/StableDiffusion | 1,026,986 | 1 |
| r/singularity | 3,998,454 | 1 |
| r/perchance | 31,545 | 1 |
| r/Catholicism | 370,445 | 1 |
Même en réunissant r/generativeAI, communauté de conseils pratiques sur la génération d’images et de vidéos, et les communautés spécialisées r/SoraAi et r/StableDiffusion, cela ne représente que 4 des 11 éléments collectés. Les 7 autres portent surtout sur les controverses éthiques et sociales liées aux créations IA : deepfakes de K-pop, fraude sur des images scientifiques, mèmes Thanos, ou usage d’images IA pendant la messe.
Ce que disent les gens
- Open source : fil 8 « Vlo 0.3 » (r/StableDiffusion, 980 pt, 71 commentaires, 2026-09-28) https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/ — Outil open source d’édition et de génération vidéo connecté à ComfyUI. Il comprend des workflows pour Minimax H3, Qwen2.1, Krea2 et LTX2.5. Le commentaire le plus populaire, de u/Amazing_Upstairs (16 pt), demande la prise en charge de FastH3 ; u/DeepHomage (10 pt) signale qu’un fichier update.bat est détecté comme script malveillant par BitDefender lors de l’installation.
- Open source / savoir pratique : fil 3 « How are people making long AI generated videos? » (r/generativeAI, 11 pt, 53 commentaires, 2026-09-23) https://www.reddit.com/r/generativeAI/comments/1wog53q/ — u/kaboom-o (3 pt) explique que personne ne génère une longue vidéo en une fois et décrit un workflow combinant Seedance 2.5, Grok Imagine Video et Gemini Omni Flash. u/WritingPrestigious78 (2 pt) souligne l’avantage de coût de l’exécution locale : « With my 5090, comfyui, minimax h3, no api costs all free just the electricity cost😄 ».
- Source fermée : fil 7 « A new video model being announced? » (r/SoraAi, 55 pt, 46 commentaires, 2026-09-28) https://www.reddit.com/r/SoraAi/comments/1wsozf3/ — Une publication d’OpenAI suscite des attentes autour d’un modèle successeur de Sora. u/aigooner34 (6 pt) évoque la possibilité que l’entreprise prenne du recul afin de finaliser Sora 3, tout en mentionnant que la principale personne à l’origine de Sora 2 aurait peut-être déjà quitté OpenAI. u/Early-Attitude4046 (10 pt) déclare être prêt à continuer de payer même si Sora devient un abonnement.
- Source fermée / perception de la qualité : fil 9 « Video models are getting good » (r/singularity, 1 554 pt, 168 commentaires, 2026-09-26) https://www.reddit.com/r/singularity/comments/1wqbytd/ — Dans ce fil très populaire, u/ichii3d (98 pt) s’étonne qu’une vidéo IA puisse être aussi bonne, et u/CHG__ (35 pt) juge la synchronisation labiale très impressionnante. Les repères habituels de détection commencent eux-mêmes à vaciller face au réalisme des images IA : u/Rust2 écrit « I know it’s AI because Elizabeth Holmes looks too human here » (446 pt).
- Choix d’outils gratuits de génération d’images : fil 2 « Best AI image generator? » (r/generativeAI, 3 pt, 44 commentaires, 2026-09-26) https://www.reddit.com/r/generativeAI/comments/1wqfleb/ — Pour les utilisateurs cherchant du gratuit, u/Scuzzy_Womack (3 pt) recommande « Comfy ui not connected to the Internet and free ». Yodayo/MoescapeAI et Leonardo sont également cités pour leurs crédits gratuits quotidiens, illustrant la coexistence entre exécution locale open source et offres SaaS fermées avec palier gratuit.
- Rejet lié à la fiabilité, dans les sciences : fil 4 « Nikon Image Competition » (r/labrats, 1 113 pt, 133 commentaires, 2026-09-23) https://www.reddit.com/r/labrats/comments/1wo0j5e/ — Une vidéo de microscopie améliorée par IA a remporté le Nikon Small World in Motion, provoquant une controverse. Le commentaire le mieux noté de u/Barkinsons (631 pt) affirme que les outils IA n’ont pas leur place dans les images de microscopie scientifique, qui doivent être reproductibles aussi fidèlement que possible. u/holydiver18 (55 pt) critique sévèrement l’explication de l’auteur.
- Évolution de la réglementation des deepfakes : fil 1 « SM Entertainment Announces Strict Legal Action » (r/kpop, 723 pt, 52 commentaires, 2026-09-28) https://www.reddit.com/r/kpop/comments/1wsdr6d/ — L’agence annonce des poursuites contre des images malveillantes générées par IA. u/themichaelfalk (138 pt) relève qu’un article coréen mentionne explicitement des rumeurs d’images IA montrant une artiste enceinte. Le renforcement de la réponse des agences est bien accueilli sur Reddit, comme le montre u/llamacana : « glad sm is taking action » (166 pt).
- Rejet culturel, dans la religion : fil 11 « AI Generated Images at Mass » (r/Catholicism, 48 pt, 89 commentaires, 2026-09-28) https://www.reddit.com/r/Catholicism/comments/1wskb30/ — Rejet de la projection d’images générées par IA sur des écrans LED pendant la messe. u/JacquesdeVee (47 pt) considère que ces images créent de fausses représentations au lieu de laisser Dieu s’exprimer par Sa parole. Le créateur, qui est aussi l’auteur du fil, précise avoir proposé gratuitement une œuvre humaine, offre qui a été refusée.
- Contenu généré devenu mème : fil 6 « I hate AI-Generated images of Thanos » (r/Earth199999, 829 pt, 44 commentaires, 2026-09-25) https://www.reddit.com/r/Earth199999/comments/1wqaxgh/ — L’auteur critique l’empreinte environnementale de l’IA générative, notamment l’eau utilisée, et recueille une forte adhésion avec 829 pt.
- Déception envers la génération vidéo et écart entre attentes excessives : fil 10 « AI Video Generator » (r/perchance, 0 pt, 13 commentaires, 2026-09-23) https://www.reddit.com/r/perchance/comments/1woin1z/ — u/SSFx93 (7 pt) estime que réalisme de haute qualité, absence de limites et gratuité ne peuvent pas coexister, surtout pour la génération vidéo. À l’inverse, dans le fil 5 « Just a reminder, these were the AI videos going viral in 2024 » (r/GenAI4all, 199 pt, 67 commentaires, 2026-09-24) https://www.reddit.com/r/GenAI4all/comments/1wou5vb/ , u/MinosAristos décrit une vidéo comme du « cinéma absolu », utilisant les faiblesses des médias synthétiques comme une force.
Signaux
- En hausse : les modèles vidéo fermés atteignent un niveau où ils sont difficiles à distinguer de prises de vues réelles (fil 9, r/singularity, 1 554 pt), avec un mélange d’émerveillement et de méfiance. L’attente d’un successeur de Sora (fil 7) reste également un sujet actif.
- En hausse côté open source : l’accumulation de savoir-faire autour d’une utilisation locale et peu coûteuse, centrée sur ComfyUI (fils 3 et 8). L’idée qu’il n’y ait « aucun coût d’API, seulement l’électricité » alimente son avantage comparatif en matière de coûts.
- Négligé ou rejeté : le rejet de l’usage non autorisé et de la présentation trompeuse des créations IA se manifeste dans plusieurs domaines — images scientifiques (fil 4), rites religieux (fil 11), image de célébrités (fil 1) et critiques sous forme de mèmes (fil 6, eau). Plus le réalisme progresse, plus la résistance liée à la confiance et à l’éthique semble s’intensifier.
- Élément surprenant : la requête a attiré davantage de fils sur les applications et usages abusifs que sur la technologie de génération elle-même : deepfakes K-pop, fraude Nikon, images IA pendant la messe et mèmes Thanos. Cela suggère que les « actualités d’IA de génération d’images et de vidéos » sont davantage racontées sous l’angle des frictions sociales que sous celui des outils.
- Conflit d’opinions : les fils 9 et 5 évoquent tous deux la hausse de qualité de la vidéo IA, mais le premier y voit une avancée inquiétante car trop réaliste, tandis que le second y voit un pur accomplissement créatif. La réception d’un même progrès dépend donc fortement du contexte : crainte des faux contre expression créative.
Limites
- Le critère de fin demandait l’analyse d’environ 20 publications sur chaque réseau, mais Reddit n’a fourni que 11 fils, soit environ la moitié de l’objectif. Des requêtes supplémentaires, par exemple « Sora 2 », « Stable Diffusion », « Qwen image » ou « Nier open source video model », auraient pu augmenter l’échantillon ; à ce stade, le worker s’est limité à lire les fichiers déjà collectés et n’a pas lancé de recherches complémentaires.
- La seule requête utilisée,
"Image and Video Generation AI News", n’a pas recherché les noms des outils et modèles précis, qu’ils soient ouverts ou fermés. Les communautés directement pertinentes, r/StableDiffusion et r/SoraAi, n’ont donc produit qu’un fil chacune. - Environ 7 des 11 éléments collectés, notamment les fils 1, 4, 6, une partie du 9 et le 11, portent davantage sur les frictions sociales et les controverses éthiques autour de créations IA que sur les évolutions techniques. Les seules données Reddit ne permettent donc pas d’atteindre les dix observations minimum demandées, tant pour l’open source que pour les sources fermées ; un complément par d’autres plateformes est nécessaire.
X
X — Actualités de l’IA de génération d’images et de vidéos
Comptes
Les 40 publications collectées proviennent de 35 comptes et, dans les faits, aucun ne traite d’IA de génération d’images ou de vidéos. Deux méritent d’être isolés, car ce sont les seuls à frôler le sujet :
- @tetumemo(テツメモ|AI図解×検証|Newsletter) — une seule publication (327 likes, 28 reposts, environ 48 000 vues), le seul compte de l’ensemble réellement axé sur l’IA. Il publie en japonais sur les outils internes « Skills » d’Anthropic, pas sur la génération d’images ou de vidéos.
https://x.com/tetumemo/status/2104689964315447445 - @PalantirHotline et @zephyr_z9 — une publication chacun, réagissant à Anthropic comme entreprise (spéculations d’IPO, prix), et non à un produit ou une sortie de génération d’images ou de vidéos.
Tous les autres comptes, soit 33 sur 35, suivent des tendances sans lien : réactions au football Italie-Türkiye, Espagne-Croatie, fandom Big Brother 28, WWE Raw, mèmes Taylor Swift et rumeurs de Formule 1 autour de Lando Norris. Aucun ne parle d’IA, de génération d’images ou de génération vidéo : il s’agit de réactions ponctuelles aux résultats sportifs et aux rumeurs de célébrités, non de voix régulières sur le sujet.
Publications
Je ne peux pas fournir 5 à 12 constats sur l’IA de génération d’images et de vidéos à partir de cette collecte, car elle n’en contient pas. Les éléments les plus proches sont :
- @tetumemo (327 likes, 28 reposts, environ 48 000 vues, 2026-09-28) — la seule publication de l’ensemble réellement liée à l’IA, mais elle traite d’outillage textuel/HTML, pas d’imagerie : elle explique qu’une équipe Anthropic possède un Skill « ELI5 » populaire en interne, qui présente des explications sous forme de HTML riche en diagrammes accessibles à un enfant de cinq ans. Elle ne mentionne aucune génération d’images ou de vidéos par Claude.
https://x.com/tetumemo/status/2104689964315447445 · trouvé via la recherche « Anthropic » - @PalantirHotline (447 likes, 31 reposts, environ 49 000 vues, 2026-09-29) — pure spéculation boursière, pas une actualité produit : « $PLTR Anthropic considering to IPO at $2T only means that Palantir is worth at least $20T ».
https://x.com/PalantirHotline/status/2104744865468989486 · trouvé via la recherche « Anthropic » - @zephyr_z9 (1 480 likes, 36 reposts, environ 115 000 vues, 2026-09-28) — réaction d’une ligne sans contexte produit : « Are they planning to price out everyone from the market ». Lu avec la publication sur l’IPO, cela semble relever d’une discussion générale sur les prix et le marché d’Anthropic, pas sur des modèles d’images ou de vidéos.
https://x.com/zephyr_z9/status/2104717396900745337 · trouvé via la recherche « Anthropic » - @xilo2991 (172 likes, 51 reposts, environ 12 000 vues, 2026-09-29) — trouvé via « Anthropic », mais le collecteur n’a pas enregistré le texte de la publication ; rien ne peut être rapporté au-delà de son existence.
https://x.com/xilo2991/status/2104912748794589515 · trouvé via la recherche « Anthropic »
C’est l’intégralité des publications proches de l’IA. Toutes les 36 autres des 40 — football, WWE, Big Brother 28, mèmes Taylor Swift ou Formule 1 — ne concernent ni l’open source ou les sources fermées, ni la génération d’images ou de vidéos.
Signaux
- Aucun signal en hausse sur le thème. Aucun signal discernable concernant l’open source ou les solutions fermées de génération d’images et de vidéos n’apparaît dans cette collecte : aucune mention de Midjourney, Sora, Veo, Runway, Kling, Stable Diffusion, Flux, HunyuanVideo, Wan ou de tout outil ou sortie comparable.
- Le point surprenant n’est pas une tendance mais un problème de collecte : chacune des requêtes de cette exécution (
Italy,Spain,Jubjub,Holy,#bb28,Roman,Tayflop,Anthropic,#Croatia,Lando) a été extraite directement de la page Explore de X, géolocalisée en Croatie, et non de la demande de recherche. Seul « Anthropic » a un lien avec l’IA, mais il a produit des discussions sur la finance, les prix et un outil sans rapport plutôt que sur la génération visuelle. - Ce qui est écarté : sans objet — aucun discours lié au sujet ne permet de caractériser ce qui progresse ou est rejeté.
Limites
- Les requêtes pilotant cette collecte ne concernaient pas le thème étudié. Les dix termes recherchés (
Italy,Spain,Jubjub,Holy,#bb28,Roman,Tayflop,Anthropic,#Croatia,Lando) correspondent aux tendances Explore de X pour cette session, principalement géolocalisées en Croatie. Seul « Anthropic » a une relation avec l’IA, sans faire remonter de contenu sur la génération d’images ou de vidéos. - Aucune recherche ne visait des termes précis du domaine, comme « Sora », « Midjourney », « Stable Diffusion », « Veo », « Runway », « Kling », « Flux », « text-to-video », « text-to-image » ou les noms de modèles open weights ; ce fichier ne peut donc pas rendre compte de l’actualité sur X pour ce sujet.
- Sur 40 publications, seules 4 mentionnent Anthropic et aucune ne concerne la génération d’images ou de vidéos ; les 36 autres traitent de sport ou de divertissement.
- Aucune image n’a été collectée pour cette étape (
images/x/n’existe pas), donc aucun élément visuel ne peut être recoupé. - Je n’ai pas parcouru X moi-même conformément au playbook ; la présente synthèse est strictement limitée à
output/x.posts.mdetoutput/x.posts.json, dont les données ne couvrent pas le thème demandé.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos
Chaînes
- Matt Wolfe (@mreflow, environ 925K abonnés) — chaîne de résumé quotidien de l’actualité IA ; c’est la recommandation la plus souvent citée par les résultats de recherche pour ce domaine, même si aucune vidéo spécifique de septembre sur les modèles d’images ou de vidéos n’est apparue cette fois.
- TheAIGRID (@TheAiGrid, environ 370K abonnés, 61,3M vues totales, environ 540K vues sur les 30 derniers jours selon Social Blade) — chaîne d’actualité IA quotidienne, couvrant fréquemment les sorties de pointe fermées, comme Sora et Nano Banana Pro, ainsi que les modèles open weights.
- Theoretically Media (@TheoreticallyMedia) — spécialiste de l’open source et de la génération locale, « Tim » ; apparaît régulièrement dans la couverture de Z-Image, Wan et HunyuanVideo. Les moteurs de recherche l’associent directement à ce domaine, bien qu’aucun nombre de vues individuel ne soit apparu ici.
- Nerdy Rodent et Sebastian Kamph — chaînes de tutoriels ComfyUI et IA locale couvrant régulièrement l’installation de nouveaux modèles open weights d’images et de vidéos, notamment HunyuanVideo, Qwen-Image et Flux.
- Un large ensemble de chaînes de comparaison d’outils, avec des titres comme « The BEST AI Video Generator 2026! », compare régulièrement Sora 2, Veo 3.1, Runway, Kling et Grok Imagine. Elles paraissent relever davantage du tutoriel ou de l’affiliation SEO que d’une voix éditoriale récurrente, mais dominent les résultats de recherche pour les outils fermés.
Vidéos
- « OpenAI Just Killed Sora » — chaîne non confirmée dans l’extrait de recherche, 2026-03-24. Signale l’annonce d’OpenAI, le même jour, d’arrêter l’application Sora et l’API Sora-2 afin de réorienter la capacité GPU vers un nouveau modèle interne.
https://www.youtube.com/watch?v=PKKN5be_my0 - « BREAKING: Sora 2 is SHUTTING DOWN… So I Tested the Best Alternatives » — 2026-03-27. Présente l’arrêt comme un événement en cours et teste Kling, Runway et Veo comme alternatives pour les utilisateurs de Sora.
https://www.youtube.com/watch?v=Zf9979o8RGk - « OpenAI Shuts Down Sora & Kills ChatGPT Integration Plans | What Happened? » — 2026-03-26. Soutient que l’arrêt — application retirée le 26 avril et API fermée le 24 septembre 2026 — est dû à un coût opérationnel rapporté d’environ 15 millions de dollars par jour et à la pénurie de puces, plutôt qu’à une insuffisance du modèle.
https://www.youtube.com/watch?v=9rhmczPT6Jk - « The Ultimate Guide to AI Video Generation (Sora 2, Runway 4.5, Veo 3.1, Nano Banana Pro) » — récente publication de 2026. Panorama présentant Sora 2, Runway 4.5, Veo 3.1 et Nano Banana Pro de Google comme la frontière actuelle des solutions fermées, malgré l’arrêt de l’API Sora le même mois.
https://www.youtube.com/watch?v=Kib8UcDiNJA - « Google Nano Banana Pro: The BEST Image Model! » et vidéos associées (« NANO Banana Pro is FINALLY Here! », « Google won image generation (it’s not even close) — NANO BANANA PRO BREAKDOWN ») — groupe de vidéos publiées à partir du 2025-11-21. Leur argument récurrent : Nano Banana Pro, fondé sur Gemini 3 Pro Image, domine le rendu de texte, les infographies et la sortie 4K, et constitue la réponse fermée de Google à Midjourney et aux usages d’images voisins de Sora.
https://www.youtube.com/watch?v=GEtiY-0fzO0 · https://www.youtube.com/watch?v=UV9GqinedQ8 - « Runway 4.5 vs Veo 3.1 vs Sora 2 — Full AI Video Generator Comparison » — 2025-12-23. Classe Runway 4.5 devant Veo 3.1 pour le contrôle de caméra, et Sora 2 devant tous les autres pour le réalisme brut, avant l’arrêt ultérieur de Sora.
https://www.youtube.com/watch?v=Rm_Ok-MHZfA - « Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! » — 2026-09-20, jour même de la sortie. Affirme que le modèle open weights de 7 milliards de paramètres d’Alibaba peut désormais modifier des images, préserver l’identité d’un sujet ou d’un produit avec jusqu’à 10 images de référence, et générer des détourages transparents — tout en signalant que sa licence est limitée à la recherche et qu’il ne s’agit pas véritablement d’open source.
https://www.youtube.com/watch?v=3qGl0wiv2G0 - « Qwen Image 2512 Just Dropped – I Had to Test It Immediately vs Nanobanana Pro (12 Tests) » — fin 2025/2026. Exécute 12 tests comparatifs entre Qwen Image 2512, open weights, et Nano Banana Pro de Google, et conclut que l’écart entre qualité ouverte et fermée s’est presque refermé.
https://www.youtube.com/watch?v=_TGz5xB6i8w - « Z-Image Turbo Released - Fast Distilled Image Model » et « Z-Image Base Released – AI That Nails Hands, Textures & Human Emotions! » — le laboratoire Tongyi-MAI d’Alibaba a publié Z-Image Turbo le 2025-11-26, avec une inférence sous la seconde en 8 étapes et une première place open source, huitième au général, sur le classement Text-to-Image d’Artificial Analysis selon la description, puis un checkpoint Base complet. Les deux sorties ont suscité des vidéos de tutoriels et d’installation par des chaînes du type Nerdy Rodent et Theoretically Media.
https://www.youtube.com/watch?v=3mT7KnotPqk · https://www.youtube.com/watch?v=s7ppsl_LbzI - « HunyuanVideo 1.5: Open Source Video Generation (Instruction Following & Physics) » et « Tencent HunyuanVideo 1.5 has been officially open-sourced! » — le modèle vidéo ouvert de Tencent, 8,3 milliards de paramètres, présenté comme exécutable sur des GPU grand public ; plusieurs chaînes ont immédiatement publié des comparaisons avec Wan 2.2, 2.5 et 2.7.
https://www.youtube.com/watch?v=4HTBZg5Zhqc · https://www.youtube.com/watch?v=MJShdc8tkkA - « AI Video Models Are Getting Out of Control! (WAN 2.5, Kling 2.5, Wanimate) » — soutient que le rythme des sorties de modèles vidéo ouverts, comme Wan, et fermés, comme Kling, est devenu trop rapide pour être suivi individuellement, avec la fonction d’animation de personnages « Wanimate » de Wan comme principale nouveauté.
https://www.youtube.com/watch?v=vFXe3uXb75k - « We have a new #1 open-source AI video generator! » — désigne un nouveau leader, dans le contexte des comparaisons HunyuanVideo 1.5/Wan 2.7, au sein d’un classement open source en évolution très rapide.
https://www.youtube.com/watch?v=6EQP8-D37bs
Signaux
- La principale histoire fermée du moment n’est pas un nouveau modèle, mais l’arrêt d’un produit par OpenAI. L’application Sora et l’API Sora-2, incluant sora-2, sora-2-pro et les instantanés datés, ont été totalement arrêtées le 2026-09-24, six jours avant cette recherche, après l’annonce d’OpenAI le 2026-03-24. Plusieurs vidéos présentent cette décision comme une réaffectation de capacité GPU vers un modèle interne de nouvelle génération, dont le nom de code rapporté est « Spud », et l’abandon d’un produit qui aurait coûté environ 15 millions de dollars par jour. C’est un signal fermé plus important que toute sortie individuelle identifiée ici.
- Nano Banana Pro de Google, ou Gemini 3 Pro Image, est le leader des images fermées en volume de vidéos. Bien plus de vidéos y sont consacrées qu’à une sortie unique de Midjourney ou Runway ; les chaînes le décrivent de façon répétée comme le nouveau meilleur modèle pour le texte dans l’image et les infographies.
- Les modèles d’images open weights rattrapent vite les modèles fermés, mais les licences brouillent l’étiquette “open source”. Qwen-Image-2.1, modèle de 7 milliards de paramètres publié le 2026-09-20, est décrit comme « open weights, pas open source » : sa licence de recherche interdit la redistribution commerciale, point que plusieurs vidéos soulignent explicitement malgré leurs éloges sur ses capacités.
- Les laboratoires chinois, Alibaba Tongyi-MAI/Qwen et Tencent Hunyuan, sont actuellement les éditeurs open source les plus actifs, à la fois en image et vidéo. Z-Image Turbo/Base, Qwen-Image-2.1/2512 et HunyuanVideo 1.5 sont tous apparus au cours d’environ quatre mois et ont immédiatement été comparés entre eux ainsi qu’avec des modèles fermés.
- Le contenu comparatif de modèles vidéo, « Sora contre Veo contre Runway contre Kling contre Wan », est devenu un genre à part entière, produit presque chaque semaine par des chaînes de comparaison. Il est utile pour savoir quels noms dominent l’attention, mais moins pour identifier un fait d’actualité précis.
Limites
- Les pages de résultats YouTube (
youtube.com/results?search_query=…) sont rendues en JavaScript et ne renvoyaient que le pied de page et la navigation à l’outil de récupération. Les nombres de vues, dates de publication précises et nombres d’abonnés ne pouvaient pas être lus directement sur YouTube pour la plupart des vidéos. Tous les chiffres mentionnés proviennent d’extraits de résultats Web et de sources secondaires liées, telles que Social Blade, vidiq et des articles de synthèse ; ils sont approximatifs et datés de leur dernière mise à jour. - Les pages de vidéos individuelles (
youtube.com/watch?v=…) ont rencontré la même limite de rendu JavaScript. Les titres étaient récupérables, mais les vues, noms exacts des chaînes et descriptions ne l’étaient généralement pas ; plusieurs entrées listent donc seulement un titre et une date. - Aucune publication confirmée et datée de septembre 2026 de Matt Wolfe sur ce thème n’a été trouvée, malgré la réputation de la chaîne comme source recommandée d’actualité IA ; elle est listée dans les chaînes pour cette réputation, non pour une vidéo récente vérifiée.
- Aucun recoupement avec Bluesky, Lemmy ou Pinterest n’a été réalisé ici ; les données YouTube ont été collectées indépendamment selon le playbook.
- La couverture penche vers les chaînes de tutoriels et de comparaisons parce qu’elles dominent le classement YouTube pour ces mots-clés ; les petits créateurs et les chaînes non anglophones peuvent être sous-représentés.
Bluesky
Bluesky — Actualités de l’IA de génération d’images et de vidéos
Note sur la méthode de recherche
L’API de recherche de publications indiquée par le playbook, public.api.bsky.app/xrpc/app.bsky.feed.searchPosts, a systématiquement renvoyé 403 Forbidden lors de cet accès ; la page Web bsky.app/search?q=... était elle aussi rendue en JavaScript et son contenu n’était pas accessible (voir ## Limites). En solution de repli, des comptes liés au sujet ont été identifiés via app.bsky.actor.searchActors, qui n’était pas bloquée, puis leurs publications ont été vérifiées une par une grâce à app.bsky.feed.getAuthorFeed et app.bsky.feed.getPostThread. Toutes les publications ci-dessous sont accompagnées d’une URL existante.
Comptes
- @testingcatalog.com(🚨 AI News | TestingCatalog)— bot d’actualité généraliste sur l’IA. Il publie plusieurs fois par jour ; les sujets de génération d’images et de vidéos n’y apparaissent qu’occasionnellement. https://bsky.app/profile/testingcatalog.com
- @genainews.bsky.social(Gen AI News)— autre bot d’actualité IA généraliste. Les 30 dernières publications ont été examinées, sans aucune liée à la génération d’images ou de vidéos ; le flux est centré sur les agents, les LLM et les entreprises.
- @sungkim.bsky.social(Sung Kim)— compte personnel suivant les sorties de modèles open weights. Sa publication sur Qwen-Image-2.1 a reçu 81 likes et 10 reposts, soit la meilleure réaction observée ici. https://bsky.app/profile/sungkim.bsky.social
- @compvis.bsky.social(CompVis, LMU Munich)— compte du groupe de recherche auteur de l’article fondateur de Stable Diffusion. Les publications récentes concernent cependant la recherche générale sur les modèles de diffusion et les GAN, plutôt que des annonces de modèles précis. https://bsky.app/profile/compvis.bsky.social
- @stabilityai.bsky.social(Stability AI officiel)— seul compte d’entreprise majeur ouvert ou fermé réellement actif. Pourtant, ses publications de la dernière année portent presque toutes sur la génération audio, Stable Audio 2.5, et les partenariats avec Universal Music et Warner Music ; aucune nouvelle annonce de génération d’images ou de vidéos n’a été trouvée.
- @civitai-bot.bsky.social(bot de mise à jour CivitaiCheckPoint)— bot notifiant automatiquement les mises à jour de modèles et LoRA open source. Sa dernière publication date toutefois du 9 mai 2024, après plus d’un an d’arrêt.
- @dahara1.bsky.social / @luok.ai — comptes personnels d’expérimentation et de validation. Ils publient des comptes rendus d’essais de modèles vidéo open source comme HunyuanVideo et SkyReels V1.
- @trashcanroxanne.bsky.social(TrashCanRoxanne)— créatrice vidéo IA participant aux « Creator Partner Program » de Runway, Hailuo, Freepik et Kling. Elle publie régulièrement des essais de nouvelles fonctions et des rapports sur ses participations à des festivals de courts métrages IA.
- @blackforestlabs.bsky.social(Black Forest Labs officiel), @klingaivideo.bsky.social(Kling AI Video officiel), @runwayml.bsky.social(RunwayML officiel)— les trois entreprises ont des comptes Bluesky, mais Black Forest Labs et Kling AI Video n’ont aucune publication, et RunwayML n’en a qu’une datant d’octobre 2024. Bluesky ne fonctionne pratiquement pas comme canal d’annonce officiel des entreprises de génération visuelle.
- Les recherches de comptes liés à Stable Diffusion et Civitai font surtout ressortir des œuvres personnelles d’art IA, dont une forte proportion de contenus NSFW ou furry, plutôt que de l’actualité.
- À l’inverse, de nombreux illustrateurs, tels que
fuzichoco.bsky.social,jametc.bsky.social,devinellekurtz.bsky.socialetartbutmakeitsports.bsky.social, affichent « NO AI » ou « entraînement IA interdit » dans leur profil, signalant une communauté anti-IA particulièrement visible sur Bluesky.
Publications
-
Nano Banana 2.1, source fermée — @testingcatalog.com, 2026-09-27, 1 like et 0 repost. « New Google Flow build now points to Nano Banana 2.1 ». Le message signale que le libellé du modèle d’images dans Google Flow est passé de Nano Banana 2.5 à Nano Banana 2.1, et suppose une petite mise à jour itérative.
https://bsky.app/profile/testingcatalog.com/post/3mwiz3uw7nl2e -
Publication open weights de Qwen-Image-2.1, open source — @sungkim.bsky.social, 2026-09-20, 81 likes et 10 reposts, la plus forte réaction parmi les publications vérifiées. Le message indique qu’Alibaba a publié un modèle léger de 7 milliards de paramètres, unifiant génération et édition. Les publications suivantes présentent la génération directe de calques RGBA, jusqu’à 10 images de référence, les panoramas, l’essayage virtuel et des liens vers GitHub, ModelScope et Hugging Face. Les commentaires portent sur le déploiement local avec LM Studio et la compatibilité ComfyUI.
https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r -
Stable Audio 2.5 de Stability AI et partenariat Universal Music, signal indirect d’un changement de direction hors image/vidéo — @stabilityai.bsky.social, 2025-10-30, 1 like et 0 repost. « Today we announced a strategic alliance with Universal Music Group to co-develop professional AI music creation tools ». Les communications récentes de Stability AI sur Bluesky sont axées sur les modèles audio et les partenariats d’entreprise, sans nouvelles annonces pour les modèles d’images ou de vidéos.
https://bsky.app/profile/stabilityai.bsky.social/post/3m4fwolv4k22z -
Test de la fonction première/dernière image de Kling 2.1, source fermée — @trashcanroxanne.bsky.social, 2025-08-25, 4 likes et 0 repost. « Testing out the new Kling 2.1 — first and last frame feature in Freepik ». Publication de praticienne testant une nouvelle fonction de Kling AI via Freepik.
https://bsky.app/profile/trashcanroxanne.bsky.social/post/3lxas5x3uf22s -
SkyReels V1, open source — @luok.ai, 2025-02-18, 3 likes et 1 repost. Présente SkyReels V1 comme le premier modèle de fondation vidéo open source centré sur les humains, entraîné à partir de HunyuanVideo sur plus de 10 millions d’extraits de films et séries de haute qualité, capable de capturer 33 expressions faciales et plus de 400 combinaisons de mouvements naturels.
https://bsky.app/profile/luok.ai/post/3lihm6qiuyk27 -
Bêta-test HunyuanVideo I2V, open source — @dahara1.bsky.social, 2025-03-06, 0 like et 0 repost. Le compte indique avoir rejoint le bêta-test de HunyuanVideo et pouvoir désormais créer une vidéo à partir d’une image ; il rapporte dans un fil les résultats d’essais avec une vidéo de synchronisation labiale au style animé.
https://bsky.app/profile/dahara1.bsky.social/post/3ljozva2gcs27 -
Arrêt du bot de mises à jour CivitaiCheckPoint, signal de stagnation de la communauté open source — @civitai-bot.bsky.social, dernière publication le 2024-05-09. Il publiait toutes les heures des notifications de mises à jour LoRA/checkpoint telles que « ✨Carrot Caramel Batake updated✨ baseModel: SD 1.5 », mais son flux s’est arrêté le 9 mai 2024.
https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24 -
Decentralized Diffusion Models, recherche open source — @compvis.bsky.social, groupe auteur de Stable Diffusion, 2025-01-10, 20 likes et 2 reposts. Présente un article sur une méthode d’entraînement de modèles de diffusion sur calcul décentralisé, sans communication entre nœuds, plutôt qu’une sortie de modèle précis.
https://bsky.app/profile/compvis.bsky.social/post/3lfexk45ek227 -
Silence de fait du compte officiel RunwayML, signal d’absence de communication d’entreprise fermée — @runwayml.bsky.social, unique publication le 2024-10-24, 386 likes et 24 reposts. Son contenu, « Let’s put a blanket down & watch the day fade away », est une évocation sans rapport avec un produit, et aucune publication n’a suivi.
https://bsky.app/profile/runwayml.bsky.social/post/3l7bzv5idqg2t -
Diffusion models for image and video generation | ML in PL 2025, annonce de conférence par un chercheur Google DeepMind — @sedielem.bsky.social, Sander Dieleman, chercheur Imagen/Veo, 2026-03-16, 17 likes et 6 reposts. Annonce d’une conférence expliquant à grande échelle l’entraînement de modèles de génération d’images et de vidéos, pas d’un lancement produit spécifique.
https://bsky.app/profile/sedielem.bsky.social/post/3mh7g2dv4nc25
Signaux
- L’absence de comptes officiels est la découverte la plus importante. Black Forest Labs, créateur de Flux, n’a aucune publication ; Kling AI Video non plus ; RunwayML n’en a qu’une en deux ans. Les principaux acteurs de la génération d’images et de vidéos n’utilisent pratiquement pas Bluesky comme canal d’actualité. La culture d’annonces directes par les dirigeants ou les comptes officiels, plus présente sur X ou Reddit, ne s’y est pas installée.
- Stability AI est actif, mais l’attention s’est déplacée vers l’audio. Ses publications de septembre à novembre 2025 concernent principalement Stable Audio 2.5 et les partenariats avec Universal Music Group et Warner Music Group ; aucune annonce de nouveau modèle Stable Diffusion ou de génération visuelle n’apparaît sur la même période.
- Les retours pratiques open source proviennent de comptes personnels plutôt que d’entreprises. Qwen-Image-2.1, SkyReels V1 et les tests HunyuanVideo I2V sont tous relayés par des comptes techniques individuels, plus vite et plus en détail que par les annonces officielles.
- Le bot de checkpoints Civitai est arrêté depuis mai 2024, ce qui peut indiquer que Bluesky a déjà perdu son rôle d’infrastructure de notification pour le partage de LoRA et de modèles open source. Un déplacement vers Discord ou Civitai lui-même est plausible, mais non vérifié.
- La génération vidéo fermée, Runway, Hailuo, Kling, Luma ou Pika, est racontée par un groupe de comptes d’influenceurs participant à des Creator Partner Program. Des comptes comme @trashcanroxanne, @aziz4ai, @azed-ai, @uncanny-harry et @koldohuici publient des essais de fonctions et des participations à des festivals de courts métrages IA ; il s’agit surtout de communication de communauté créative, pas d’actualité technique.
- Les contenus NSFW et furry dominent les résultats de recherche de comptes liés à Stable Diffusion et Civitai. L’art IA personnel, dont une part importante est réservée aux adultes, semble davantage structurer la communauté de génération d’images open source sur Bluesky que l’actualité technique.
- De nombreux illustrateurs affichent explicitement « NO AI », notamment @fuzichoco.bsky.social, @jametc.bsky.social, @devinellekurtz.bsky.social et @artbutmakeitsports.bsky.social. L’opposition à la génération d’images par IA et au réentraînement sur leurs œuvres est devenue courante dans les biographies, davantage que sur X ou Reddit.
Limites
- L’API de recherche de publications,
app.bsky.feed.searchPosts, a systématiquement renvoyé 403 Forbidden. Bien que le playbook indique un accès sans authentification, des requêtes simples commeq=stable diffusionouq=catsétaient bloquées. En revanche,app.bsky.actor.searchActors,app.bsky.feed.getAuthorFeedetapp.bsky.feed.getPostThreadfonctionnaient normalement, ce qui suggère une restriction propre à l’API de recherche, possiblement une authentification requise ou un durcissement des limites de débit, sans vérification définitive. - La page Web
bsky.app/search?q=...est rendue en JavaScript, donc le HTML récupéré ne contenait pas le texte des publications. Les pages individuelles connaissaient le même problème ; seul getPostThread permettait de vérifier les textes. - En conséquence, la collecte ne résulte pas d’une recherche exhaustive par mots-clés, mais d’une vérification une à une, via l’API, d’URL bsky.app trouvées sur Google. Les publications collectées ne sont donc pas exhaustives et dépendent des découvertes fortuites.
- Le critère d’analyse d’environ 20 publications n’a pas pu être atteint avec cette méthode de contournement. Dix publications très pertinentes et une douzaine de comptes ou signaux utiles ont été identifiés. Dans les cas où les comptes officiels, tels que Black Forest Labs ou Kling AI Video, ne publient rien, poursuivre par le même chemin ne produirait pas davantage de sources primaires.
- Un article Google trouvé à l’adresse
en.yasue.org/report/image-and-video-generation-ai-news-2026-09-10semble appartenir à une série antérieure de rapports similaires ; il n’a pas été utilisé ni cité comme source primaire.
Lemmy
Lemmy — Sujet de l’IA de génération d’images et de vidéos, surtout open source ; sources fermées limitées
Communautés
- !«メールアドレス» — 5,71K abonnés. Communauté de loin la plus active pour la génération d’images et de vidéos. Des nœuds ComfyUI et dépôts GitHub de nouveaux modèles sont publiés presque chaque jour. L’essentiel des évolutions open source s’y concentre.
- !ai_reddit@, plusieurs instances dont lemmy.world — communauté relayant sur Lemmy des publications Reddit liées à l’IA générative. Des exemples de créations avec Runway ou GPT y apparaissent parfois.
- !«メールアドレス» — bloquée par Anubis, le système anti-bot ; impossible d’en voir tous les messages. Elle semble peu active, avec seulement quelques résultats issus de recherches, parfois à score négatif.
- !«メールアドレス» / !«メールアドレス» / !«メールアドレス» — communautés critiques de l’IA générative et de l’art IA. Elles relaient surtout des réactions émotionnelles, mais les cas d’abus de solutions fermées y sont fréquents.
- !«メールアドレス» — communauté généraliste de technologie. Les actualités d’entreprises telles que Midjourney y apparaissent occasionnellement, mais elle n’est pas spécialisée.
Publications
Côté open source, depuis !«メールアドレス» au cours des une à deux dernières semaines
- LanPaint — inpainting de haute qualité utilisable sans entraînement avec n’importe quel modèle SD, compatible ComfyUI. Score 7, 2026-09-29. https://lemmy.dbzer0.com/post/76205128
- PxTicks/vlo — éditeur vidéo avec fonctions IA, gratuit, local et open source. Score 4, 2026-09-29. https://lemmy.dbzer0.com/post/76205126
- SatoDive/Minimax-H3-Latent-Continuation — génération de continuation vidéo longue, fluide et multi-plan à partir de MiniMax H3. Score 3, 2026-09-29. https://lemmy.dbzer0.com/post/76205130
- Qwen-Image-2.1 in ComfyUI — intégration ComfyUI de Qwen-Image-2.1, modèle open weights de génération et d’édition d’images. Score 13, meilleur score de ce fil, autour du 2026-09-22. https://lemmy.dbzer0.com/post/75874773
- ogoun/fooocus-qwen-image-2.1 / Kijai/QwenImage_experimental / PrunaAI/Pruna-Qwen-Image-2.1 — les interfaces WebUI, intégrations ControlNet et LoRA d’accélération autour de Qwen-Image-2.1 sont publiées simultanément. 2026-09-26 à 27. https://lemmy.dbzer0.com/post/76110120
- SupraLabs/Supra2-IMG — modèle compact de génération texte-image ne comptant que 100 millions de paramètres. Score 7, autour du 2026-09-22. https://lemmy.dbzer0.com/post/75874769
- Nouvelle interface The AI Horde — le réseau décentralisé et gratuit de génération d’images IA AI Horde a renouvelé son frontend, son backend et sa documentation. Score 8, autour du 2026-09-19. https://lemmy.dbzer0.com/post/75736717
- Cierpliwy/krea2-inpaint-edit et lvladikov/Krea2-Turbo-Distill-2step-LoRA — LoRA d’édition par inpainting pour Krea-2 et LoRA de distillation accélérée en deux étapes. 2026-09-16 à 17. https://lemmy.dbzer0.com/post/76065378
- Art abstrait avec SDXL local + LoRA — œuvre abstraite réalisée avec SDXL 1.0 exécuté localement, LoRA personnalisé entraîné par l’auteur, puis finalisée dans GIMP et Inkscape. Score 4, 2026-09-18. https://lemmy.today/post/60272629
Côté sources fermées, sporadique et via d’autres communautés
- Midjourney demande à Hollywood de divulguer son utilisation de l’IA — information selon laquelle Midjourney réclame aux studios hollywoodiens le détail de leur usage de l’IA. !technology, 2026-07-05. https://techcrunch.com/2026/07/04/midjourney-wants-hollywood-studios-to-reveal-the-details-of-their-ai-usage/
- Google Earth AI, avec Nano Banana, retiré en 24 heures — le lendemain de l’intégration à Google Earth de la génération d’images Nano Banana, des utilisateurs ont produit massivement de fausses images, dont de faux clichés satellites de massacres et de catastrophes ; Google a désactivé la fonction. Les commentaires ont proposé de distinguer les vraies images satellites par signature cryptographique. Via !ai_reddit, 2026-08-07. https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Publicité pour entreprise IA créée en six heures avec Runway — publication affirmant avoir produit un concept de publicité de 40 secondes de style Nike avec Runway Gen-4 et sans équipe de tournage ni mannequins. !ai_reddit, score 1, 2026-09-26. https://v.redd.it/awqo4jp13yrh1
- Suicide après génération de 7 000 images sexuelles d’un beau-fils avec Grok — discussion dans !fuck_ai autour d’un grave fait divers lié à l’abus de Grok, solution fermée. 2026-07-09. https://lemmy.dbzer0.com/post/71983645
- Stanford reconnaît avoir utilisé l’IA pour modifier la race d’une photo d’étudiant — !nottheonion, 2026-09-23. https://san.com/cc/stanford-university-admits-ai-was-used-to-race-swap-student-photo/
Signaux
- Les discussions sur l’IA générative de Lemmy sont presque entièrement open source. Rien que !«メールアドレス» a reçu plus de 20 publications de dépôts et d’outils en deux semaines. L’écosystème autour de Qwen-Image-2.1, modèle open weights d’Alibaba, et MiniMax H3 pour la vidéo — nœuds ComfyUI, LoRA et WebUI — est la tendance claire. De nouveaux modèles légers tels que Krea ou SupraLabs apparaissent également.
- Les sources fermées, Midjourney, Sora, Veo, Grok et Google Nano Banana, n’apparaissent sur Lemmy que comme reprises d’articles ou dans le cadre d’abus et de polémiques. Elles ne sont pas discutées sous l’angle des outils, tutoriels ou créations, mais de la critique des entreprises, de la régulation ou des faits divers.
- L’ambiance de la communauté est globalement sceptique, voire hostile à l’IA. Des communautés anti-IA comme !fuck_ai existent sur plusieurs instances, et l’expression « AI slop », contenu IA produit en masse et de mauvaise qualité, revient fréquemment. Même des œuvres publiées peuvent obtenir un score négatif lorsqu’elles sont soupçonnées d’avoir été générées par IA.
- La recherche par mots-clés de l’API est assez instable. Les recherches sur des noms propres comme « Flux » ou « Veo 3 » se mélangent à des résultats sans rapport, par exemple des applications alternatives à Discord ; consulter directement !stable_diffusion est plus fiable.
Limites
- Le nombre d’utilisateurs et de publications actifs sur Lemmy reste très inférieur à celui de Reddit. Il fonctionne davantage comme un tableau de partage de dépôts pour développeurs que comme une source de « dernières actualités ». Les sorties de modèles, comparaisons et annonces liées aux solutions fermées sont presque absentes de Lemmy seul.
- !«メールアドレス» est protégé par Anubis et n’a pas pu être parcouru directement ; seules des informations fragmentaires trouvées dans les résultats de recherche étaient disponibles.
- Les scores sont globalement faibles, souvent à un chiffre, et Lemmy ne contient presque aucun message que l’on puisse qualifier de viral. Il faut interpréter ces chiffres en tenant compte de la petite taille de la communauté.
- Par rapport à l’objectif de 20 analyses, le côté open source atteint plus de 20 publications dans !stable_diffusion seul ; le côté fermé n’en atteint qu’une dizaine après recherche dans plusieurs communautés et mots-clés. Cela reflète le biais réel de Lemmy en faveur de l’open source, non un manque de couverture de recherche.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
La requête n’était qu’une seule expression, sans catégorisation, et 50 épingles ont été collectées. Toutes ont été examinées visuellement. Plutôt que des « jolies images » typiques de Pinterest, le lot était majoritairement composé de vignettes promotionnelles d’outils IA, d’infographies comparatives et de vignettes de vidéos « AI NEWS » ; il ressemble davantage à un tableau de blogs technologiques et d’affiliation.
Thèmes visuels
- Des robots humanoïdes bleu-blanc aux yeux lumineux dominent l’ensemble. Des robots en costume façon présentateurs d’actualité IA [1, 22, 29, 31, 47] et des logos « AI » sur une paume avec circuits lumineux [9, 46, 50] se répètent, représentant directement l’idée que l’IA remplace le travail humain.
- Une texture de circuits bleu marine et néon, cyan/magenta/violet, domine les arrière-plans [4, 8, 14, 16, 32, 45]. Presque toutes les publications utilisent la même palette, suggérant une standardisation des vignettes sur l’IA.
- Les infographies de comparaison et de classement d’outils sont nombreuses : logos alignés sous des titres comme « gratuit contre payant » ou « six meilleurs sites de génération vidéo IA » [3, 9]. Les logos de Runway, Pika, Kling AI, Luma AI, Canva AI, Hailuo AI, ChatGPT, Midjourney, Adobe Firefly, Ideogram, SeaArt, Playground, Krea et CapCut y sont très concentrés.
- Une mise en scène du doute entre réel et IA, avec loupe, tampon « FAKE », comparatif « Human or AI? » ou taux de détection IA à 97 %, est fréquente [1, 26, 27]. Elle traduit visuellement l’intérêt pour la vérification de l’authenticité.
- Le motif d’une IA prenant le contrôle de l’actualité revient à plusieurs reprises [5, 34, 37, 39, 44]. Une vraie séquence NBC News affiche « AI GENERATED » en haut à gauche d’un clip de type présentateur météo [44], exemple concret et atypique dans la production d’information.
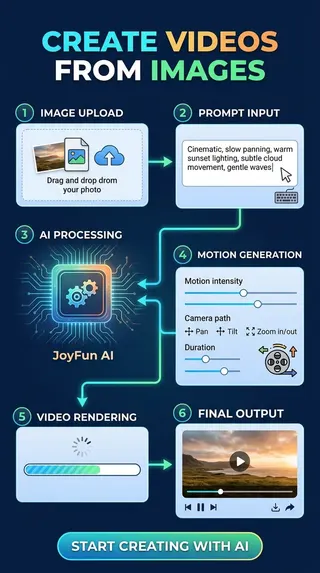
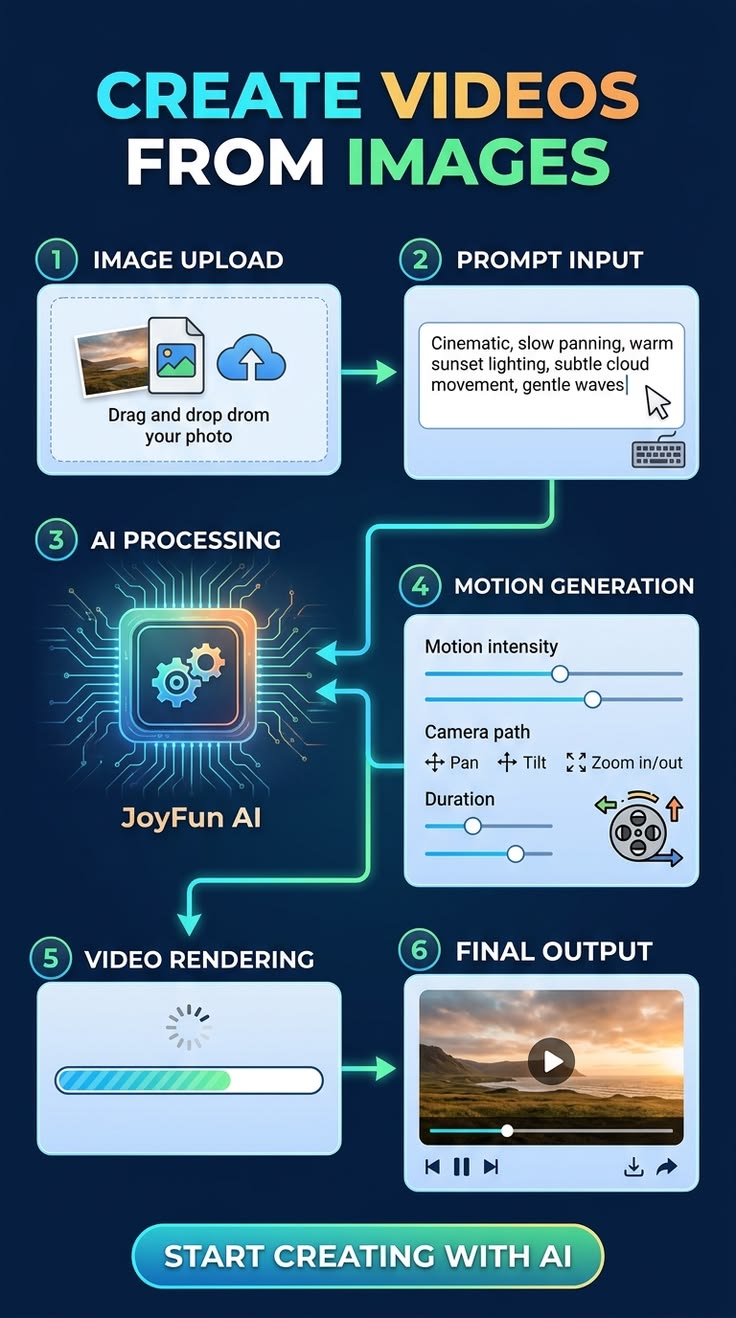
- Des infographies verticales en étapes, de 1 à 6, expliquent plusieurs fois comment créer une vidéo à partir d’une image [6, 24]. Saisie du prompt, traitement par IA, rendu et export constituent un workflow devenu standard.
- Des portraits réalistes sans artefacts visibles, gros plan d’un visage âgé, sculpture jouant du violoncelle ou jeune héros, servent de démonstrations publicitaires [12, 15, 49]. Ils visent à montrer la qualité des images photoréalistes générées.
- Des visuels d’annonces de produits avec logos d’entreprise, comme Google Veo 2 / VideoFX [16, 33], Gemini Omni [21], Vidu S1 de ShengShu [48] et Amuse 3.0 d’AMD [49], contiennent des informations plus spécifiques que les simples illustrations génériques de l’IA.
Épingles notables
- [2] Meta Muse Spark AI Model 2026 — vignette d’un article expliquant Meta Muse et promettant une « superintelligence personnelle ». Une femme avec casque, combinée à des maisons, voitures et éléments VR, souligne la piste de l’assistant personnel universel.
- [3] 6+ Best AI Video Generation Websites — infographie comparant Runway, Pika, Kling AI, Luma AI, Canva AI et Hailuo AI. Les outils sont répartis selon l’usage : cinéma, réseaux sociaux ou débutants.
- [9] AI Image Video: Best Quality vs Best Free — arbre de décision répartissant les services payants, ChatGPT Plus, Gemini Advanced, Midjourney, Adobe Firefly, Recraft, Runway Gen-3, Luma, Pika Pro, Kaiber et Synthesia, et les gratuits, Ideogram, Gemini Free, SeaArt, Playground, Krea, Canva, CapCut, Pika Free et Runway Free, par usage.
- [15] ByteDance and Hollywood reach global deal on AI copyright — capture d’écran d’un article selon lequel ByteDance a conclu un accord mondial avec la Motion Picture Association sur la protection du droit d’auteur dans les outils de génération d’images et de vidéos par IA. C’est une actualité concrète sur la régulation des solutions fermées.
- [16] Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API — présentation du modèle vidéo Veo de Google.
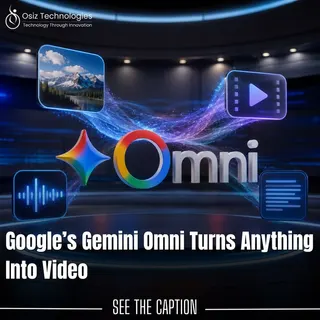
- [21] Google’s Gemini Omni Turns Anything Into Video — présentation d’une fonction où Gemini Omni transforme ensemble images, audio et texte en vidéo.
- [31] Discover how Grok is revolutionizing video... — épingle annonçant l’entrée de Grok de xAI dans la vidéo.
- [44] AI news videos blur line between real and fake reports — vraie vidéo NBC News montrant un clip de type météorologue portant le label « AI GENERATED ». Exemple d’application de signalement des contenus générés par IA dans les grands médias.
- [48] ShengShu Technology Unveils Vidu S1 — visuel annonçant Vidu S1, modèle vidéo chinois promettant une génération interactive en temps réel.
- [49] ‘Amuse 3.0’ — AMD-powered AI art creation tool — annonce d’une nouvelle version d’un outil de création artistique IA fonctionnant sur GPU AMD et orienté vers l’exécution locale, rare exemple précis côté ouvert/local.
Signaux
- Les solutions fermées dominent très largement. Google, avec Veo, Gemini et Omni, Meta avec Muse, OpenAI avec les logos ChatGPT/DALL-E, Runway, Pika, Luma, Kling, Canva, Hailuo, ShengShu avec Vidu et xAI avec Grok apparaissent régulièrement. Pinterest est centré sur des contenus d’intention d’achat destinés aux utilisateurs comparant les outils à choisir.
- L’open source et l’auto-hébergement sont peu présents. Stable Diffusion n’apparaît qu’une fois, titre seulement avec une image générique ; AMD Amuse 3.0 ressort comme cas d’exécution locale. Il n’y a aucun contenu de communauté technique sur ComfyUI, LoRA ou le partage de checkpoints. Ce biais correspond au public de Pinterest, plus grand public et marketing.
- L’intérêt pour l’authenticité des contenus générés est fort. Tampons FAKE, comparaisons Human or AI? et pourcentages de détection reviennent régulièrement. Avec l’exemple de NBC News, cela suggère que l’étiquetage et l’authenticité des contenus IA deviennent aussi un sujet grand public.
- Les contenus SEO de comparaison et de tutoriel sont dominants. Plus que les détails techniques des nouveaux modèles, les épingles expliquent quel outil choisir et comment l’utiliser ; Pinterest agit davantage comme un hub d’aide à la décision que comme une source de nouvelles de dernière minute.
- Les modèles visuels se sont uniformisés. Arrière-plan bleu marine, lignes de circuits néon et robot blanc se répètent presque partout, signe d’une forte standardisation et production en série des vignettes de blogs sur l’IA.
Limites
- La liste d’épingles ne comporte pas de catégories,
genreétant vide partout ; seules les 50 réponses à la requête unique « Image and Video Generation AI News » ont été examinées. Conformément au playbook, Pinterest n’a pas été parcouru directement : seules les images collectées ont été lues. - Beaucoup d’images sont des vignettes de blogs ou d’infographies ; le texte complet des articles liés n’a pas été lu. Les seules sources sont le texte visible dans les images et les titres/URL de
pinterest.pins.md. - Les épingles étayant précisément les évolutions open source sont peu nombreuses, une mention de Stability AI et une d’AMD Amuse seulement. Pinterest seul ne donne donc pas une couverture riche de l’actualité open source ; il s’agit d’un biais structurel de la plateforme visuelle grand public, pas nécessairement d’une omission de collecte.
Actions recommandées
- La prochaine fois, effectuer sur Reddit et X des recherches directes par noms propres, tels que Qwen-Image, Sora, Nano Banana et HunyuanVideo, pour réduire le bruit des tendances.
- Remplacer, pour X, la dépendance aux tendances Explore par une liste préétablie de termes relatifs à la génération d’images et de vidéos par IA.
- Continuer de surveiller le problème 403 de l’API searchPosts de Bluesky et passer à une recherche exhaustive par mots-clés dès qu’il sera résolu.
- Faire de l’évolution de la licence de Qwen-Image-2.1, notamment l’autorisation commerciale, un point de vérification fixe lors du prochain suivi.
- Continuer de surveiller !stable_diffusion sur Lemmy comme point d’observation de référence des nouveautés open source.
Images collectées


































Note sur la qualité des données
X a recueilli très peu de publications liées à la génération d’images et de vidéos par IA, car ses requêtes dépendaient des tendances X Explore, football et divertissement. Reddit n’a atteint que 11 fils sur l’objectif de 20 et a penché vers les controverses sociales. Bluesky ne pouvait pas être parcouru de façon exhaustive car searchPosts était bloquée par une erreur 403. YouTube ne permettait pas de lire les pages de résultats ni les pages de vidéos rendues en JavaScript ; les nombres de vues et autres mesures reposaient donc sur des sources secondaires.