J’ai quantifié mon propre LLM de 300 millions de paramètres et comparé sa vitesse et sa précision sur CPU
J’ai quantifié le modèle de 320 millions de paramètres pour le RAG en croate créé dans l’article précédent. Comme il est destiné à fonctionner sur CPU, j’ai voulu voir jusqu’où je pouvais le réduire et l’accélérer, et dans quelle mesure la précision diminuerait.
D’abord, la conclusion.
- Q6_K est le bon compromis. Taille divisée par 5 (254 Mo), génération environ 4 fois plus rapide, et précision identique au modèle d’origine
- Q2_K est inutilisable. Il est rapide, mais répond « il n’y a pas de réponse » même aux questions dont la réponse est présente
- Étonnamment, Q3_K_M s’est révélé plus précis que Q4_K_M
Ce que j’ai fait
J’ai converti le modèle créé avec PyTorch au format utilisable par llama.cpp pour l’inférence sur CPU (GGUF), puis je l’ai enregistré dans huit niveaux de précision.
- J’ai exporté le modèle dans le même format que Qwen3, puis l’ai converti en GGUF
- Le tokenizer étant fait maison, llama.cpp a refusé la conversion en le considérant comme un « tokenizer inconnu ». Après avoir comparé les règles de découpage des mots, elles se sont avérées identiques à Qwen2, caractère pour caractère : je l’ai donc enregistré comme Qwen2 pour effectuer la conversion
- J’ai vérifié que la conversion était correcte. La tokenisation de 160 textes correspondait intégralement à celle de la version PyTorch. Sur 20 questions, j’ai aussi généré les réponses en choisissant à chaque fois le mot à la probabilité la plus élevée : les sorties correspondaient parfaitement pour les 20 questions
- J’ai créé les versions F16 à Q2_K avec
llama-quantize
Ainsi, le F32 du tableau contient exactement la même chose que la version PyTorch. Il sert de référence pour la comparaison.
Méthode de mesure
- Le CPU est un i7-13700K. Aucun GPU n’a été utilisé
- La configuration de llama.cpp utilisait 8 threads pour la génération et 16 threads pour la lecture des textes (c’était la combinaison la plus rapide parmi celles testées)
- Chaque modèle a répondu 400 fois : 100 questions × 4 types de contexte
- Paragraphe : un paragraphe d’environ 100 tokens contenant la réponse
- Texte long : un texte d’environ 3 000 tokens contenant la réponse (avec également des articles sans rapport)
- Sans réponse (paragraphe / texte long) : un texte ne contenant pas la réponse. Refuser de répondre était considéré comme correct
- L’article précédent évaluait 300 questions ; les chiffres diffèrent donc légèrement
Résultats : précision
| Format | Taille | Paragraphe correct | Texte long correct | Refus sur texte long | Invention (sans réponse, paragraphe / texte long) | Taux de précision après vérification |
|---|---|---|---|---|---|---|
| F32 (référence) | 1 233 Mo | 77 % | 53 % | 30 % | 1 % / 9 % | 80,9 % |
| F16 | 617 Mo | 77 % | 53 % | 30 % | 1 % / 9 % | 80,9 % |
| Q8_0 | 329 Mo | 76 % | 53 % | 30 % | 1 % / 8 % | 81,9 % |
| Q6_K | 254 Mo | 79 % | 54 % | 30 % | 2 % / 9 % | 81,3 % |
| Q5_K_M | 223 Mo | 72 % | 45 % | 41 % | 1 % / 6 % | 84,4 % |
| Q4_K_M | 193 Mo | 68 % | 37 % | 46 % | 1 % / 7 % | 75,9 % |
| Q3_K_M | 160 Mo | 72 % | 48 % | 38 % | 1 % / 8 % | 80,4 % |
| Q2_K | 129 Mo | 39 % | 11 % | 78 % | 4 % / 7 % | 72,2 % |
Le « taux de précision après vérification » correspond à la proportion de réponses correctes parmi celles fournies, après avoir vérifié par programme que la citation du modèle se trouvait réellement dans le texte et remplacé par « sans réponse » les cas où ce n’était pas le cas.
- F16, Q8_0 et Q6_K sont quasiment identiques à la référence. Il n’y a qu’une à deux questions d’écart
- À partir de Q5_K_M, les refus augmentent davantage que les erreurs. Le comportement appris dans l’article précédent — refuser lorsqu’il manque de confiance — semble se manifester tel quel. Les inventions n’ont pas augmenté
- Q4_K_M est moins bon que Q3_K_M. 37 % contre 48 % sur les textes longs. Il peut y avoir une certaine variation sur 100 questions, mais 11 points est un écart important. Je n’en ai pas encore identifié la raison
- Q2_K refuse 78 % des textes longs. C’est pratiquement un autre modèle
Résultats : vitesse
| Format | Vitesse de génération | Temps moyen par exécution |
|---|---|---|
| PyTorch fp32 (à titre de référence) | Paragraphe 14,6 · texte long 6,7 tok/s | — |
| F32 | 18,7 tok/s | 2,76 secondes |
| F16 | 35,9 tok/s | 2,08 secondes |
| Q8_0 | 59,0 tok/s | 1,93 seconde |
| Q6_K | 73,1 tok/s | 1,33 seconde |
| Q5_K_M | 81,2 tok/s | 1,26 seconde |
| Q4_K_M | 89,1 tok/s | 1,10 seconde |
| Q3_K_M | 103,4 tok/s | 1,12 seconde |
| Q2_K | 119,9 tok/s | 1,07 seconde |
Les chiffres de llama.cpp sont des moyennes sur 400 exécutions (paragraphes, textes longs et cas sans réponse confondus). Les chiffres de PyTorch proviennent des mesures de l’article précédent.
- La vitesse de génération est presque inversement proportionnelle à la taille. Sur CPU, elle dépend davantage de la vitesse de lecture des poids depuis la mémoire que du calcul lui-même : plus le modèle est petit, plus il est rapide
- Même en F32, llama.cpp est plus rapide que PyTorch
- En revanche, sous Q6_K, le temps d’une exécution ne diminue plus beaucoup. Pour cette longueur, le temps de lecture initiale du texte devient prépondérant
Vidéo : la même question sur un texte long, résolue sur CPU
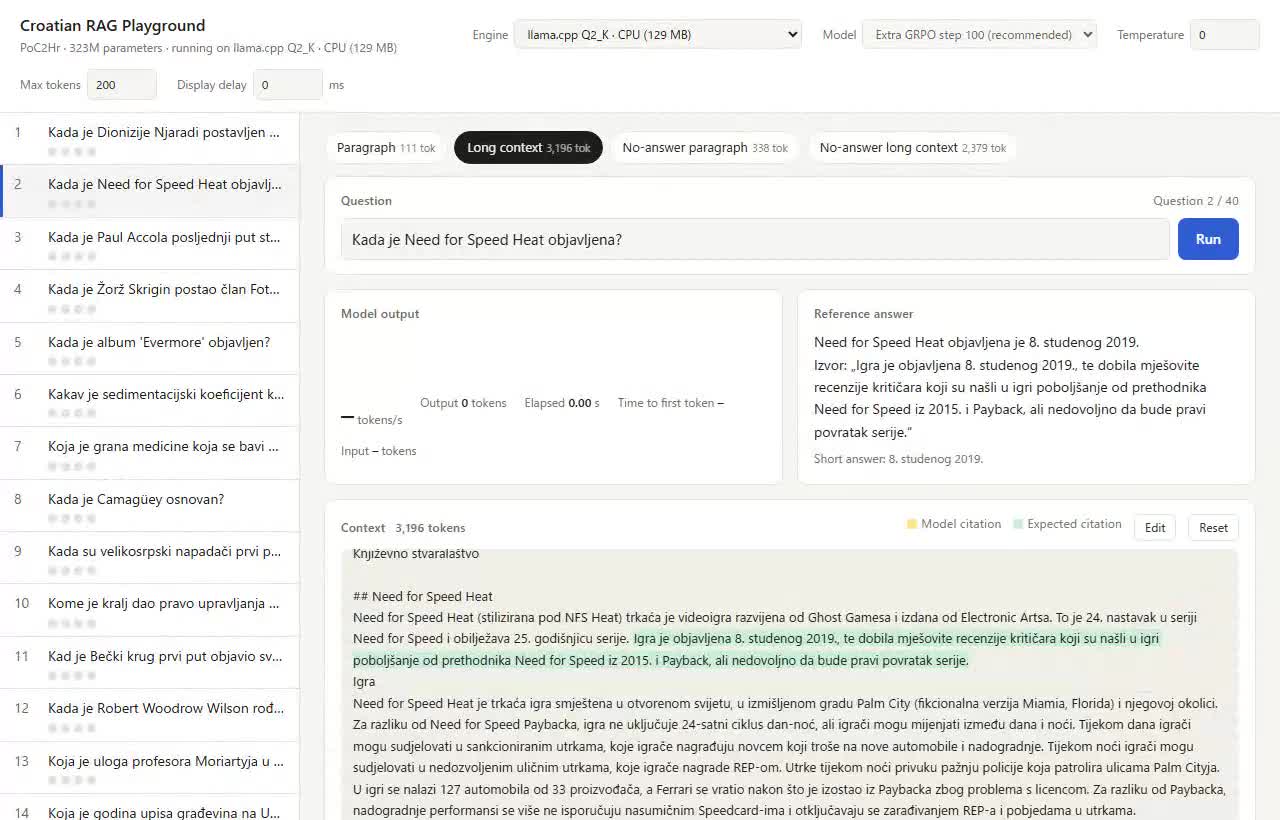
J’ai fourni un texte d’environ 3 200 tokens et demandé : « Quand Need for Speed Heat est-il sorti ? » La bonne réponse est le 8 novembre 2019.
Comme l’enregistrement était en cours et que le navigateur dessinait également l’écran, les vitesses dans la vidéo sont inférieures à celles du tableau ci-dessus. Il faut surtout la regarder pour comparer les versions entre elles.
| Format | Vitesse de génération dans la vidéo | Jusqu’au premier caractère | Total | Résultat |
|---|---|---|---|---|
| PyTorch fp32 | 5,5 tok/s | 4,8 secondes | 18,5 secondes | Correct |
| F32 | 14,2 tok/s | 2,8 secondes | 8,1 secondes | Correct |
| F16 | 25,9 tok/s | 3,5 secondes | 6,4 secondes | Correct |
| Q8_0 | 38,2 tok/s | 4,0 secondes | 5,9 secondes | Correct |
| Q6_K | 41,6 tok/s | 2,6 secondes | 4,4 secondes | Correct |
| Q5_K_M | 46,3 tok/s | 2,6 secondes | 4,3 secondes | Correct |
| Q4_K_M | 47,2 tok/s | 2,3 secondes | 4,7 secondes | Correct (réponse un peu longue) |
| Q3_K_M | 56,7 tok/s | 2,5 secondes | 4,5 secondes | Correct (réponse un peu longue) |
| Q2_K | 61,3 tok/s | 2,7 secondes | 2,8 secondes | A refusé |
De F32 à Q5_K_M, la réponse et la citation sont identiques, caractère pour caractère, à la version PyTorch. Avec Q4_K_M et Q3_K_M, la phrase de réponse est devenue plus longue, mais la citation était correcte. Q2_K a répondu « le texte ne contient pas la réponse » alors qu’elle y figurait.
PyTorch fp32 (modèle d’origine)
llama.cpp F32 (1 233 Mo)
llama.cpp F16 (617 Mo)
llama.cpp Q8_0 (329 Mo)
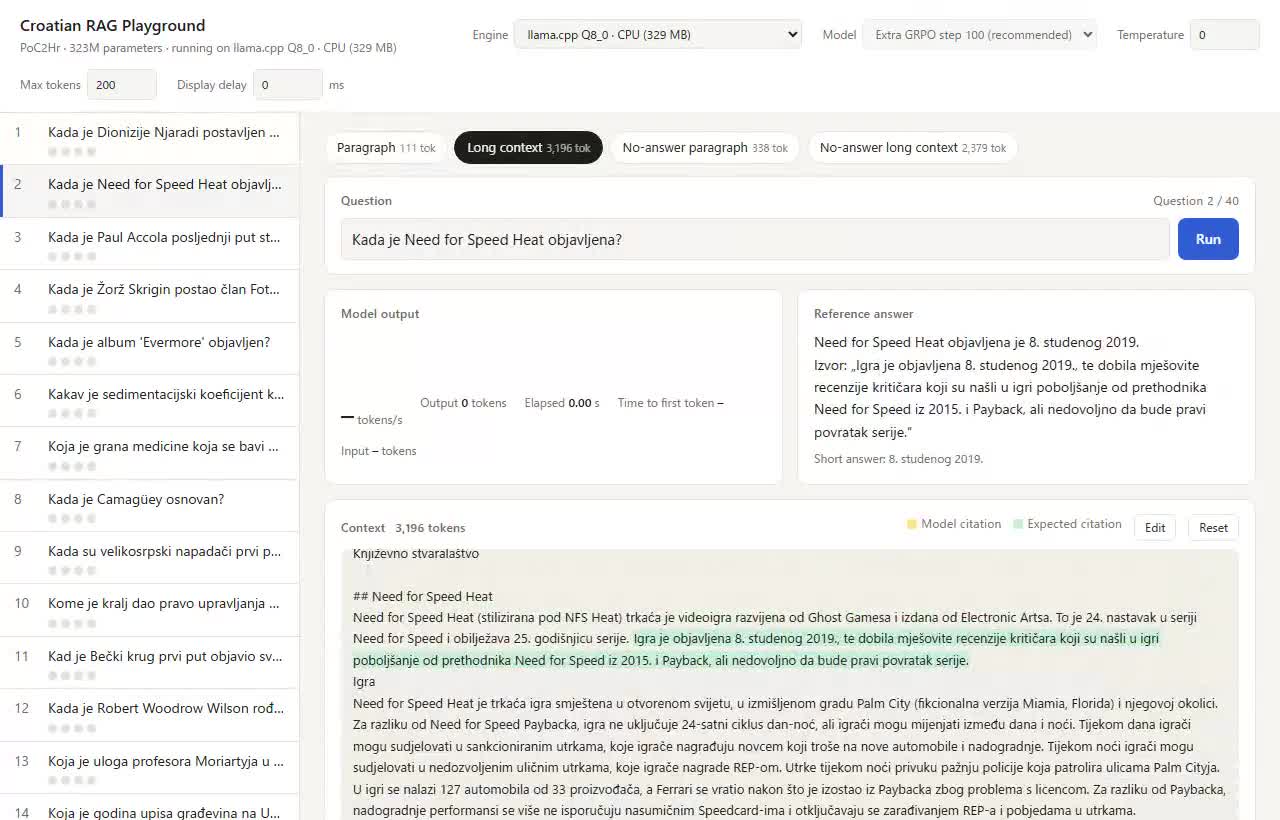
llama.cpp Q6_K (254 Mo)
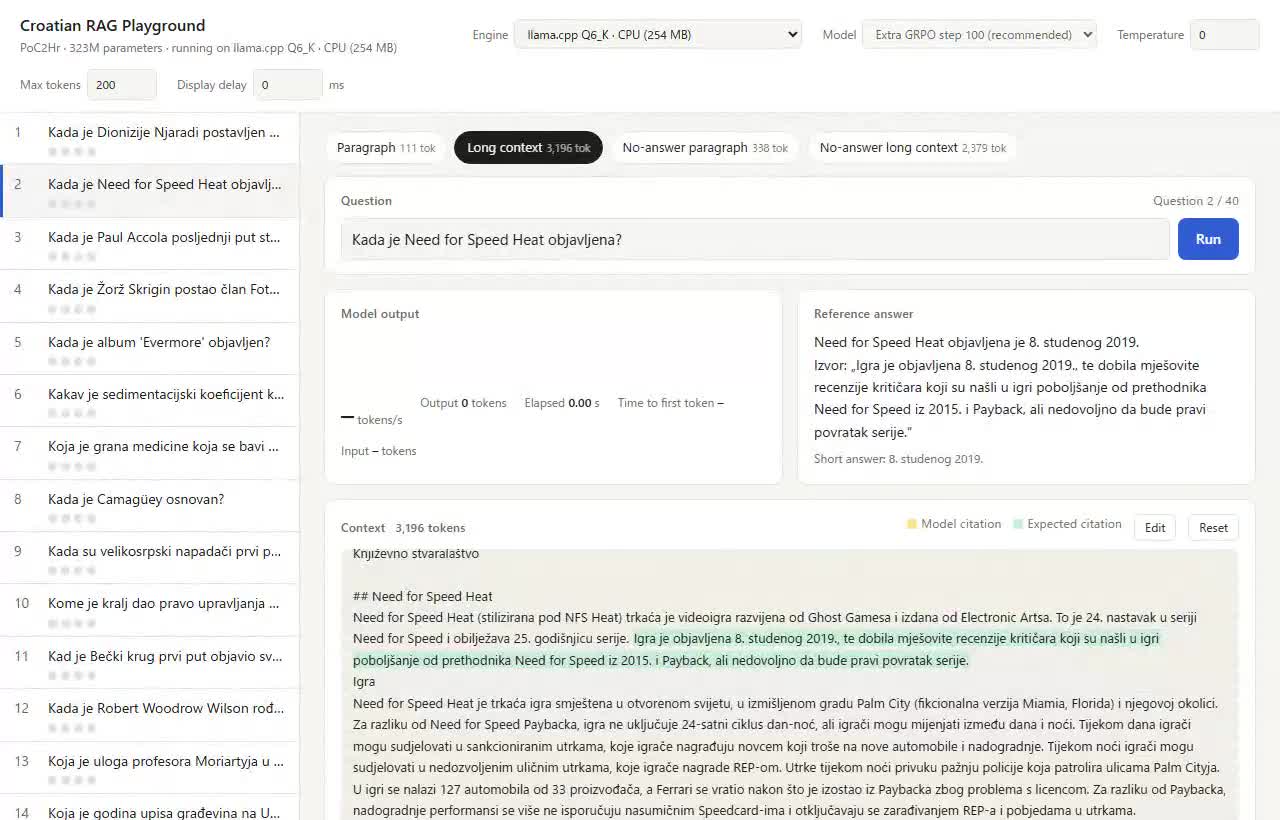
llama.cpp Q5_K_M (223 Mo)
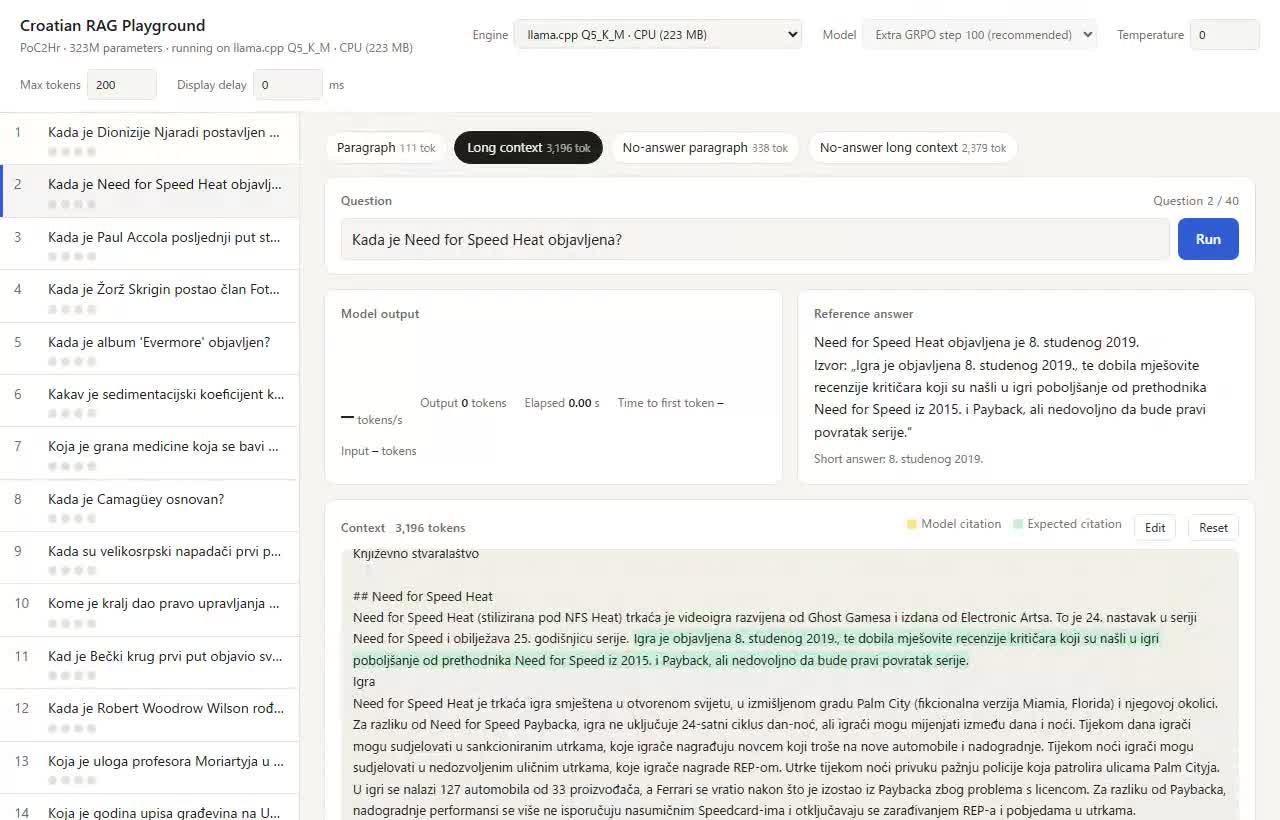
llama.cpp Q4_K_M (193 Mo)
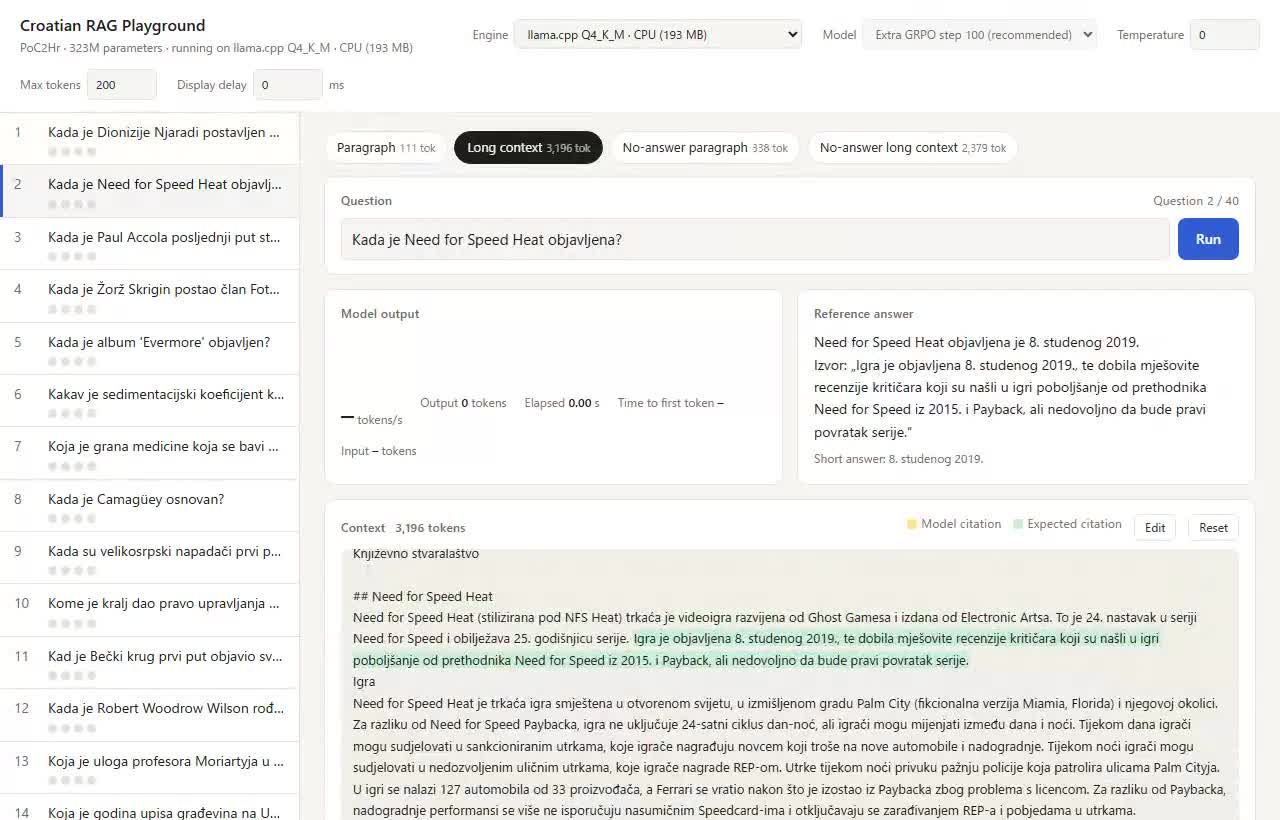
llama.cpp Q3_K_M (160 Mo)
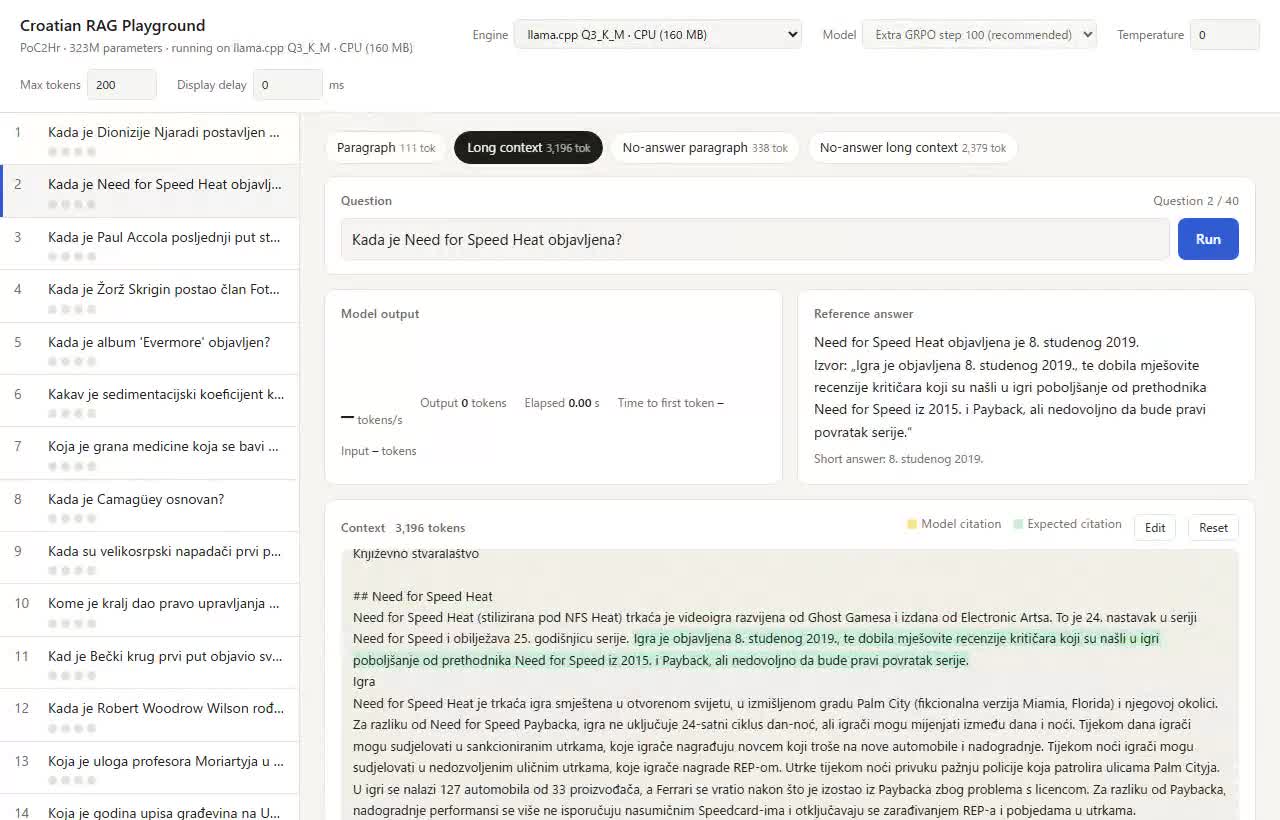
llama.cpp Q2_K (129 Mo)
Analyse
- Pour faire tourner ce modèle sur CPU, choisissez Q6_K. La précision reste celle de l’original, la taille est divisée par 5 et la génération est environ 5 fois plus rapide que sous PyTorch. Il n’y a aucune raison d’hésiter
- Pour privilégier la sécurité, choisissez Q8_0. Il est presque identique à l’original avec 329 Mo seulement. C’est déjà très compact
- Les petits modèles de 300 millions de paramètres résistent mal à la quantification. Les grands modèles sont réputés subir très peu de dégradation même en Q4, mais ici une baisse visible est apparue dès Q5. Le modèle avait déjà peu de marge, donc chaque réduction a un effet sensible
- C’est rassurant que la défaillance prenne la forme de refus. En RAG, refuser est plus sûr qu’inventer. L’apprentissage par renforcement qui lui a appris à refuser dans l’article précédent semble aussi produire son effet ici
- Sur les petits modèles, les écarts de vitesse se resserrent. Sous Q6_K, même lorsque la génération s’accélère, le temps de lecture du texte demeure ; l’impression de rapidité change donc peu. Dans la vidéo aussi, Q6_K à Q3_K_M se situent tous autour de 4 secondes
- La raison pour laquelle Q4_K_M perd face à Q3_K_M reste inconnue. J’aimerais augmenter le nombre de questions et examiner quelles couches sont quantifiées, et comment, pour l’étudier