J’ai créé de zéro un LLM de 300 millions de paramètres pour le RAG en croate. Il fonctionne sur CPU
Après GPT-2 la dernière fois, j’ai cette fois créé de zéro un LLM en croate sur une seule RTX 4090. L’objectif : le RAG. Un modèle qui cherche la réponse dans le texte fourni et répond en citant une phrase qui l’étaye. Et il est conçu pour tourner en production sur CPU.
Pour commencer, voici la conclusion.
- Environ 68 heures de GPU de zéro jusqu’au modèle final (essais et erreurs inclus). Dont 51 heures de pré-entraînement
- 320 millions de paramètres. 71 % de bonnes réponses sur des questions portant sur un paragraphe, 44 % sur de longs textes d’environ 3 000 tokens
- Il répond à une question en 3 à 16 secondes uniquement sur CPU. Les caractères apparaissent à une vitesse qu’on peut suivre à l’œil
Temps d’apprentissage
| Étape | Durée | Contenu |
|---|---|---|
| Génération des données d’entraînement | Environ 4,5 heures | 45 000 QA Wikipedia et 50 000 traductions de conversations avec EuroLLM-9B (vLLM) |
| Tokeniseur et tokenisation | Environ 2,5 heures (CPU) | Création maison d’un vocabulaire croate de 32 000 unités |
| Pré-entraînement | 50 heures 46 minutes | 7 milliards de tokens. Contexte porté à 4 096 sur les 10 % finaux |
| SFT | Environ 35 minutes | Apprentissage des réponses avec citation et du refus lorsqu’il n’y a pas de réponse |
| Apprentissage par renforcement (GRPO) | Environ 11 heures | 400 étapes, puis ajustement sur 300 étapes |
Le tokeniseur maison permet de représenter le croate avec environ la moitié du nombre de tokens du tokeniseur GPT-2. Avec 4 096 tokens, il peut lire environ 17 000 caractères.
Le modèle obtenu
| Élément | Contenu |
|---|---|
| Paramètres | 320 millions (24 couches, 1 024 dimensions) |
| Architecture | Famille Llama / Qwen3 (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Longueur de contexte | 4 096 tokens |
| Format de sortie | Réponse + Izvor: „une phrase extraite telle quelle du contexte“. S’il n’y a pas de réponse : « U tekstu nema odgovora na ovo pitanje.(Il n’y a pas de réponse à cette question dans le texte.)」 |
| Exécution | Pensé pour le CPU (environ 1,3 Go en fp32) |
J’ai aussi ajouté autour du modèle un mécanisme qui vérifie par programme si la citation générée est bien présente dans le contexte et, sinon, la remplace par « pas de réponse ». L’idée est de ne pas faire entièrement confiance au modèle, mais de pouvoir vérifier ses sources.
Les problèmes rencontrés
1. Il invente une réponse à chaque fois, même quand il n’y en a pas. Au départ, je lui ai simplement appris à répondre aux questions. Le taux de bonnes réponses a progressé, mais lorsqu’on lui fournissait un texte ne contenant pas la réponse, il fabriquait une réponse plausible dans 100 % des cas. C’est le pire problème en RAG. Après lui avoir appris à citer et à « refuser », les inventions sont tombées à quelques pourcents.
2. Il refuse trop souvent. Quand j’ai défini la notation de l’apprentissage par renforcement ainsi : « −0,5 en cas d’erreur, 0 en cas de refus », il a appris que, sur les longs textes difficiles, refuser était avantageux, et il s’est mis à refuser dans 70 % des cas. Il exploite parfaitement les failles de la règle de notation. En passant la pénalité du refus à −0,3, il a basculé dans l’autre sens : il ne refusait presque plus et inventait une réponse dans 40 % des cas. Ça oscillait comme une balançoire.
3. Les erreurs de copie dans les citations. Sur les longs textes, la réponse était parfois correcte, mais il inversait l’ordre des mots dans la citation ou citait la première phrase de l’article. Sur les longs contextes, la réponse et la citation n’étaient toutes deux correctes que dans environ la moitié des cas.
4. Des erreurs qui passent la vérification. Il a cité exactement une phrase « né à XX » provenant d’un autre article mélangé au contexte et a donné le lieu de naissance d’une autre personne. La citation étant authentique, la vérification ne pouvait pas l’arrêter.
5. Des failles dans les données d’évaluation. Dans certains contextes censés ne pas contenir de réponse, une partie de celle-ci subsistait ; le modèle avait donc raison, mais était classé comme ayant « inventé » une réponse.
Performances finales
300 questions ont été évaluées pour chaque cas. J’ai utilisé le modèle à la 100e étape de l’apprentissage par renforcement ajusté, celui qui offrait le meilleur équilibre entre refus et réponse.
| Contexte | Correct | Incorrect | Refus |
|---|---|---|---|
| Paragraphe (environ 100 à 400 tokens) | 71,3 % | 16,7 % | 12,0 % |
| Long contexte (1 500 à 3 500 tokens) | 44,0 % | 20,3 % | 35,7 % |
| Contexte sans réponse | Refus correct | Invention |
|---|---|---|
| Paragraphe | 97,7 % | 2,3 % |
| Long contexte | 92,3 % | 7,7 % |
Après vérification, la proportion de réponses correctes parmi celles auxquelles le modèle a répondu était de 73,8 %. On est encore loin de l’objectif de 90 %.
À noter que si on lui fait résoudre chaque question 8 fois et qu’une seule réponse correcte suffit, il atteignait 91 % sur les paragraphes et 74 % sur les longs textes (mesuré sur le dernier checkpoint). Ce chiffre changeait à peine avant et après l’apprentissage par renforcement ; ce qui a changé, c’est sa capacité à réussir à chaque fois. Les chiffres ont clairement montré que l’apprentissage par renforcement n’ajoute pas tant de nouvelles capacités qu’il ne rend systématique la résolution de problèmes que le modèle sait parfois résoudre.
Essai sur CPU
J’ai créé une interface Web de test et l’ai exécutée uniquement sur CPU (i7-13700K). La vitesse à laquelle les caractères apparaissent correspond directement à la vitesse de génération.
Paragraphe (263 tokens) : 0,3 seconde avant le premier caractère, environ 11 tokens/s, 7 secondes au total
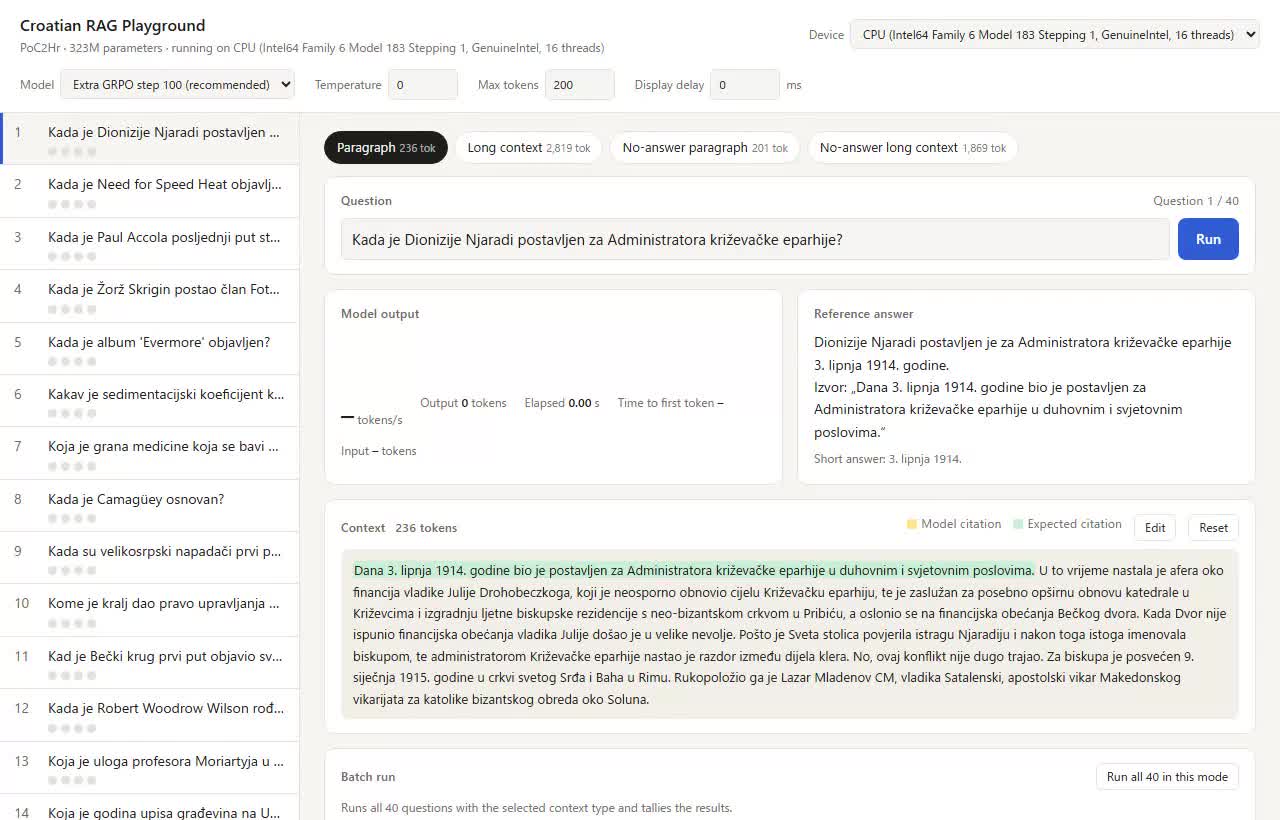
Long contexte (3 215 tokens) : environ 5 secondes pour lire le texte, environ 5 tokens/s, 19 secondes au total. Le jaune correspond à la phrase citée : le modèle retrouve bien la bonne phrase parmi 3 000 tokens
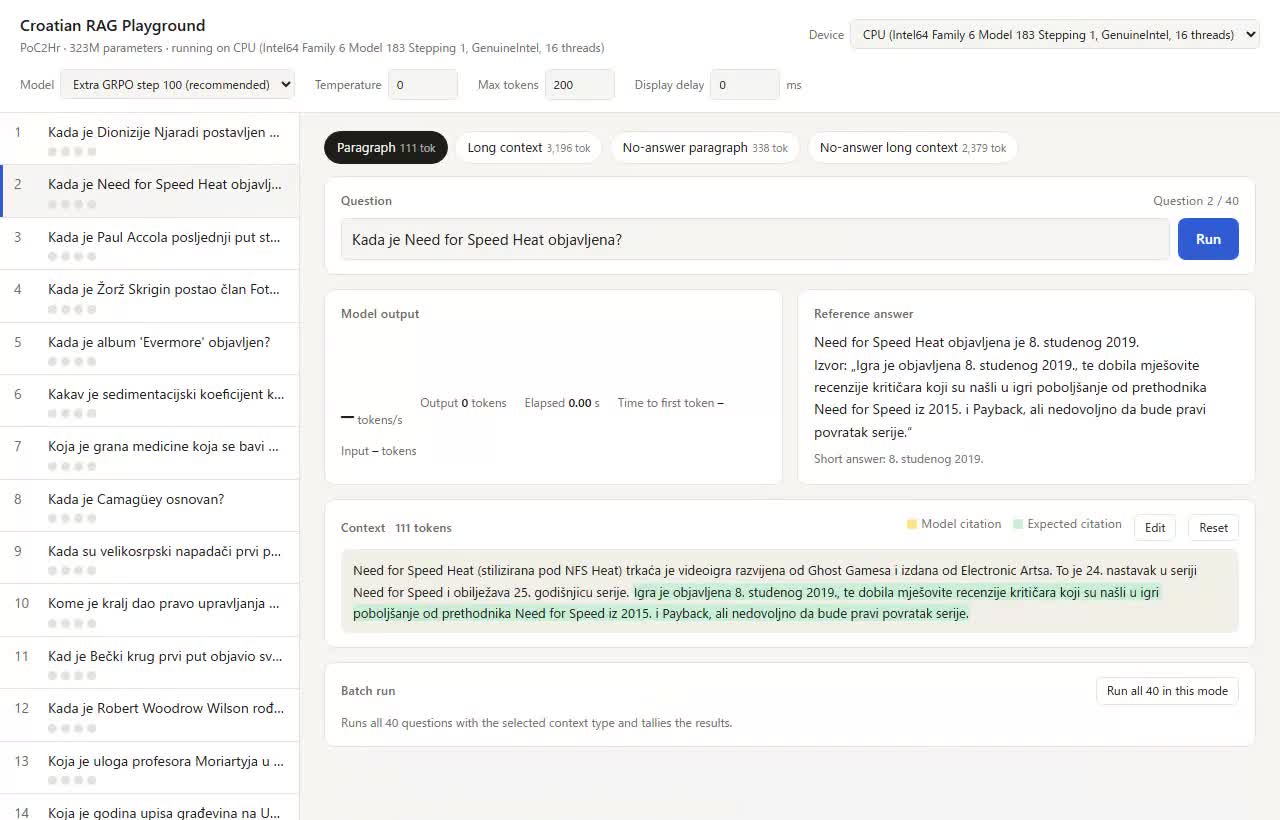
La vidéo est un peu plus lente car elle a été enregistrée. Sans enregistrement, sur 20 questions de chaque type, on obtenait 15 tokens/s et 3,4 secondes par question pour les paragraphes, contre 7 tokens/s et 16 secondes par question pour les longs contextes. Les réponses étant courtes, autour de 50 tokens, la vitesse semble utilisable même sur CPU.
Réflexions
- Avec un petit modèle, le plus important est de lui faire dire qu’il ne sait pas ce qu’il ignore. En RAG, réduire les inventions est plus utile qu’augmenter le taux de bonnes réponses. La combinaison citation + refus + vérification externe s’est révélée très efficace
- 300 millions de paramètres, c’est la limite pour les longs textes. Même avec 8 tentatives, on ne dépasse que 74 % sur les longs contextes. Pour viser 90 % sur des textes longs, il faudrait sans doute environ 1 milliard de paramètres
- Vérifier seulement que la citation existe réellement ne suffit pas. Il faut aussi contrôler que la citation contient le chiffre ou le nom répondant à la question, et que son sujet correspond bien à la personne visée
- Un modèle de 300 millions de paramètres qui fonctionne sur CPU convient parfaitement aux Q&R sur des documents impossibles à mettre en ligne. Sur un ordinateur portable ou un serveur sans GPU, il peut répondre uniquement à partir de documents locaux. Avec quelques secondes à une quinzaine de secondes par question, et probablement davantage de vitesse grâce à la quantification (non testé), c’est prometteur
La prochaine fois, j’aimerais essayer une version à 1 milliard de paramètres afin de viser 90 % sur les longs contextes.