J’ai fait tourner Qwen3.8-Flash-Next avec Strata et demandé à OpenCode de créer trois projets
J’ai fait tourner Qwen3.8-Flash-Next avec Strata et demandé à OpenCode de créer trois projets
J’ai fait tourner le modèle ouvert MoE de 125B « Qwen3.8-Flash-Next » via Strata sur un PC Windows équipé d’une RTX 4090, puis l’ai utilisé comme agent d’implémentation dans OpenCode.
J’ai testé trois cas : un jeu 3D en Three.js, une application Web plutôt pratique et 30 secondes de motion design. Pour aller droit au but : le jeu et l’application Web ont réussi. La vidéo a bien été générée, mais la qualité visuelle reste très insuffisante.
Il ne s’agit pas d’un benchmark rigoureux, mais d’un test de travail réel très subjectif.
Environnement d’exécution
| Élément | Configuration |
|---|---|
| GPU | NVIDIA GeForce RTX 4090 24 Go |
| CPU | Intel Core i7-13700K (16 cœurs / 24 threads) |
| RAM | 64 Go |
| OS | Windows 11 Pro |
| Inférence | Strata v0.1.40.2 / Qwen3.8-Flash-Next IQ2_XS |
| Contexte | 262 144 tokens |
| Agent de programmation | OpenCode v1.17.13 |
Le modèle lui-même pèse environ 70 Go. Sur la 4090, les réponses courtes ont atteint environ 86 à 108 tok/s, tandis que même les longs prompts de 32K à 128K ont été ingérés à environ 4 400 à 5 000 tok/s. J’ai également pu traiter 255K tokens en pratique.
La principale contrainte était toutefois la RAM, plus que la VRAM. Strata consomme beaucoup de mémoire ; faire tourner simultanément Docker, une build Next.js et Playwright sur la même machine de 64 Go devient très difficile. Pour développer sérieusement en parallèle, il me semble réaliste de viser au moins 96 Go, ou de séparer le PC d’inférence du PC de développement.
1. Un jeu 3D avec Three.js : succès
J’ai commencé par lui demander de créer une version 3D en 3×3×3 de « Lights Out » avec Three.js. Le prompt n’a été envoyé qu’une seule fois et comprenait néons, bloom, effets sonores, interface japonaise et anglaise, annulation et animation de fin de niveau.
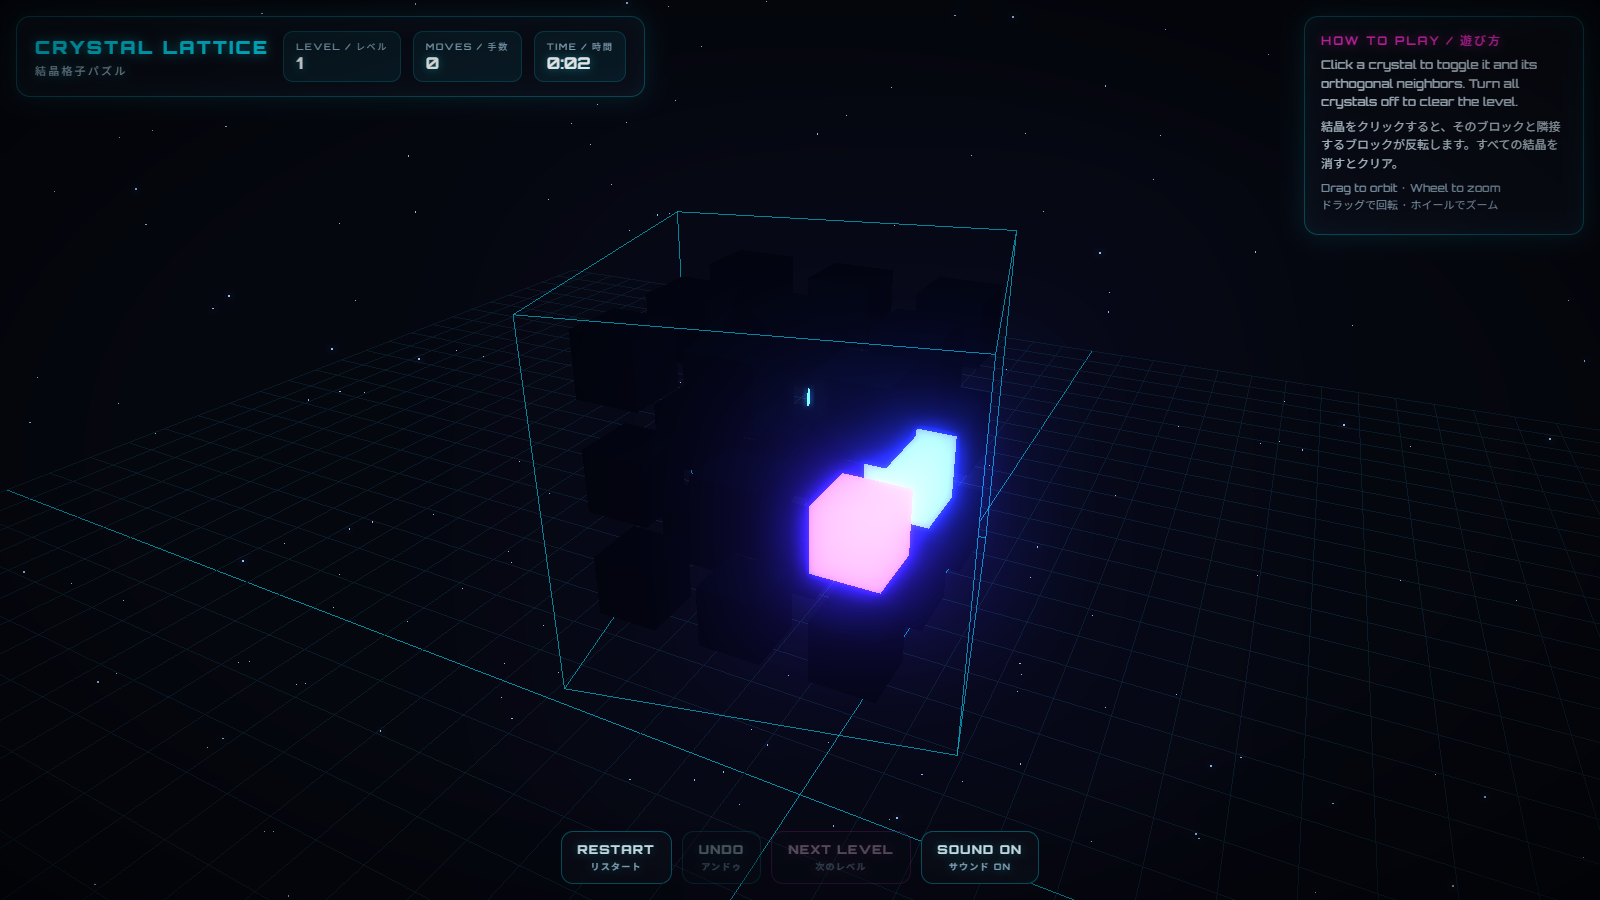
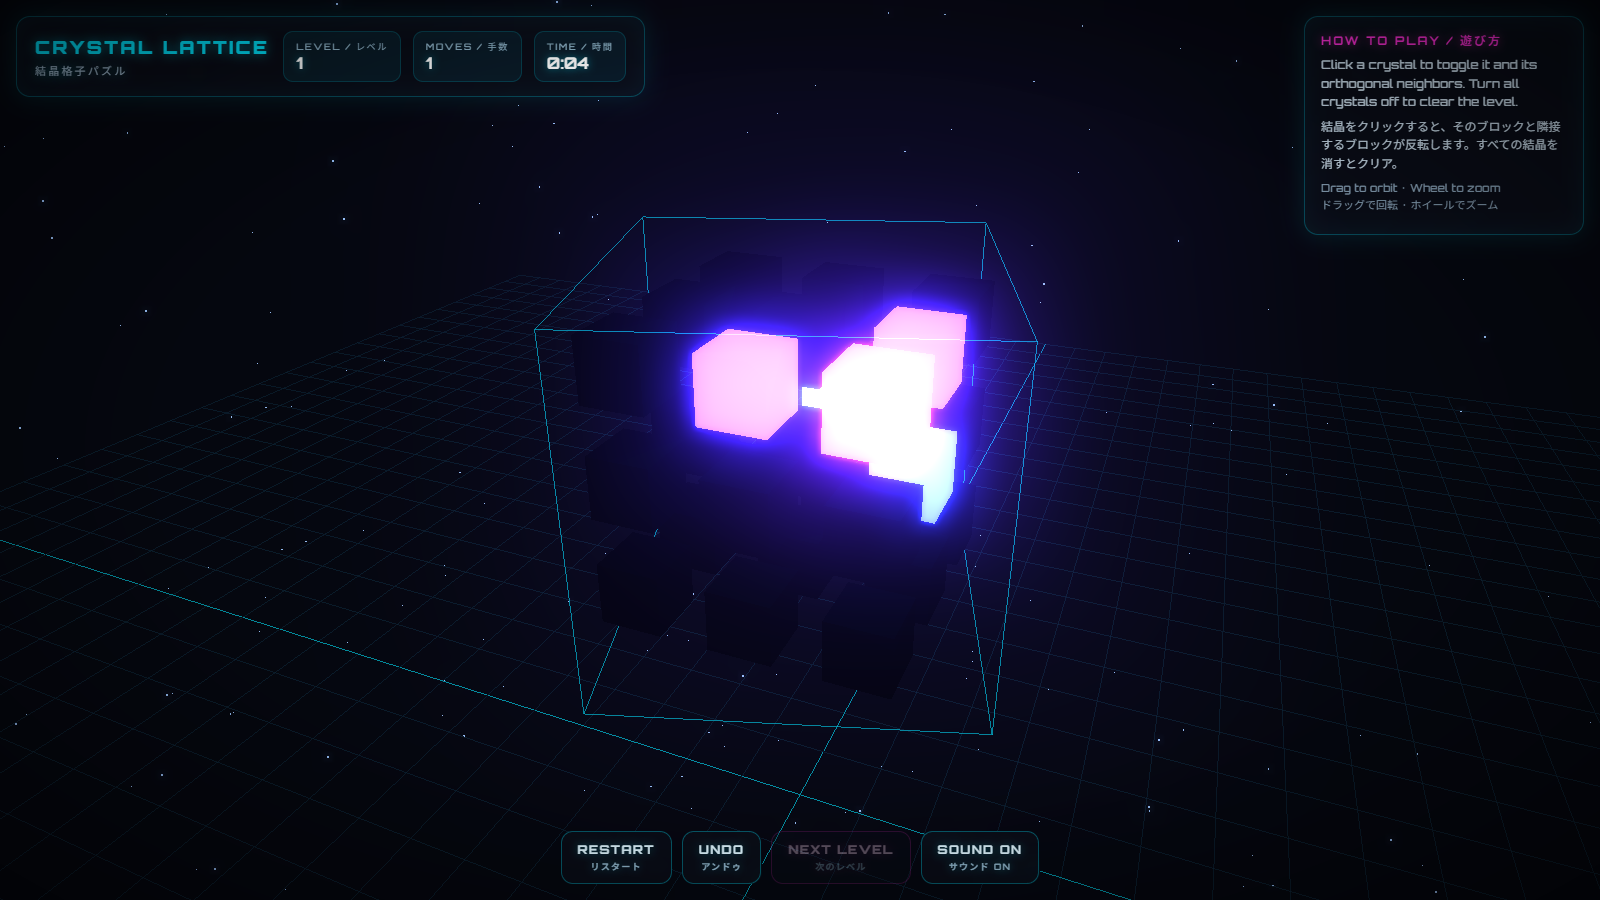
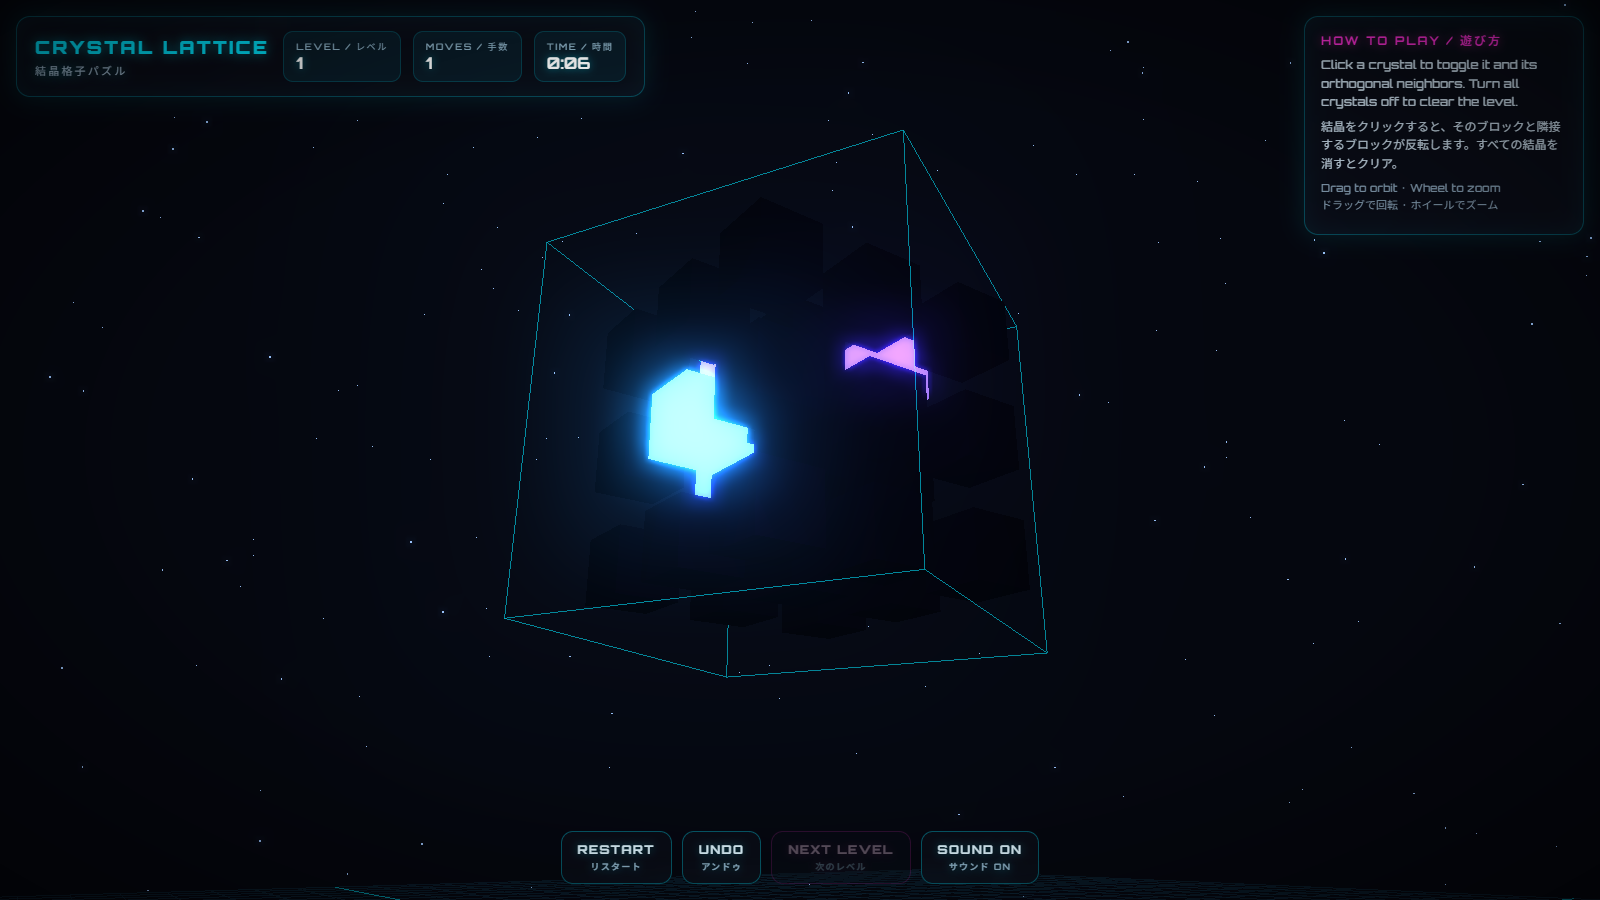
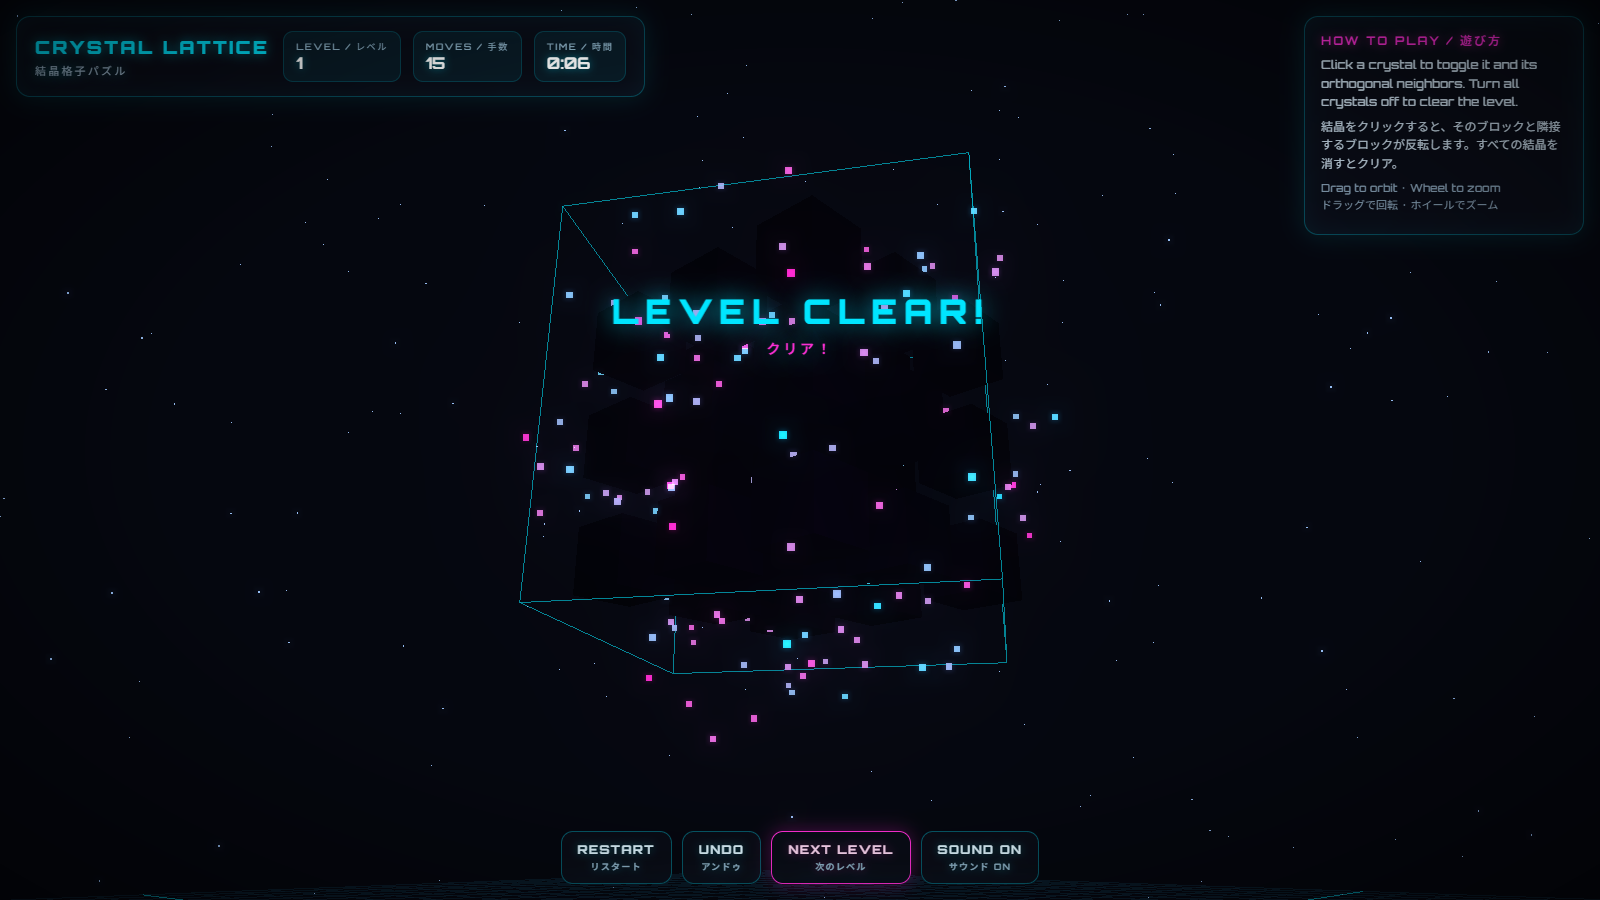
La stack technique se compose d’un unique fichier HTML et de Three.js. L’implémentation compte 559 lignes et regroupe rendu, post-traitement, Web Audio et contrôles à la souris. Elle a généré environ 31 000 tokens et a demandé environ 5 minutes.
Après vérification dans Chrome sans interface, aucune erreur JavaScript n’a été relevée. Les clics, la rotation de la vue et la résolution du niveau ont réellement fonctionné.
Un seul échec : un bug faisait diverger la construction du plateau entre la génération de niveau et la réinitialisation. Cela dit, ce plateau 3×3×3 est mathématiquement résoluble quelle que soit sa configuration, donc le jeu ne peut pas se retrouver bloqué.
- Taux de réussite subjectif : 90 %
- Temps nécessaire : environ 5 minutes
- Évaluation : très bon pour une génération en une fois. L’apparence comme le fonctionnement en font déjà une véritable « œuvre »
2. Une application Web assez fonctionnelle : succès
Ensuite, je lui ai fait créer « ORBIT », une console de gestion de réservations pour un studio. Pas un simple tableau de bord : une application Next.js de 12 écrans et environ 5 700 lignes.
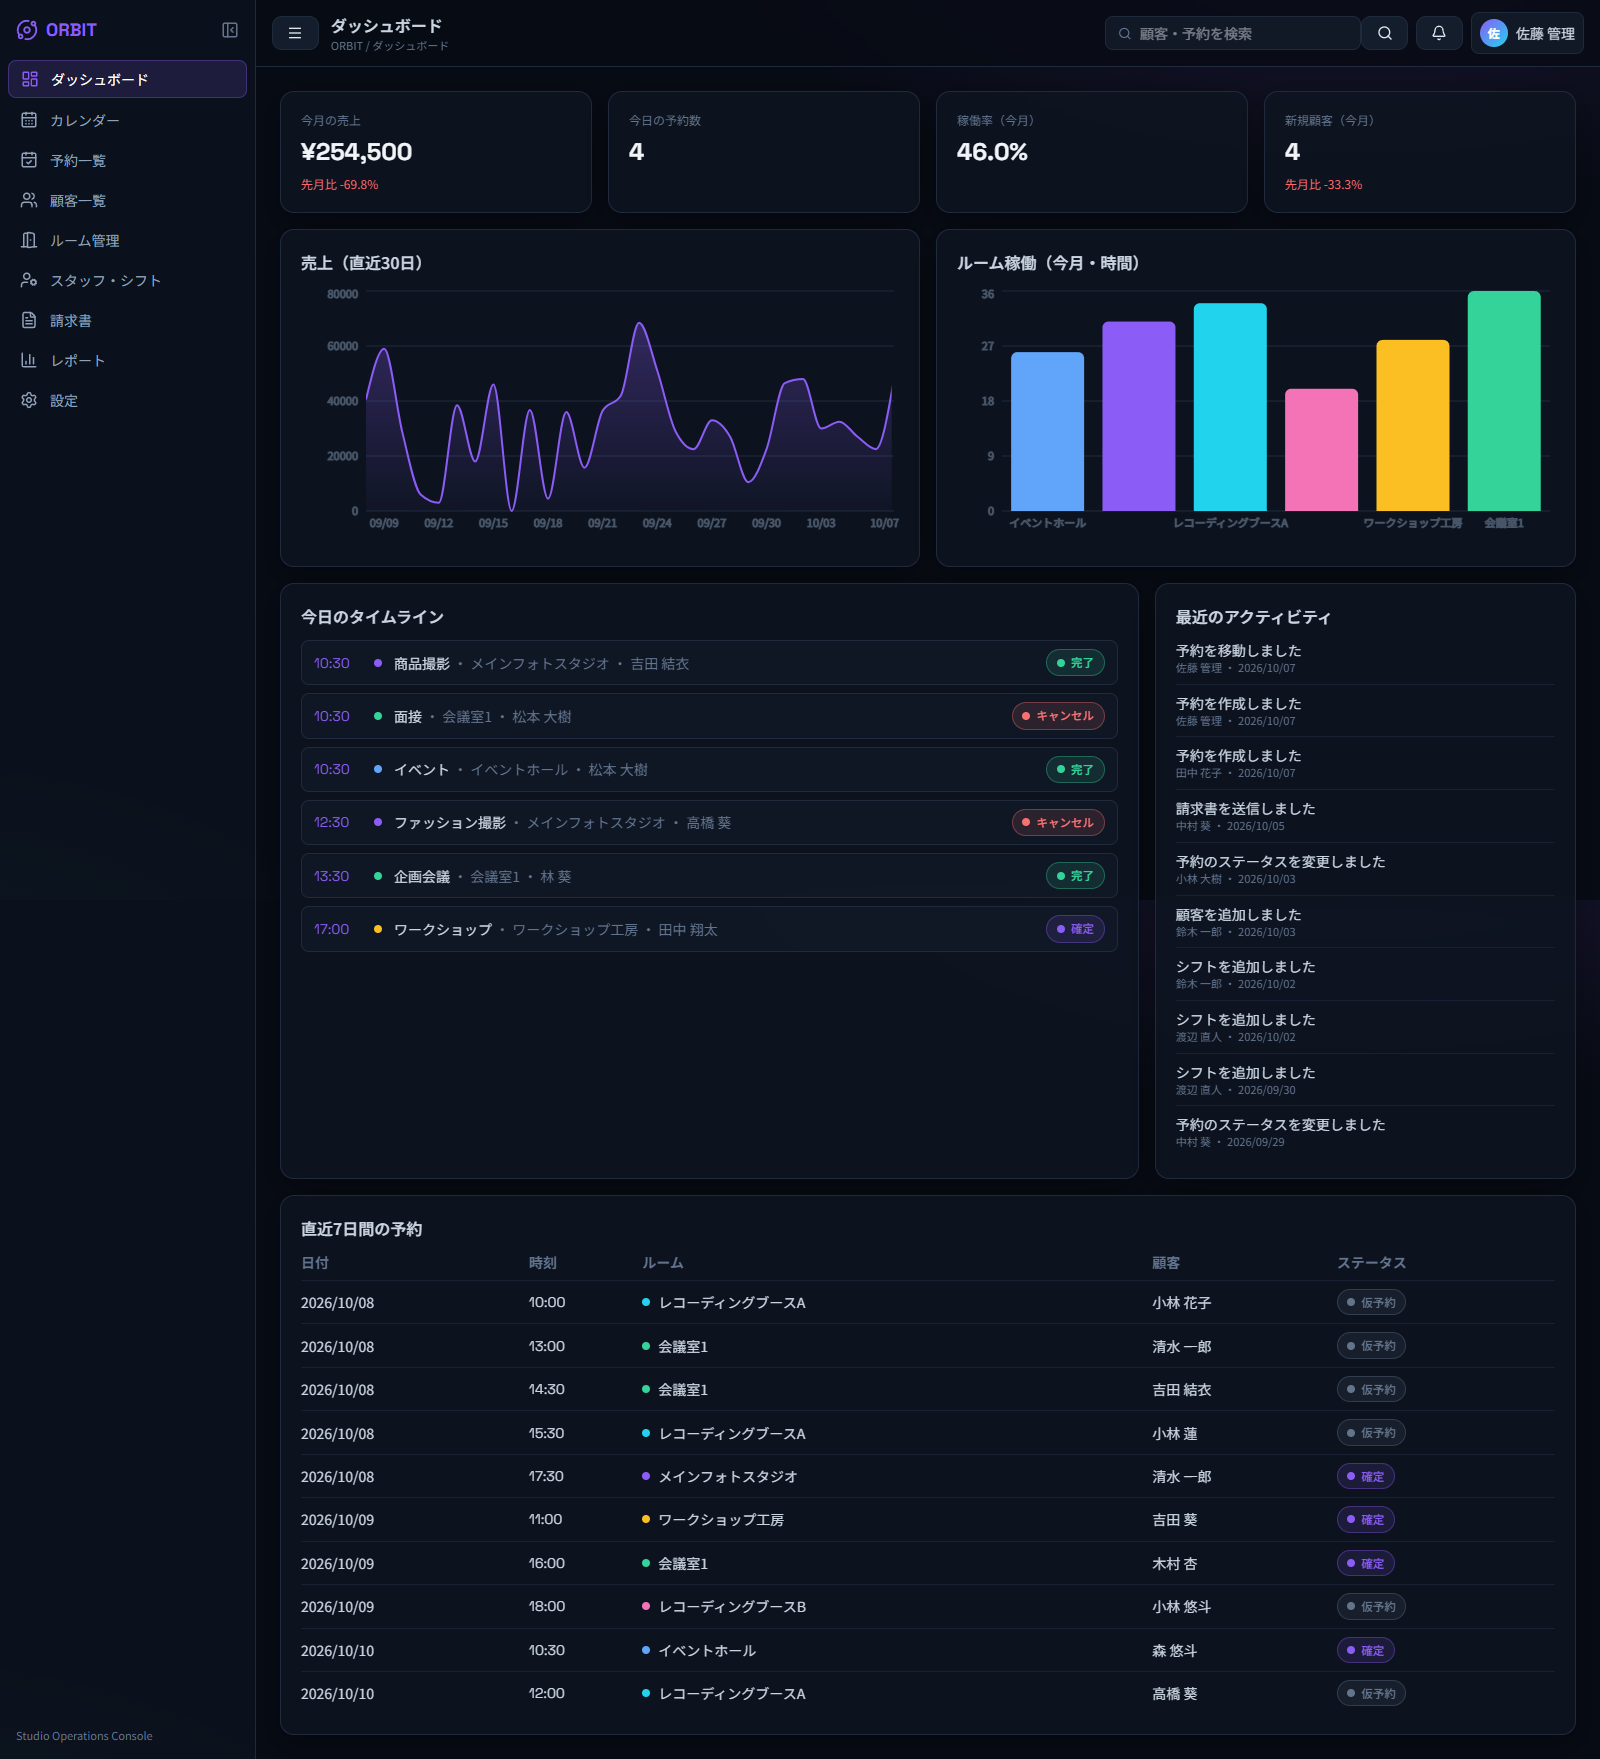
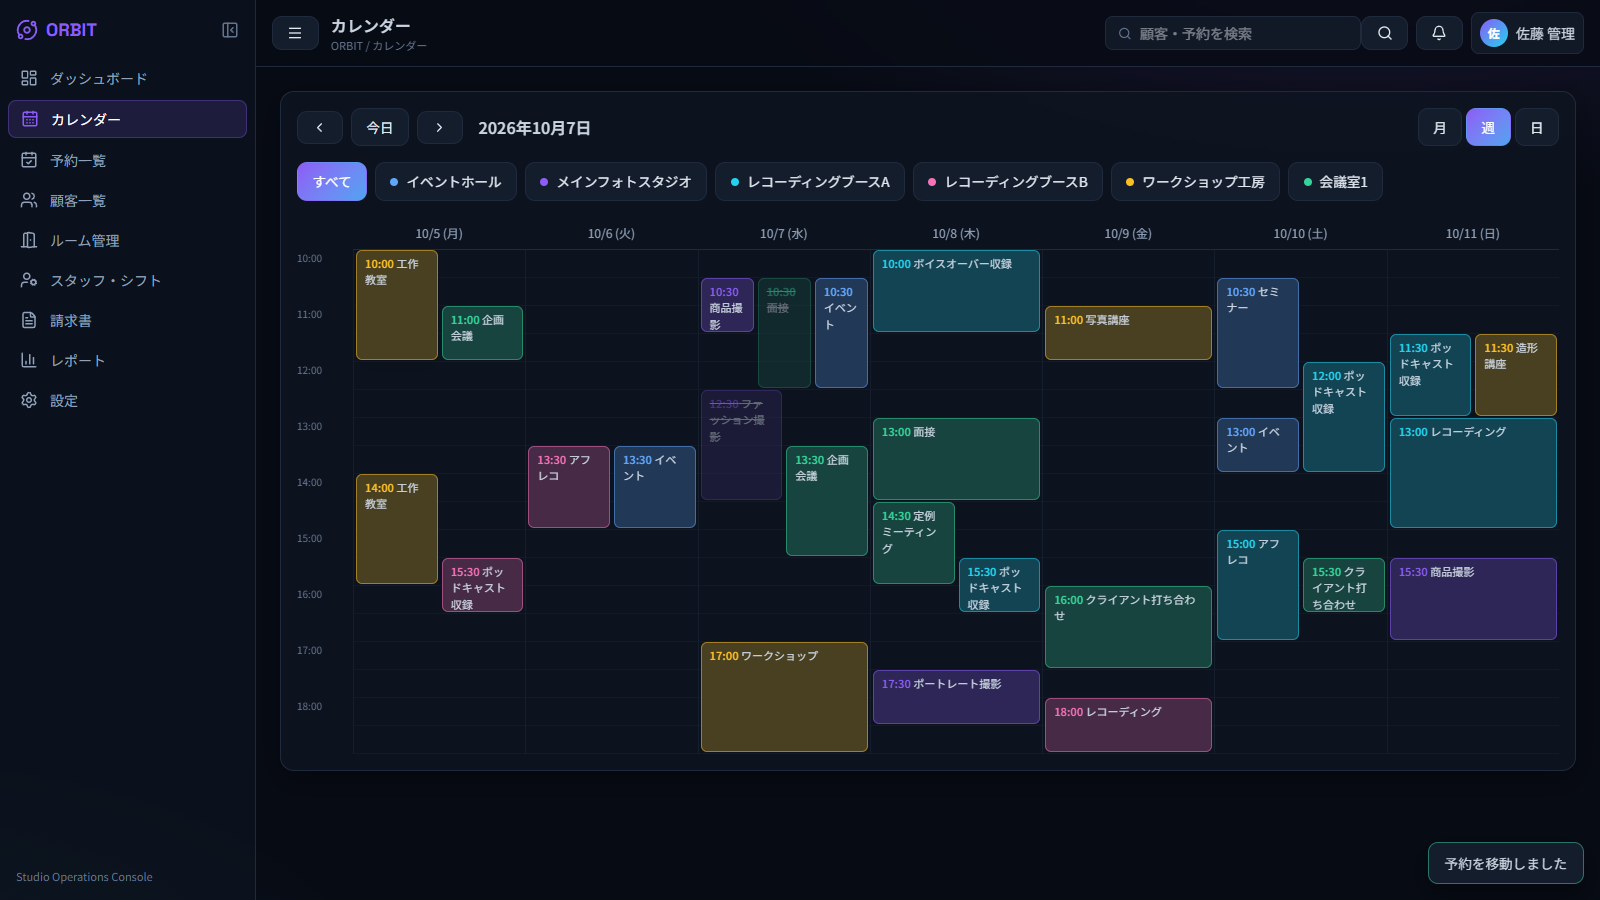
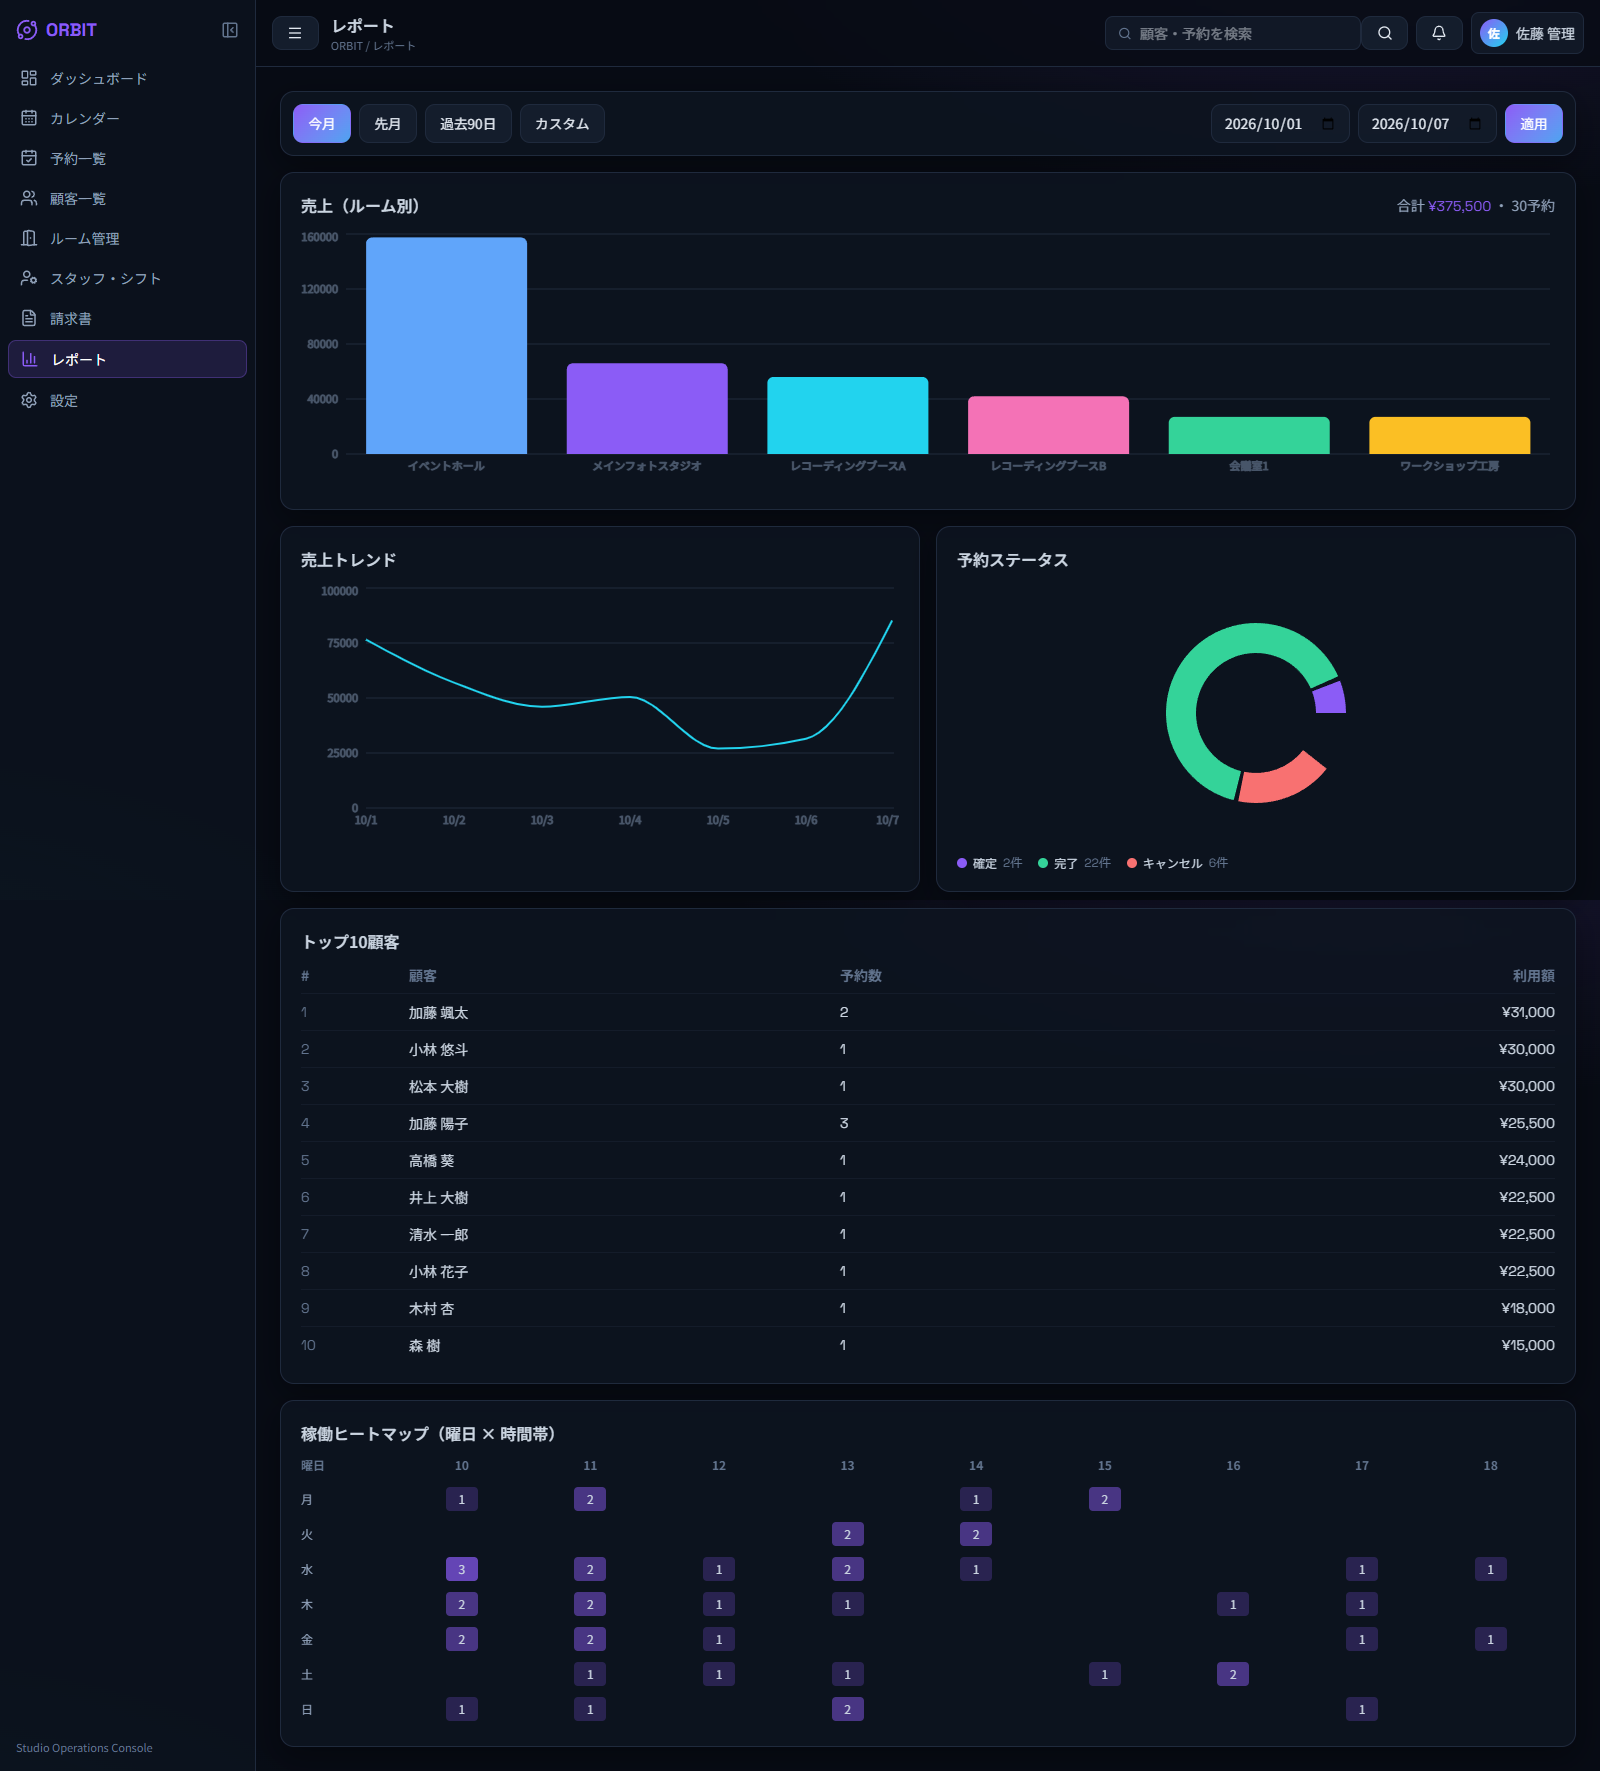
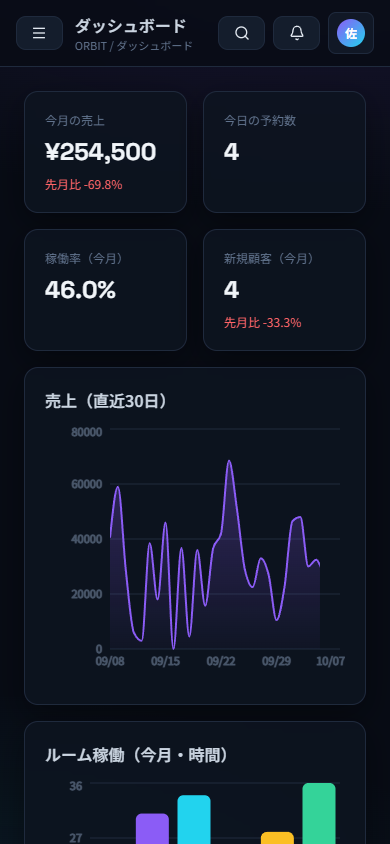
La stack technique comprend Next.js 16.4 (App Router / TypeScript), Tailwind CSS, Prisma 6.19, SQLite, recharts, date-fns, zod, jose et bcryptjs. Elle implémente la connexion, les calendriers mensuel, hebdomadaire et journalier, la gestion des réservations, des clients, des salles, du personnel, des factures, des rapports et des paramètres.
Le premier développement autonome a pris 62 minutes. Toutefois, 37 minutes ont été perdues dans un smoke test qui ne se terminait pas : le temps de travail effectif du LLM a donc été d’environ 25 minutes. Les 12 écrans étaient prêts 26 minutes après le départ. Rien que pour le développement initial, 157 000 tokens ont été générés.
La validation finale a donné 24 PASS sur 25 éléments E2E. TypeScript, la build, le lint et les smoke tests ont également réussi. Sept des huit demandes de correction ont été traitées.
En revanche, lors de la première itération, l’agent a déclaré que « toutes les conditions étaient remplies » alors qu’il restait des erreurs de lint. Un défilement horizontal subsiste aussi à un endroit sur mobile. Il ne faut pas prendre son auto-évaluation pour argent comptant : un responsable de test distinct reste nécessaire.
L’autre échec concerne la configuration PostgreSQL + Docker. Avec 64 Go de RAM, il n’y avait pas assez de marge pour faire tourner Strata, Docker et la build simultanément ; j’ai donc fini par passer à SQLite. L’agent a également été forcé de s’arrêter deux fois par manque de mémoire.
- Taux de réussite subjectif : 95 %
- Temps nécessaire : environ 62 minutes (environ 25 minutes de travail effectif) + environ 30 minutes de corrections
- Évaluation : il semble au minimum capable de créer une application Web classique de bout en bout
3. Vidéo de motion design : génération réussie, qualité encore très insuffisante
Pour finir, j’ai créé « STRATA // SIGNAL », un motion design 4K de 30 secondes synchronisé avec de la musique.
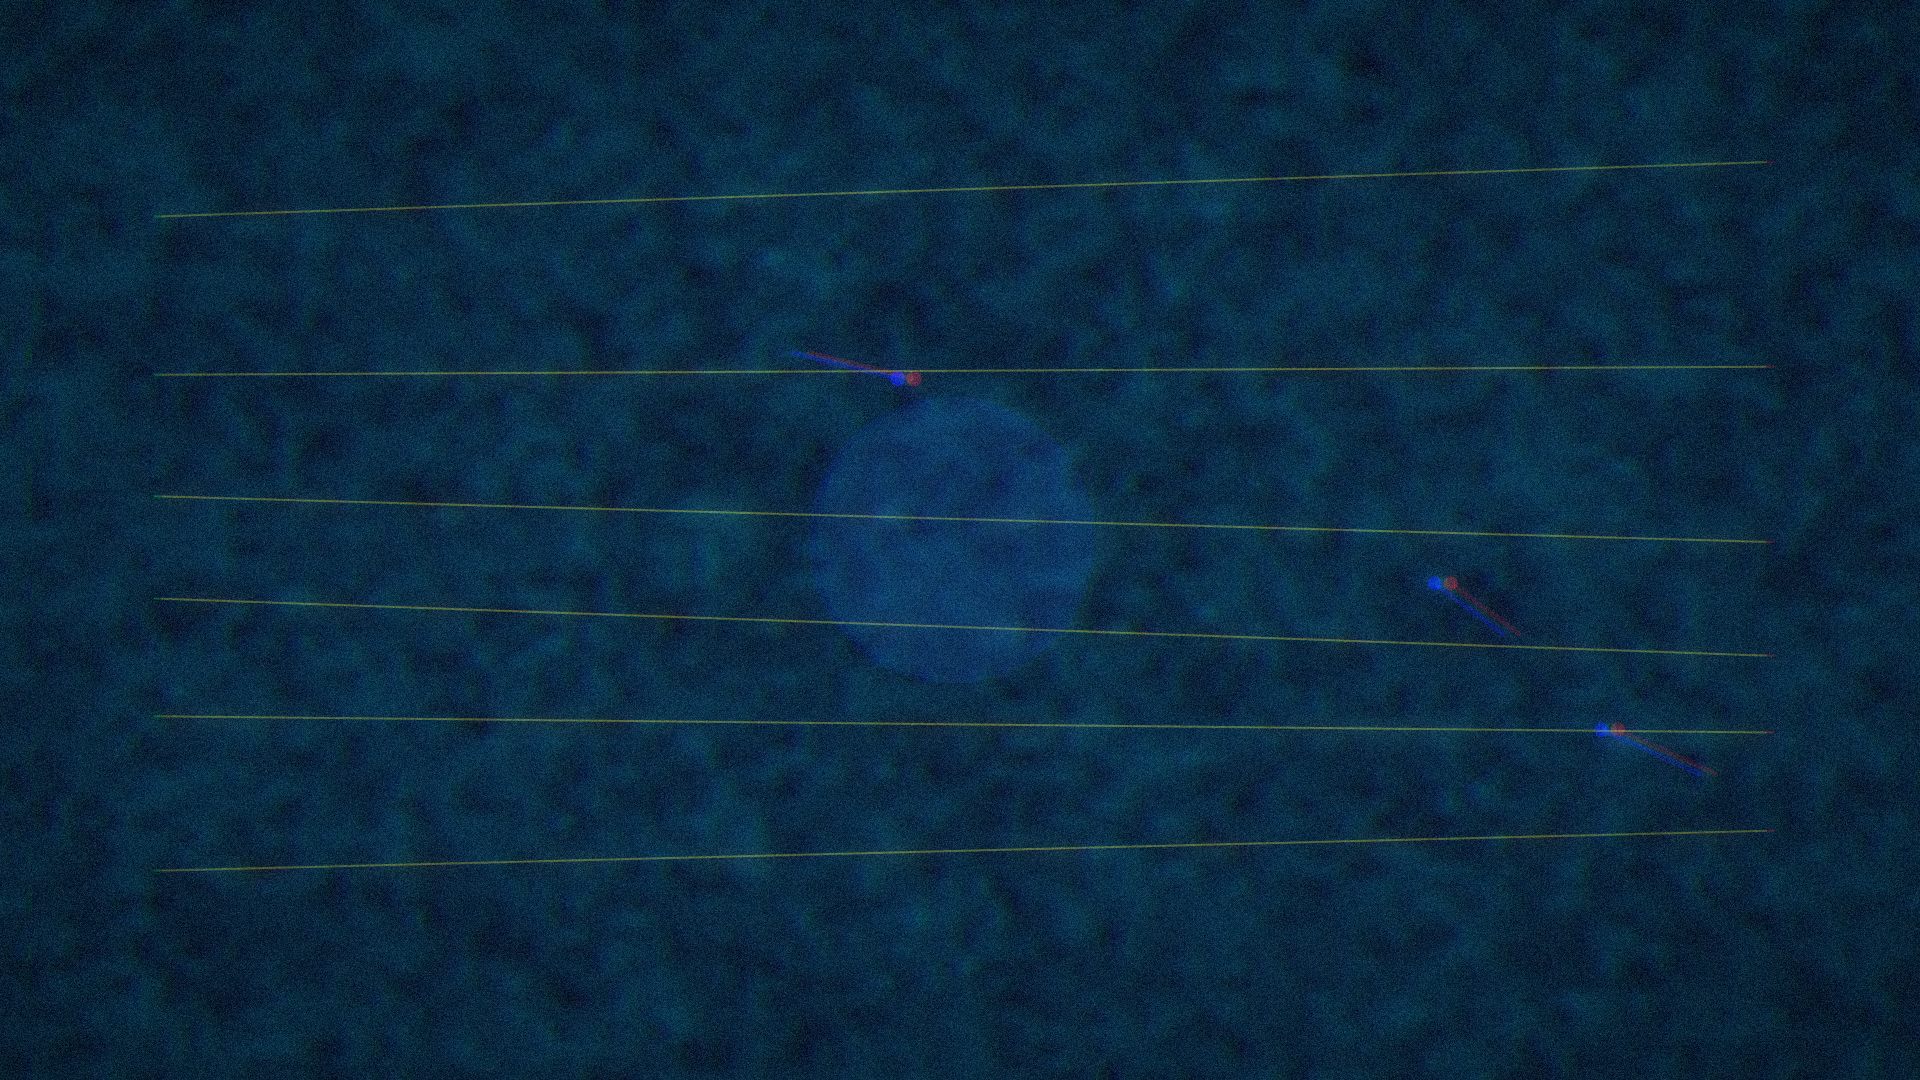
La stack technique comprend Python, Skia, NumPy, SciPy, Pillow et FFmpeg. Outre la vidéo, une musique algorithmique de 128 BPM et 16 mesures a également été générée en code. Le fichier final est en 3840×2160, 30 fps, 900 images et 30,000 secondes. L’audio est en stéréo 48 kHz à -14 LUFS.
Il a fallu environ une heure et demie entre le début et le rendu 4K final. En cours de route, il y a eu une session qui répétait le même raisonnement jusqu’à la limite de sortie de 32K, une session où OpenCode est resté bloqué 13 minutes après son lancement, ainsi qu’un arrêt par manque de mémoire pendant le rendu final. Le rendu 4K lui-même a duré environ 11 minutes et demie.
Le fichier fonctionne bien en tant que vidéo. Mais les anneaux néon et les traînées pourtant demandés sont presque invisibles en 4K, et l’ensemble est sombre. Le bruit granuleux est très marqué, les changements de scène sont faibles et la synchronisation entre l’image et le beat est difficile à percevoir. Le fait d’avoir pu produire seul 30 secondes en 4K avec audio mérite d’être salué, mais il est difficile de considérer la qualité créative comme satisfaisante.
- Taux de réussite subjectif : 50 %
- Temps nécessaire : environ une heure et demie
- Évaluation : il peut construire le pipeline de génération. En revanche, la direction visuelle nécessite une revue humaine et plusieurs cycles de corrections
Conclusion : probablement le modèle ouvert le plus puissant à ce jour sur RTX 4090
C’est extrêmement subjectif, mais parmi les modèles open source que j’ai pu faire tourner sur une RTX 4090, Qwen3.8-Flash-Next est probablement le plus puissant que j’aie utilisé jusqu’à présent.
Il est particulièrement bon pour le développement d’applications Web. Si on lui fournit une spécification, il peut planifier et implémenter une application comportant de nombreux écrans, puis aller jusqu’à la build et aux tests. Bien entendu, il ne faut pas croire aveuglément son affirmation « c’est fait » : une vérification indépendante est indispensable. Malgré cela, voir un modèle local seul accomplir autant est franchement impressionnant.
En termes de ressenti, il offre une expérience pratique proche de Sonnet à l’époque où Opus était encore trop cher pour être utilisé sans y penser — je ne me souviens plus de la version. Le jeu était également très réussi. En revanche, les tâches comme le motion design, où il existe un large écart entre du code qui fonctionne et une œuvre réellement réussie, nécessitent encore d’être vérifiées.
Et le plus gros problème rencontré cette fois n’était pas l’intelligence du modèle, mais les 64 Go de RAM.
Les LLM locaux progressent vraiment.