Guide complet de Qwen-Image 2.1 : génération, édition et PNG transparents avec 7B, 100 exemples populaires sur Reddit
Le 20 septembre 2026, l’équipe Qwen a publié son modèle de génération d’images « Qwen-Image 2.1 ». Sa principale particularité est de réunir dans un seul modèle la génération d’images à partir de texte, l’édition à partir d’images de référence, la composition de plusieurs images, l’édition locale et la génération ou l’édition sur fond transparent (RGBA). Sa partie générative compte 7 milliards de paramètres. Plutôt que de viser uniquement des modèles toujours plus grands, il cherche un format et une efficacité de traitement adaptés aux environnements locaux.
En bref, Qwen-Image 2.1 est particulièrement intéressant moins comme modèle capable de créer la meilleure image possible à partir de rien que comme modèle de production : il préserve relativement bien les images existantes, combine plusieurs éléments et modifie précisément les zones visées. Sur Reddit, les évaluations les plus positives concernent l’édition, la cohérence des personnages, la composition de produits, l’outpainting et les éléments transparents. À l’inverse, des faiblesses nettes sont signalées pour les mains, les visages lointains, le bruit des détails, les noirs bouchés, la restauration de photos anciennes et les styles anime.
Cet article rassemble toutes les fonctions à partir des informations officielles et synthétise, à travers les principaux fils Reddit, les tests de génération et d’édition qui ont fait parler d’eux sous la forme de « 100 exemples ». Ces 100 éléments ne correspondent pas à 100 publications indépendantes : ils comptent des thèmes de création et des opérations d’édition testés dans plusieurs publications populaires, galeries et workflows.
Qu’est-ce que Qwen-Image 2.1 ?
Qwen-Image 2.1 est un modèle intégré de génération et d’édition d’images de la famille Qwen. Selon la présentation officielle, la partie générative utilise un DiT Single-Stream de 32 couches et 7 milliards de paramètres. Qwen3-VL 8B transforme les instructions textuelles et les images conditionnelles en une représentation commune, tandis qu’un VAE RGBA à 64 canaux assure une compression spatiale par 16 et une transparence native.
Les améliorations mises en avant officiellement sont les quatre suivantes.
- Compact et efficace : l’attention à granularité mixte et la réutilisation du cache KV de préfixe améliorent l’équilibre entre qualité et coût de calcul.
- Génération et édition unifiées : les images ordinaires et transparentes peuvent être générées et éditées avec le même modèle.
- Édition polyvalente : prise en charge de jusqu’à 10 images de référence, de désignations locales par masque ou dessin, et préservation de l’identité des personnes et des produits.
- Texture et esthétique : amélioration de la typographie, de l’éclairage des portraits et des textures fines.
Sources : blog officiel de Qwen, GitHub officiel, documentation Diffusers
Vue d’ensemble des fonctions
1. Génération d’images à partir de texte
Le modèle prend en charge la génération Text-to-Image classique. Il peut traiter non seulement des instructions brèves, mais aussi, grâce à Qwen3-VL, des descriptions naturelles longues et complexes comprenant composition, lumière, matériaux, premier plan, arrière-plan et éléments textuels. Les exemples officiels utilisent principalement 40 étapes ; la communauté teste aussi des LoRA d’accélération à 8 à 16 étapes et des réglages privilégiant la qualité à 30 à 40 étapes.
2. Édition d’images
En fournissant simultanément une image d’entrée et une instruction, il est possible de modifier les couleurs, la météo, le fond, les vêtements, la pose, les matériaux, l’éclairage ou l’angle de caméra. Sur Reddit, beaucoup estiment que le modèle est plus fort en édition qu’en T2I pur.
3. Jusqu’à 10 images de référence
Il peut intégrer dans une même scène des personnes, vêtements, chaussures, sacs, chapeaux, meubles ou produits provenant d’images distinctes. Les exemples officiels incluent une photo de groupe réunissant les visages de six personnes, un essayage virtuel avec cinq éléments et un aménagement intérieur avec dix meubles. Toutefois, la communauté rapporte aussi que plus le nombre de références augmente, plus les instructions conflictuelles et les mélanges d’attributs deviennent probables.
4. RGBA natif et arrière-plan transparent
Au lieu de simplement supprimer l’arrière-plan en post-traitement, le modèle peut générer directement des images contenant un canal de transparence. Il convient notamment à l’extraction d’un sujet d’une photo, à la modification de la forme d’un élément transparent ou à la création d’assets transparents composés de plusieurs éléments.
5. Édition locale et par masque
Les zones à modifier peuvent être désignées par des cercles, des annotations coloriées ou des masques indépendants. Dans ComfyUI, des essais consistent à peindre des zones sur l’image et à donner des instructions telles que « modifier uniquement le vêtement dans la zone rouge ». Associé à LanPaint, il permet aussi l’inpainting du canal alpha lui-même, et pas seulement des couleurs.
6. Outpainting
Il peut agrandir la toile vers le haut, le bas, la gauche ou la droite et compléter les zones vides en fonction du contexte de l’image d’origine. Sur Reddit, un rapport indiquant qu’il peut étendre plusieurs directions en une seule fois, plus vite que les workflows spécialisés traditionnels, a attiré l’attention.
7. Préservation de l’identité
L’usage central consiste à conserver le visage, les vêtements ou la pose d’une personne, ainsi que la forme et les éléments de marque d’un produit, tout en ne modifiant que le fond ou certains attributs. Cette capacité est particulièrement discutée pour les fiches de personnages et la création de plans successifs ; les angles extrêmes, les expressions fortes et les longues séquences nécessitent toutefois de vérifier la dérive.
8. Rendu de texte et design
Le modèle prend en charge les images comportant des affiches, emballages, panneaux et typographie. Un workflow populaire consiste à organiser d’abord la composition, la hiérarchie de l’information, la taille des textes et les marges avec un LLM externe. Des rapports signalent toutefois l’insertion involontaire de chinois dans des infographies anglaises.
9. Réécriture de prompts
Le dépôt officiel contient des réécriteurs de prompts pour T2I et I2I. Ils développent une demande courte en composition détaillée et, lors de l’édition, la réécrivent pour préserver les éléments hors de la zone à modifier. La communauté rapporte aussi que des modèles adaptés à des usages précis peuvent parfois être meilleurs que la réécriture standard.
10. Accélération, mémoire réduite et quantification
Le modèle prend en charge le CPU offload de Diffusers, le cache KV de préfixe de vLLM-Omni, CUDA Graph, FP8, le parallélisme tensoriel, ainsi que le déchargement mémoire et les noyaux optimisés de SGLang. Des variantes BF16, INT8 ConvRot, GGUF et 4 bits sont également apparues pour ComfyUI. Des utilisateurs rapportent environ deux fois plus de vitesse avec une LoRA à 4 étapes, ou des nœuds personnalisés faisant fonctionner l’extension de prompt avec 8 Go de VRAM, mais il faut toujours vérifier le compromis entre vitesse et qualité.
11. Environnements pris en charge
Les implémentations officielles, Hugging Face Diffusers, ComfyUI, vLLM-Omni, SGLang-Diffusion, LightX2V et ModelScope sont proposés. Des exemples ROCm pour AMD Radeon et une prise en charge de plusieurs puces via FlagOS sont également présentés.
12. Attention à la licence
Les poids du modèle sont publics, mais ils ne sont pas fournis sous Apache 2.0 : ils le sont sous la « Qwen Research License Agreement ». La licence officielle précise qu’une licence commerciale distincte est requise pour l’usage commercial. Elle prévoit également des obligations de notification lors de la redistribution et l’affichage de « Built with Qwen » ou « Improved using Qwen » dans la documentation des modèles d’IA dérivés. Consultez impérativement le texte original avant toute adoption professionnelle.
Source : licence officielle
50 angles vus dans les exemples officiels
Cette section présente 50 exemples centrés sur les échantillons officiels de Qwen-Image 2.1 publiés par l’équipe Qwen, mis en relation avec les points particulièrement discutés sur Reddit. Au-delà de simples « belles images », elle inclut entrées, résultats d’édition, masques, références multiples, changements de caméra et génération de documents afin de montrer où le modèle peut aider dans le processus de création.
Assets transparents et génération d’illustrations
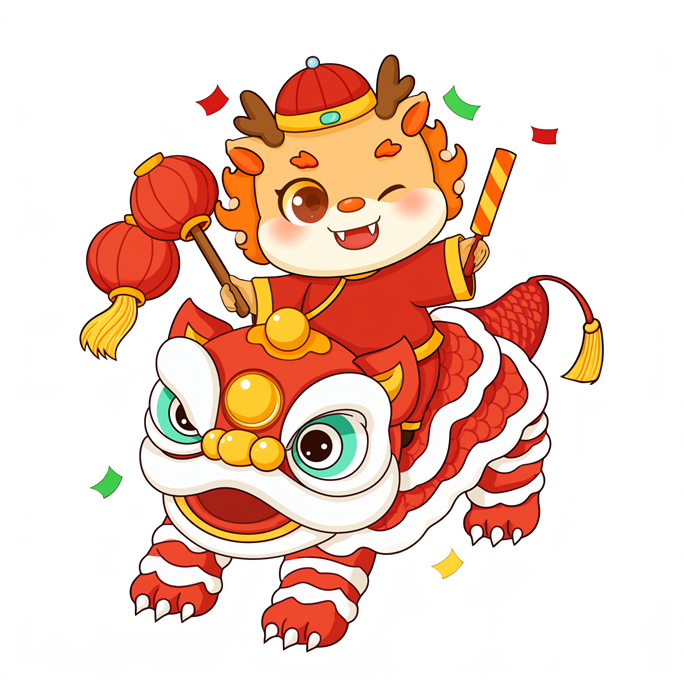
Exemple 1 : illustration transparente inspirée de la danse du lion. Un exemple qui traite simultanément des ornements détaillés des contours et un fond alpha.
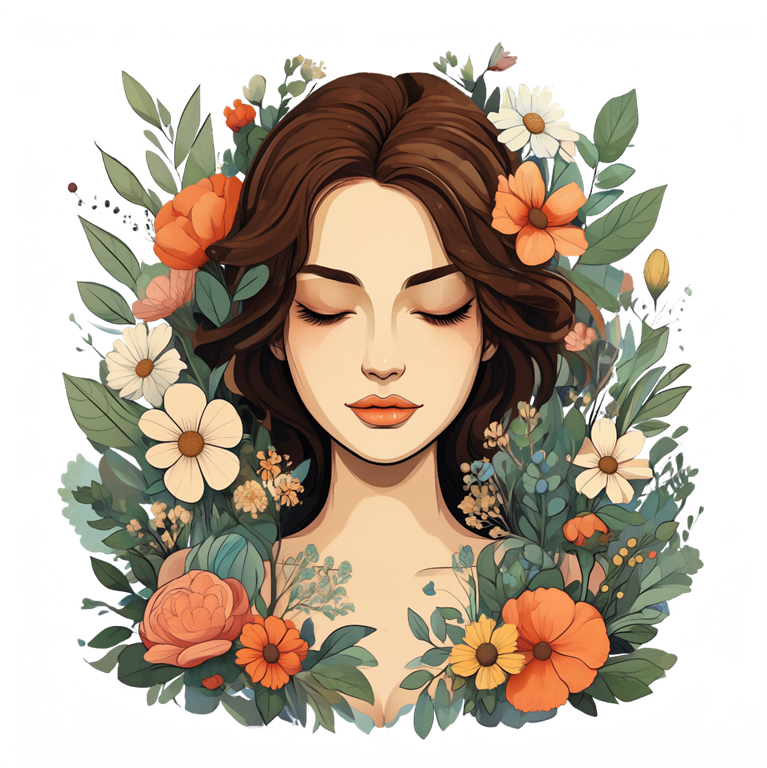
Exemple 2 : illustration décorative d’une femme entourée de fleurs. Elle comporte les limites complexes des cheveux, pétales et feuilles.
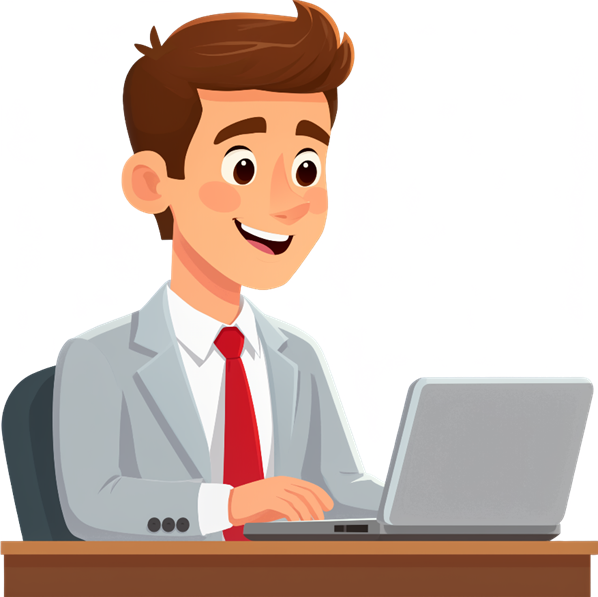
Exemple 3 : personnage professionnel utilisant un ordinateur portable. Une illustration détourée pour le Web ou les présentations.
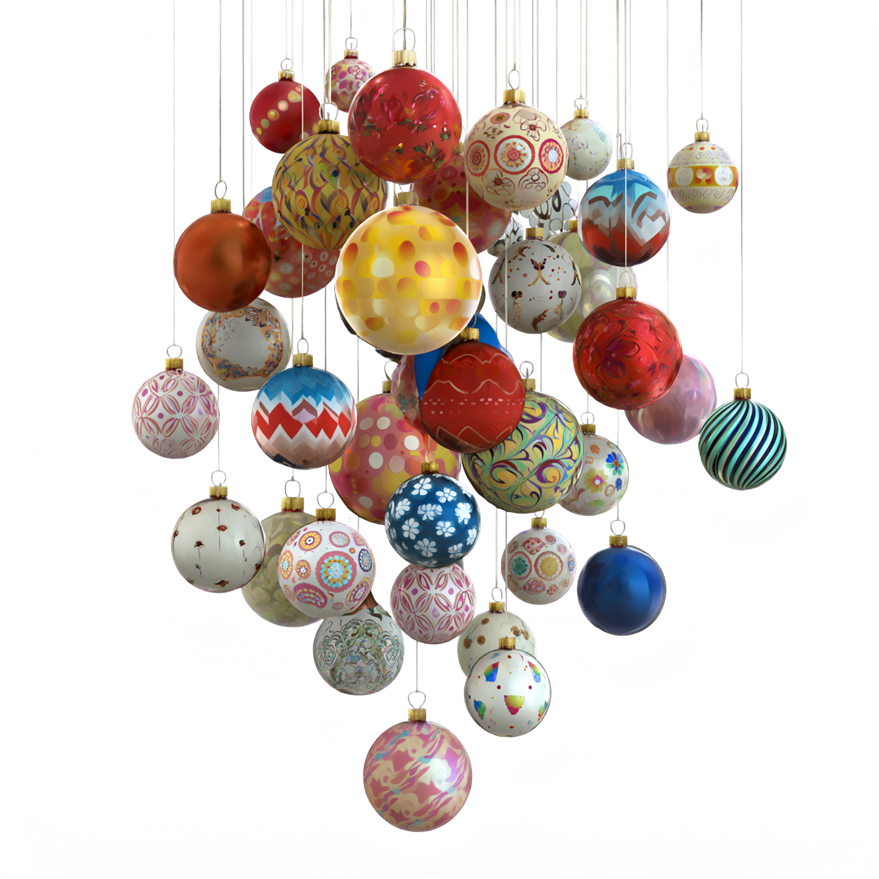
Exemple 4 : plusieurs décorations suspendues. Intègre dans une image la semi-transparence, des fils fins et différentes textures de matériaux.
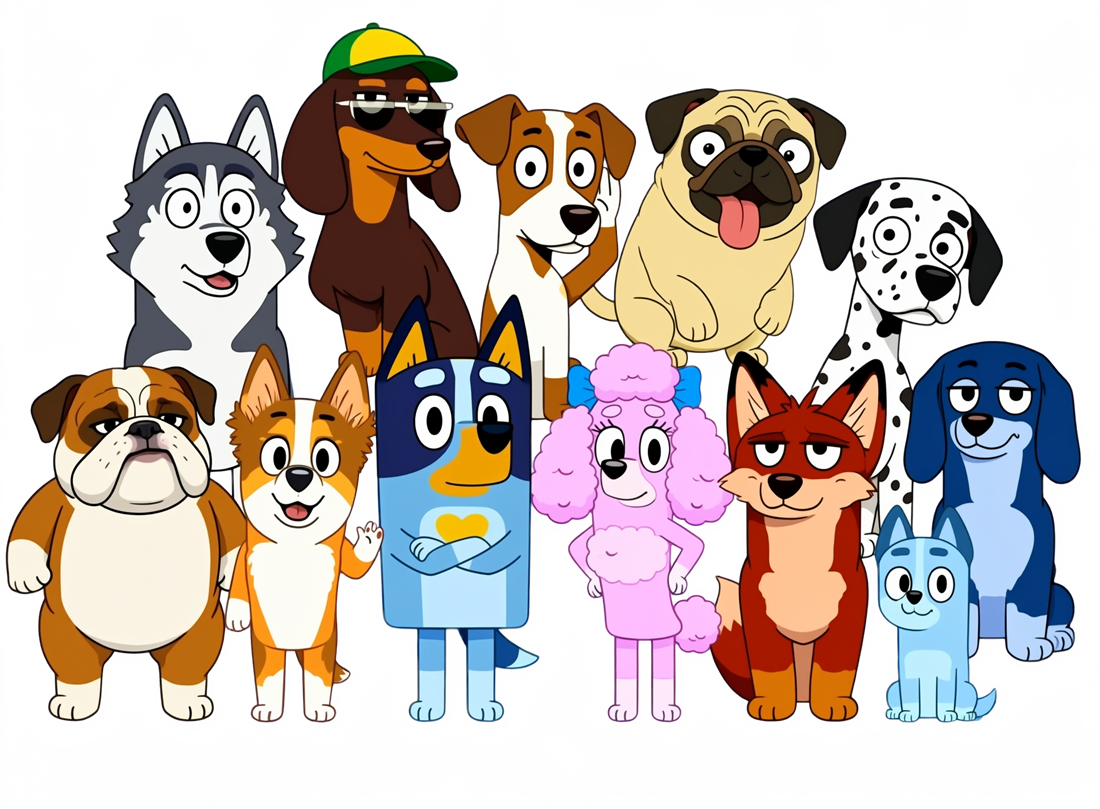
Exemple 5 : nombreux personnages de chiens. Un exemple de différenciation de plusieurs sujets et de composition de groupe.
Édition d’images et remplacement de texte
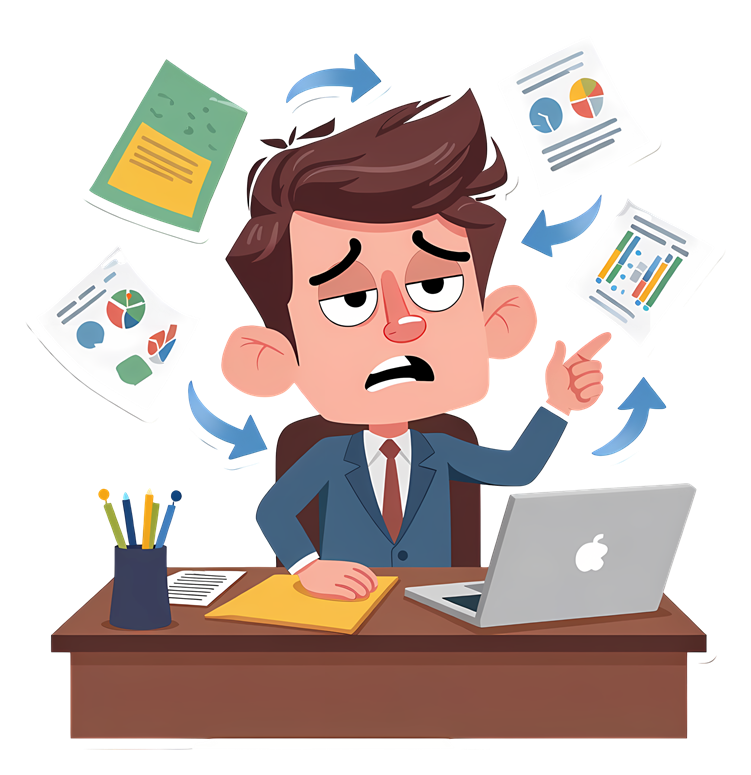
Exemple 6 : image originale d’un employé de bureau fatigué. Image conditionnelle servant à comparer le résultat d’édition suivant.
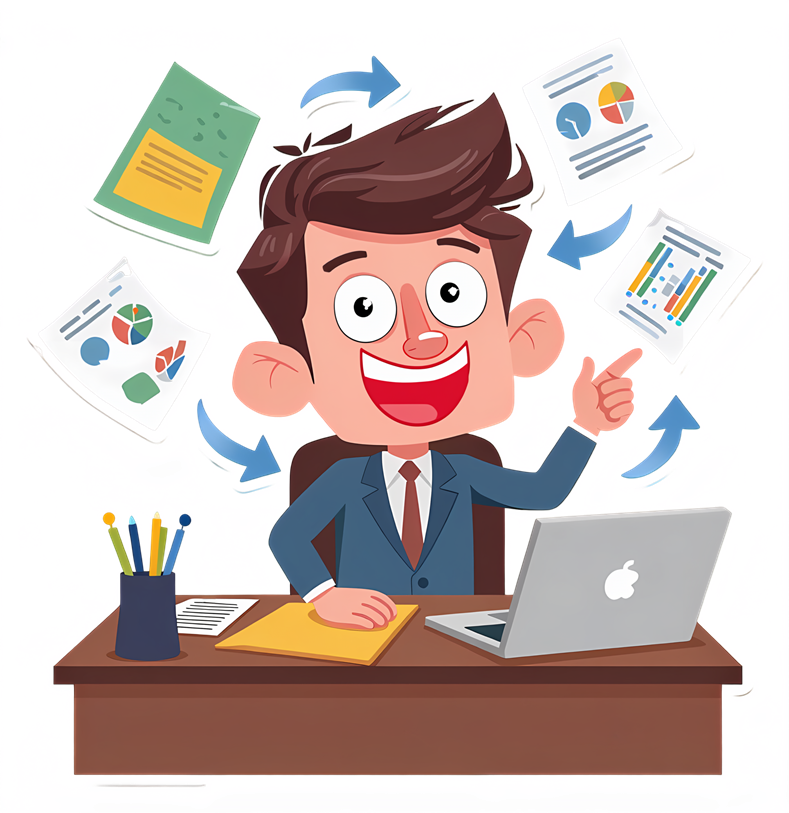
Exemple 7 : employé dont l’expression et l’ambiance ont été modifiées. L’émotion du personnage change tout en préservant la mise en page.
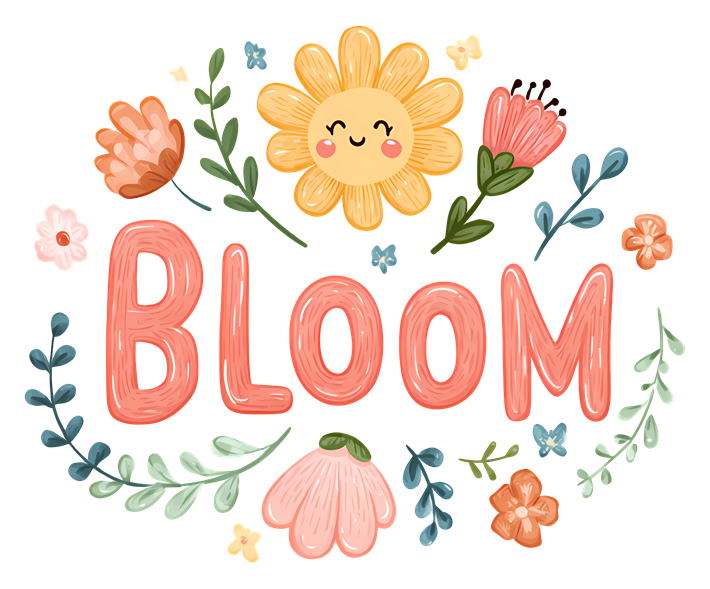
Exemple 8 : lettrage floral « BLOOM ». Exemple de référence pour le texte, les décorations et le centrage.
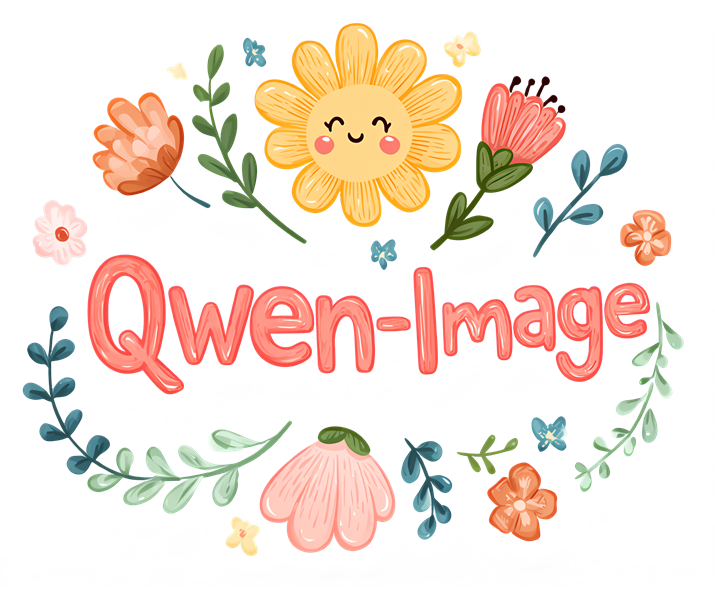
Exemple 9 : remplacement du texte par « Qwen-Image ». Édition typographique qui conserve le style floral.
Exemple 10 : photo diurne d’une tour. Exemple d’entrée pour l’édition de l’heure et de l’arrière-plan.
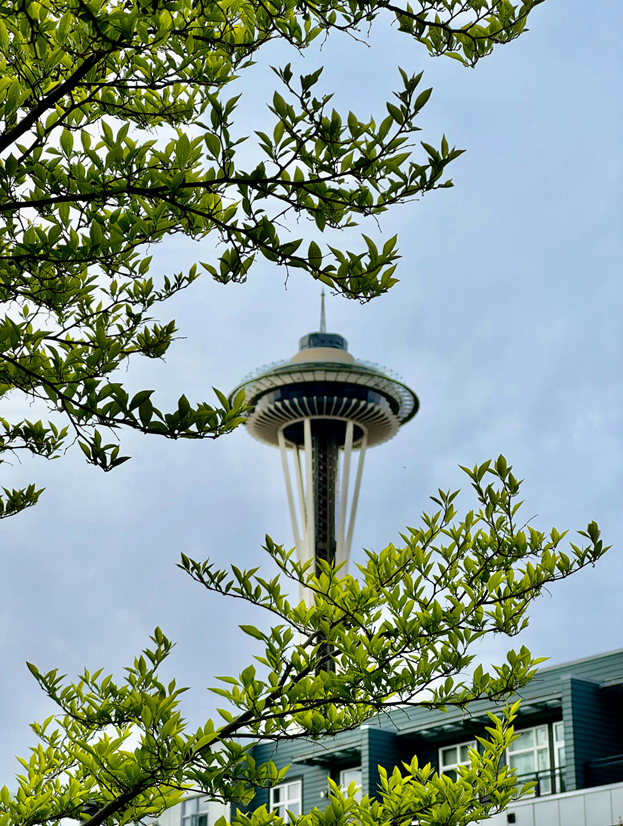
Arrière-plan, heure et plusieurs personnes
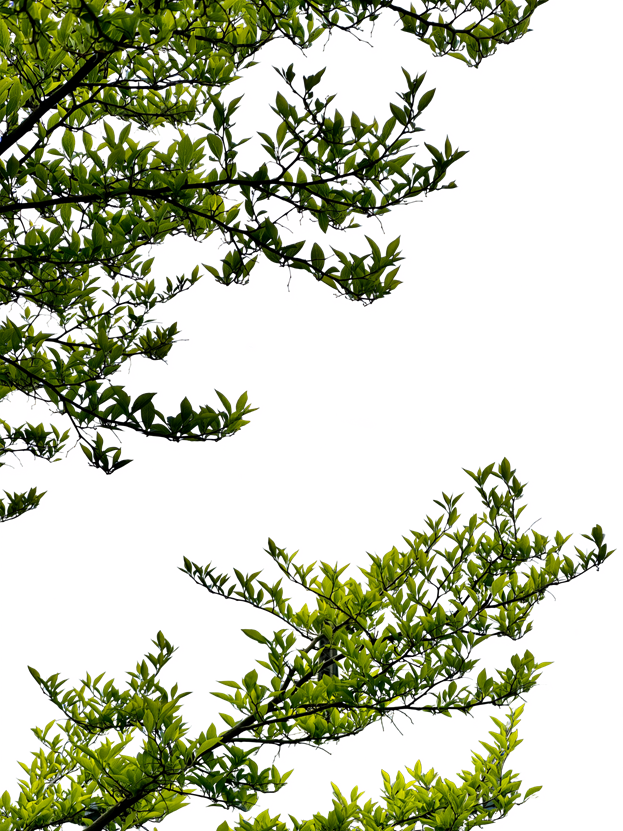
Exemple 11 : arbre fleuri la nuit. Montre la capacité à passer d’une photo de jour à une scène nocturne ou à changer l’ambiance.
Exemple 12 : génération d’une photo de groupe à partir de plusieurs références de personnes. Illustre la fonction centrale de jusqu’à 10 références.
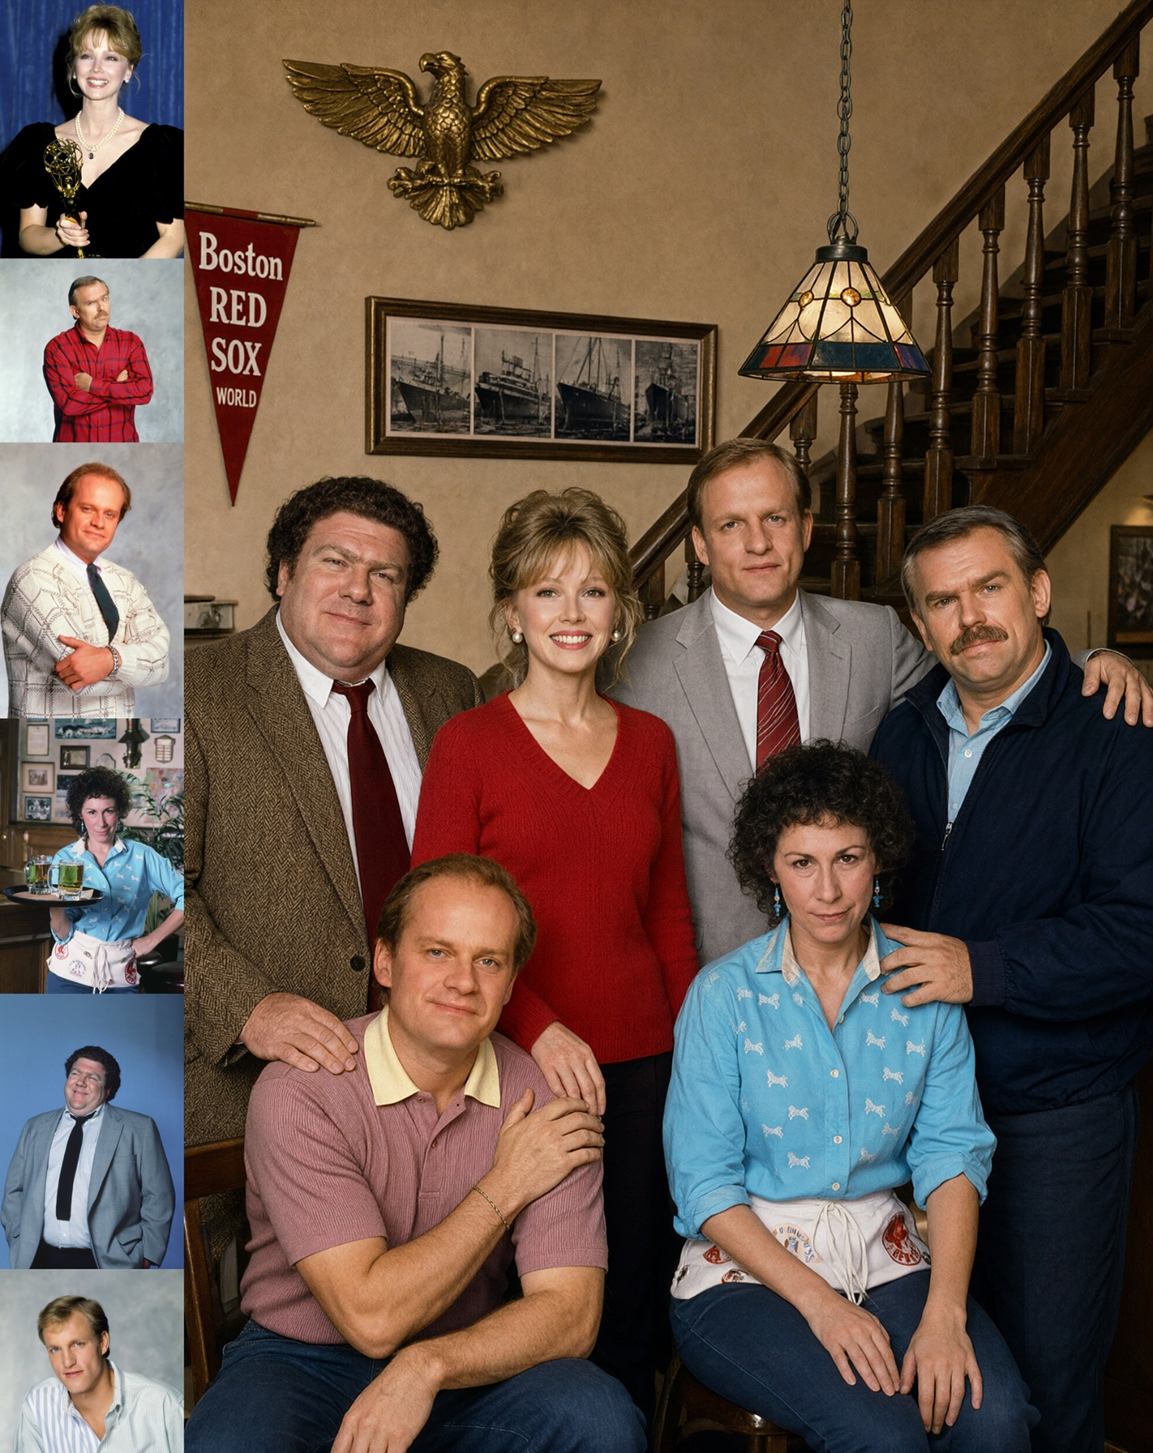
Exemple 13 : tenue créée avec plusieurs références de vêtements et de personne. Se rapproche du principe de l’essayage virtuel.
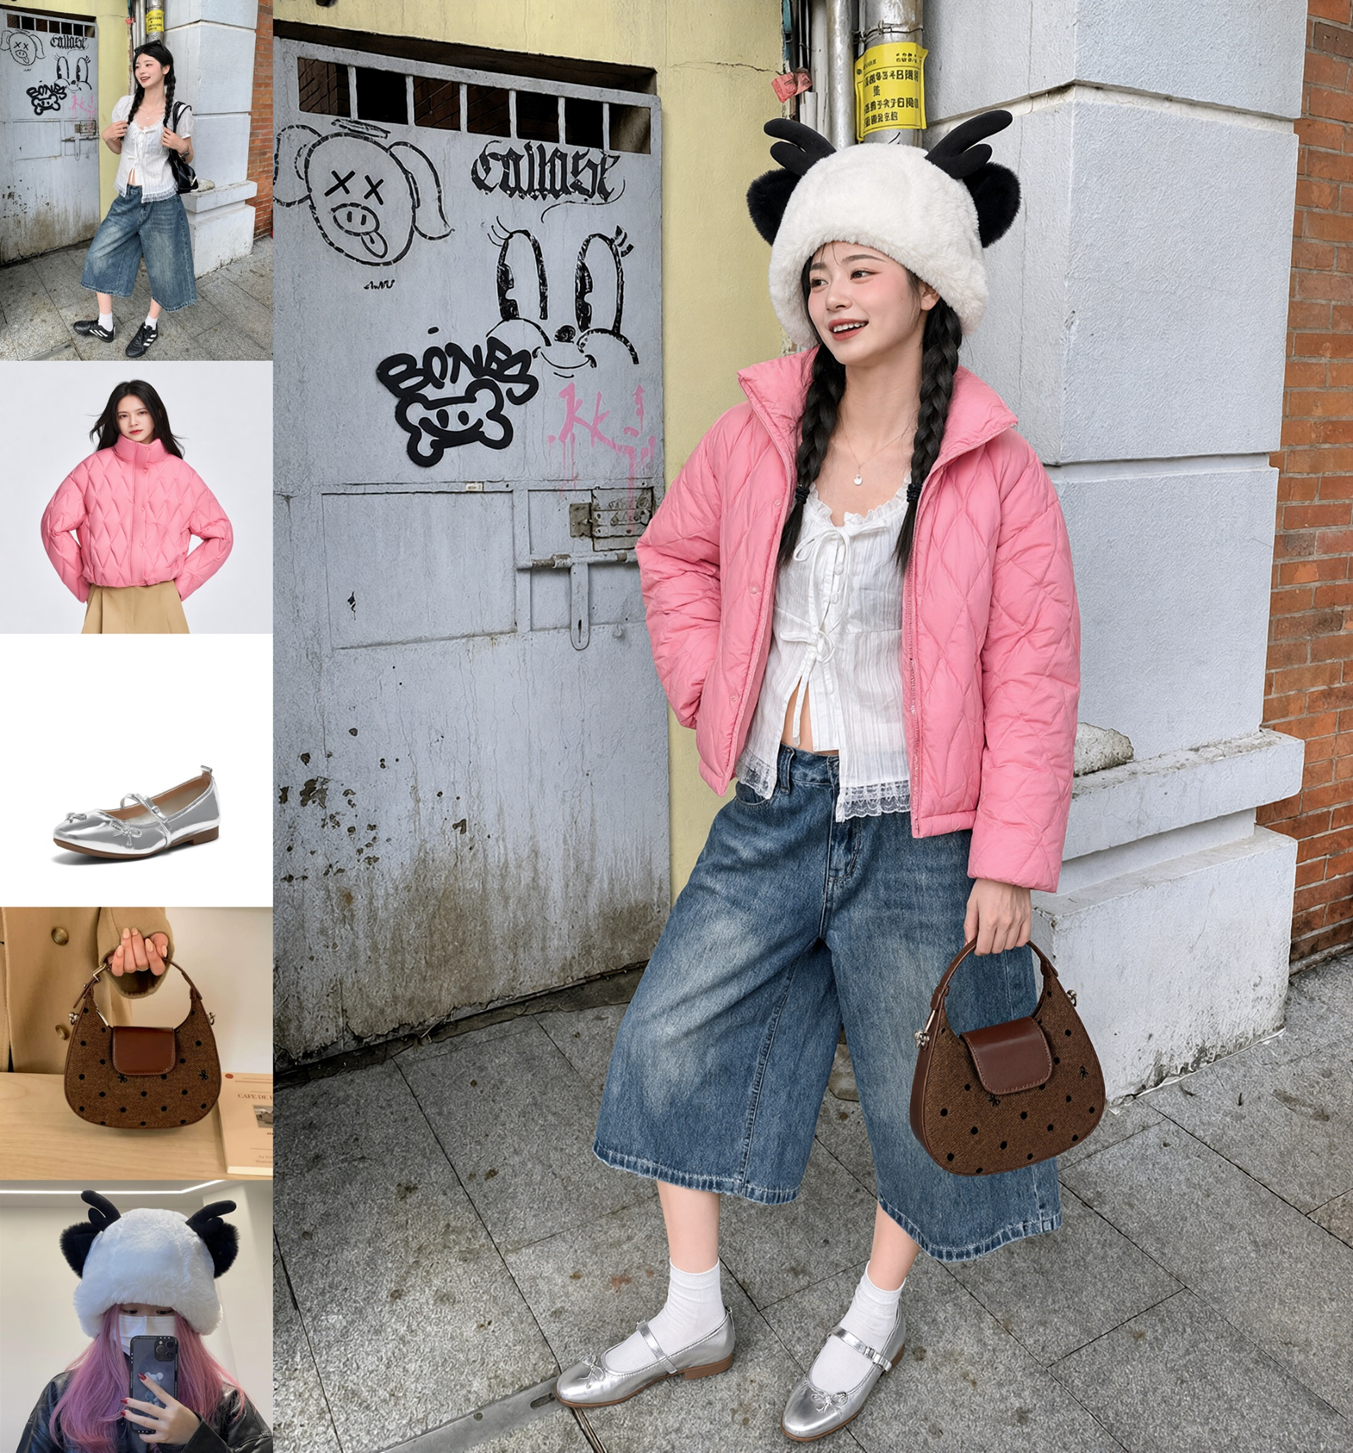
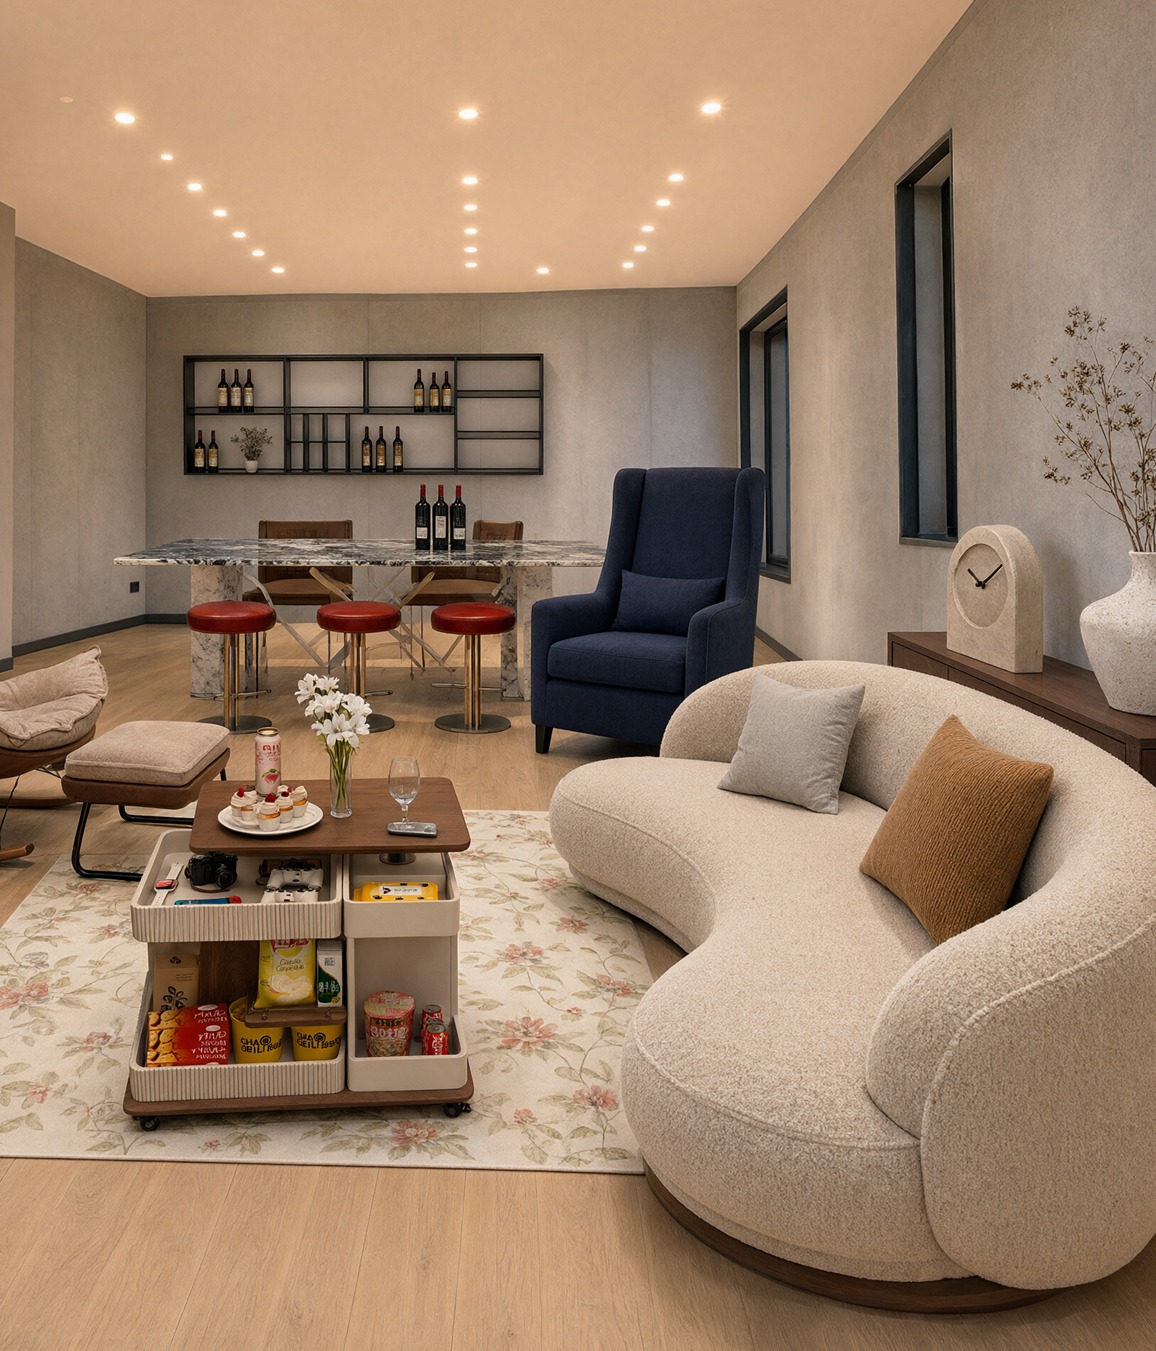
Exemple 14 : intérieur composé à partir de nombreuses images de meubles. Usage consistant à disposer un catalogue de produits dans une pièce.
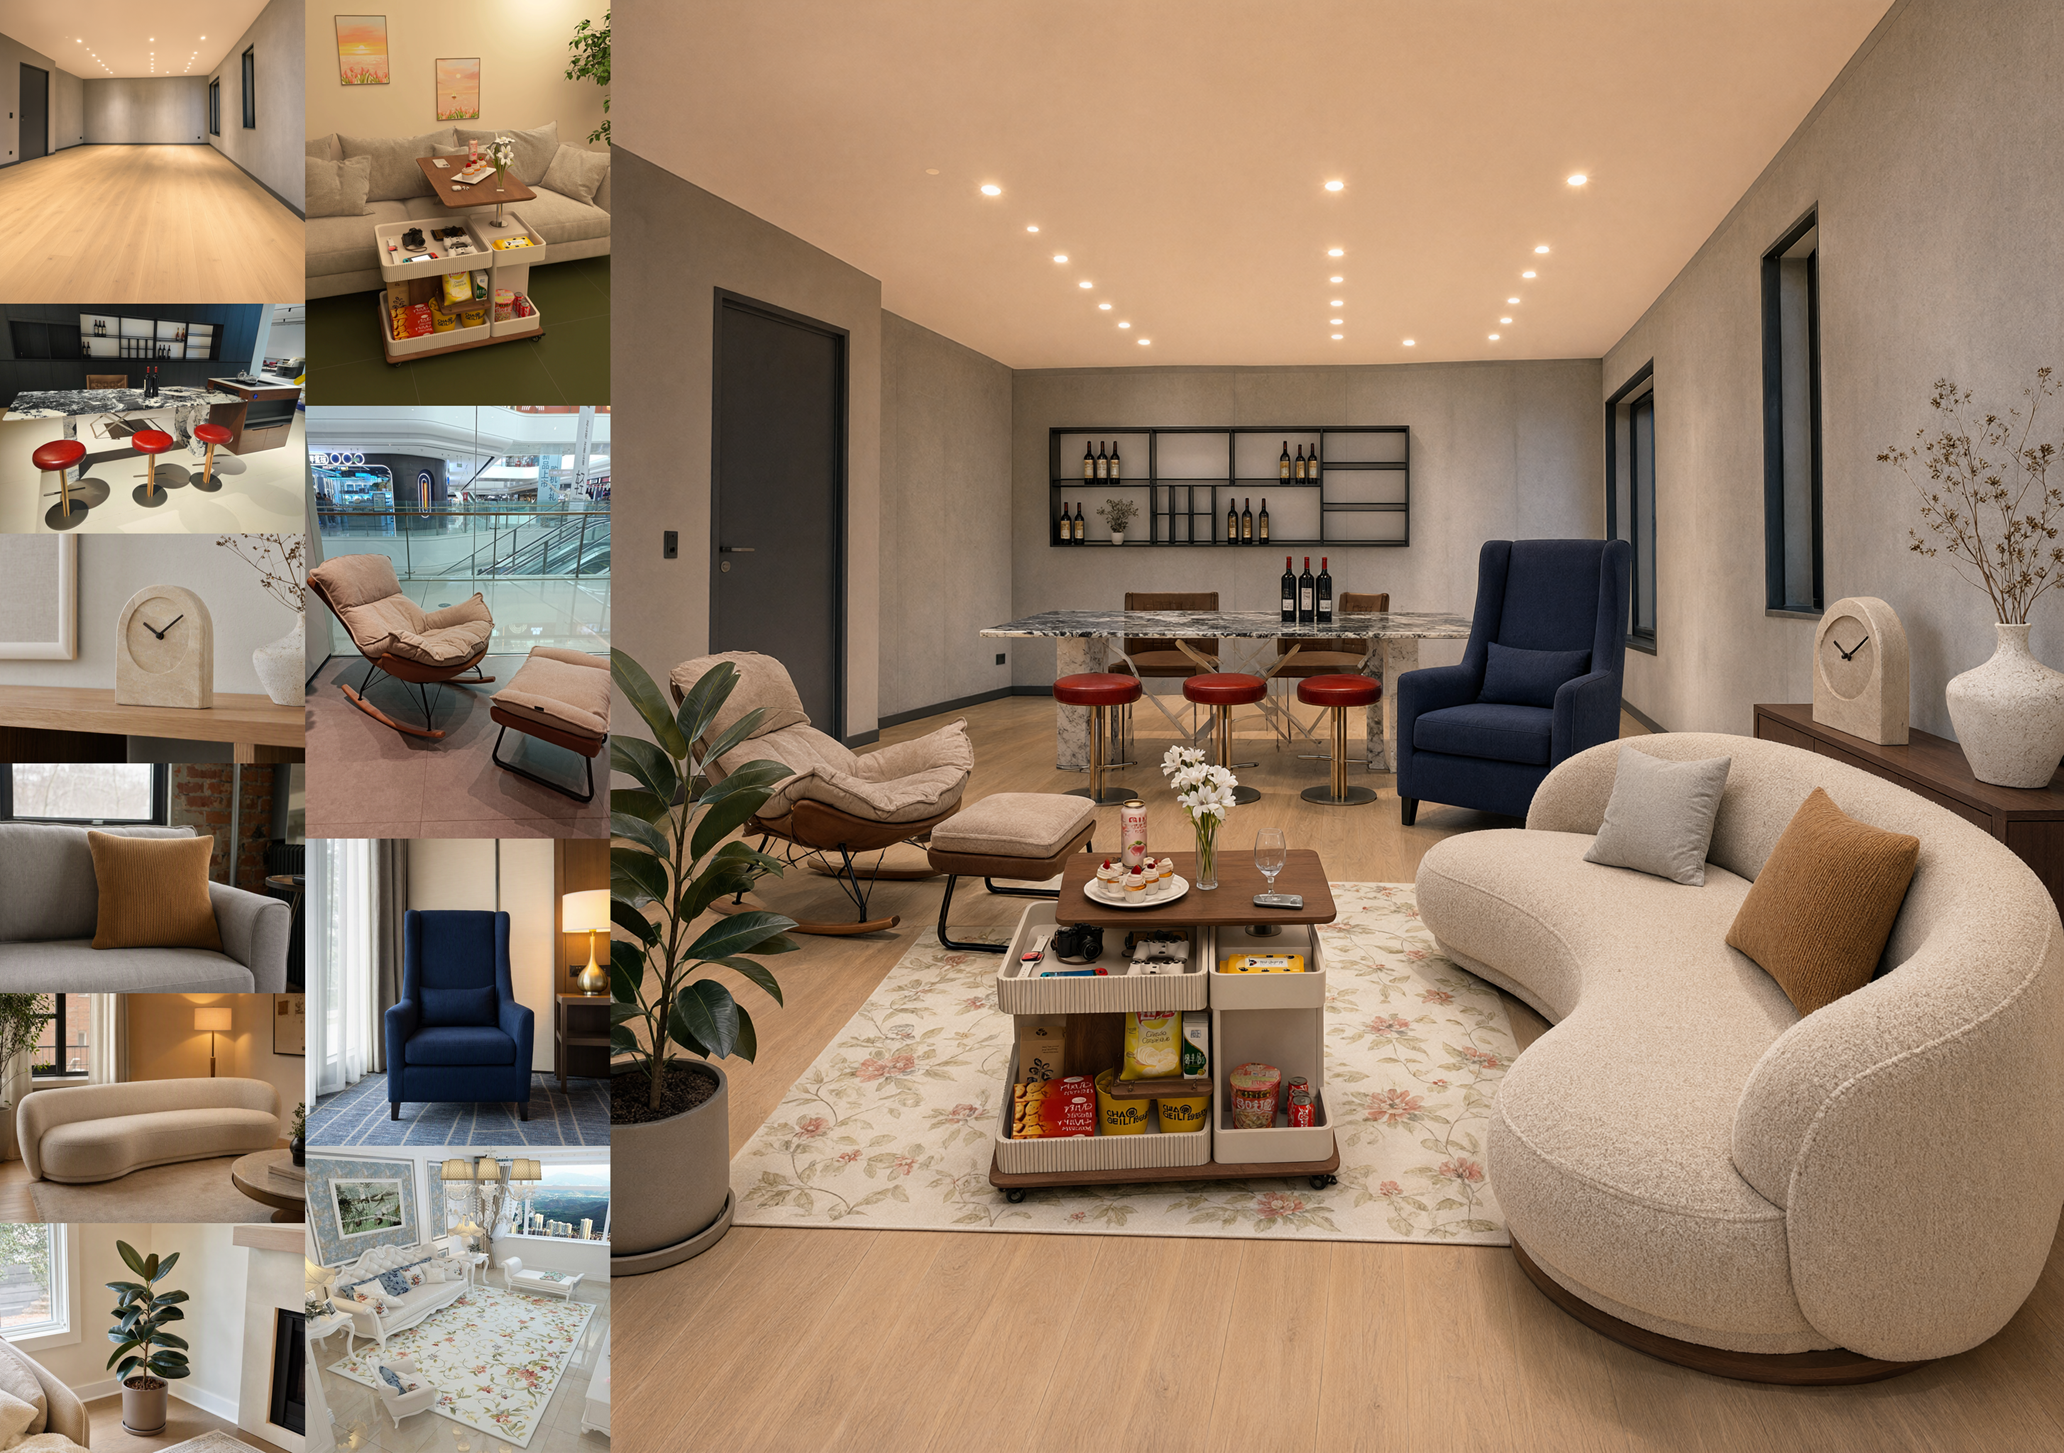
Exemple 15 : indication par couleur autour d’un chat. Entrée de désignation locale au moyen d’annotations dessinées.
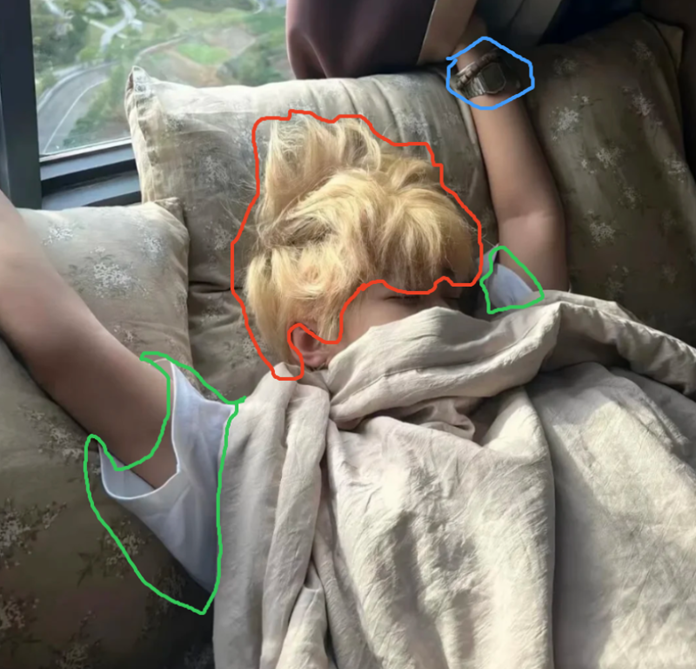
Édition locale, masques et composition
Exemple 16 : modification du chat dans la seule zone indiquée. Le sujet est remplacé tout en conservant la literie et la personne.
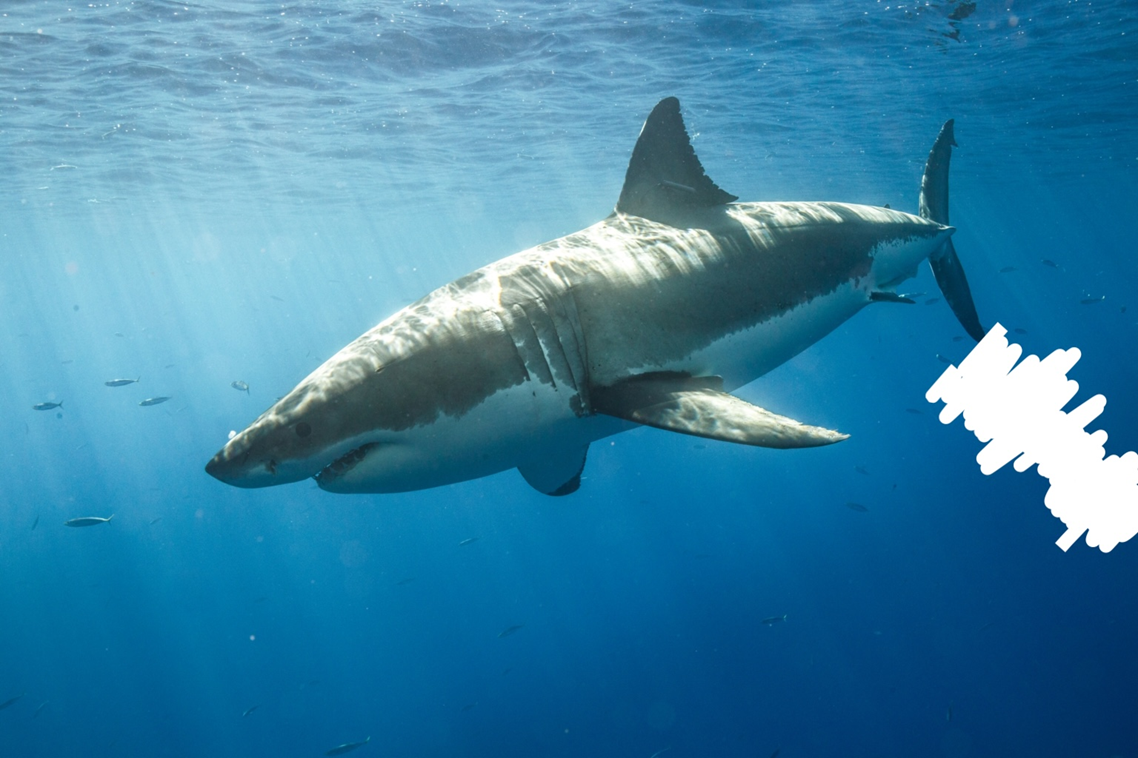
Exemple 17 : requin sous l’eau avec instruction locale. Entrée d’édition dessinée directement sur l’objet ciblé.
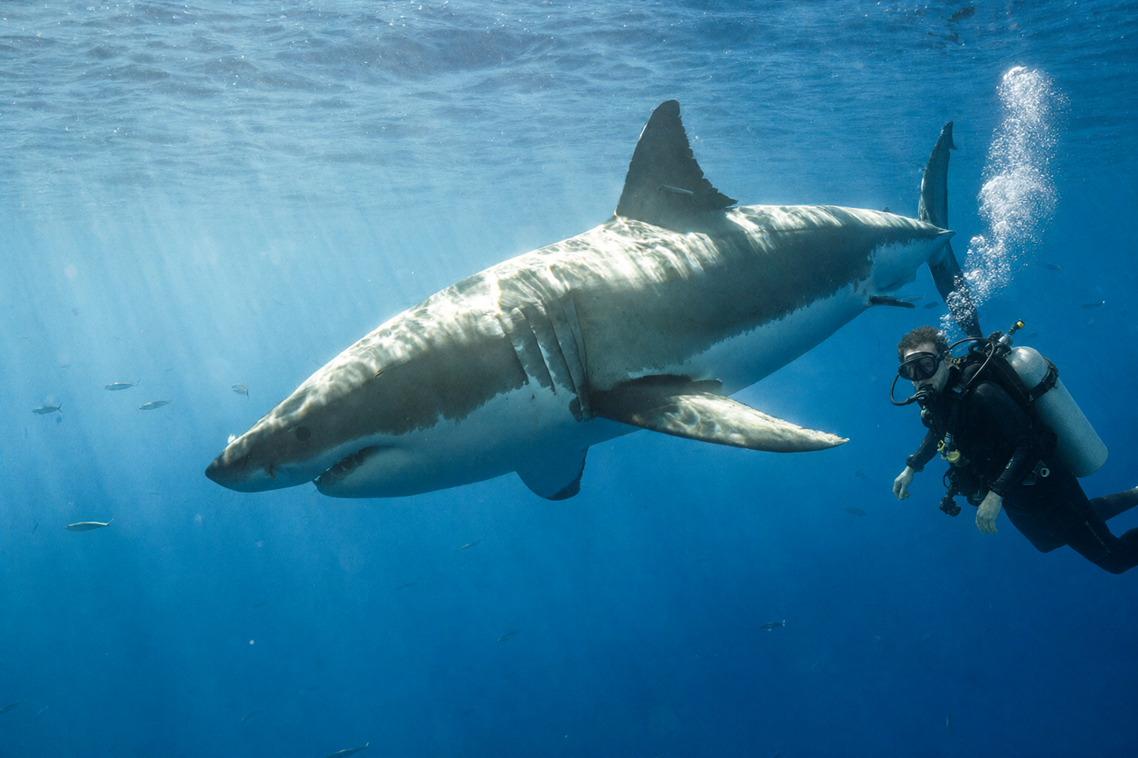
Exemple 18 : scène sous-marine avec ajout d’un plongeur. Composition qui harmonise lumière et échelle sous l’eau.
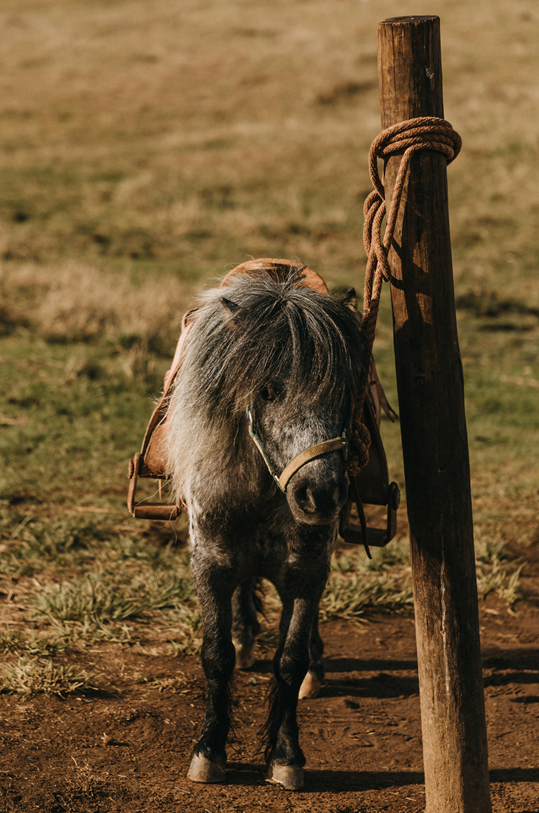
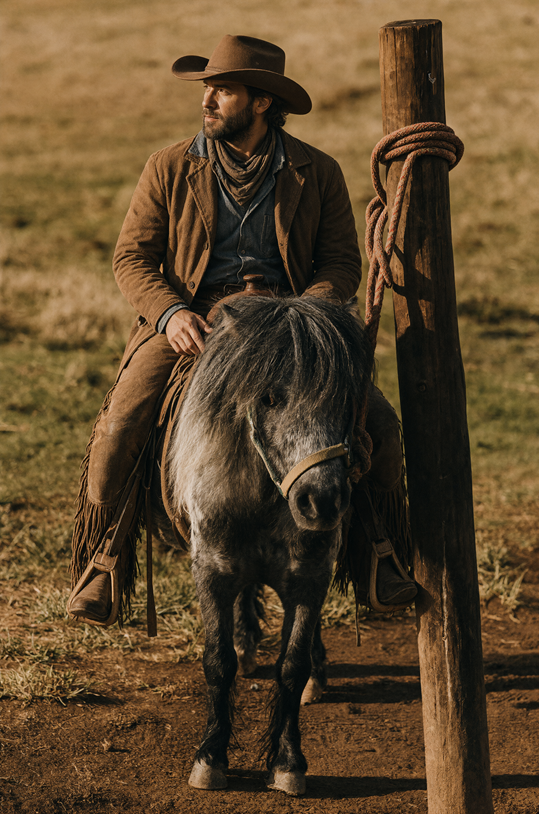
Exemple 19 : image originale d’une personne sur un âne. Photo de référence pour l’édition par masque.
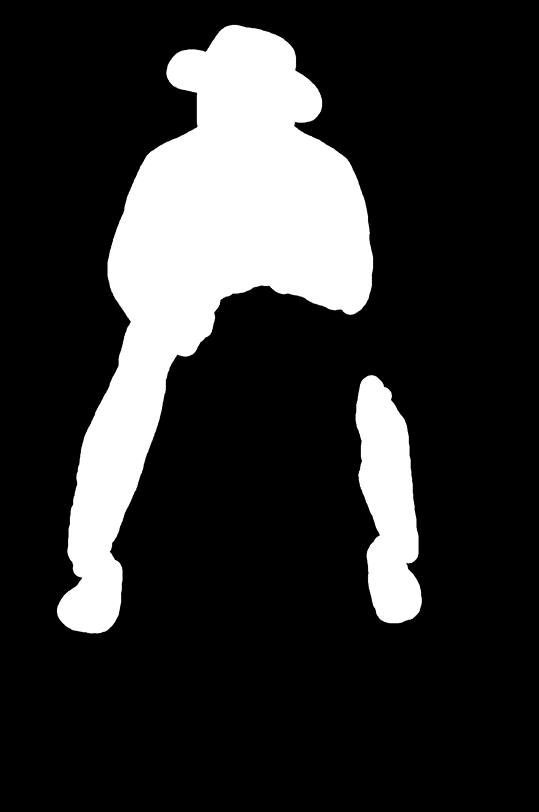
Exemple 20 : masque indiquant la personne et l’âne. Une autre méthode qui délimite en noir et blanc les zones à modifier.
Repositionnement de personnes et conservation du visage
Exemple 21 : résultat d’une édition de personne à l’aide d’un masque. Permet aussi de comparer la cohérence avec la prairie en arrière-plan.
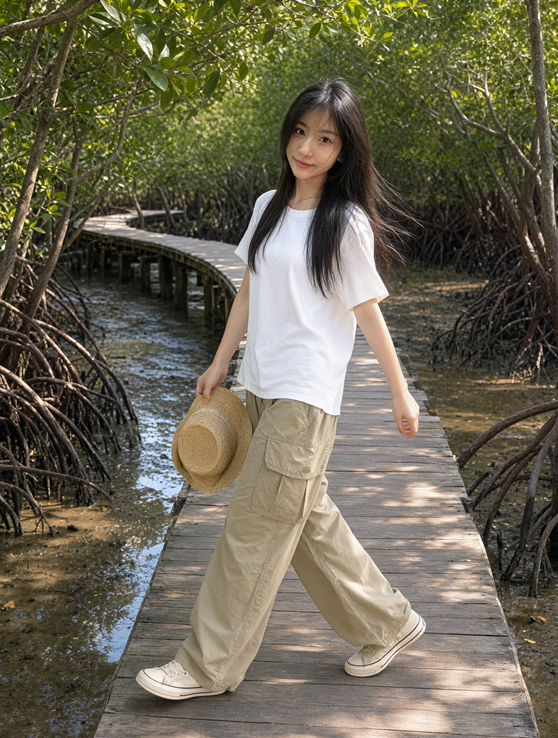
Exemple 22 : portrait servant de référence faciale. Image de base utilisée pour générer ensuite une vue en pied dans un nouvel environnement.
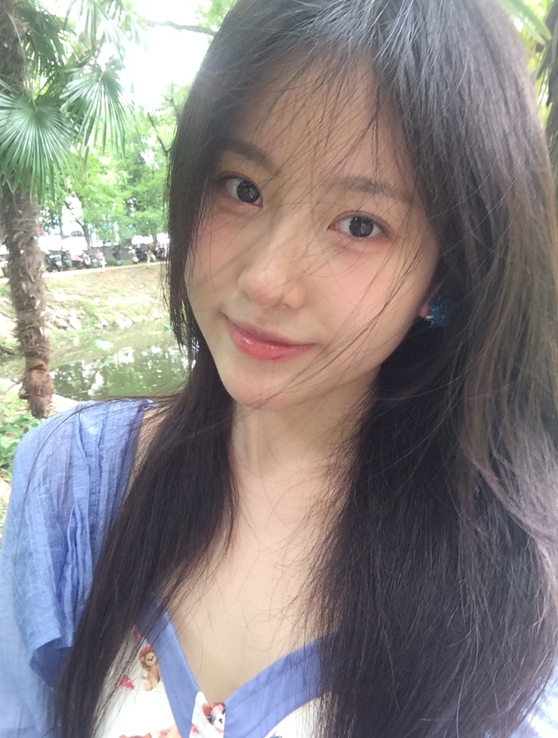
Exemple 23 : déclinaison de la personne de référence en photo extérieure en pied. Transpose le visage et les vêtements dans une nouvelle composition.
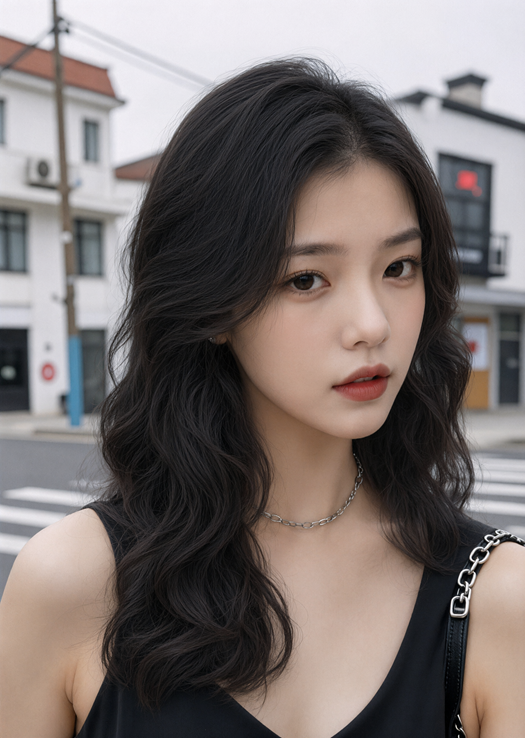
Exemple 24 : photo de visage presque de face. Condition d’entrée pour l’édition de coiffure.
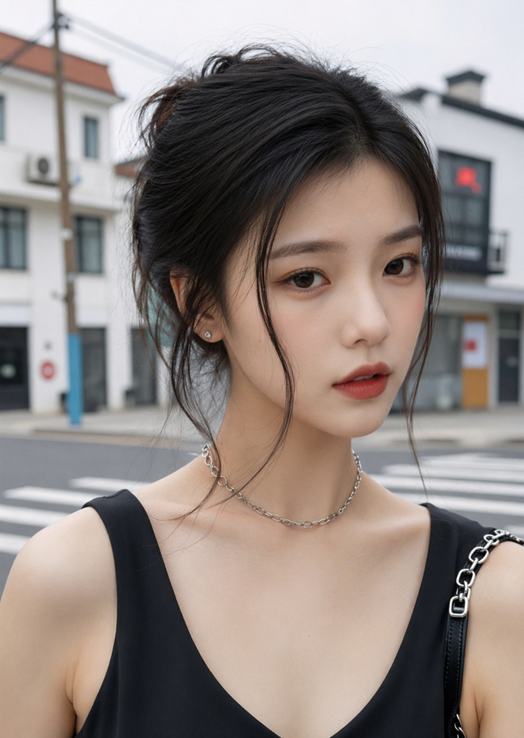
Exemple 25 : photo de visage avec coiffure modifiée. Conserve les traits et le fond, tout en allongeant uniquement les cheveux.
Poses, scènes et photos de produits
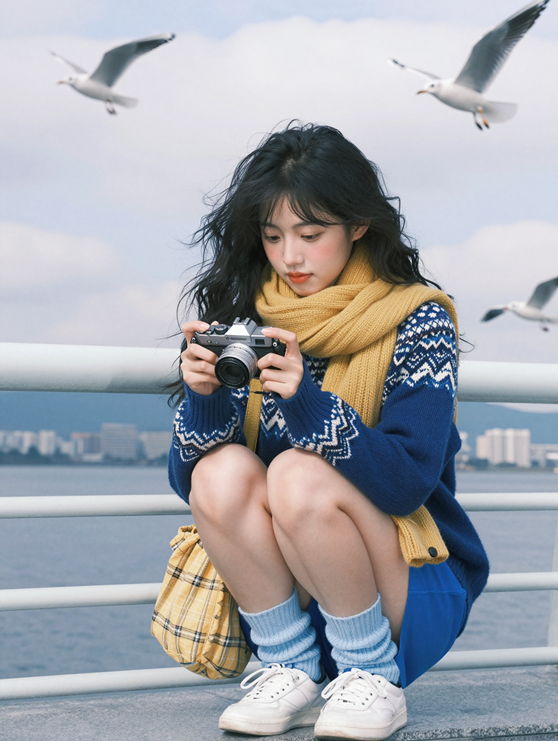
Exemple 26 : personne accroupie dans un port. Exemple comprenant une pose complexe, des accessoires et un arrière-plan lointain.
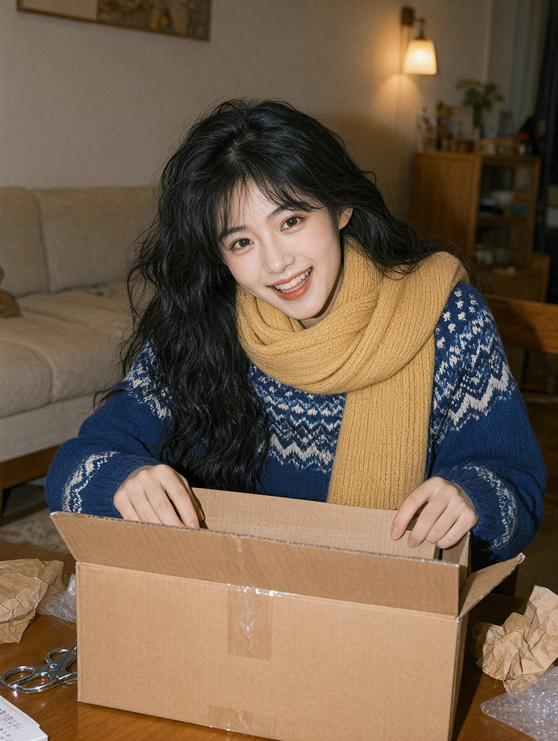
Exemple 27 : personne ouvrant une boîte à l’intérieur. Composition permettant d’observer les mains, la boîte et les chevauchements du corps.
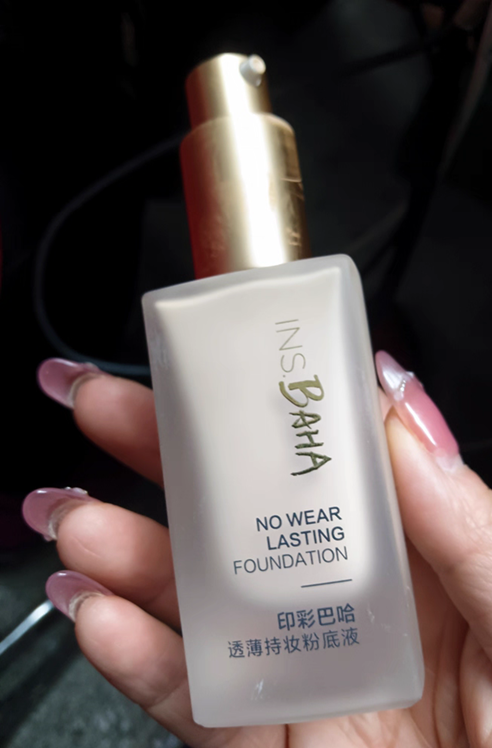
Exemple 28 : produit cosmétique tenu à la main. Photo de produit comportant le texte de l’étiquette et le contact avec les doigts.
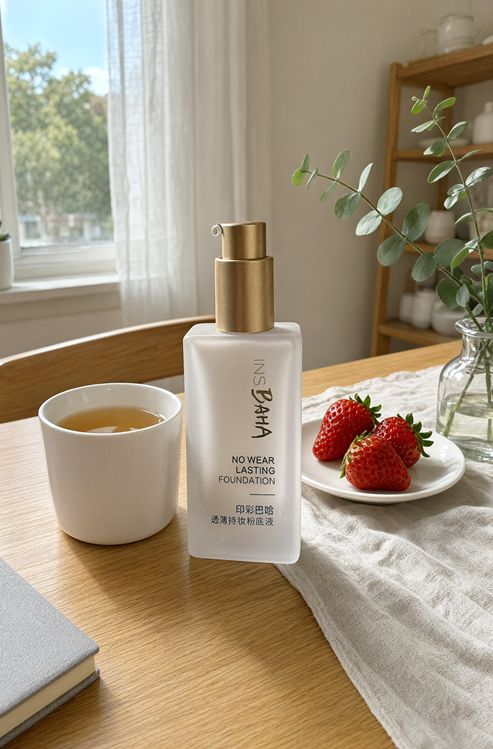
Exemple 29 : cosmétique converti en photo de produit d’intérieur. Ajoute lumière naturelle, table et petits éléments alimentaires.
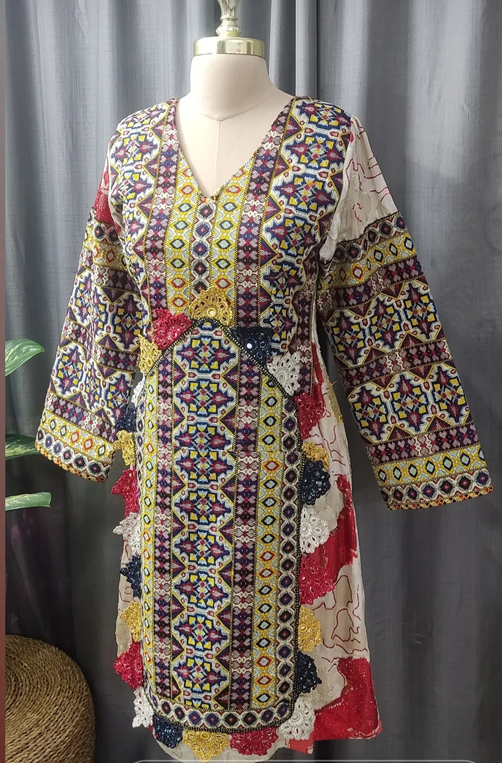
Exemple 30 : vêtement porté par un mannequin. Référence produit utilisée pour la génération d’essayage suivante.
Essayage virtuel et composition d’accessoires portés
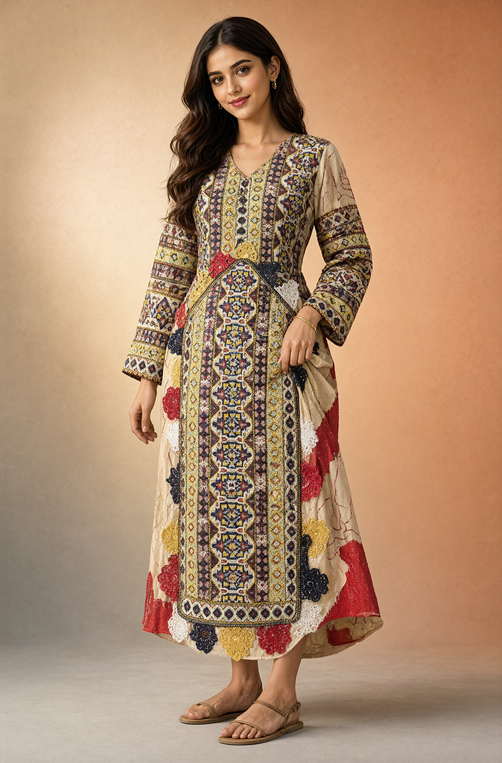
Exemple 31 : vêtement de référence porté par une personne. Le motif, la longueur et la silhouette sont adaptés au corps humain.
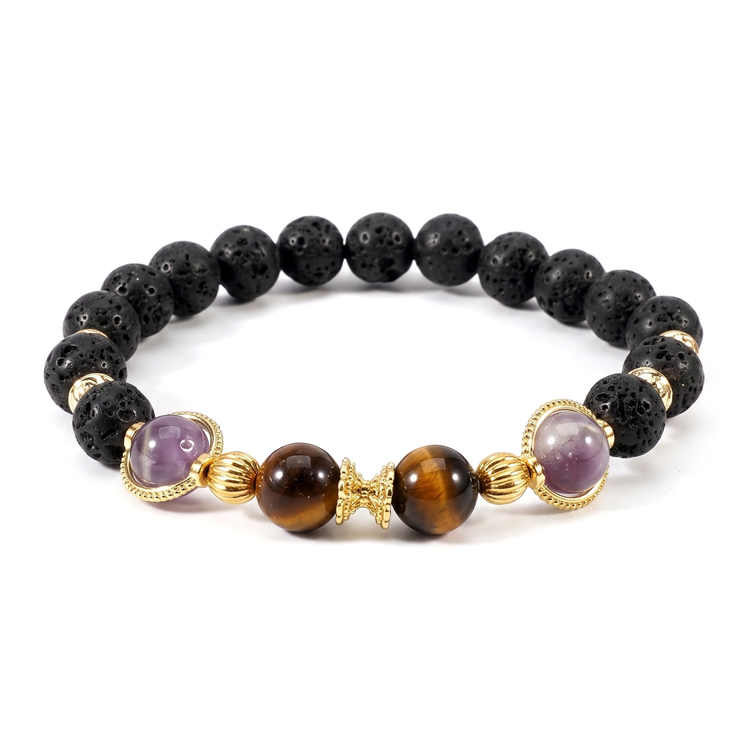
Exemple 32 : photo de produit d’un bracelet seul. Image conditionnelle pour la composition d’un accessoire porté.
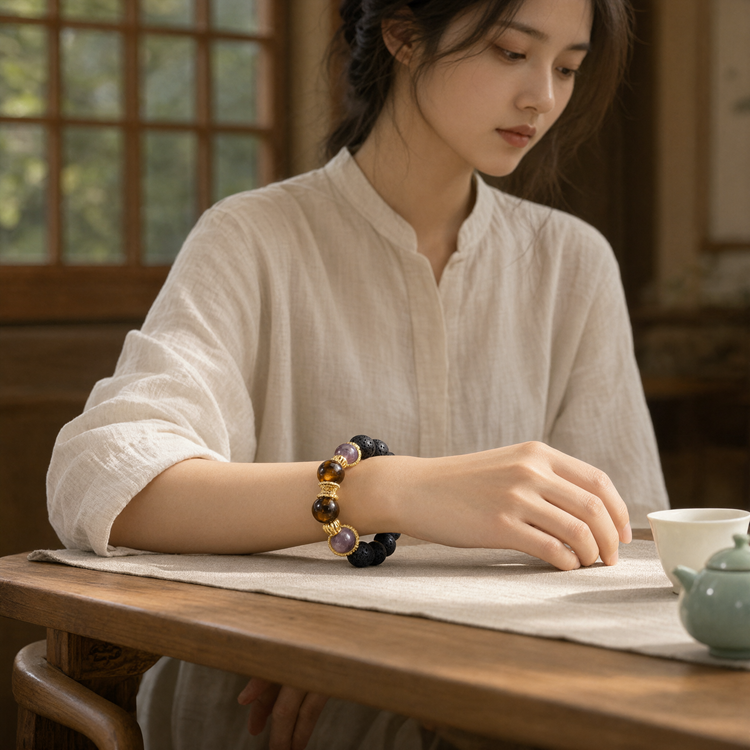
Exemple 33 : bracelet porté au poignet d’une personne. Harmonise naturellement le contact avec la peau et les ombres.
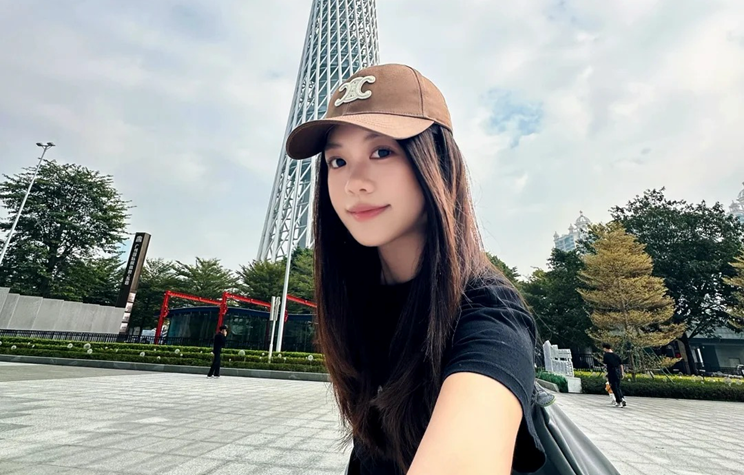
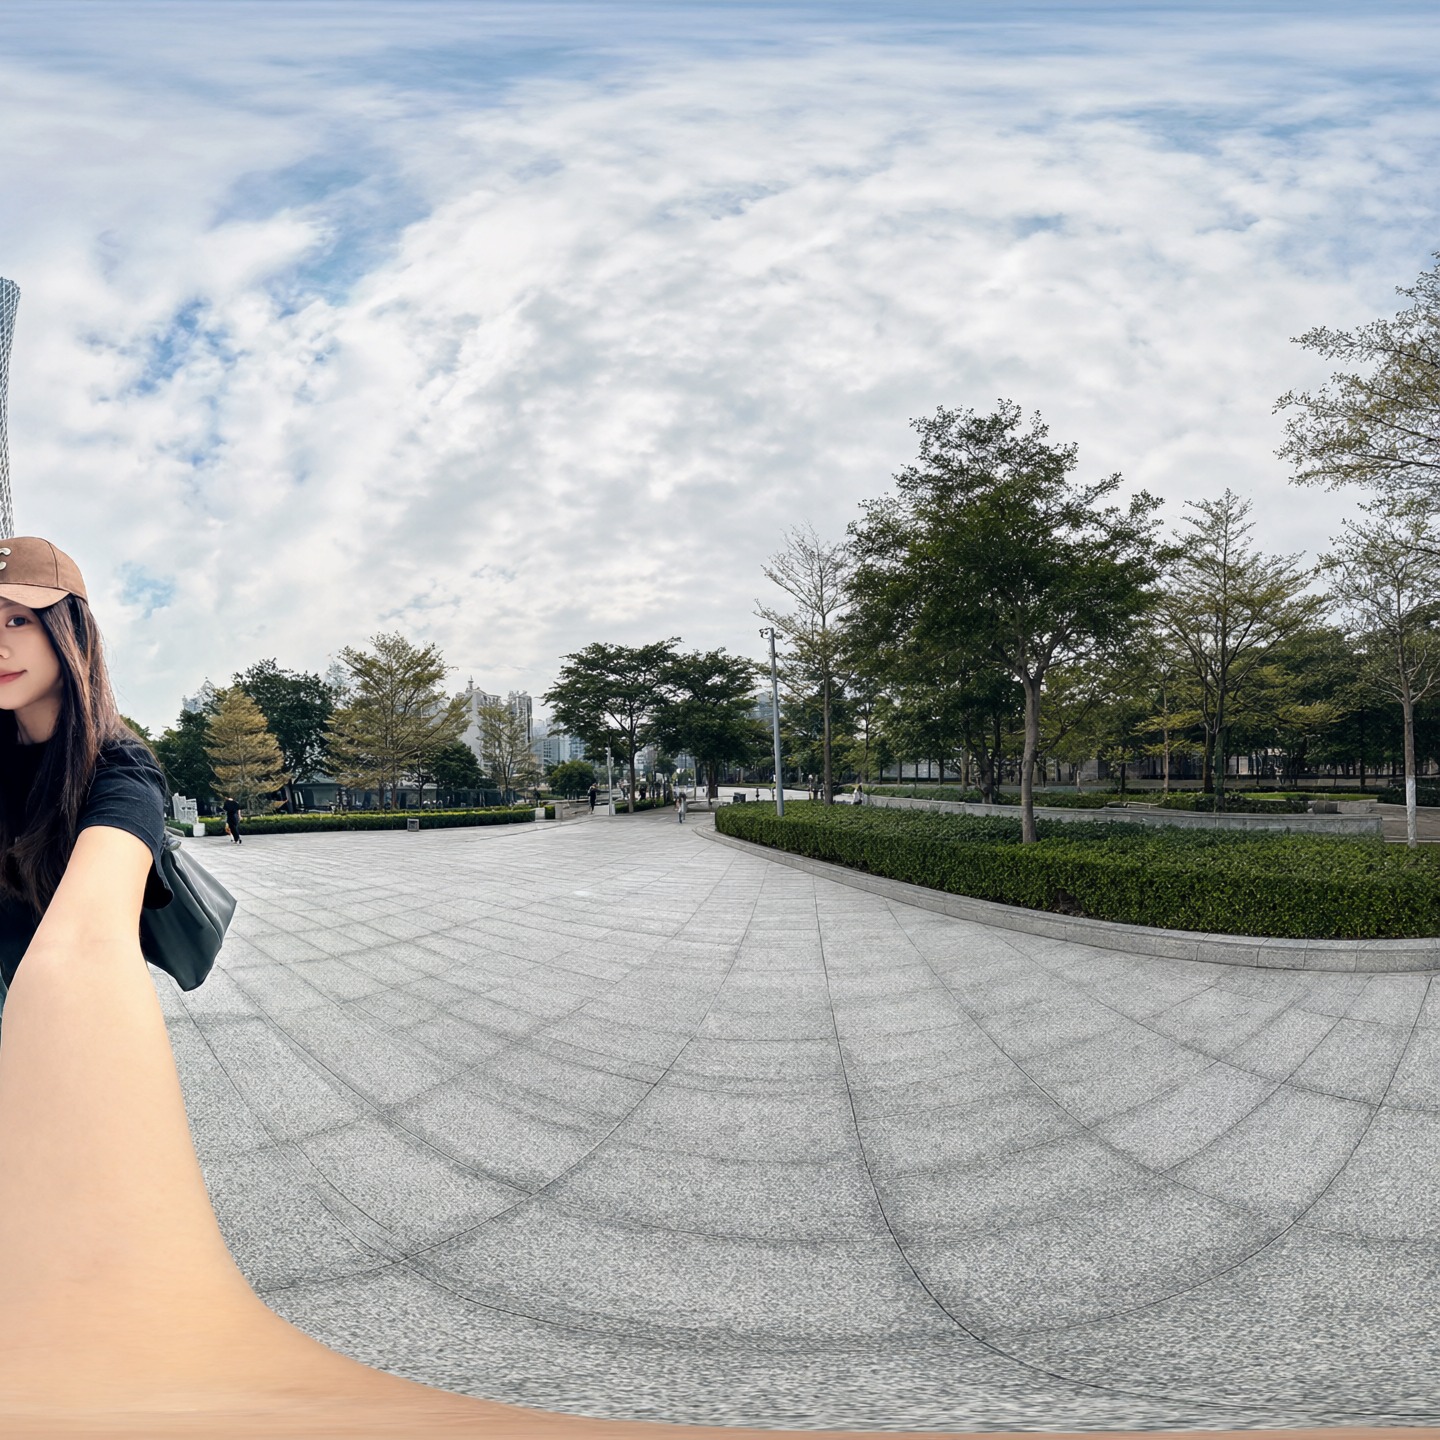
Exemple 34 : selfie devant une tour. Photo d’entrée utilisée pour modifier le point de vue.
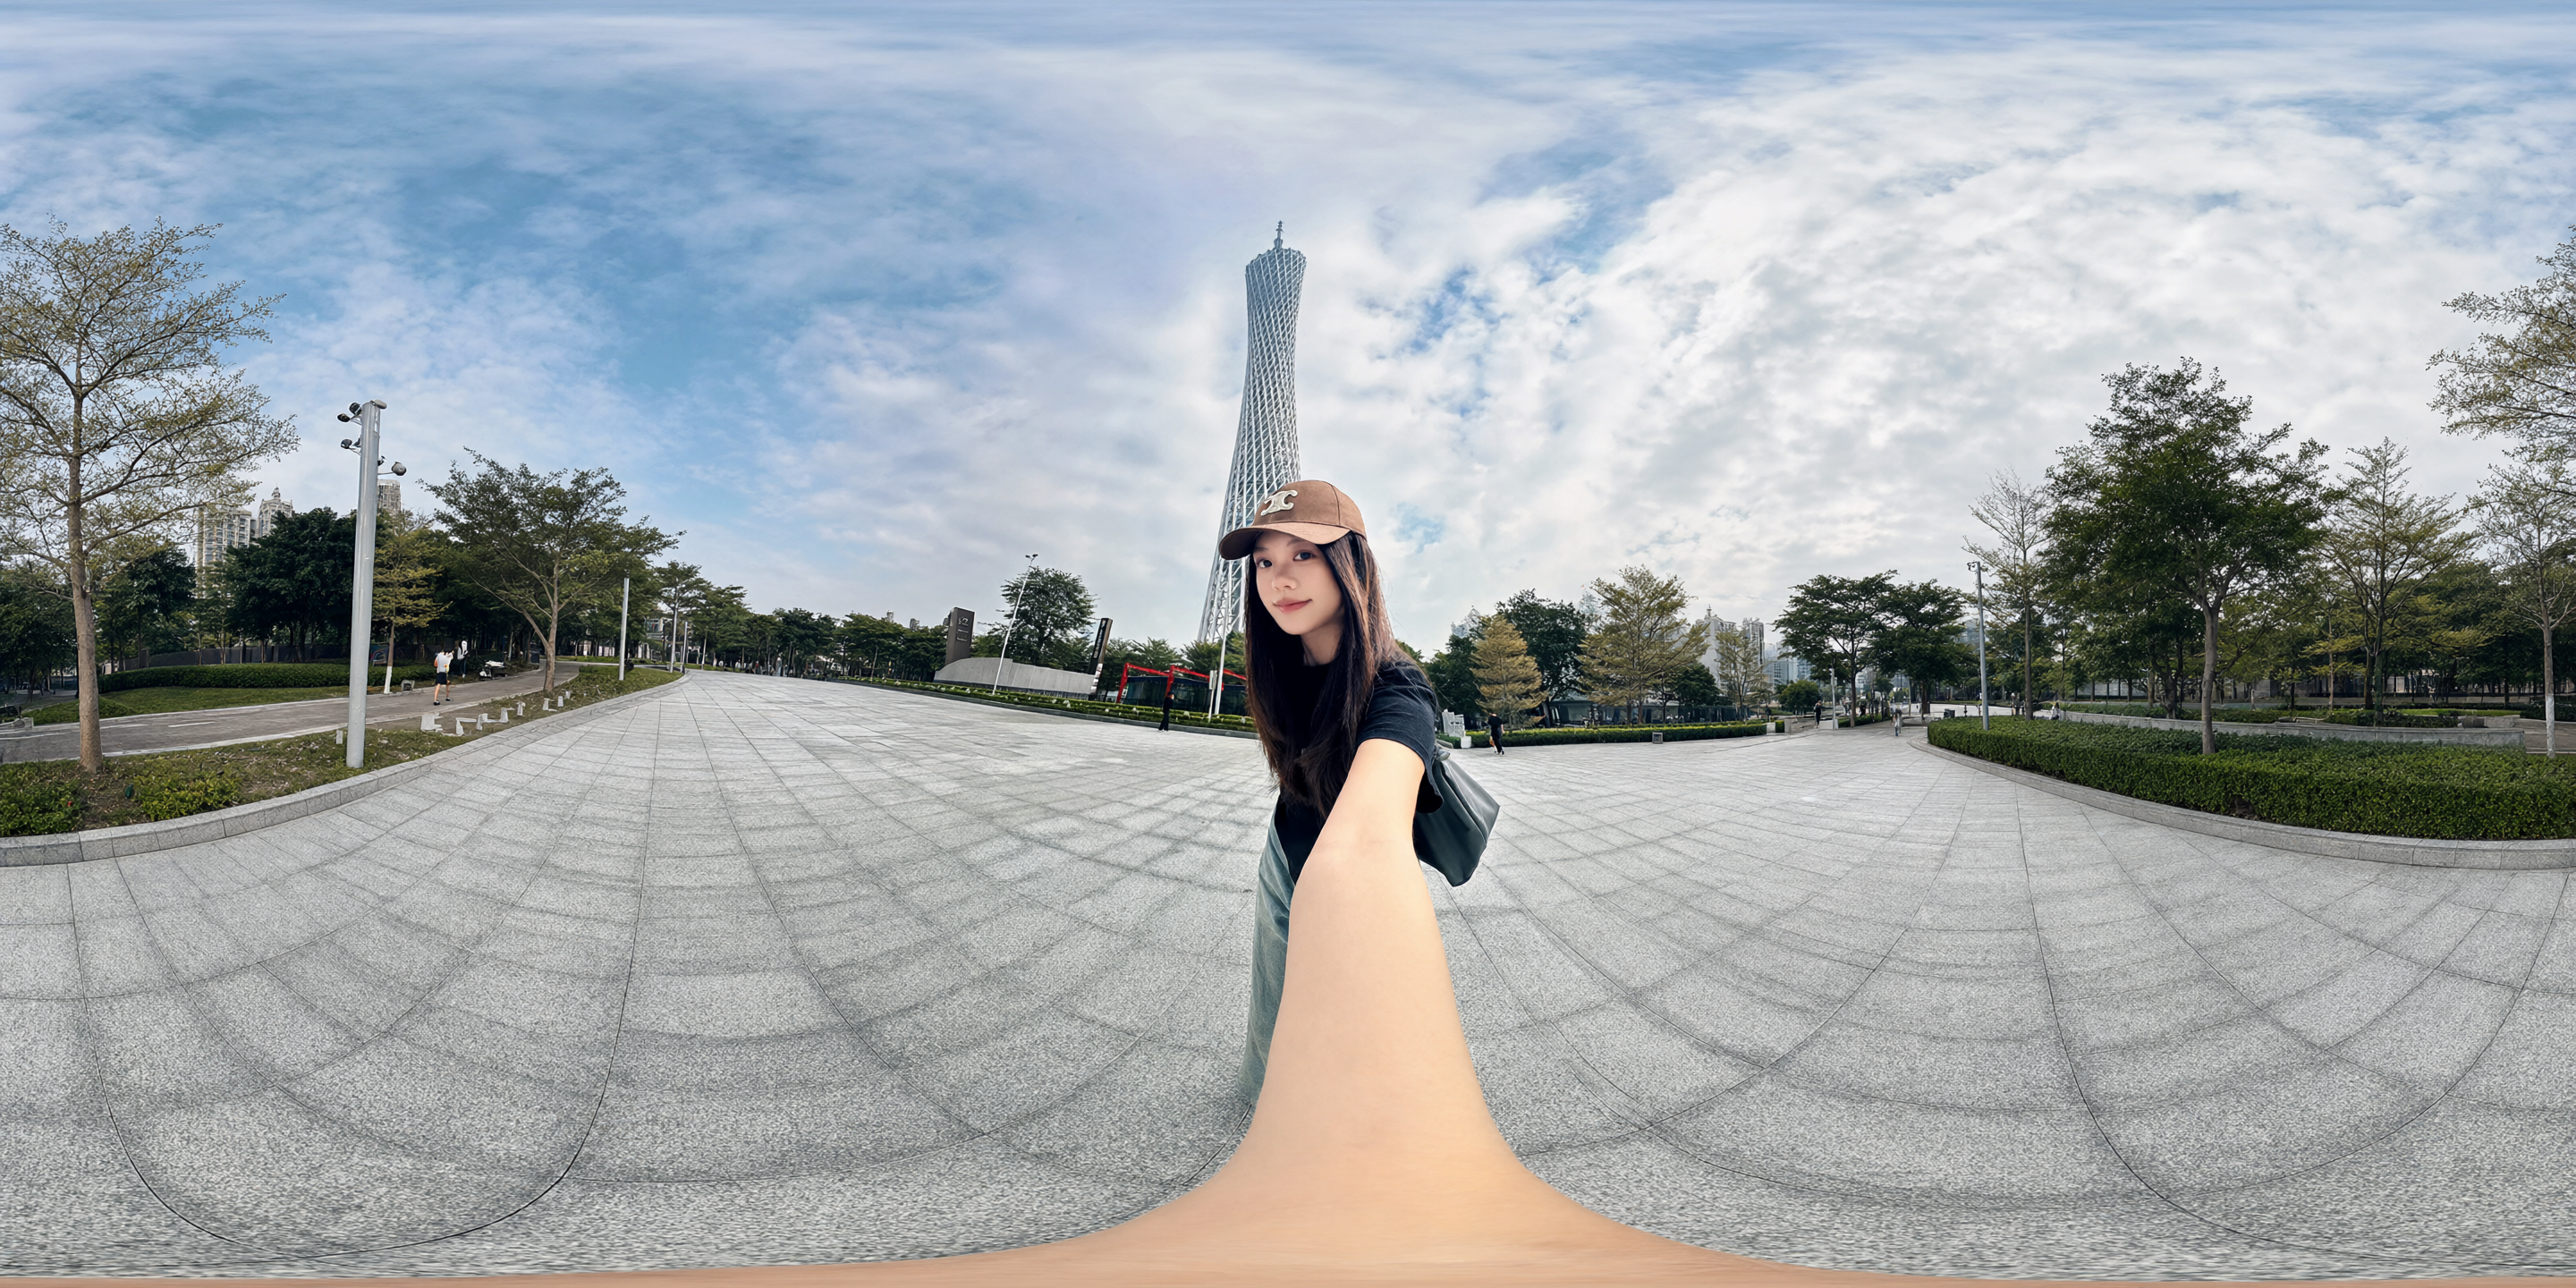
Exemple 35 : du selfie à une vue à la troisième personne. Recompose la même personne et le même lieu dans un champ plus large.
Fiches de personnages et continuité
Exemple 36 : portrait d’une personne en tenue blanche. Entrée pour une fiche de personnage.
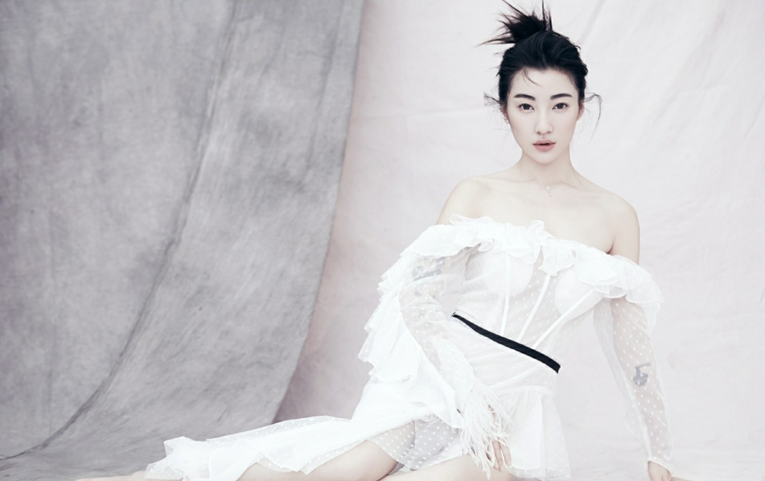
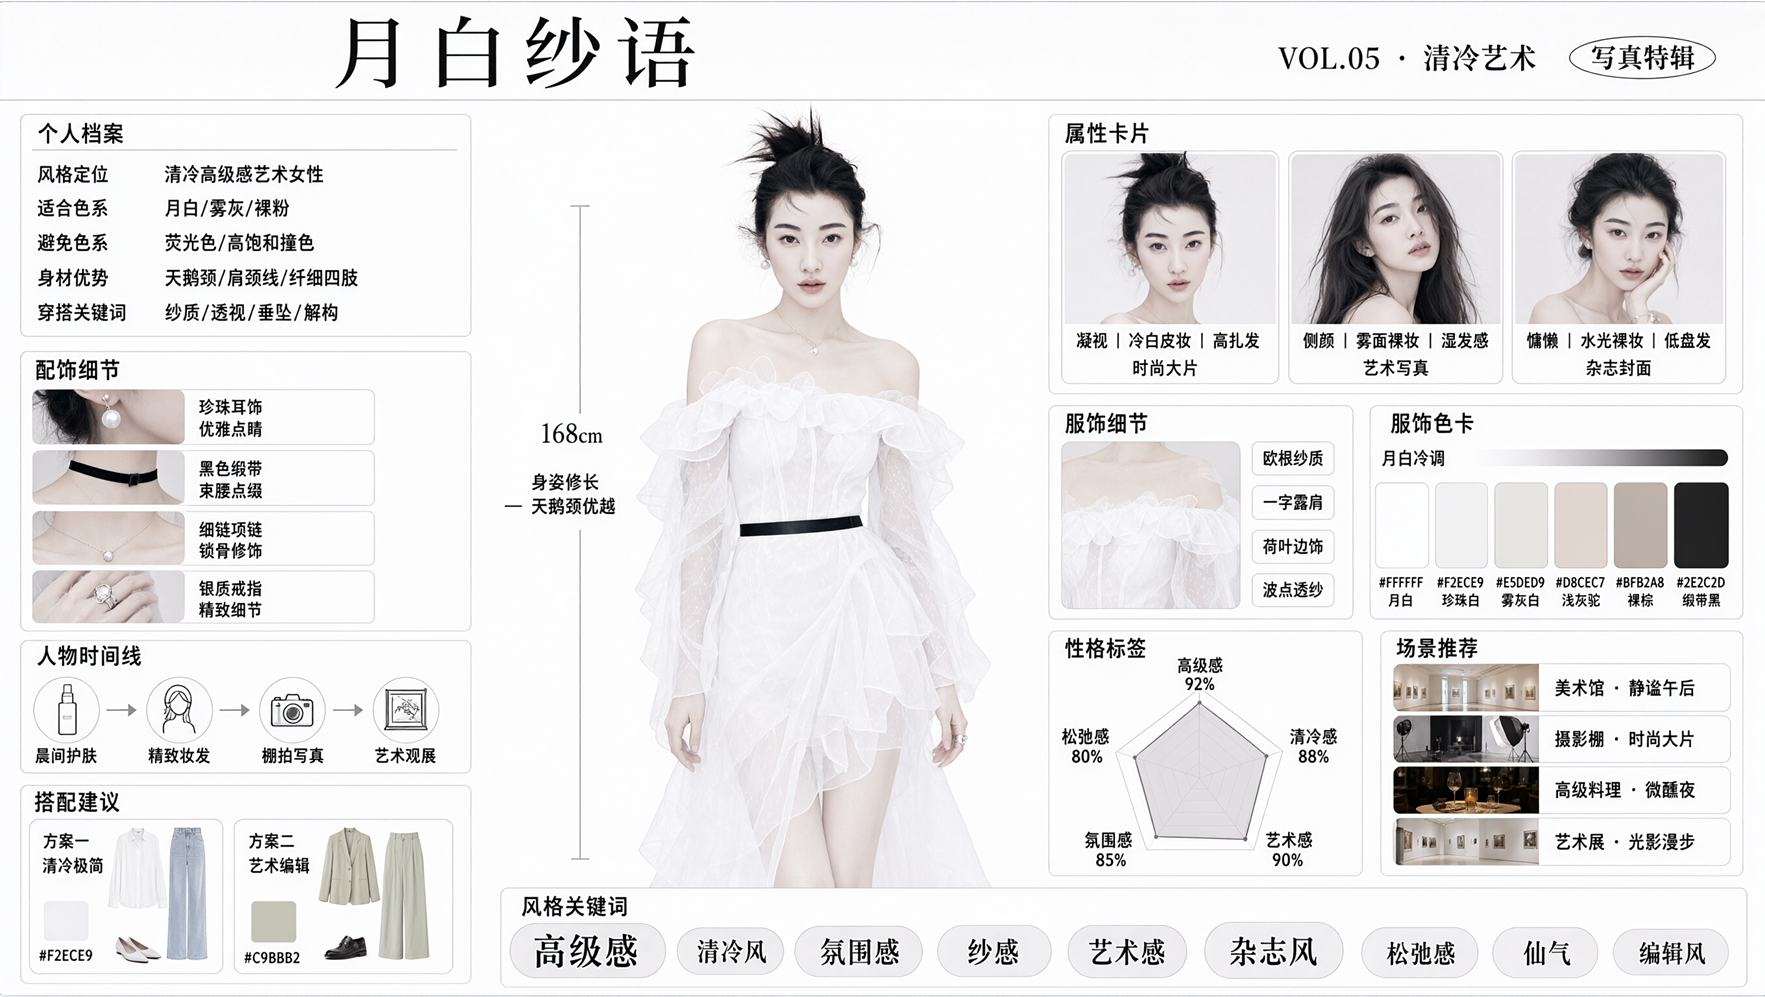
Exemple 37 : fiche de design réunissant le profil d’une personne. Intègre visage, vêtements, accessoires et informations textuelles.
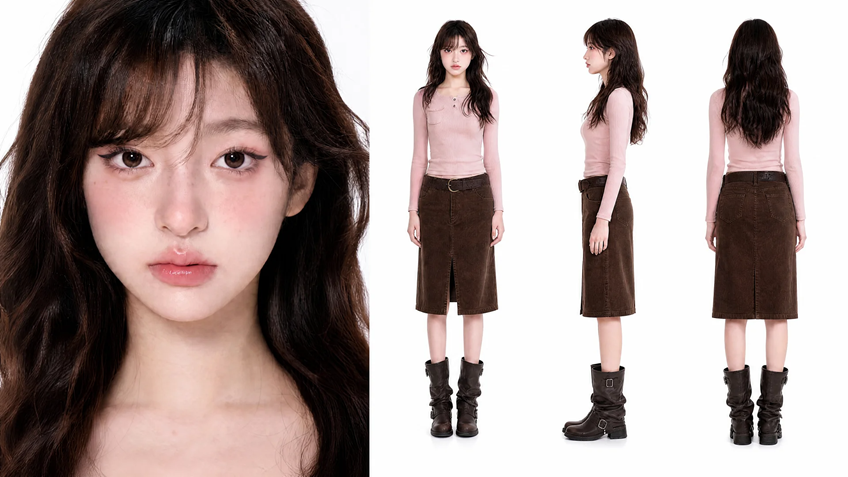
Exemple 38 : fiche de personnage avec vue de face, de côté et de dos. Adaptée aux supports de référence pour vidéo ou bande dessinée.
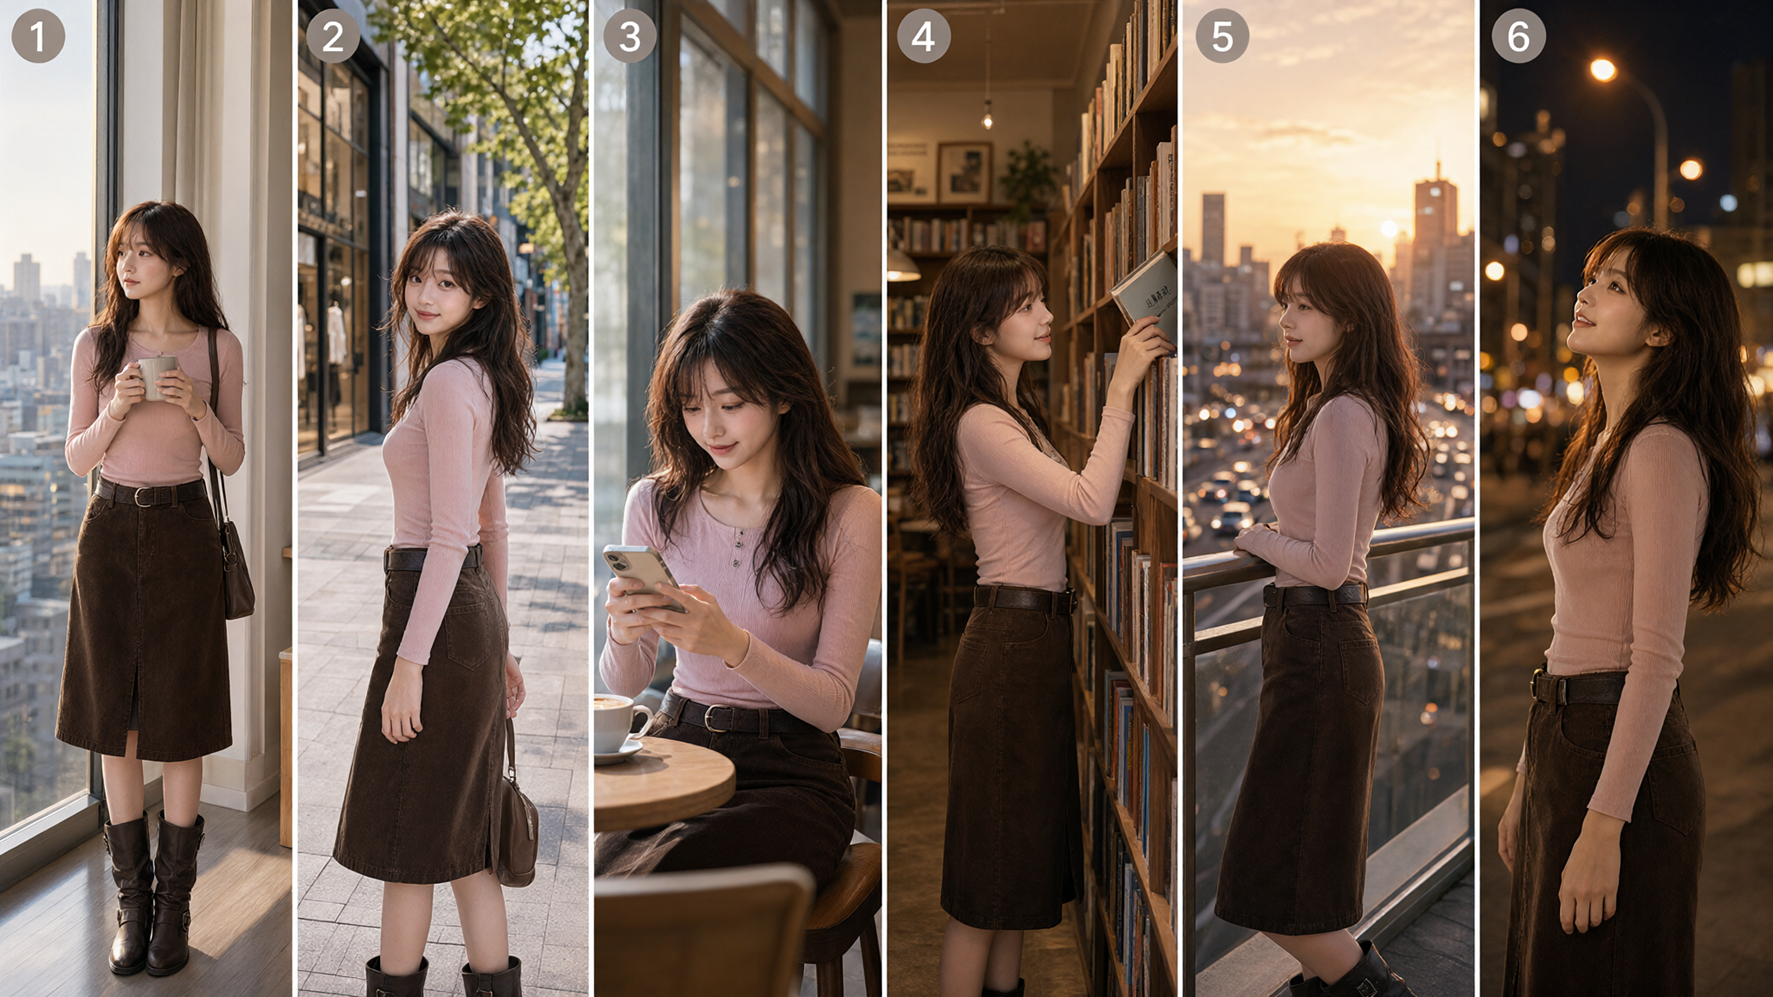
Exemple 39 : même personne placée dans plusieurs scènes. Permet d’évaluer la conservation du visage et des vêtements lorsque pose et lieu changent.
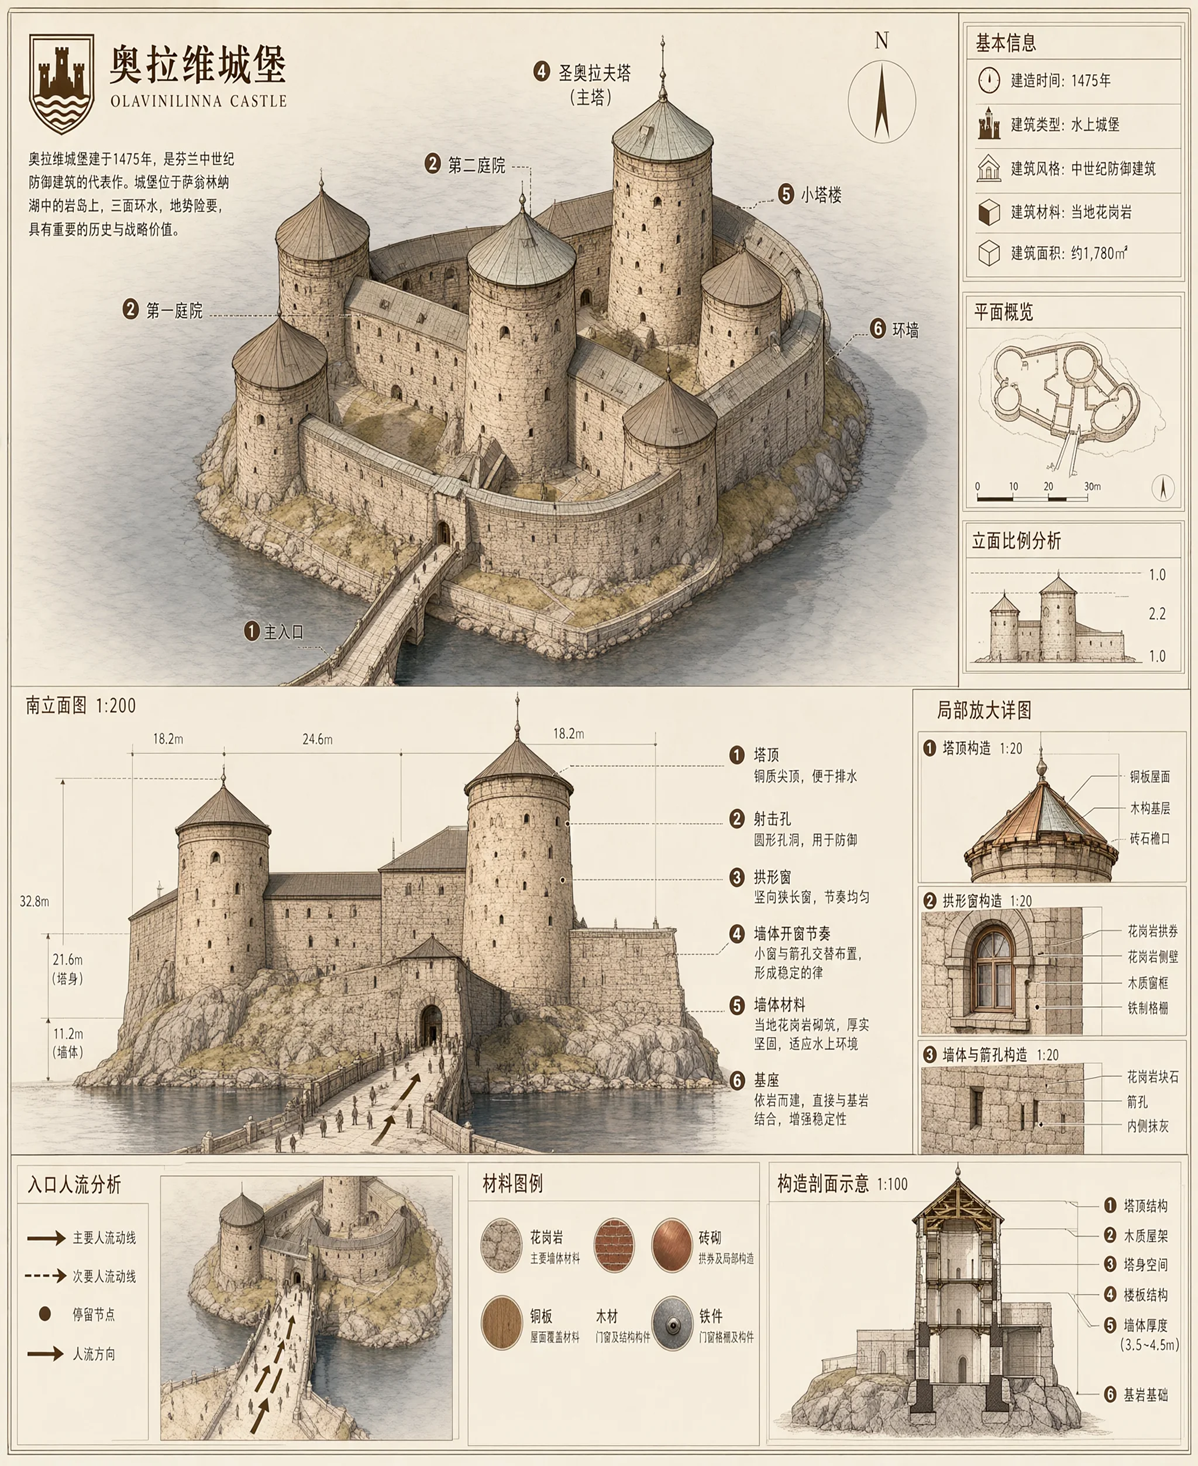
Exemple 40 : schéma explicatif d’un bâtiment. Génération documentaire intégrant texte, plans, échantillons de matériaux et annotations.
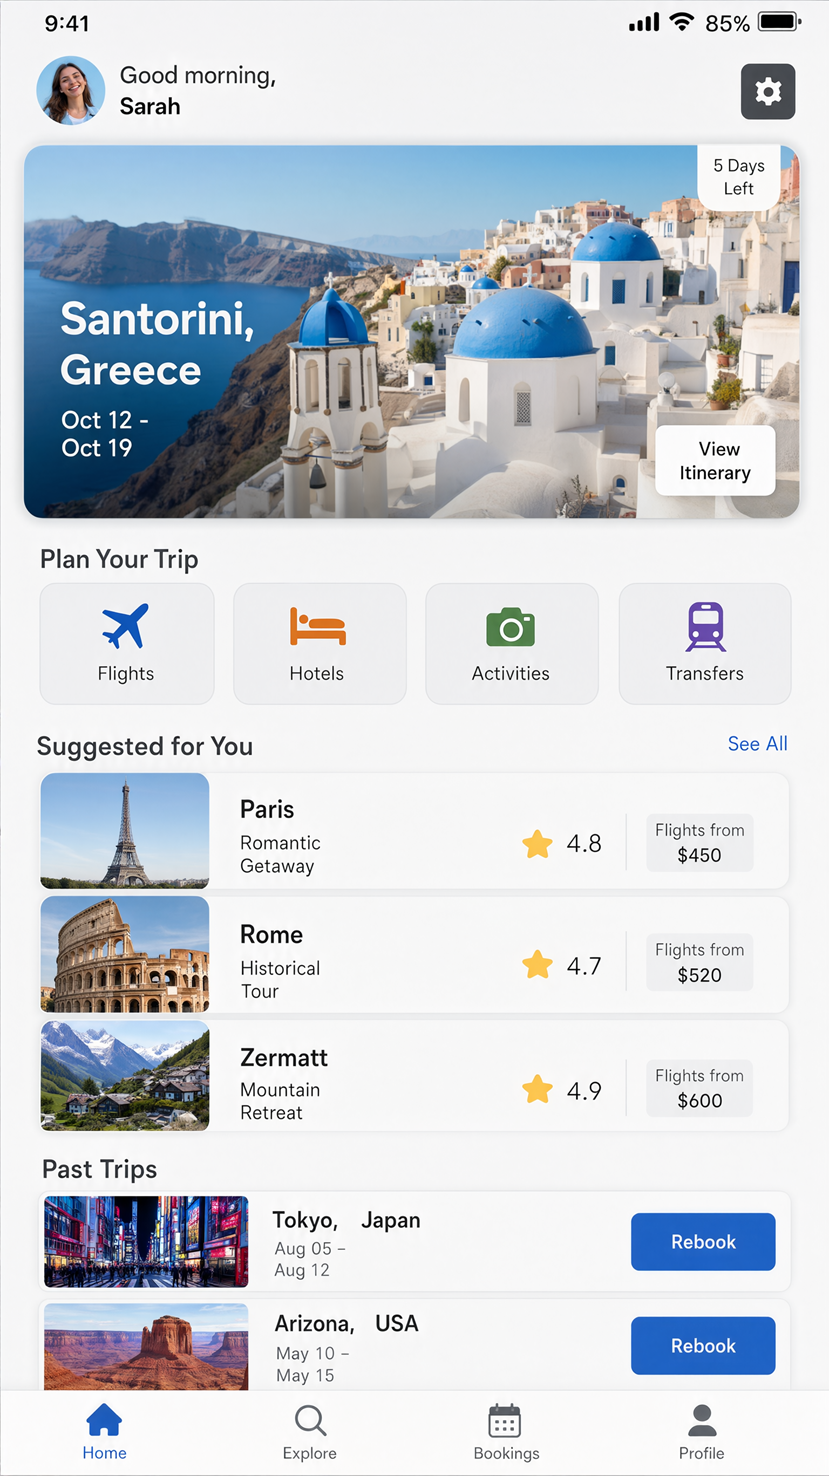
UI, documents et photos de personnes naturelles
Exemple 41 : UI d’une application de réservation de voyages. Conception d’écran avec petits textes, cartes, photos et boutons.
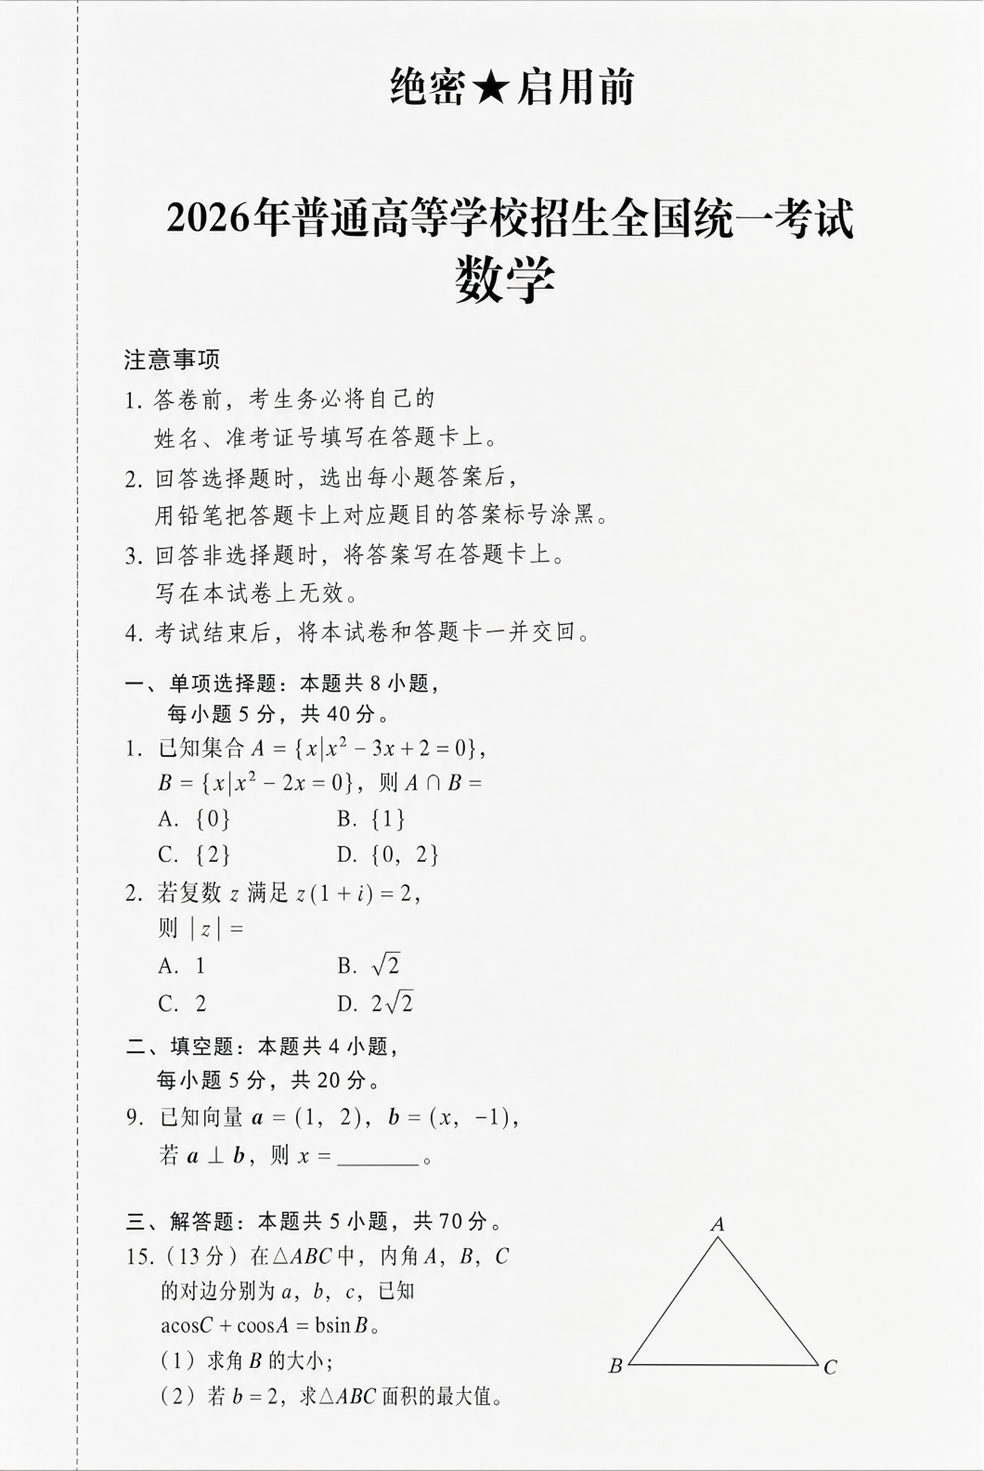
Exemple 42 : document comprenant un problème de géométrie. Permet d’observer la difficulté de générer une page avec un long texte et des figures.
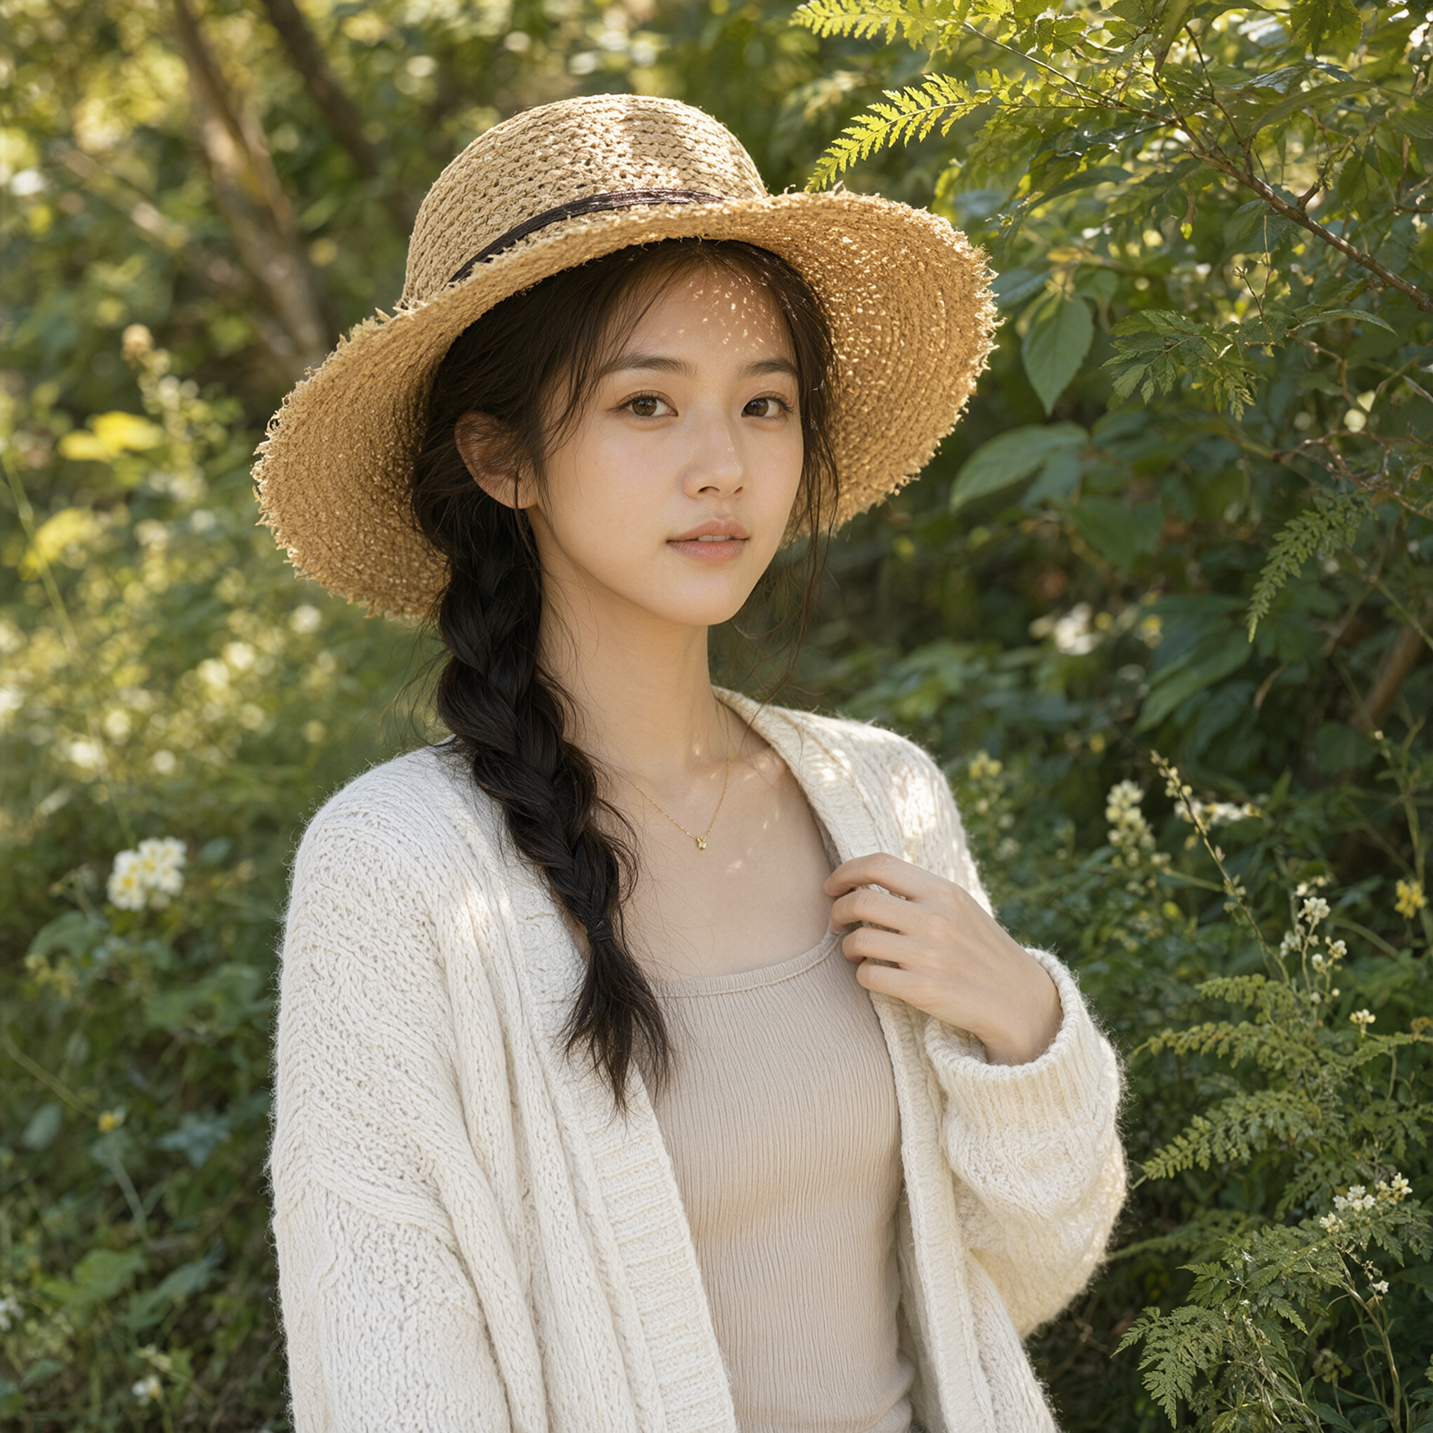
Exemple 43 : portrait extérieur sous lumière naturelle. Rendu d’un chapeau, des cheveux et de la lumière filtrée par les arbres.
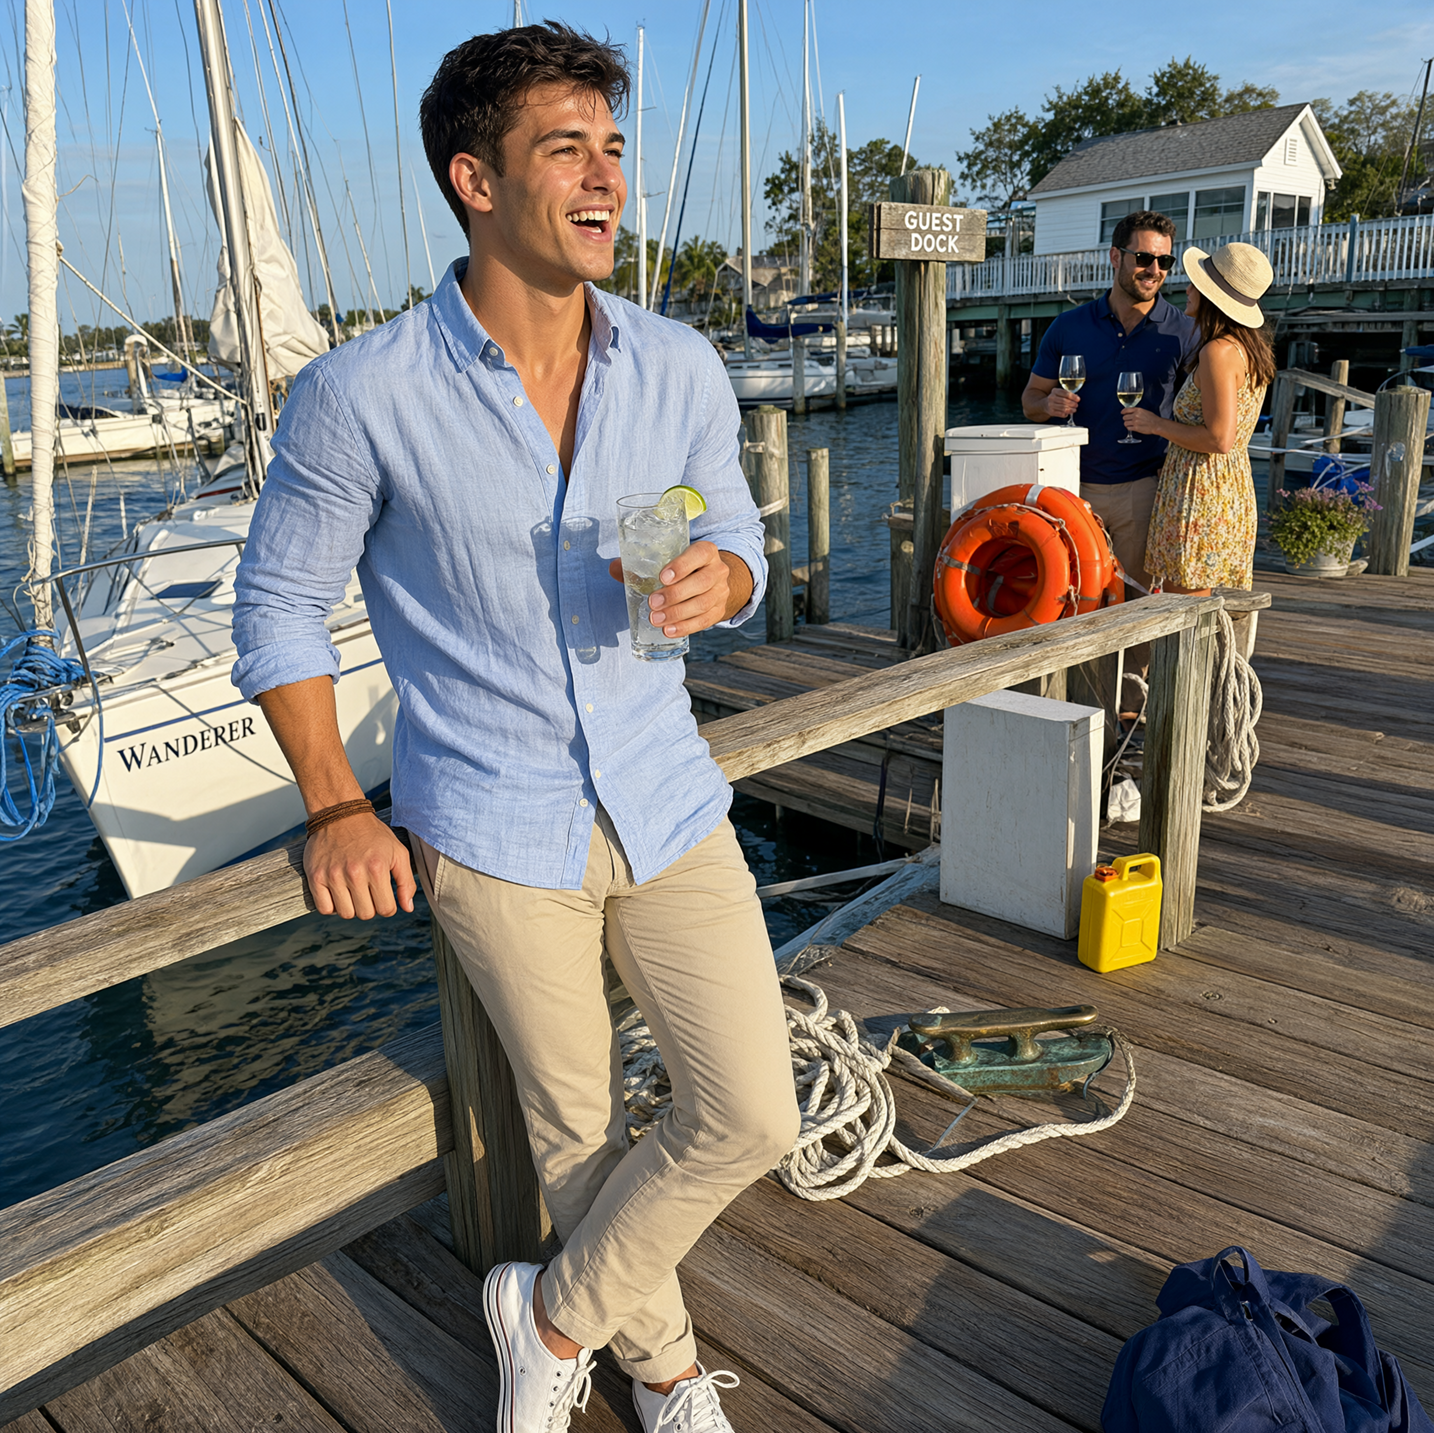
Exemple 44 : photo de personne dans une marina. Exemple photoréaliste avec arrière-plan détaillé : cordes, bateaux et outils.
Agrandissements et autres vues facilitant la comparaison
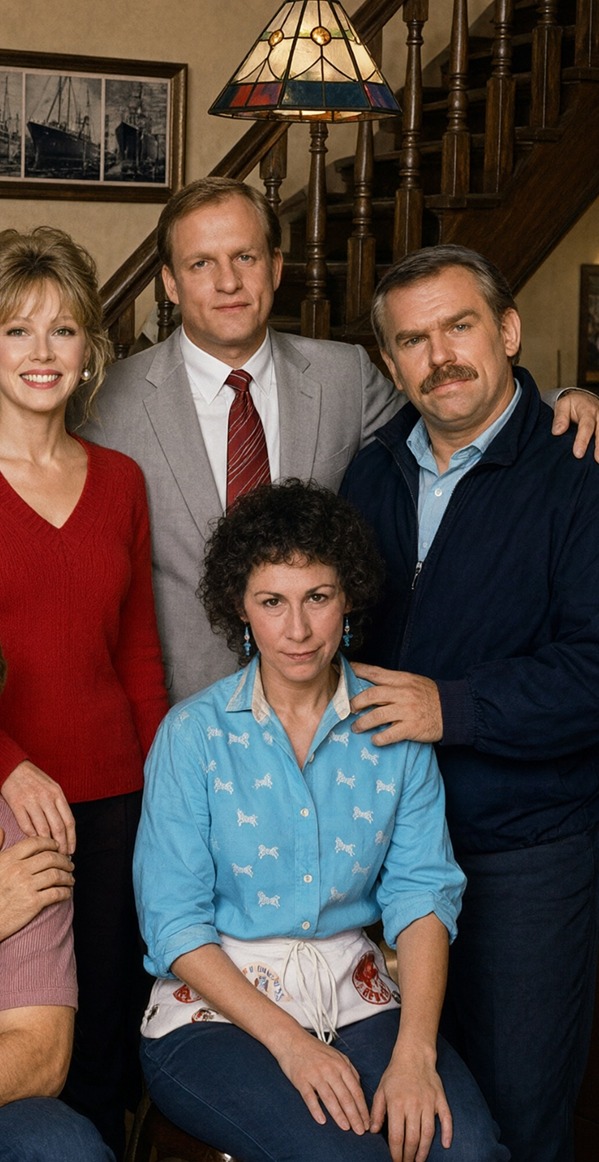
Exemple 45 : agrandissement d’une partie d’une photo de groupe. Permet de vérifier les visages, poses et éclairages lors de l’intégration de références multiples dans un même espace.
Exemple 46 : agrandissement de l’intérieur après intégration des meubles. Produit la perspective et la lumière de toute une pièce à partir de références individuelles de produits.
Exemple 47 : recadrage carré après changement de point de vue. Rend plus lisible le rapport d’échelle entre la tour en arrière-plan et la personne.
Exemple 48 : agrandissement d’une fiche de design de personnage. Permet de vérifier la qualité locale des variantes de visage, textes et accessoires.
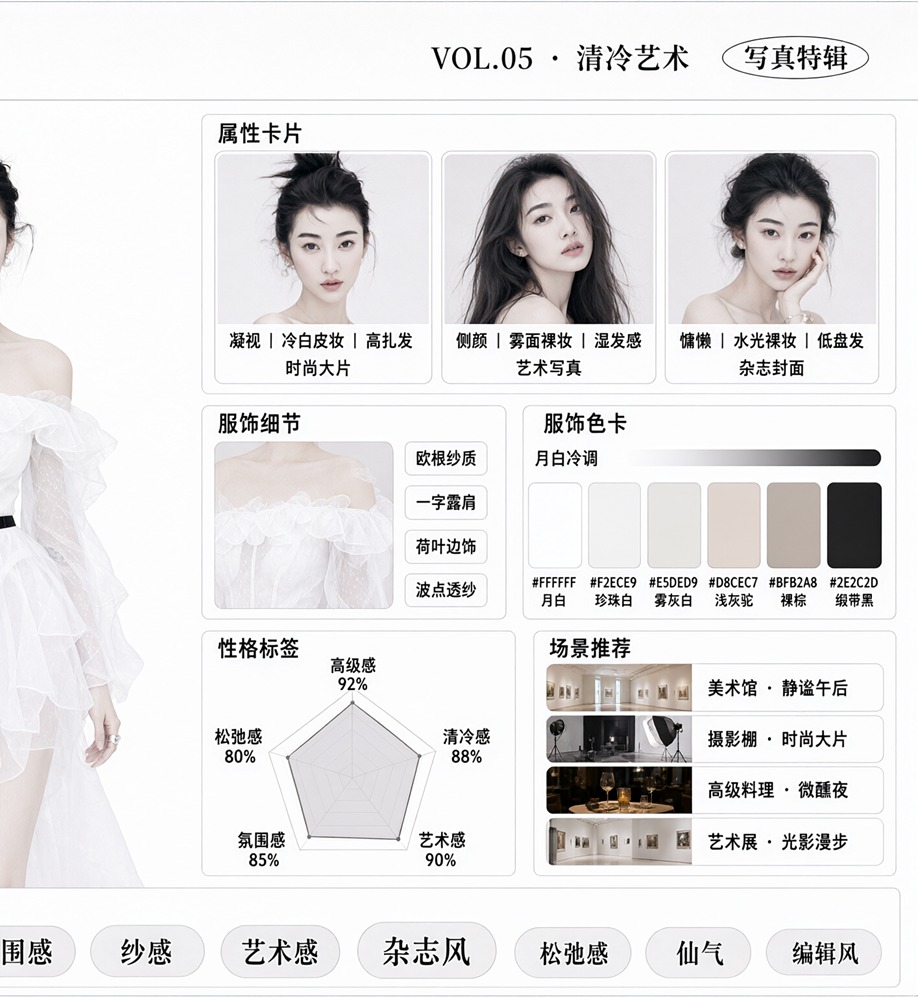
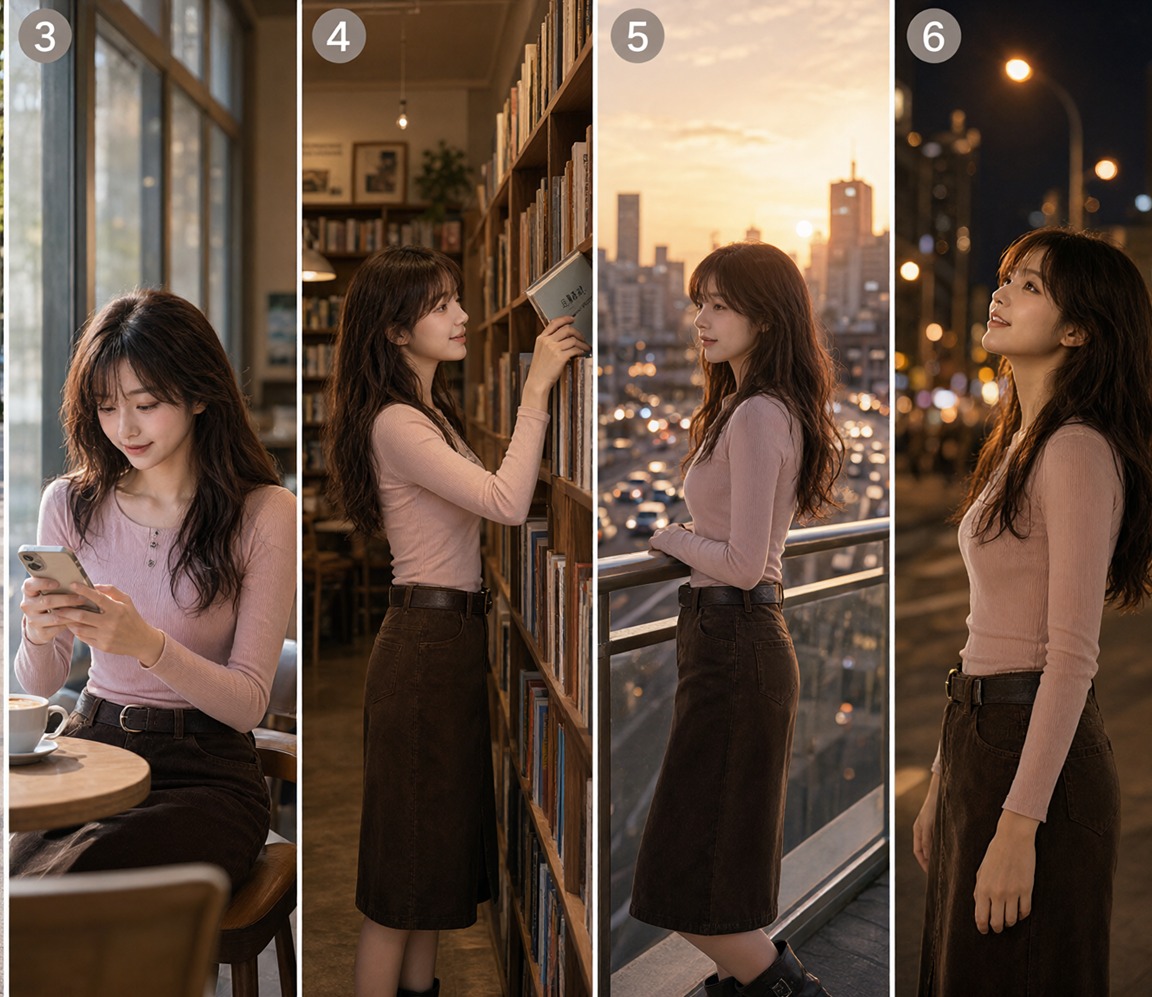
Exemple 49 : agrandissement d’une partie montrant la même personne dans plusieurs scènes. Permet d’évaluer la cohérence des vêtements et du visage, cruciale dans une longue production.
Exemple 50 : agrandissement d’une infographie architecturale. Montre le défi combiné du dessin au trait, des matériaux, des annotations et de la gestion des marges.
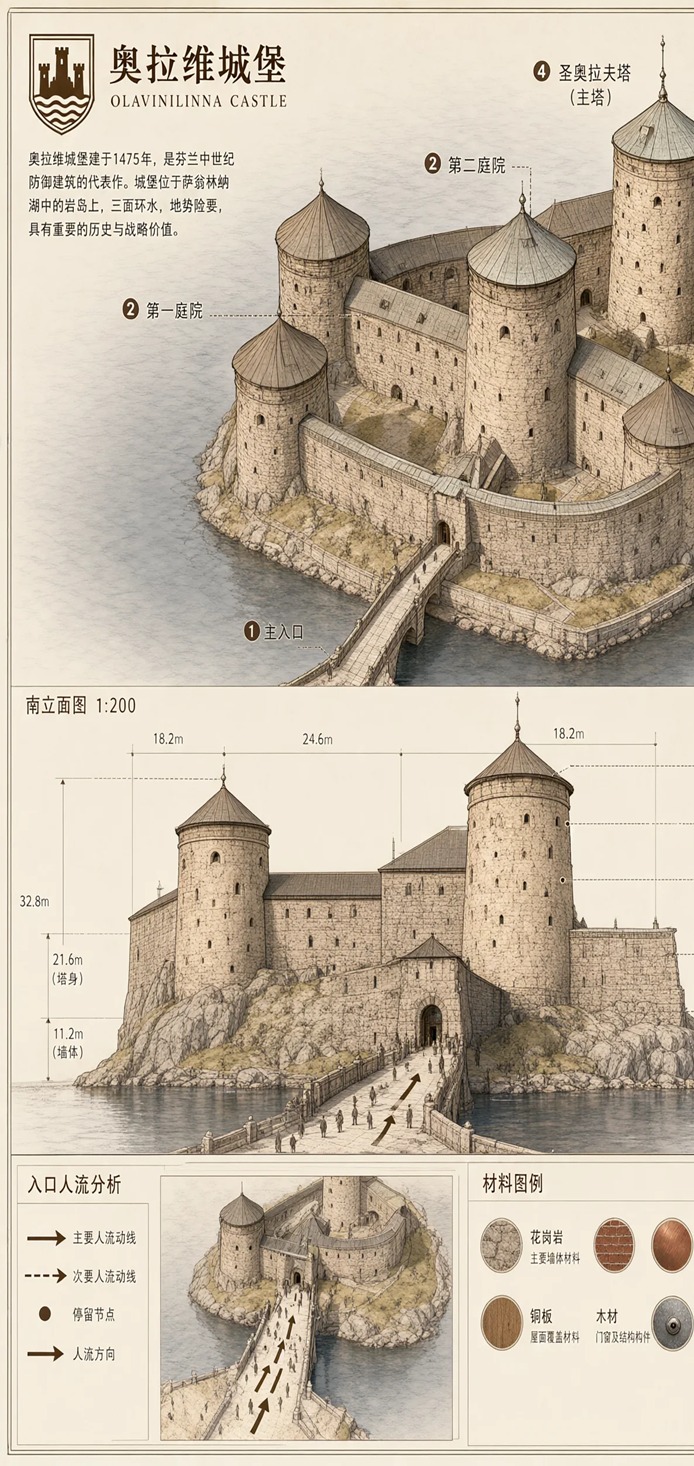
Source des images : exemples officiels « Qwen-Image-2.1 » de l’équipe Qwen. Les six vues agrandies sont des recadrages édités à des fins de comparaison explicative.
100 exemples et tests qui ont fait parler d’eux sur Reddit
Les éléments suivants organisent en 100 catégories les types de création et d’édition réellement discutés dans les principales publications Reddit sur Qwen-Image 2.1. Comme ils incluent la subjectivité des auteurs et les différences d’environnement, il ne s’agit pas d’un benchmark, mais d’un catalogue pratique montrant quels essais révèlent le caractère du modèle.
A. Photos de personnes et portraits (1 à 10)
- Photo amateur d’une femme, comme prise avec un smartphone.
- Portrait quotidien pris dans le rayon d’un supermarché.
- Photo de personne avec contre-jour cinématographique.
- Rééclairage d’une personne devant un paysage nocturne.
- Modification simultanée de la météo et de l’heure vers une nuit pluvieuse.
- Photo de mode conservant la texture de la peau.
- Prise de vue de profil droit depuis une caméra basse.
- Changement de caméra d’une photo de face vers un angle trois-quarts.
- Régénération de visage avec forte modification d’expression.
- Génération d’un « visage de référence » intégré à partir de plusieurs conditions d’éclairage.
Sources d’attention : test de plus de 200 images 1girl (environ 1 483 votes), premier avis
B. Cohérence des personnages (11 à 20)
- Fiche d’un même personnage de face, de côté et de dos.
- Document de référence réunissant gros plan du visage et vue en pied.
- Génération d’un visage unique cohérent à partir d’une référence faciale 2×2.
- Déplacement de la même personne dans un autre lieu tout en conservant le visage.
- Changement des seuls vêtements pour la même personne.
- Changement de la seule coiffure pour la même personne.
- Remplacement de la seule pose pour la même personne.
- Représentation de la même personne en version réaliste et en version bande dessinée.
- Création de poses multiples pour des plans successifs.
- Utilisation d’une fiche de personnage comme support de référence pour la génération vidéo.
Sources d’attention : fiches de design de personnages, références de visage sous quatre angles (environ 157 votes), Qwen contre FLUX.2 Krea (environ 116 votes)
C. Transfert de pose, caméra et composition (21 à 30)
- Transfert de la pose de la référence 2 vers la personne de la référence 1.
- Placement d’une personne assise sur une chaise jaune issue d’une autre image.
- Passage d’une posture debout à une posture assise tout en conservant les vêtements.
- Passage d’une composition de face à un plan moyen en contre-plongée.
- Extension du champ de vision tout en conservant la taille du sujet.
- Transfert d’une posture depuis une image de studio de pose vers une personne réaliste.
- Transformation d’une personne réaliste en style Simpsons tout en conservant la posture.
- Conservation de la position d’un produit porté malgré le changement d’angle de caméra.
- Application d’une grande profondeur de champ au premier plan comme à l’arrière-plan.
- Création d’une photo de groupe sans perturber l’agencement de plusieurs personnes.
Sources d’attention : conseils d’édition (environ 513 votes), Editing Beast (environ 840 votes)
D. Produits, publicité et essayage virtuel (31 à 40)
- Remplacement global d’une canette de cola écrasée par la canette d’un autre produit.
- Modification des seules couleurs et du design en conservant la déformation de la canette.
- Réflexion de la couleur d’un produit sur les surfaces blanches environnantes.
- Pose naturelle d’une montre issue d’une autre image sur le poignet d’une personne.
- Publicité de montre conservant pose, morphologie et éclairage d’origine.
- Essayage avec cinq références : modèle, vêtements, chaussures, sac et chapeau.
- Placement du logo d’une autre image sur une photo de produit.
- Remplacement du seul emballage en conservant le décor de prise de vue.
- Détourage sur fond transparent d’un produit destiné à l’e-commerce.
- Déclinaison d’un même produit avec plusieurs arrière-plans et éclairages.
Sources d’attention : Editing Beast (environ 840 votes), exemples officiels à références multiples du blog
E. Édition de l’arrière-plan, de l’éclairage et des matériaux (41 à 50)
- Transformation d’un arrière-plan diurne en nuit pluvieuse.
- Remplacement du seul arrière-plan en conservant la personne.
- Transfert simultané de l’éclairage et de l’arrière-plan d’une image de référence.
- Remplacement d’un mur par la texture verte issue d’une autre image.
- Conversion d’un intérieur vers un éclairage de coucher de soleil chaud.
- Conversion vers un éclairage net de séance de haute couture.
- Recalcul des ombres de la personne selon la lumière de l’arrière-plan.
- Comparaison du photoréalisme avec bruit normal et bruit brownien.
- Comparaison des textures avec Euler et un échantillonneur personnalisé eta 0,50.
- Conciliation entre netteté et naturel avec un échantillonneur à deux étapes.
Sources d’attention : conseils d’édition, fil de test des réglages (environ 80 votes)
F. PNG transparents, détourage et édition locale (51 à 60)
- PNG à fond transparent d’un personnage unique.
- Asset produit à fond transparent.
- Ressource de design transparente composée de plusieurs éléments.
- Extraction d’une seule personne à partir d’une photo.
- Édition d’un sujet sur un calque transparent.
- Inpainting d’une forme comprenant des limites alpha.
- Modification simultanée de la forme d’un casque et des zones transparentes.
- Remplacement de la seule zone de vêtement peinte en rouge.
- Édition du seul petit objet entouré d’un cercle.
- Édition locale restaurant intégralement ce qui se trouve hors du masque.
Sources d’attention : édition alpha avec LanPaint (environ 77 votes), premier avis
G. Outpainting et restauration (61 à 70)
- Extension de la toile uniquement à gauche.
- Extension de la toile uniquement à droite.
- Extension de la toile uniquement en haut.
- Extension de la toile uniquement en bas.
- Extension simultanée à gauche, à droite et en bas.
- Complétion des espaces vides d’une photo inclinée.
- Restauration d’un arrière-plan perdu à cause d’un mauvais recadrage.
- Complétion de l’environnement d’un sujet partiellement coupé.
- Passage à un angle large tout en gardant le fond d’origine.
- Comparaison des changements de grain et de contraste lors de la restauration de photos anciennes.
Sources d’attention : test d’outpainting (environ 62 votes), test critique de restauration de photos
H. Affiches, texte et design graphique (71 à 80)
- Affiche événementielle comportant un grand titre.
- Design publicitaire dont la composition et la hiérarchie d’information ont été définies à l’avance.
- Comparaison pour stabiliser de grands textes à 2 à 2,5 MP.
- Comparaison visant à améliorer le niveau de détail de visuels sans texte autour de 4 MP.
- Design d’emballage comportant un nom de produit.
- Graphique affichant « Qwen » sur une télévision vintage.
- Composition naturelle d’enseignes ou logos dans une autre image.
- Mise en page complexe avec un long prompt.
- Test de texte déformé et d’insertion de chinois dans une infographie anglaise.
- Affiche comparant la qualité de design avec des modèles d’image de type GPT.
Sources d’attention : modèle de prompt pour le design, avis bref et exemple de télévision vintage
I. Transfert de style, illustration et création narrative (81 à 90)
- Conversion d’une photo réaliste en style bande dessinée.
- Conversion d’une personne réaliste en style Simpsons.
- Transfert du seul style visuel d’une référence vers une autre image.
- Transformation colorimétrique conservant personnage et arrière-plan.
- Génération d’une image au style photo Polaroid.
- Génération d’un storyboard en quatre cases.
- Déclinaison de la même personne dans plusieurs scènes.
- Plans narratifs successifs préservant animal, voiture et personne.
- Illustration dans le style d’une capture d’écran d’anime moderne.
- Comparaison d’échecs de style anime tiré vers le réalisme ou le cinéma.
Sources d’attention : expérience Polaroid, comparaison avec Krea 2 pour l’anime, premier avis
J. Workflows, vitesse et comparaisons de qualité (91 à 100)
- Comparaison de composition, texture et contraste avec CFG 1 à 5.
- Comparaison entre CFG inférieur ou égal à 2 et CFG 4, jugé « trop cuit ».
- Génération rapide à 16 étapes, 1 MP et INT8.
- Vérification de la qualité d’édition à 25 étapes et en 2K.
- Upscaling de 2K vers 4K après 30 étapes.
- Édition visant environ deux fois plus de vitesse avec une LoRA à 4 étapes.
- Génération de personne en environ 45 secondes avec 8 étapes, 1024×1280 et une RTX 3060.
- Comparaison de vitesse des fiches de personnages entre Qwen et FLUX.2 Krea.
- Test de précision pixel en 2K et d’intégration de 10 images de référence.
- Comparaison réduisant le bruit des détails avec Fix v2.0 et un échantillonneur spécialisé.
Sources d’attention : fil de publication des modèles ComfyUI (environ 106 votes), LoRA 4 étapes et faible VRAM (environ 44 votes), résultats d’expérimentation, Fix v2.0
Synthèse des avis Reddit
Points très appréciés
- Performances d’édition : préserve relativement bien l’image d’origine malgré le changement de couleurs, fond, matériaux, pose ou produit.
- Références multiples : performant pour combiner personnes, produits, vêtements et accessoires dans une même création.
- Cohérence des personnages : prometteur comme point de départ pour les documents de référence et les plans successifs.
- Images transparentes : permet non seulement le détourage, mais aussi la génération et l’édition de l’alpha lui-même.
- Outpainting : facile à utiliser pour étendre plusieurs directions simultanément.
- Taille et vitesse : pratique pour une partie générative 7B, avec de nombreuses options de quantification et d’accélération.
Faiblesses régulièrement signalées
- Les mains, doigts, bras et structures corporelles complexes sont instables.
- Les visages lointains et les traits fins se dégradent facilement.
- La sortie par défaut peut présenter une impression de bruit ou des détails désordonnés.
- Le contraste peut être fort, avec des noirs parfois trop bouchés.
- En restauration photo, le modèle peut modifier de lui-même le grain d’origine ou les formes fines.
- Des critiques signalent des silhouettes trapues dans les fiches de personnages.
- L’augmentation des images de référence favorise les confusions d’attributs et les hallucinations.
- Certains styles anime sont attirés vers une direction réaliste ou cinématographique.
- Le texte est parfois convaincant, mais les petits caractères et les infographies anglaises restent instables.
- Les résultats varient fortement selon les réglages, la réécriture de prompt et l’échantillonneur.
Ces avis contrastés montrent que Qwen-Image 2.1 n’est pas un « modèle universel parfait en un essai », mais un modèle de création axé sur l’édition, qui progresse à mesure que l’on affine réglages et workflow.
Démarrage pratique
Dans ComfyUI, mettez à jour vers la dernière version et choisissez Text-to-Image ou Image Edit depuis les modèles intégrés. Les workflows officiellement pris en charge sont également publiés sur GitHub. Commencez par créer une image de référence avec les 40 étapes proches des réglages officiels, puis réduisez à 16, 8 et 4 étapes pour comparer vitesse et qualité.
Pour l’édition, plutôt que d’écrire vaguement « améliorer », il est plus facile de tester en précisant les éléments dans cet ordre.
- Ce qui doit être modifié.
- L’image de référence dont il faut tirer cet élément.
- Ce qui ne doit absolument pas changer.
- Comment conserver lumière, arrière-plan, morphologie, pose et composition.
- Les éléments susceptibles d’échouer à inclure dans les instructions négatives.
Par exemple, pour une composition de produit : « conserver la personne et la pose de l’image 1, et placer uniquement la montre de l’image 2 au poignet. Ne pas modifier la morphologie, l’arrière-plan ni l’éclairage. » Il est essentiel de ne pas rendre ambiguë la correspondance entre <image1> et <image2> lorsqu’on utilise plusieurs références.
Dans les exemples partagés sur Reddit, les images transparentes précisent « RGBA image », « alpha channel » et « background is transparent ». Pour modifier jusqu’aux bordures transparentes, utilisez un traitement de masque compatible alpha comme LanPaint.
À qui convient-il ?
Qwen-Image 2.1 convient bien aux usages suivants.
- Personnes souhaitant créer localement avec ComfyUI.
- Personnes voulant ne modifier qu’une partie d’une personne ou d’un produit.
- Personnes souhaitant réunir plusieurs références dans une même publicité ou scène.
- Personnes créant des fiches de personnages ou des images de référence pour vidéo.
- Personnes créant des PNG transparents ou des assets pour jeux et Web.
- Équipes de recherche et développement exploitant une API de génération et d’édition d’images sur serveur dédié.
À l’inverse, pour une restauration photo parfaitement fidèle, une identité rigoureuse sur de longues œuvres continues, des poses complexes où les mains sont importantes, des infographies denses en petits caractères ou une adoption sans réserve pour un usage commercial, il est indispensable de comparer avec d’autres modèles et de vérifier la licence.
Conclusion
L’essence de Qwen-Image 2.1 réside dans l’intégration, autour d’une partie générative relativement compacte de 7 milliards de paramètres, de T2I, l’édition d’images, jusqu’à 10 références, l’édition locale, le RGBA transparent et l’extraction de sujets. Ce qui suscite le plus d’enthousiasme sur Reddit n’est pas la simple génération de jolies filles, mais les usages qui raccourcissent le processus de création : remplacement de montres ou de canettes, fiches de personnages, transfert d’arrière-plan et d’éclairage, outpainting et édition alpha.
Les évaluations des exemples dépendent toutefois fortement des réglages. CFG, échantillonneur, nombre d’étapes, résolution, réécriture de prompt et LoRA d’accélération peuvent produire des résultats si différents qu’ils semblent venir de modèles distincts. Il est prudent de créer d’abord une référence avec les réglages officiels, de comparer les modifications une par une et, pour les projets importants, d’effectuer une comparaison à l’aveugle avec d’autres modèles.
Enfin, la licence constitue le principal point d’attention. La publication des poids ne signifie pas que l’usage commercial est automatiquement libre. Le modèle est techniquement très attrayant, mais une adoption professionnelle doit être décidée après vérification de la licence officielle et des conditions les plus récentes.
Liens principaux
- Blog officiel de Qwen-Image 2.1
- Dépôt GitHub officiel
- Documentation Hugging Face Diffusers
- Modèle pour ComfyUI
- Reddit : collection d’exemples 1girl
- Reddit : Editing Beast
- Reddit : conseils d’édition
- Reddit : outpainting
- Reddit : inpainting du canal alpha
- Reddit : Qwen-Image 2.1 Fix v2.0
※ Cet article a été rédigé à partir des informations officielles et des publications communautaires publiques disponibles au 4 octobre 2026. Les votes Reddit, les outils autour du modèle et les conditions de licence peuvent évoluer.