J’ai évalué les performances RAG des SLM : 25 modèles de 1 à 9 milliards de paramètres comparés en croate et en anglais
Après avoir créé un modèle RAG croate maison et l’avoir même quantifié, j’ai voulu voir dans quelle mesure les petits modèles du marché (SLM) étaient réellement utilisables pour le RAG. J’ai fait résoudre les mêmes problèmes en croate et en anglais à 25 modèles — 10 de la classe 1B, 8 de la classe 3B et 7 de la classe 7B — auxquels j’ai ajouté mon propre modèle de 320 millions de paramètres.
Mise à jour (le même jour) : j’ai également testé trois petits modèles conçus spécifiquement pour le RAG (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). Les résultats figurent dans « Mise à jour : j’ai aussi testé des modèles dédiés au RAG » dans la seconde moitié de l’article.
Voici d’abord les conclusions.
- Les modèles de 3 à 4B sont désormais presque au niveau de ceux de 8 à 9B. En croate, Qwen3.5 4B et Gemma 4 E4B atteignent 90 % de précision globale, contre 91 % pour le meilleur, Qwen3.5 9B
- Ce qui fait la différence, c’est la capacité à refuser lorsqu’il n’y a pas de réponse. Phi-4-mini, pourtant parmi les meilleurs en précision, a inventé une réponse dans 64 % des longs textes sans réponse
- En anglais, davantage de modèles refusent alors que la réponse existe. OLMo 3 7B a refusé 47 % des paragraphes anglais, et MiniCPM5 2B en a refusé 70 %
- Sur CPU, les modèles de 7B mettent plus de 30 secondes pour une question sur un long texte. Les modèles de 1B prennent 4 à 13 secondes. Mon modèle de 320 millions prend 2,1 secondes et est à peu près aussi précis que Qwen3.5 0.8B
Ce que j’ai fait
Problèmes : les mêmes questions que dans l’article précédent, créées à partir de Wikipédia en croate. Pour chaque question, je fournis quatre types de textes.
- Paragraphe : un paragraphe d’environ 100 tokens contenant la réponse
- Long texte : un texte d’environ 3 000 tokens contenant la réponse (avec aussi des articles sans rapport)
- Sans réponse (paragraphe / long texte) : un texte qui ne contient pas la réponse. Répondre « La réponse ne figure pas dans le texte » était considéré comme correct
Version anglaise : les mêmes problèmes ont été traduits en anglais avec EuroLLM-9B. J’ai retiré des deux langues les problèmes où la réponse avait disparu à la traduction ou était restée en croate sans être traduite, puis comparé les mêmes 260 questions.
Instruction : dans chaque langue, j’ai donné l’instruction : « Utilise uniquement le texte ci-dessous et réponds brièvement en une phrase. S’il n’y a pas de réponse, réponds uniquement “La réponse ne figure pas dans le texte”. »
Évaluation : j’ai demandé à Qwen3.5 9B de comparer la réponse à la réponse modèle et de la classer comme « correcte », « incorrecte » ou « refus ». J’ai vérifié moi-même 65 cas : l’évaluation était légèrement généreuse, puisqu’elle comptait aussi comme correctes des réponses partielles, par exemple ne donnant que l’année, mais les décisions sur le fait qu’un modèle avait refusé étaient toutes justes.
Taux de précision global : le nombre de réponses correctes sur les paragraphes et les longs textes, additionné au nombre de refus corrects lorsqu’il n’y avait pas de réponse, puis divisé par l’ensemble des problèmes. C’est une mesure qui évalue à la fois la capacité à répondre correctement et à se taire lorsqu’on ne sait pas.
Exécution : la précision a été mesurée avec vLLM sur une RTX 4090, en générant à chaque fois le mot le plus probable. J’ai désactivé le « mode réflexion » des modèles qui en disposent, où ils réfléchissent avant de répondre. Les modèles de 7B ont été passés en FP8 pour tenir dans la mémoire GPU.
Résultats : précision (croate)
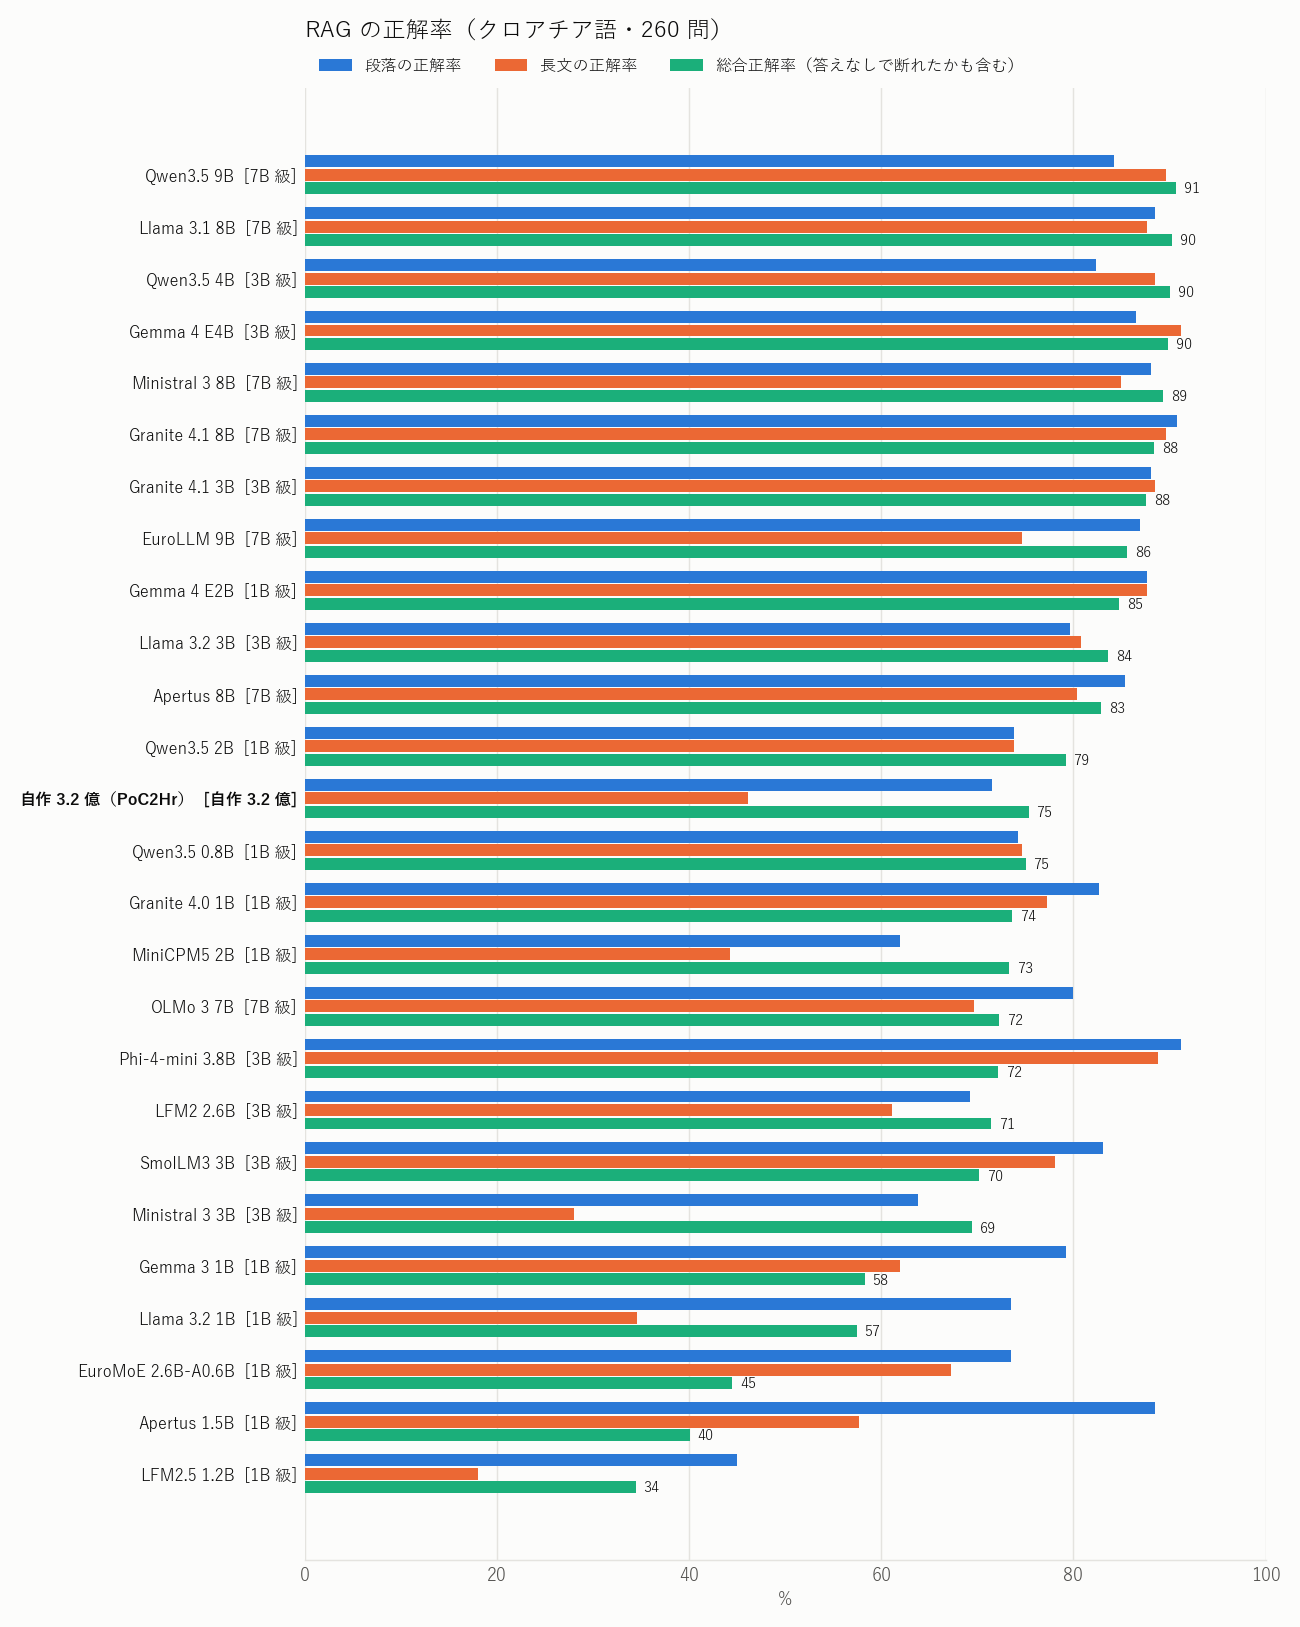
- Les meilleurs sont presque tous au coude-à-coude autour de 90 %. Qwen3.5 9B (91 %), Llama 3.1 8B, Qwen3.5 4B et Gemma 4 E4B (90 %)
- Dans la classe 1B, Gemma 4 E2B se détache (85 %). Malgré son nom en 2B, son fichier est plutôt volumineux, à 3,2 Go
- Certains modèles chutent au score global malgré une forte précision sur les paragraphes et les longs textes. Phi-4-mini fait partie du meilleur groupe avec 91 % sur les paragraphes et 89 % sur les longs textes, mais son score global n’est que de 72 %. La raison est l’« invention » de réponses expliquée ensuite
- Le plus mauvais était LFM2.5 1.2B (34 %). Il ne répondait pas correctement aux questions avec réponse et inventait des réponses pour celles qui n’en avaient pas
Résultats : précision (anglais)
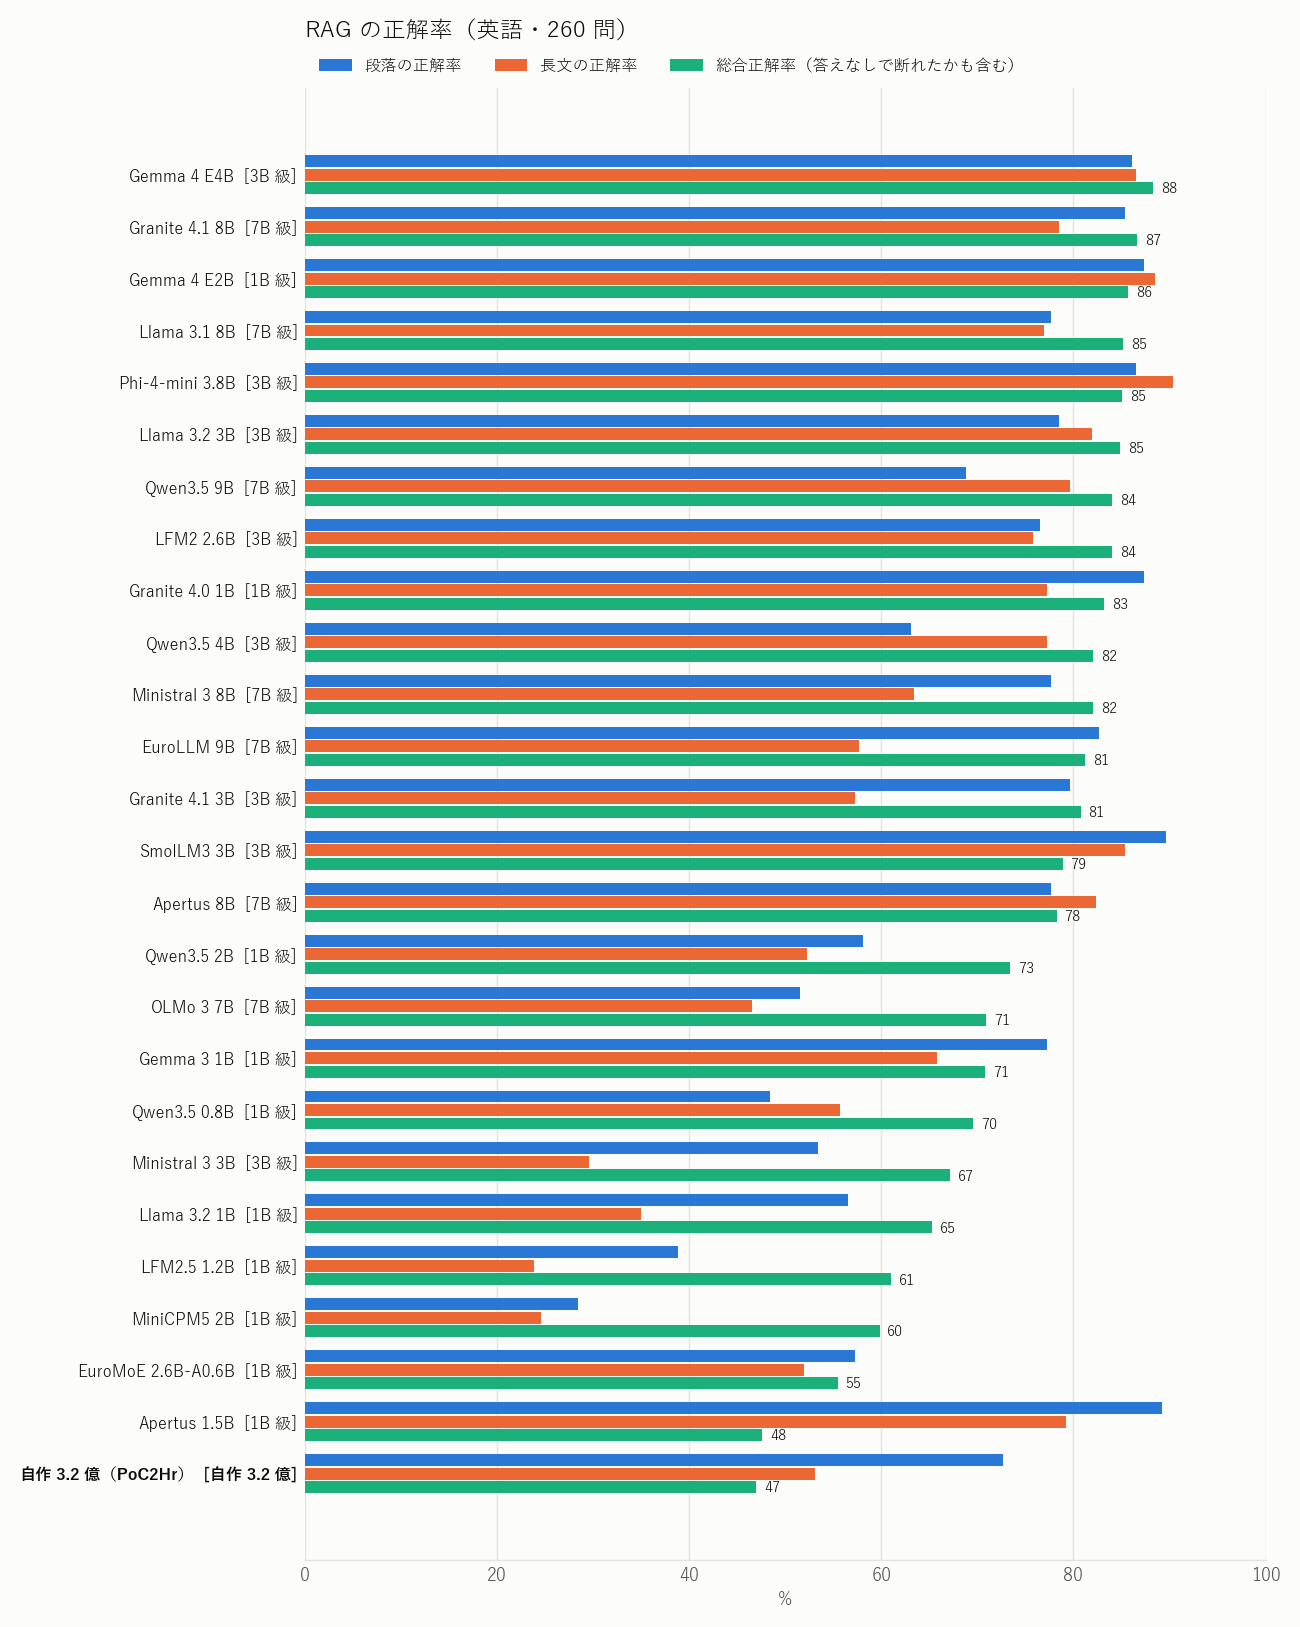
- Le meilleur est Gemma 4 E4B (88 %). Gemma 4 E2B atteint aussi 86 %, donc Gemma 4 est stable dans les deux langues
- Certains modèles perdent des places en anglais. Qwen3.5 4B passe de 90 % en croate à 82 % en anglais. La cause est qu’il refuse alors que la réponse existe (35 % des paragraphes)
Ce que j’ai appris 1 : ce qui fait la différence, c’est la capacité à refuser
Proportion de réponses inventées lorsqu’on fournit un long texte sans réponse (croate).
| Modèle | Réponses inventées dans les longs textes sans réponse |
|---|---|
| Qwen3.5 4B | 9 % |
| Modèle maison 320M | 9 % |
| Qwen3.5 9B | 10 % |
| Gemma 4 E4B | 19 % |
| Granite 4.1 8B | 30 % |
| Phi-4-mini 3.8B | 64 % |
| SmolLM3 3B | 73 % |
| EuroMoE 2.6B-A0.6B | 94 % |
Par exemple, à la question « Quand Need for Speed Heat est-il sorti ? », avec un long texte ne contenant pas la réponse. Qwen3.5 9B a répondu « La réponse ne figure pas dans le texte », tandis que Phi-4-mini a répondu « août 1969 ». Il semble avoir repris une date qui figurait quelque part dans le texte.
C’est le principal problème avec le RAG. Il est dangereux de choisir un modèle en ne regardant que son taux de précision. Parmi les réponses données, Qwen3.5 4B et 9B avaient le meilleur taux de correction, à 91–92 %, tandis que Phi-4-mini n’atteignait que 64 %.
Ce que j’ai appris 2 : en anglais, les modèles refusent trop souvent
À l’inverse, en anglais, de nombreux modèles refusaient alors que la réponse était clairement écrite. Voici la proportion de refus lorsqu’on leur fournissait un paragraphe contenant la réponse.
| Modèle | Croate | Anglais |
|---|---|---|
| Qwen3.5 4B | 15 % | 35 % |
| Qwen3.5 0.8B | 17 % | 47 % |
| OLMo 3 7B | 8 % | 47 % |
| MiniCPM5 2B | 34 % | 70 % |
| Gemma 4 E4B | 9 % | 8 % |
Par exemple : « Quand Paul Accola est-il monté sur le podium pour la dernière fois ? » Le paragraphe anglais indiquait clairement « the last time in 2000 », mais Qwen3.5 4B a répondu « La réponse ne figure pas dans le texte ». Posée en croate, la même question reçoit la bonne réponse : « 2000 ».
La raison reste inconnue. La version anglaise étant issue d’une traduction automatique, le caractère peu naturel des textes y joue peut-être un rôle ; il est aussi possible que les modèles réagissent trop fortement, en anglais, à l’instruction disant quoi répondre en l’absence de réponse.
Résultats : vitesse sur CPU
Mon utilisation suppose une exécution sur CPU ; j’ai donc converti tous les modèles dans le même format llama.cpp (Q4_K_M) et les ai mesurés sur un i7-13700K. La génération utilisait 8 threads, et la lecture des textes 16 threads. Seul Ministral 3 n’a pas pu être correctement converti : j’ai donc utilisé le Q4_K_M officiel de Mistral.
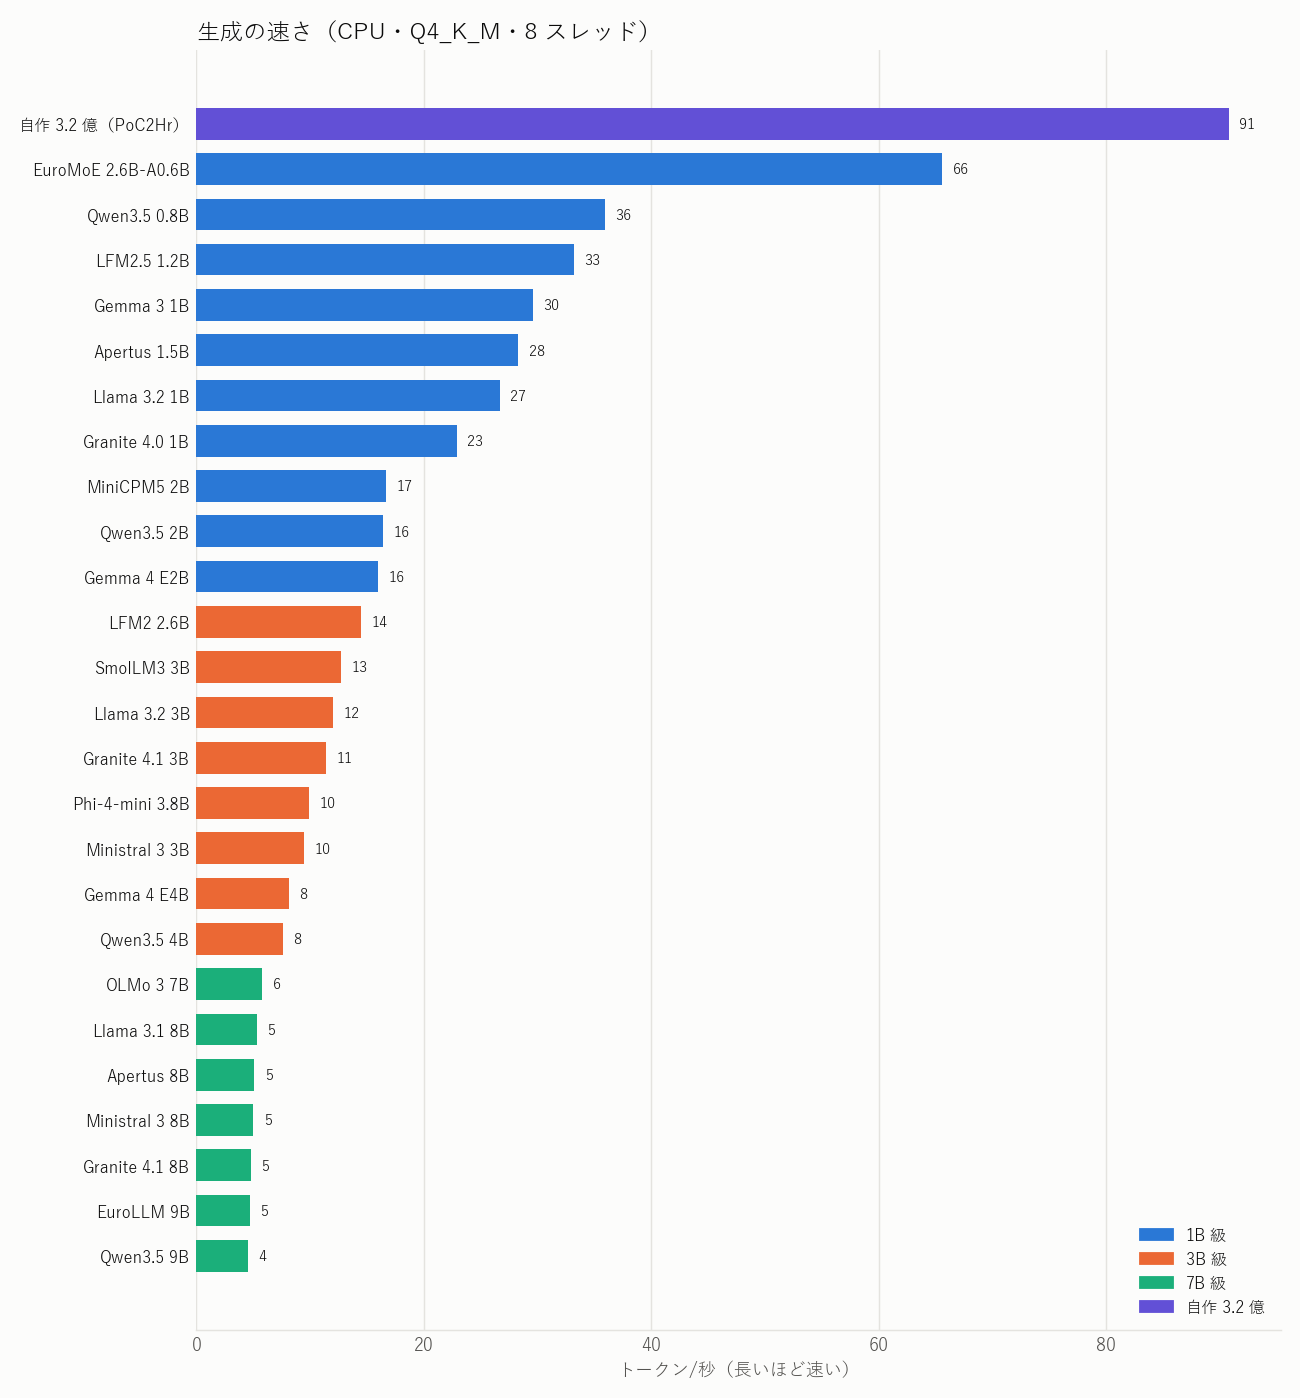
J’ai aussi estimé le temps nécessaire pour répondre à une question sur un long texte : pour chaque modèle, il s’agit du temps de lecture du nombre de tokens d’entrée des longs textes, additionné au temps de génération de la longueur moyenne de réponse.
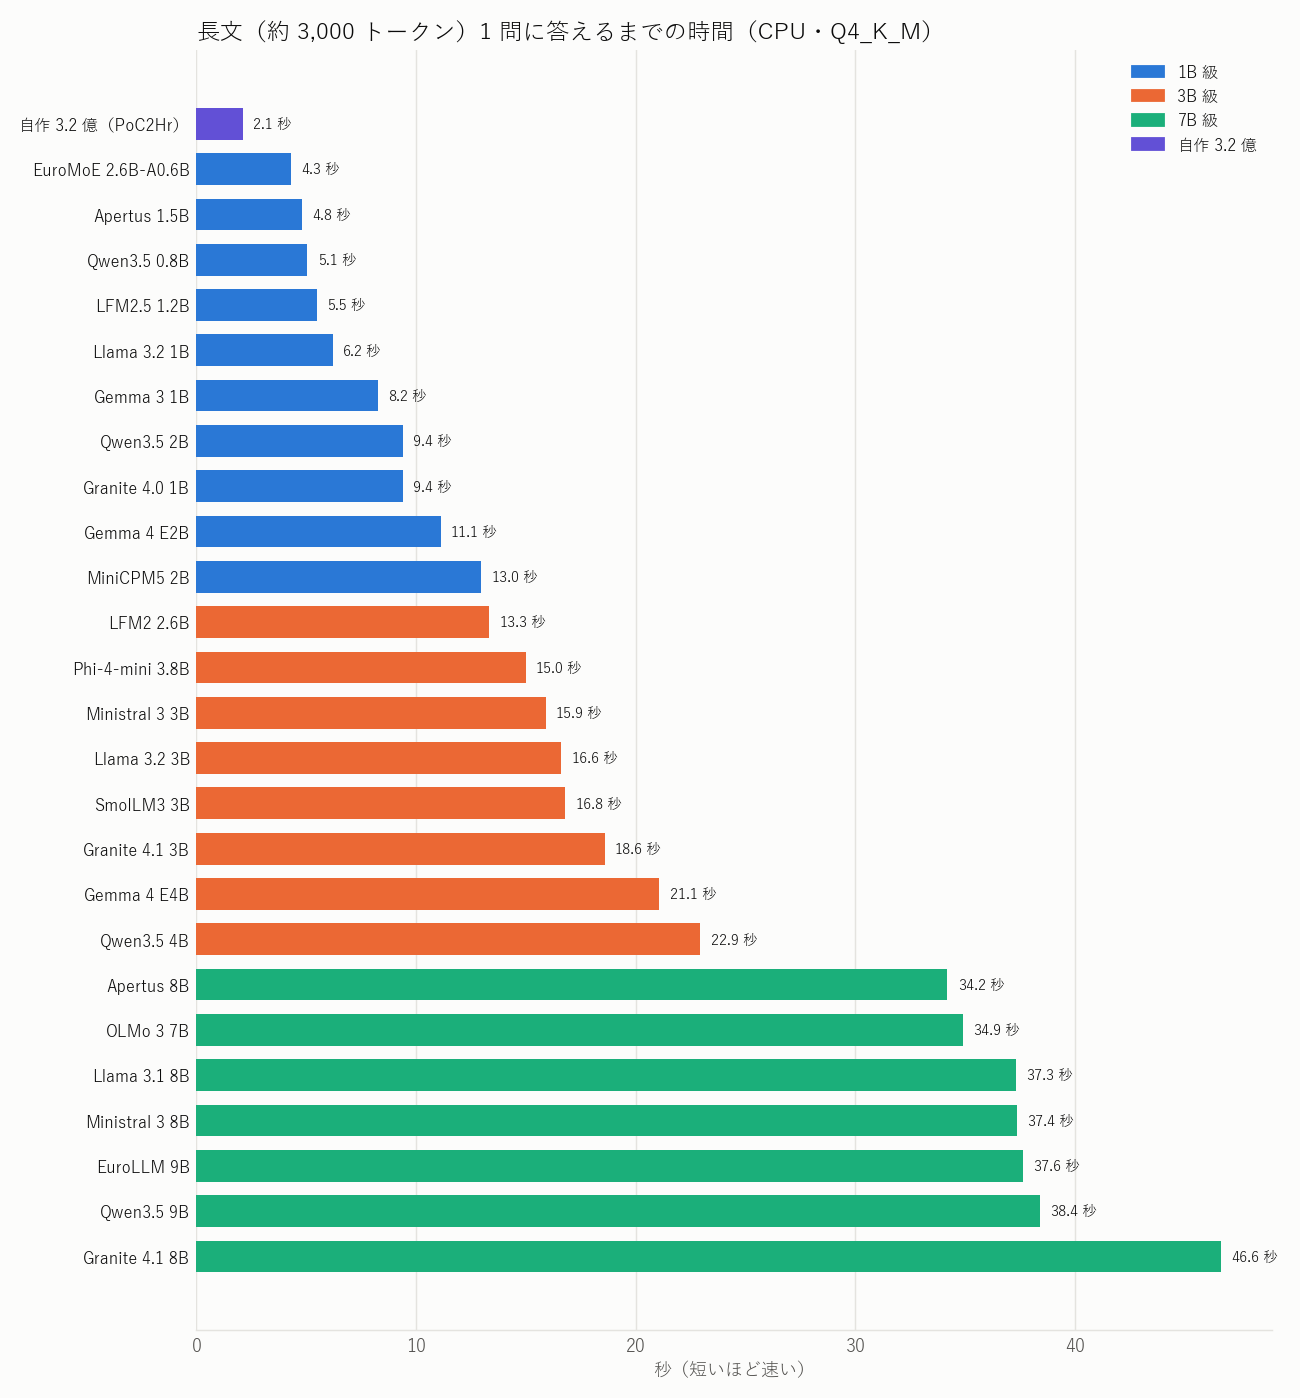
- La vitesse de génération est globalement inversement proportionnelle à la taille. Les modèles de 7B tournent autour de 5 tokens par seconde, soit 34 à 47 secondes pour une question sur un long texte
- Les modèles de 3B prennent 13 à 23 secondes, ceux de 1B prennent 4 à 13 secondes
- Même pour un même long texte, le nombre de tokens d’entrée varie de 2 443 à 3 796 selon le modèle. Cela dépend de la capacité du tokenizer à représenter le croate de manière compacte, et le tokenizer de mon modèle maison, conçu spécialement pour le croate, est le plus court
En mettant vitesse et précision côte à côte
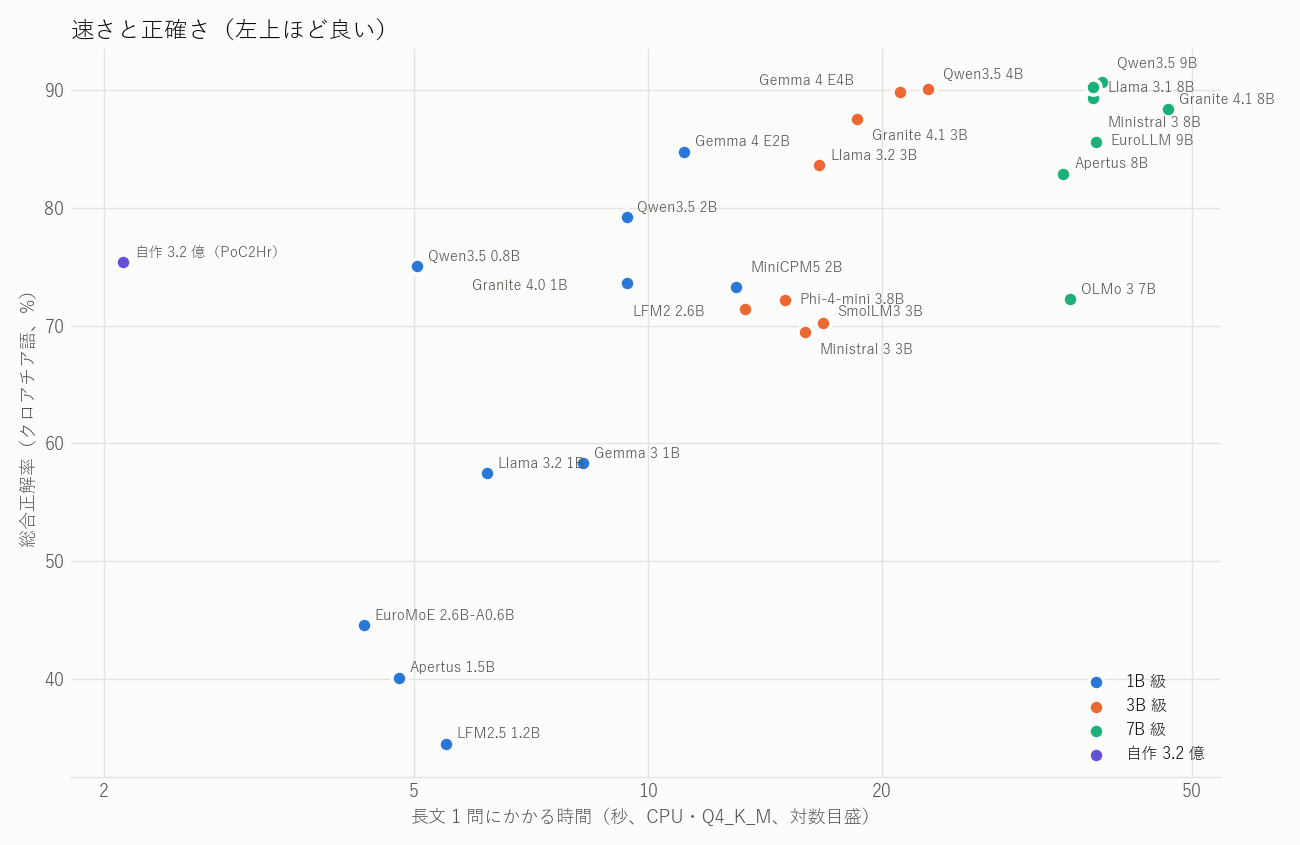
Plus on va vers le coin supérieur gauche, plus le modèle est « rapide et précis ».
- Les meilleurs compromis sont Gemma 4 E2B (11 secondes, 85 %) et Qwen3.5 2B (9 secondes, 79 %)
- Pour privilégier la précision : Qwen3.5 4B ou Gemma 4 E4B (21 à 23 secondes, 90 %). Ils sont plus de 1,5 fois plus rapides que les modèles de 7B, pour une précision presque identique
- Mon modèle maison de 320M est dans une catégorie à part pour la vitesse (2,1 secondes). Son taux de précision global de 75 % est identique à celui de Qwen3.5 0.8B, et il invente aussi peu de réponses que les modèles les mieux classés. Mais son taux de précision sur les longs textes, de 46 %, est nettement inférieur à celui de Qwen3.5 0.8B (75 %) et Gemma 4 E2B (88 %)
- Mon modèle maison n’ayant pas appris l’anglais, il a inventé une réponse dans 91 % des longs textes anglais sans réponse
Points d’attention
- L’évaluation est effectuée par un LLM, elle n’est donc pas parfaite. Elle est légèrement généreuse
- La version anglaise est une traduction automatique. Les questions comme leur traduction ont été produites par EuroLLM-9B, ce qui peut lui donner un léger avantage (son résultat est de 86 %, dans la moyenne)
- Apertus 1.5B ne peut gérer qu’un contexte de 4 096 tokens ; 23 % des longs textes en croate ne tenaient pas. Ces cas ont été comptés comme incorrects
- La précision a été mesurée sur GPU (vLLM, FP8 pour les modèles de 7B), et la vitesse sur CPU (Q4_K_M) : les environnements de mesure sont donc différents. La quantification peut légèrement modifier la précision
- La vitesse a été mesurée sur un PC où mes applications habituelles étaient encore ouvertes. Tous les modèles ont été mesurés successivement dans les mêmes conditions, donc je pense que les comparaisons restent valables
Réflexions
- Pour le RAG, 4B suffit désormais. Les meilleurs modèles de 3 à 4B sont aussi précis que les modèles de 7 à 9B et sont 1,5 à 2 fois plus rapides sur CPU
- Lors du choix d’un modèle, il faut absolument vérifier sa capacité à refuser. Même à précision comparable, le taux de réponses inventées dans les textes sans réponse varie de 1 % à 99 % selon les modèles. En RAG, la recherche récupère souvent des textes non pertinents, donc c’est le facteur le plus important
- Un même modèle se comporte différemment selon la langue. Beaucoup de modèles étaient trop prudents en anglais et rataient des réponses. Impossible de le savoir sans les tester dans la langue réellement utilisée
- Le défi de mon modèle maison, ce sont les longs textes. Sa capacité à refuser et sa vitesse sont suffisantes ; si sa précision sur les longs textes progresse, il devrait devenir très utilisable comme « modèle RAG fonctionnant sur CPU ». C’est ce que je veux améliorer ensuite
Mise à jour : j’ai aussi testé des modèles dédiés au RAG
Je me suis demandé : « Que valent les modèles optimisés spécialement pour le RAG ? » J’ai donc ajouté trois petits modèles dédiés au RAG. Les conditions étaient les mêmes que ci-dessus (les mêmes 260 questions et la même évaluation).
- LFM2-1.2B-RAG (Liquid AI) : une version de LFM2-1.2B entraînée davantage sur plus d’un million d’exemples où il faut répondre à partir de documents fournis. Les langues prises en charge comprennent l’anglais, le japonais et 7 autres langues, mais pas le croate
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs) : modèles entraînés sur environ 3,1 millions de données RAG synthétiques. Avant de répondre, ils écrivent une « analyse de la question → analyse des documents → ébauche », puis ajoutent à leur réponse des citations du texte. Les langues prises en charge sont 7 langues européennes, mais pas le croate. Le contexte gérable est limité à 4 096 tokens
- Pour comparer, j’ai aussi mesuré le LFM2-1.2B de base, dont est issu LFM2-1.2B-RAG
J’ai fourni à LFM2-1.2B-RAG les mêmes instructions qu’aux autres modèles. Pleias n’accepte qu’un format d’entrée dédié, qui sépare la question et les documents par des symboles spécifiques ; je l’ai donc utilisé au même format que la bibliothèque officielle et n’ai évalué que la partie réponse finale. Je n’ai donc pas pu donner à Pleias l’instruction indiquant quoi répondre s’il n’y avait pas de réponse.
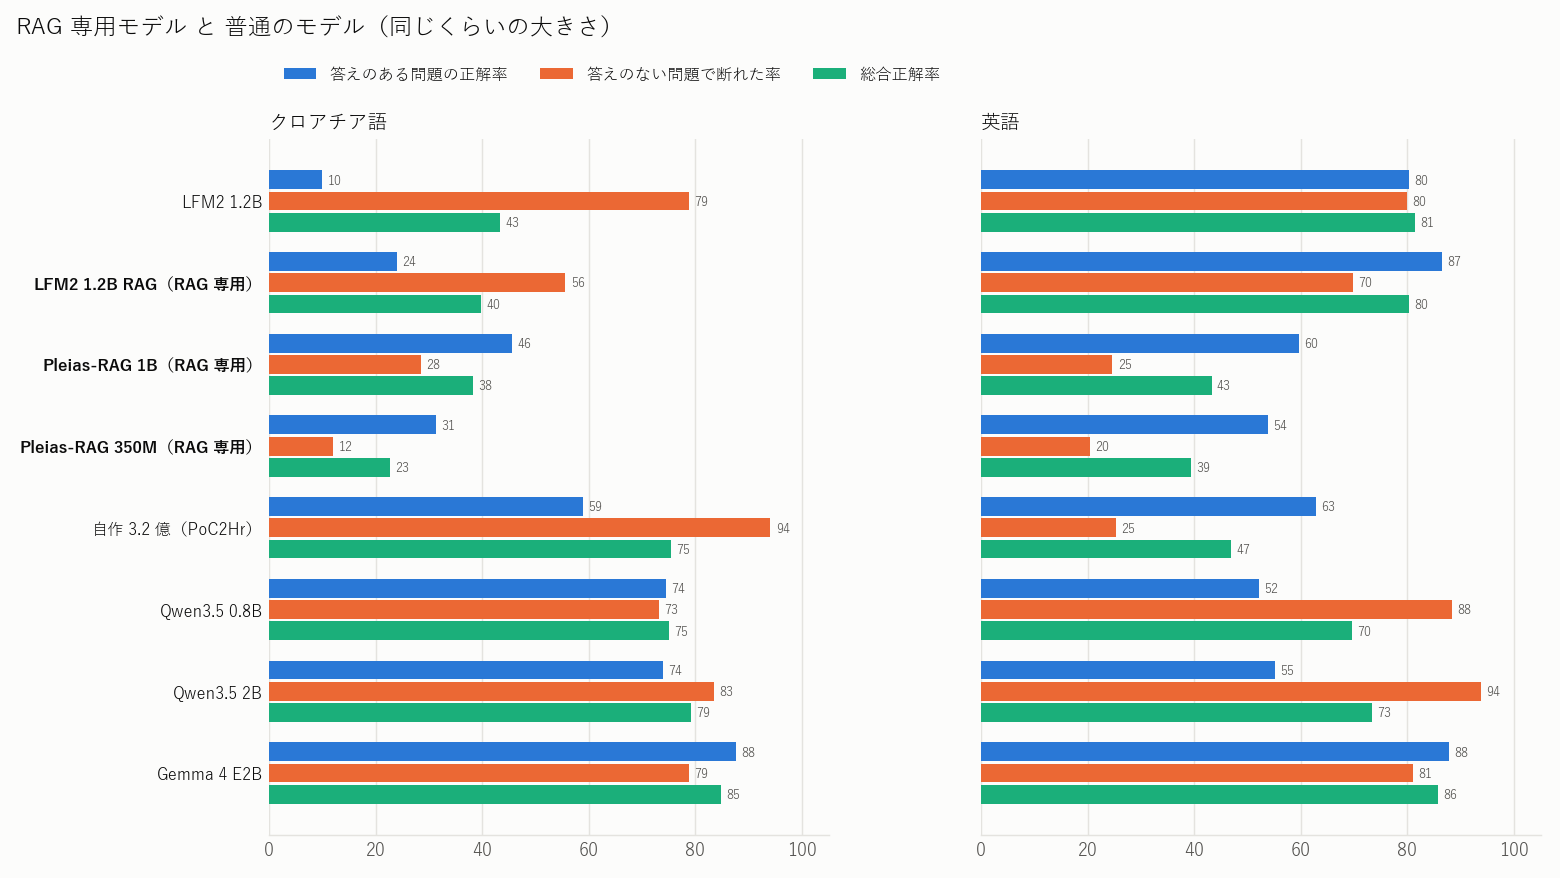
| Modèle | Global (croate) | Global (anglais) | Réponses inventées dans les longs textes sans réponse (croate / anglais) | Temps pour une question sur un long texte (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (modèle de base) | 43 % | 81 % | 42 % / 36 % | 7,8 secondes |
| LFM2 1.2B RAG | 40 % | 80 % | 61 % / 51 % | 8,1 secondes |
| Pleias-RAG 1B | 38 % | 43 % | 57 % / 73 % | 16,9 secondes |
| Pleias-RAG 350M | 23 % | 39 % | 68 % / 92 % | 6,0 secondes |
| Référence : modèle maison 320M | 75 % | 47 % | 9 % / 91 % | 2,1 secondes |
| Référence : Qwen3.5 0.8B | 75 % | 70 % | 43 % / 21 % | 5,1 secondes |
| Référence : Gemma 4 E2B | 85 % | 86 % | 37 % / 32 % | 11,1 secondes |
Pour le dire d’emblée : sur ces problèmes, je n’ai pas trouvé de domaine où les modèles dédiés au RAG étaient meilleurs que les modèles ordinaires.
LFM2-1.2B-RAG : il répond davantage, mais invente aussi davantage
Par rapport au LFM2-1.2B de base en anglais, le taux de précision sur les problèmes avec réponse a augmenté (paragraphes : 83 % → 87 %, longs textes : 78 % → 86 %). Mais les réponses inventées dans les textes sans réponse ont également augmenté (paragraphes : 4 % → 10 %, longs textes : 36 % → 51 %), et le score global est resté presque identique, passant de 81 % à 80 %. L’entraînement supplémentaire pour le RAG semble l’avoir orienté vers le fait de « répondre à tout prix ».
En croate, le modèle de base est déjà presque inutilisable. LFM2-1.2B de base a refusé 93 % des paragraphes contenant une réponse en disant « il n’y a pas de réponse », et la version RAG a souvent renvoyé l’instruction elle-même, par exemple « Odgovori kratko, jednom rečenicom. (Réponds brièvement en une phrase.) ». Le croate ne faisant pas partie des langues prises en charge, c’est compréhensible.
Pleias-RAG : il ajoute des citations, mais ces citations ne sont pas dans le texte
Pleias a très rarement refusé les textes sans réponse. En anglais, il a inventé une réponse dans 78 % des paragraphes sans réponse et dans 73 % des longs textes sans réponse (1B).
Même son argument de vente, les « réponses avec citations », est douteux. J’ai calculé la proportion de phrases citées retrouvées telles quelles dans le texte (il s’agit d’une correspondance exacte en ignorant uniquement les différences d’espaces ; les citations légèrement reformulées comptent donc aussi comme « introuvables »).
| Problèmes avec réponse | Problèmes sans réponse | |
|---|---|---|
| Pleias-RAG 1B (anglais) | 64 % | 42 % |
| Pleias-RAG 1B (croate) | 57 % | 53 % |
| Pleias-RAG 350M (anglais) | 66 % | 39 % |
| Pleias-RAG 350M (croate) | 52 % | 40 % |
Par exemple : « Quel groupe a écrit en premier la chanson “Tourniquet” ? » (la réponse est Soul Embraced).
- Avec un paragraphe ne contenant pas la réponse, le modèle 1B a répondu « Amy Lee l’a écrite », en ajoutant comme citation « Amy Lee (born Amy Leigh Lee, November 1, 1970) ... », une phrase absente du texte
- Même avec un paragraphe contenant la réponse, il a répondu « Amy Lee l’a écrite ». Sa citation était pourtant « originally written ... for the Christian death metal band Soul Embraced » : la citation est correcte, mais la réponse la contredit
La présence de citations donne l’impression que la réponse est réellement fondée sur le texte, ce qui la rend au contraire plus dangereuse.
En matière de vitesse aussi, Pleias écrit une analyse avant sa réponse, donc ses réponses sont longues (381 à 420 tokens en moyenne pour les longs textes). Le modèle 1B a mis 16,9 secondes par question sur un long texte, plus lentement que Gemma 4 E2B (11,1 secondes). De plus, 25 % des longs textes croates ne tenaient pas dans son contexte (ils ont été comptés comme incorrects ; le temps est une moyenne calculée seulement sur les problèmes qui tenaient, donc le temps réel est un peu plus élevé).
Pourquoi ce résultat ? (hypothèses)
- Langue : les trois modèles ne prennent pas le croate en charge. Mais ils perdent aussi face aux modèles ordinaires en anglais
- Forme des problèmes : ici, il faut « répondre brièvement à partir d’un texte / refuser s’il n’y a pas de réponse ». Pleias est évalué sur des problèmes demandant de combiner plusieurs sources, comme HotpotQA ; sa forme de prédilection est peut-être différente
- Manière de refuser : il est possible de dire aux modèles ordinaires quoi répondre lorsqu’il n’y a pas de réponse, mais Pleias n’offre aucun emplacement pour cette instruction. Le modèle possède lui-même un mécanisme pour juger qu’il ne peut pas répondre à partir des documents, mais il a peu fonctionné ici
Résumé de la mise à jour
- Il vaut mieux ne pas choisir un modèle uniquement parce qu’il est étiqueté « dédié au RAG ». Dans ces conditions, les modèles d’instructions ordinaires comme Gemma 4 E2B et Qwen3.5 étaient plus précis et refusaient quand il le fallait
- Une réponse avec citations ne signifie rien si l’on ne vérifie pas les citations elles-mêmes. Seules 40 à 70 % des citations de Pleias pouvaient être retrouvées telles quelles dans le texte
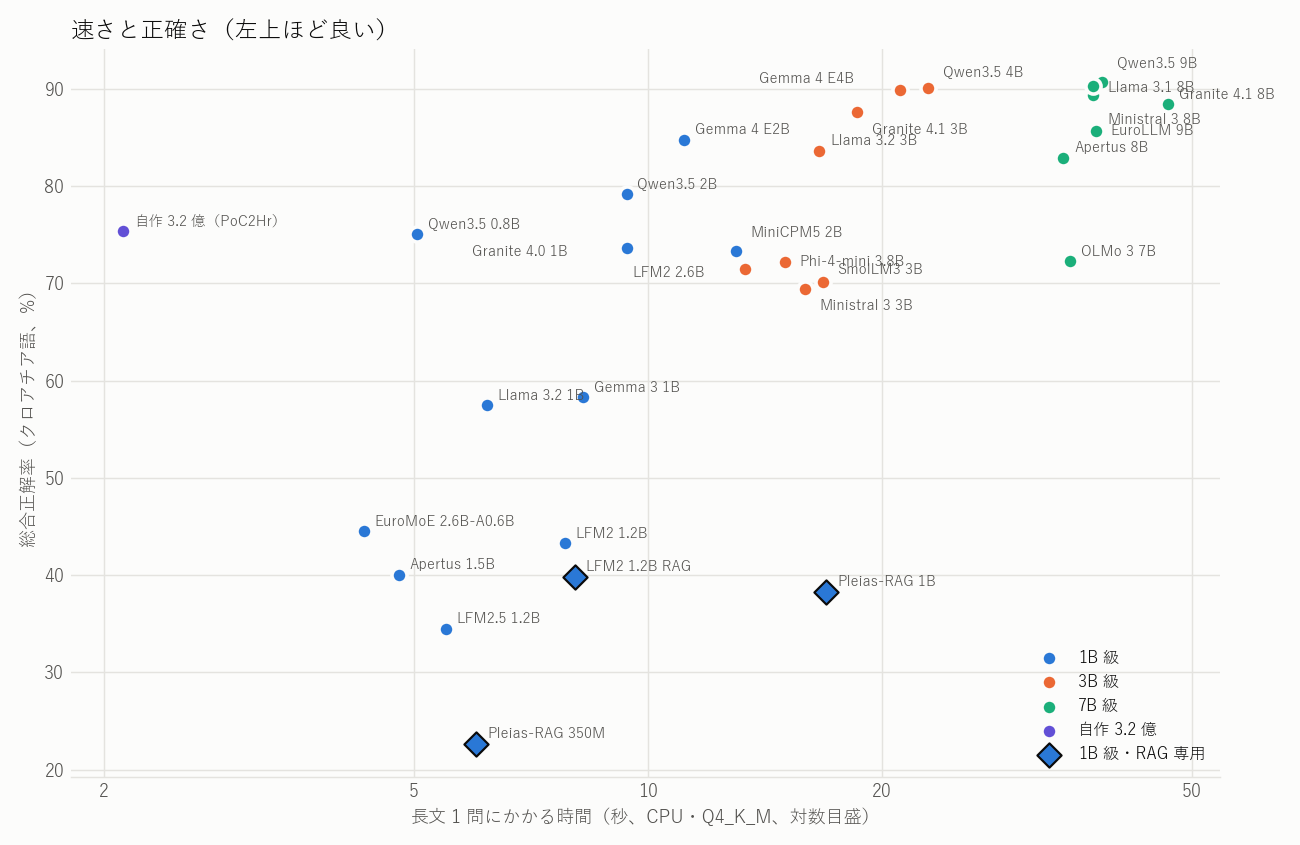
- Mon modèle maison dépasse les modèles RAG dédiés de taille comparable. Face à Pleias-RAG 350M, il atteint 75 % contre 23 % en score global croate, et 2,1 secondes contre 6,0 secondes par question sur un long texte. Le fait de l’avoir conçu spécialement pour le croate a donc eu un intérêt
La vitesse des quatre modèles ajoutés a été mesurée le soir du même jour, sur le même PC et dans les mêmes conditions. Ils ont aussi été ajoutés au graphique de vitesse et précision.
Tous les résultats
Croate
| Modèle | Catégorie | Correct pour les paragraphes | Correct pour les textes longs | Global | Invention en l’absence de réponse (paragraphe/texte long) | Proportion de réponses correctes parmi celles données |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | Classe 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | Classe 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | Classe 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | Classe 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | Classe 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | Classe 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | Classe 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | Classe 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | Classe 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | Classe 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | Classe 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | Classe 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| Personnalisé 320M | Personnalisé | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | Classe 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | Classe 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | Classe 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | Classe 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | Classe 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | Classe 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | Classe 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | Classe 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | Classe 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | Classe 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | Classe 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | Classe 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | Classe 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | Classe 1B・spécialisé RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | Classe 1B・spécialisé RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | Classe 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | Classe 1B・spécialisé RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Anglais
| Modèle | Catégorie | Correct pour les paragraphes | Correct pour les textes longs | Global | Invention en l’absence de réponse (paragraphe/texte long) | Proportion de réponses correctes parmi celles données |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | Classe 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | Classe 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | Classe 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | Classe 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | Classe 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | Classe 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | Classe 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | Classe 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | Classe 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | Classe 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | Classe 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | Classe 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | Classe 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | Classe 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | Classe 1B・spécialisé RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | Classe 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | Classe 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | Classe 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | Classe 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | Classe 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | Classe 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | Classe 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | Classe 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | Classe 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | Classe 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | Classe 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | Classe 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| Personnalisé 320M | Personnalisé | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | Classe 1B・spécialisé RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | Classe 1B・spécialisé RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Vitesse sur CPU (i7-13700K・llama.cpp Q4_K_M)
| Modèle | Taille | Génération (jetons/s) | Lecture (jetons/s) | Nombre de jetons en entrée pour les textes longs | Temps pour 1 question sur texte long |
|---|---|---|---|---|---|
| Personnalisé 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 s |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 s |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 s |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 s |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 s |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 s |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 s |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 s |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 s |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 s |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 s |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 s |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 s |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 s |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 s |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 s |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 s |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 s |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 s |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 s |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 s |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 s |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 s |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 s |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 s |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 s |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 s |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 s |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 s |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 s |
※ Pour Apertus 1.5B et Pleias-RAG, il s’agit de la moyenne des seuls textes longs qui tenaient dans le contexte de 4,096 jetons.