J’ai créé un modèle de synthèse vocale croate de 32 millions de paramètres : comparaison des voix en cours d’entraînement
Après le LLM croate pour le RAG, j’ai cette fois créé un petit modèle de synthèse vocale (TTS) exclusivement pour le croate. L’objectif : le faire fonctionner en temps réel sur le CPU d’un smartphone.
La méthode : la « distillation ». J’ai fait lire des scripts croates à un grand modèle de synthèse vocale (HiggsAudio v3) afin de produire les données d’entraînement, puis j’ai entraîné un petit modèle de zéro avec celles-ci. Pour commencer, j’ai effectué un entraînement pilote sur 7,5 heures de données et comparé l’évolution d’une même phrase au fil de l’entraînement.
Voici d’abord les conclusions.
- Avec 32 millions de paramètres (Matcha-TTS 18,3 M + Vocos 13,5 M), le modèle parlait bel et bien croate
- Dès 50 minutes d’entraînement (5 000 étapes), il lisait déjà le script correctement. Les améliorations ultérieures concernaient surtout le « bruit »
- Le taux d’erreur de caractères sur 14 phrases d’évaluation était de 0,9 % à la fin (10 phrases sur 14 correspondaient parfaitement)
- Même avec un seul thread CPU, il produisait une seconde d’audio en 0,09 seconde (i7-13700K)
Démo : faites-le réellement parler
J’ai mis le modèle de cet article (la version finale à 30 000 étapes) sur le terrain de jeu TTS croate. Saisissez le croate de votre choix : il le lit immédiatement.
- Vous pouvez choisir parmi 50 phrases d’exemple (salutations, voyage, hôpital, etc.) ou saisir votre propre texte, jusqu’à 1 000 caractères
- Vous pouvez modifier la vitesse de parole, l’amplitude de l’intonation et le nombre d’étapes de synthèse. Avec une graine fixe, une même phrase produit toujours le même audio
- La synthèse fonctionne uniquement sur le CPU du serveur (ONNX Runtime ; ni GPU ni API externe)
- Il ne sait pas lire les chiffres : il faut les écrire en toutes lettres, par exemple « dvadeset pet (25) »
Ce que j’ai fait
1. Créer les scripts : j’ai demandé à Gemma 4 31B, en local, d’écrire des répliques de conversations courantes en croate. Je lui indiquais aléatoirement une situation, l’interlocuteur, l’émotion et la longueur — par exemple « parler avec une grand-mère au marché » ou « entendre un bruit étrange la nuit et avoir peur » — avec 22 lignes à la fois. Le locuteur était une femme d’une trentaine d’années. J’ai mélangé 23 émotions (neutre, joie, colère, chuchotement, etc.).
2. Produire l’audio : j’ai fait lire les scripts à HiggsAudio v3 avec la voix d’un audio de référence (16 secondes). Avec des balises d’émotion (<|emotion:anger|>, etc.), il se met réellement en colère ou se réjouit. J’ai créé 4 500 clips en environ 5 heures.
3. Vérifier automatiquement : j’ai transcrit les clips avec Whisper large-v3 et les ai comparés aux scripts pour écarter les erreurs de lecture. J’ai également mesuré la proximité de la voix avec l’audio de référence grâce à un modèle de reconnaissance du locuteur, afin d’écarter les clips dont la voix avait changé. Au final, 4 393 clips sur 4 500 (97,6 %) ont été retenus. Après suppression des silences au début et à la fin, cela représentait 7,46 heures.
4. Entraîner le petit modèle : j’ai entraîné Matcha-TTS (un TTS fondé sur le flow matching) pendant 5 heures sur une RTX 4090, soit environ 30 000 étapes. Pour la partie qui reconvertit en forme d’onde audio (le vocodeur), j’ai utilisé Vocos, déjà disponible publiquement.
Le croate se lit presque comme il s’écrit ; j’ai donc utilisé les caractères directement comme entrée, sans les convertir en phonèmes. Toutefois, lj, nj et dž correspondent chacun à un seul son, je les ai donc regroupés comme un seul caractère.
Comparer les audios pendant l’entraînement
J’ai synthétisé avec les modèles en cours d’entraînement une phrase absente des données d’entraînement : « Molim Vas, možete li mi reći koliko košta ova haljina? » (Excusez-moi, combien coûte cette robe ?).
étape 5 000 (environ 50 minutes après le début de l’entraînement)
étape 10 000 (environ 1 heure 40 minutes)
étape 15 000 (environ 2 heures 20 minutes)
étape 20 000 (environ 3 heures 10 minutes)
étape 30 000 (environ 5 heures, version finale)
À titre de référence, voici l’un des clips de données d’entraînement générés par HiggsAudio, qui joue le rôle du professeur (une autre phrase : « Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak. »).
Selon la transcription de Whisper, cette phrase était strictement identique au script de l’étape 5 000 jusqu’à la fin. Autrement dit, le modèle savait déjà « quoi dire » dès le départ.
La différence se situe dans la propreté du son. À l’écoute, l’étape 5 000 présente un bruit granuleux, largement réduit à l’étape 10 000. Cela apparaît clairement sur un spectrogramme du même audio (temps à l’horizontale, fréquence à la verticale).
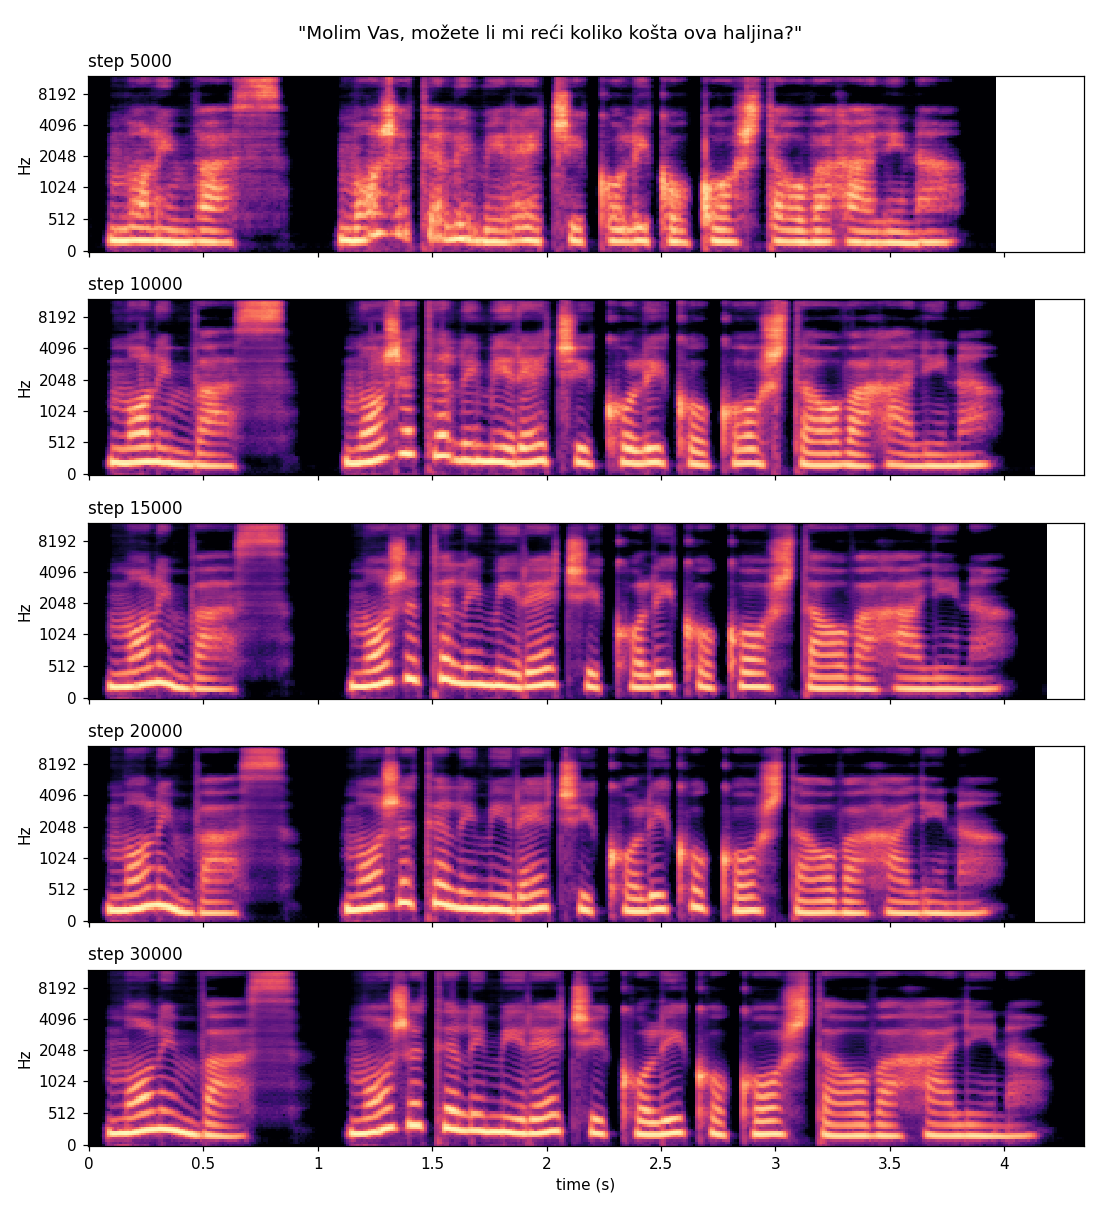
Les bandes horizontales alignées sur la hauteur de la voix (les harmoniques) sont floues à l’étape 5 000, et les espaces entre elles sont comme voilés. C’est cette partie qui s’entend comme du bruit. À partir de l’étape 10 000, les bandes deviennent nettes et les espaces s’assombrissent. Au fil de l’entraînement, elles semblent également former des courbes verticalement plus fluides : le mouvement de la hauteur de la voix, c’est-à-dire l’intonation, devient plus visible.
En chiffres
J’ai transcrit 14 phrases d’évaluation — toutes absentes des données d’entraînement — avec Whisper large-v3, puis mesuré le taux d’erreur de caractères (CER). Elles vont de courtes salutations à des monologues d’environ 16 secondes.
| Étapes | Temps d’entraînement | Taux d’erreur de caractères | Correspondance parfaite |
|---|---|---|---|
| 5 000 | Environ 50 min | 1,1 % | 9 / 14 |
| 10 000 | Environ 1 h 40 min | 3,4 % | 8 / 14 |
| 15 000 | Environ 2 h 20 min | 0,7 % | 11 / 14 |
| 20 000 | Environ 3 h 10 min | 0,9 % | 11 / 14 |
| 30 000 | Environ 5 h | 0,9 % | 10 / 14 |
- Si le score est moins bon à l’étape 10 000, c’est presque uniquement parce que Whisper a transcrit la phrase « Bok! » (Salut !) comme « Vok ». Une différence d’un caractère sur trois donne à elle seule un taux d’erreur de 33 % pour cette phrase. Pourtant, à l’oreille, l’étape 10 000 était bien plus propre que l’étape 5 000. Le taux d’erreur de caractères ne mesure que le fait de lire correctement ; pour la propreté du son, il faut écouter
- Les erreurs restées jusqu’à la fin concernaient đ et dž dans « Đak je pojeo džem » (L’élève a mangé de la confiture). Ces sons sont aussi rares en croate et ont été transcrits comme « Žak » et « Džak »
Vitesse sur CPU
J’ai mesuré les performances sur un i7-13700K, directement avec PyTorch (sans optimisation). Il s’agit de la moyenne de trois générations de quatre phrases, soit 47,6 secondes d’audio au total. Le RTF correspond au « temps de génération ÷ durée de l’audio » : plus il est faible, plus c’est rapide.
| Nombre de threads | Nombre d’étapes | Matcha | Vocos | RTF total |
|---|---|---|---|---|
| 1 | 2 | 0,042 | 0,025 | 0,067 |
| 1 | 4 | 0,067 | 0,025 | 0,092 |
| 4 | 4 | 0,032 | 0,010 | 0,042 |
| 8 | 4 | 0,028 | 0,007 | 0,036 |
Le « nombre d’étapes » est le nombre d’itérations qui transforment le bruit en son lors de la synthèse ; les extraits ci-dessus ont été générés avec 4 étapes. Même avec un seul thread, une seconde d’audio est produite en 0,09 seconde. Le CPU d’un smartphone sera moins rapide, mais cela devrait rester en temps réel (je ne l’ai pas encore mesuré sur un appareil réel : c’est donc une estimation).
Combien d’heures de données faut-il pour le TTS ?
Comme 7,5 heures ont suffi pour atteindre ce résultat, j’ai cherché quelques repères généraux.
- LJSpeech, souvent utilisé pour le TTS à une seule voix en anglais, contient environ 24 heures. Les modèles officiels de Matcha-TTS sont eux aussi entraînés dessus
- JSUT en japonais et CSMSC en chinois contiennent environ 10 heures et sont couramment utilisés comme corpus à une seule voix
- Pour un entraînement de zéro, environ 1 heure constitue la limite basse ; selon le modèle, les erreurs de prononciation peuvent augmenter
- Pour l’affinage d’un modèle préentraîné, un rapport indique que 30 minutes pouvaient donner un résultat comparable à 27 heures d’entraînement depuis zéro
J’ai aussi trouvé une étude qui entraîne Matcha-TTS uniquement avec de la parole synthétique (université Jiao Tong de Shanghai, décembre 2025). Elle indique que de nombreux types de textes, un audio propre sans bruit et une manière de parler cohérente améliorent l’entraînement. Les données synthétiques sont sans bruit et homogènes dans leur style de parole ; à durée égale, elles sont peut-être plus faciles à apprendre que de vrais enregistrements. Cela semble correspondre au résultat obtenu ici avec 7,5 heures.
Les difficultés rencontrées
- Le PC s’est figé : deux instances du modèle 31B destiné à créer les scripts se sont retrouvées par erreur simultanément sur le GPU, saturant la VRAM. Depuis, ma règle est de ne charger qu’un seul modèle à la fois sur le GPU
- Gemma 4 réfléchissait trop : environ deux tiers de sa sortie étaient de la « réflexion ». En la désactivant, la génération est devenue environ trois fois plus rapide
- Les hallucinations de HiggsAudio : lors du premier test, après le silence en fin de phrase, il a ajouté de lui-même « Hvala što pratite kanal » (Merci de suivre la chaîne), créant un clip de 81 secondes. Il semble avoir mémorisé les formules de fin de YouTube. J’ai commencé à écarter les clips dont la durée s’écartait trop de la prévision
- Matcha-TTS ne fonctionne pas sous Windows : certaines extensions C ne pouvaient pas être compilées, j’ai donc réécrit cette partie en Python (numba)