J’ai entraîné GPT-2 de zéro avec une seule RTX 4090. En une journée, il a dépassé l’original et appris à discuter
J’ai essayé d’entraîner GPT-2 (124M) de zéro avec une seule RTX 4090 chez moi. De la préparation des données au pré-entraînement, jusqu’au réglage par instruction (SFT) pour lui permettre de discuter, tout a été fait sur mon propre PC.
Pour résumer, voilà ce que ça donne.
- Le pré-entraînement s’est achevé en environ 21 heures. Il a obtenu 30,5 % au test de raisonnement de bon sens HellaSwag, dépassant les 29,4 % du GPT-2 124M original
- Le SFT a pris un peu moins de 2 heures. À peine 5 minutes après le début de l’entraînement, le modèle répondait déjà d’une façon qui ressemblait à une conversation
- Mais il est truffé d’hallucinations. Il affirme sans hésiter que « Paris compte 2,4 milliards d’habitants » ou que « 12+7=30 »
C’était fascinant de voir GPT-2 devenir progressivement plus intelligent, alors j’ai rassemblé le déroulé de l’expérience.
Environnement
- GPU : RTX 4090 (24 Go)
- CPU : i7-13700K / 64 Go de mémoire
- OS : Windows 11 (sans WSL, directement sous Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
Le code suit la même approche que nanoGPT / build-nanogpt de Karpathy. J’ai demandé à Claude Code de « créer un GPT-2 faisable en une journée avec le GPU de ce PC », puis nous avons travaillé ensemble, de la proposition d’architecture à la création des scripts et au suivi de l’entraînement.
Préparation des données : 10B tokens prêts en 12 minutes
Les données d’entraînement sont la version 10B tokens de FineWeb-Edu (des textes Web anglophones éducatifs de haute qualité). Elles représentent environ 27 Go au format parquet.
Au début, le téléchargement standard de Hugging Face ne dépassait pas 1,7 Mo/s, ce qui impliquait plus de quatre heures pour tout récupérer. Après avoir installé hf_transfer, la vitesse est passée à 60–70 Mo/s : un fichier de 2 Go arrivait en 30 secondes. Le goulot d’étranglement s’est alors déplacé vers la tokenisation, et l’ensemble téléchargement + tokenisation a pris environ 12 minutes.
Au passage, j’avais d’abord placé HF_HOME, qui change l’emplacement du cache, après l’import de huggingface_hub. Le réglage n’était donc pas appliqué, et les fichiers se téléchargeaient sur un autre disque. Cette variable d’environnement est lue lors de l’import : il faut donc la définir avant l’import. Un piège discret.
Paramètres d’entraînement
| Élément | Contenu |
|---|---|
| Modèle | GPT-2 small (12 couches, 768 dimensions, 124 millions de paramètres) |
| 1 étape | Environ 520 000 tokens (16×1024, avec accumulation de gradients 32 fois) |
| Nombre d’étapes | 16 000 (environ 8,4B tokens) |
| Vitesse | Environ 120 000 tokens/s |
| VRAM | Environ 12 Go |
On entend souvent dire que torch.compile ne fonctionne pas sous Windows et qu’il faut donc utiliser WSL, mais il a fonctionné directement dans cet environnement avec triton-windows.
Avec les 10B tokens complets, cela aurait dépassé 24 heures ; j’ai donc réduit à 8,4B tokens pour tenir en une journée.
Petite astuce : j’ai arrondi la taille du vocabulaire de 50 257 à 50 304 (un multiple de 128). C’est la célèbre technique de Karpathy qui accélère les calculs matriciels sur GPU, et elle s’est révélée utile de manière inattendue lors de la transformation en chatbot.
Incident : l’entraînement s’est arrêté après 2,5 heures
En regardant l’avancement, j’ai constaté que l’entraînement s’était arrêté. La cause était les données d’évaluation HellaSwag. Le code de type nanoGPT récupère les données depuis rowanz/hellaswag sur GitHub, mais le dépôt renvoyait « 451 Unavailable For Legal Reasons » (indisponible pour des raisons légales). L’entraînement entier s’était arrêté avec l’évaluation à cause d’une erreur 404.
J’ai modifié le code pour lire depuis Rowan/hellaswag sur Hugging Face (les mêmes 10 042 questions), puis repris depuis un point de contrôle sauvegardé toutes les 500 étapes. J’ai aussi entouré l’évaluation d’un try/except afin qu’un échec ne bloque plus l’entraînement.
Dans un entraînement de longue durée, il ne faut pas laisser l’entraînement échouer à cause d’un problème « hors cœur du modèle », comme l’évaluation ou les journaux. C’est important.
Résultats : au-delà du GPT-2 original
Voici l’évolution de la loss sur les données de validation. Elle chute fortement durant la première heure, puis continue à diminuer lentement.
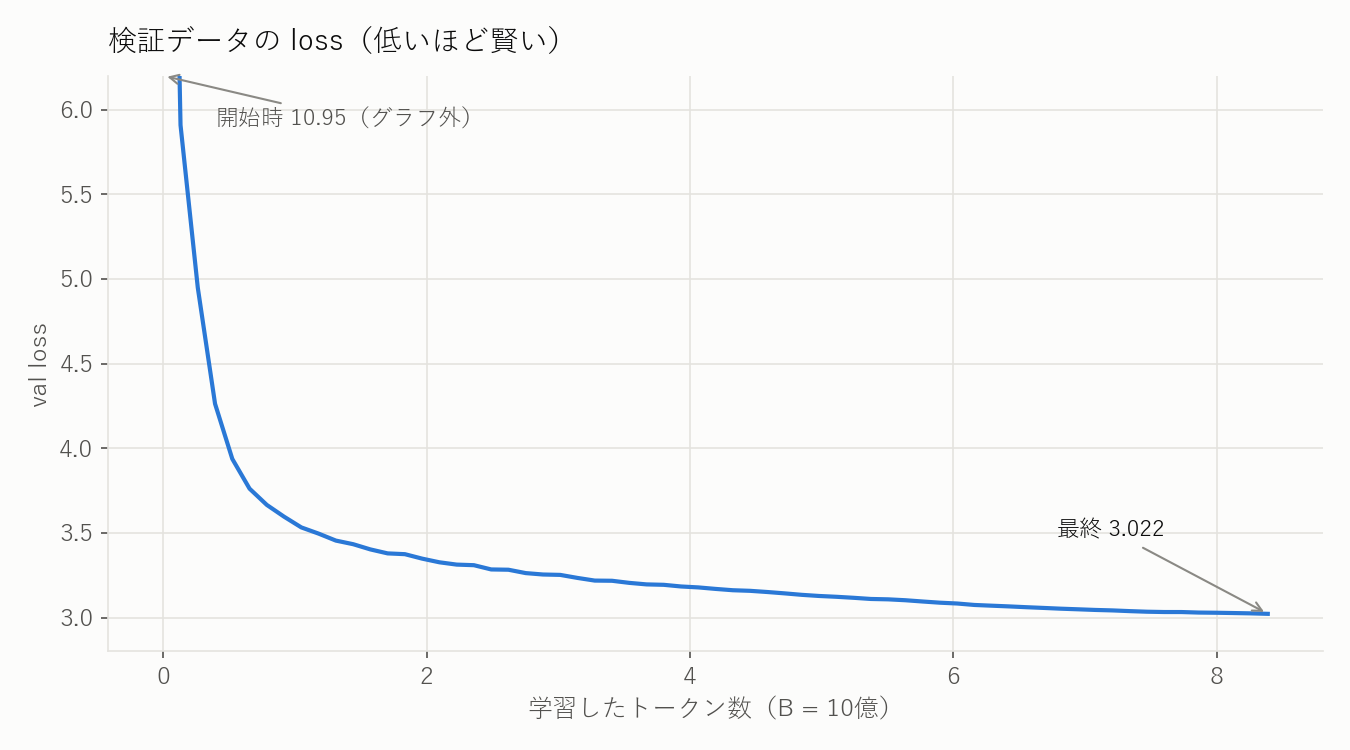
La loss initiale de 10,95 est presque identique à ln(50304)≒10,83. Cela signifie que le modèle part d’un état où il choisit totalement au hasard parmi 50 000 mots.
Voici l’évolution de la précision sur HellaSwag.
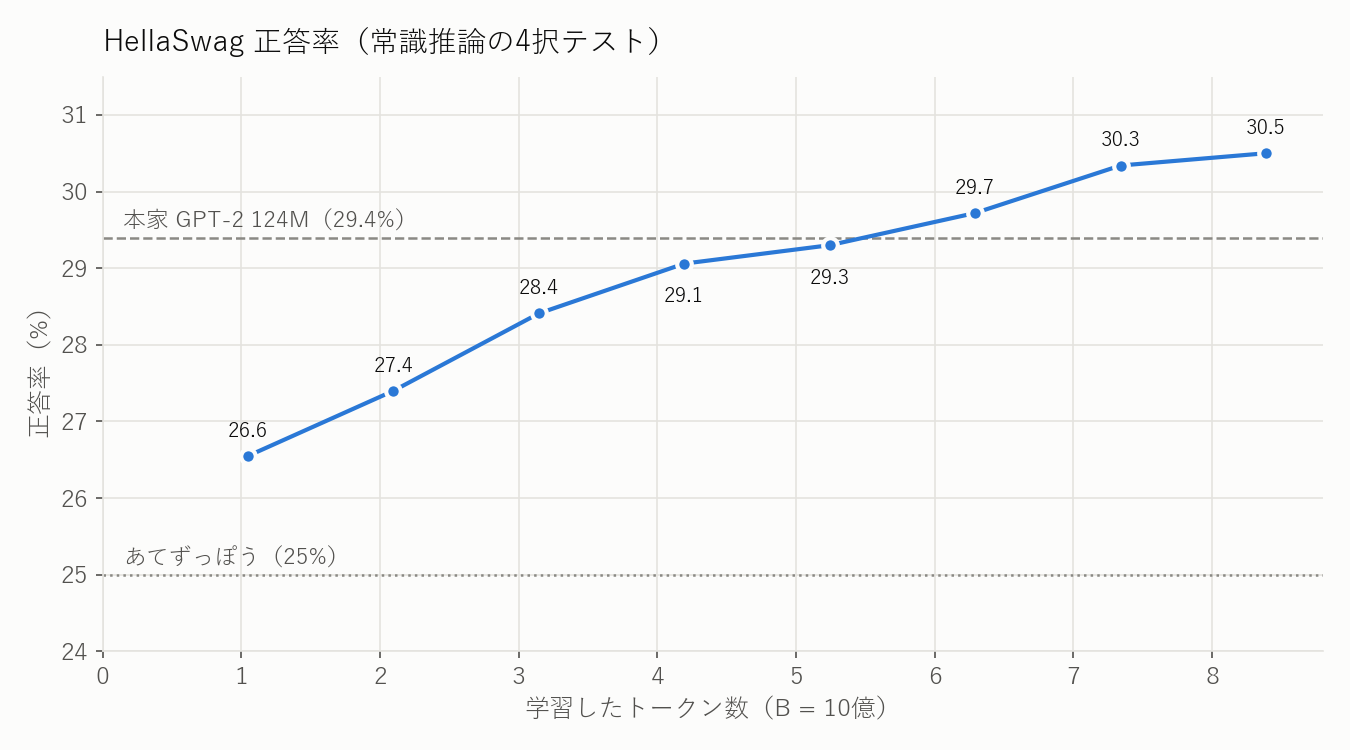
Vers 6,3B tokens (étape 12 000), il a dépassé les 29,4 % du GPT-2 124M original, pour atteindre finalement 30,5 %. Le GPT-2 original a été entraîné sur WebText. Le mien l’a été sur FineWeb-Edu, et je pense que la qualité supérieure de ces données éducatives a fait la différence.
Voir le modèle devenir progressivement plus intelligent
Pendant l’entraînement, je générais et enregistrais du texte toutes les heures à partir du même prompt. C’était la partie la plus intéressante.
Avant l’entraînement (état aléatoire)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
Les mots sont simplement alignés de manière totalement aléatoire.
37 minutes plus tard (0,26B tokens)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
La forme d’une phrase est là. Le modèle comprend qu’il est question d’une capitale, mais il affirme que la capitale de la France est celle de l’Écosse.
Environ 2 heures plus tard (0,79B tokens)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
La grammaire est devenue assez naturelle. En contrepartie, le modèle a commencé à empiler des termes techniques pour raconter des mensonges plausibles. On dirait le prototype de l’hallucination.
Environ 2,1B tokens
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
Il a enfin réussi à dire Paris ! … Mais juste après, il ajoute la fausse statistique selon laquelle « la France produit 50 % de l’acier mondial ».
J’ai posé des questions au modèle de base terminé
J’ai posé dix questions au format Question: ... Answer:.
- What is the capital of France? → Il énumère des choix de (a) à (i) et commence à créer un questionnaire
- Who was Albert Einstein? → « Né le 16 novembre 1918 à Saint-Louis, Missouri. Son père était mineur et lui-même était instituteur. » Tout est faux, mais il sait écrire dans un style biographique
- What is 12 plus 7? → « 12 plus 7 is an arithmetic expression. » Au lieu de calculer, il se met à donner une définition
Il possède des connaissances correctes dans une certaine mesure, mais ne connaît pas le comportement qui consiste à “répondre à une question”. Un modèle de base est avant tout une machine qui « écrit la suite du texte » : c’est donc normal.
Le rendre capable de discuter avec le SFT
À partir de là, j’ai effectué un réglage par instruction (SFT) afin qu’il puisse répondre aux questions comme ChatGPT.
- Données :
smol-smoltalkde Hugging Face (environ 460 000 conversations, 270 millions de tokens) - Format de chat : ajout de séparateurs comme
<|user|>,<|assistant|>et<|end|>. J’ai réutilisé ici les identifiants libres créés en arrondissant précédemment le vocabulaire à 50 304. Cela a permis d’ajouter des tokens spéciaux sans modifier l’architecture du modèle : l’astuce d’optimisation de vitesse a donc trouvé une utilité inattendue - Seules les réponses sont apprises : le modèle lit les questions, mais il n’imite que les réponses de l’assistant et le
<|end|>final - 2 époques, environ 1 heure 50 minutes
Le point essentiel est d’entraîner également le modèle jusqu’à <|end|>. Ainsi, le modèle s’arrête de lui-même lorsqu’il a fini de parler. ChatGPT et les autres fonctionnent selon le même principe : la génération s’arrête lorsqu’ils produisent un symbole de fin.
Un style conversationnel en seulement 5 minutes
Avant de démarrer le SFT (étape 0), le modèle était perturbé par les séparateurs inconnus et bouclait à l’infini sur « jakjakjakjak… ». Pourtant, après seulement 500 étapes (environ 5 minutes), il avait déjà un ton conversationnel.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
Il termine même correctement sa phrase et s’arrête. Apprendre la façon de s’exprimer a été instantané.
En revanche, ses connaissances restaient inchangées. À un moment, le modèle affirmait que « Paris est la plus grande ville du monde, avec une population d’environ 2,4 milliards d’habitants ».
Comparaison avant et après le SFT
J’ai comparé le modèle avant (modèle de base) et après le SFT avec les mêmes questions.
| Question | Avant le SFT | Après le SFT |
|---|---|---|
| What is the capital of France? | Il commence à énumérer des choix (a) à (i) | « The capital of France, Paris, is a city located in the northern part of the country, along the Seine River. » |
| Who are you? | « I am the person who has the gift for all that I do. » | « I'm a language learning AI assistant with over 10 years of experience » (une IA avec 10 ans d’expérience) |
| Translate "Good morning" into French. | Il commence à parler d’autre chose | « Bonjour! » (correct, mais il répète ensuite indéfiniment « Good morning (modifier) ») |
| What is 12 plus 7? | « It is an arithmetic expression » | « 12 + 7 = 21 » → « 12 + 7 = 30 » → « 35 + 7 = 34 » : il se trompe de plus en plus avec une méthode qui semble plausible |
| Who was Albert Einstein? | Un instituteur dont le père était mineur | « prominent physicist » : l’idée générale est juste. En revanche, « né le 24 février 1905 à Vienne » est faux |
Le ton et le format sont ceux d’un véritable assistant. Le contenu, lui, contient beaucoup de mensonges. Les calculs étaient catastrophiques.
Discussion réelle avec le modèle
J’ai créé un chat.py permettant de converser dans le terminal, puis je lui ai parlé.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Il suit l’instruction « en une phrase ». C’est quelque chose que le modèle de base ne savait pas faire.
Dans une autre conversation, après avoir demandé la capitale, j’ai ensuite demandé la population.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Il comprend bien la conversation précédente, donc que « there = Japon ». Mais juste après avoir annoncé une population de 50 000 habitants, il prétend que 1,5 milliard de personnes vivent dans le nord du pays : c’est complètement incohérent.
Quand je lui ai demandé en japonais « Quelle est la capitale du Japon ? », il a répondu :
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Comme il n’a été entraîné que sur des données en anglais, le japonais lui a sans doute semblé être un mystérieux texte à corriger.
Enfin, je lui ai demandé « Écris un haïku sur les GPU ». Il en a fait un poème qui répétait indéfiniment « I see the world, the thoughts, the emotions ». Le haïku, donc.
Ce que cette expérience m’a appris
- Avec une seule 4090 et une journée, on peut créer un modèle qui dépasse le GPT-2 original. Le GPU consomme environ 430 W. L’électricité pour le GPU seul coûte approximativement 300 yens (estimation)
- Le style de parole s’acquiert instantanément, mais les connaissances sont déterminées au pré-entraînement. Le SFT a produit un format conversationnel en 5 minutes, mais n’a presque rien changé à l’exactitude des faits
- Un modèle de 124M a une grammaire presque parfaite, mais raconte énormément de mensonges. On comprend très concrètement que fluidité et exactitude sont deux choses différentes
- Les entraînements longs échouent côté infrastructure. Cette fois-ci, l’arrêt ne venait pas du modèle, mais de la disparition de l’emplacement des données d’évaluation
Créer le modèle soi-même depuis zéro permet de ressentir concrètement que les IA comme ChatGPT sont des machines qui prédisent « la suite du texte », auxquelles on a enseigné « les règles de la conversation ». La prochaine fois, j’aimerais essayer de construire un modèle un peu plus pratique.