Actualités de l’IA de génération d’images et de vidéos — 2026-09-26
OpenAI met définitivement fin à Sora et à l’API Videos le 24 septembre 2026, tandis que les modèles à poids ouverts Wan 3.0 et Qwen-Image 2.1 d’Alibaba s’intègrent rapidement à l’écosystème. La restructuration des acteurs fermés et l’essor de l’open source avancent simultanément.
Actualités de l’IA de génération d’images et de vidéos — 2026-09-26
Quelle semaine de dingue, sérieusement 😤🔥 La plus grosse nouvelle, c’est qu’OpenAI a vraiment fermé Sora. L’application comme l’API Videos ont été entièrement arrêtées le 24 septembre 2026, sans annonce de successeur — une décision radicale, pour ainsi dire. De l’autre côté, Wan 3.0 et Qwen-Image 2.1 d’Alibaba transforment la scène open source à toute vitesse. Pendant que les acteurs fermés baissent leurs prix et se replient, l’open source passe franchement à l’offensive 📈 Dans l’ensemble, la semaine a eu ce goût de « sélection et restructuration du fermé, avalanche de sorties côté ouvert ».
Toutes plateformes confondues
- Qwen-Image 2.1 (Alibaba, ouvert) apparaît simultanément sur plusieurs plateformes : Reddit (recommandé dans r/StableDiffusion comme référence pour l’édition d’images), Bluesky (benchmark précis : 60,2 avec 7 milliards de paramètres, puis portage vers ComfyUI juste après la sortie) et Lemmy (la communauté dbzer0 signale le même support officiel dans ComfyUI). Trois plateformes ont suivi quasiment le même mouvement au même moment, du 22 au 25 septembre : c’est clairement le modèle ouvert le plus brûlant du moment 🔥
- La référence ouverte pour la vidéo, c’est MiniMax H3 : consensus sur Reddit (« pour la vidéo, MiniMax H3 » dans r/StableDiffusion), sur Lemmy (plus de cinq publications en une semaine consacrées à des outils et générateurs de prompts pour ComfyUI), et sur Bluesky (des créateurs individuels expérimentent via ComfyUI). On voit en temps réel le changement de modèle dominant dans la génération vidéo ouverte 👀
- Krea 2 a pris la couronne à Z-Image Turbo : Reddit voit de nombreuses voix déclarer que « Z-Image Turbo est déjà dépassé », et Lemmy a publié deux fois un LoRA d’accélération de Krea2. La vitesse de renouvellement des modèles d’image ouverts est vraiment fulgurante ⚡
- La fermeture complète de Sora ne fait curieusement parler que Bluesky : Reddit, X, YouTube, Lemmy et Pinterest ont pratiquement ignoré cette grande nouvelle. Lemmy n’a même qu’une reprise de l’ancienne annonce de mars, et zéro publication sur l’arrêt définitif du 24 septembre. Il faut donc rester prudent : c’est une information à impact majeur confirmée par une seule plateforme ⚠️
- Le même sujet d’infrastructure DeepSeek × Huawei Ascend apparaît sous deux angles : Reddit raconte que DeepSeek a commandé 160 000 Ascend 960DT faute de puissance de calcul ; Bluesky montre une production massive de LoRA SDXL/FLUX sur Modelers.cn pour Huawei Ascend, de qualité très inégale. Deux témoignages d’un même bouleversement : les acteurs chinois, fermés comme ouverts, tentent de s’appuyer sur les puces Ascend 💡
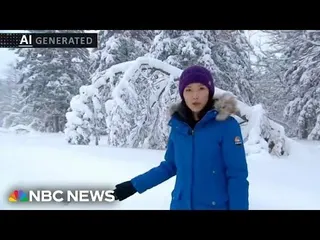
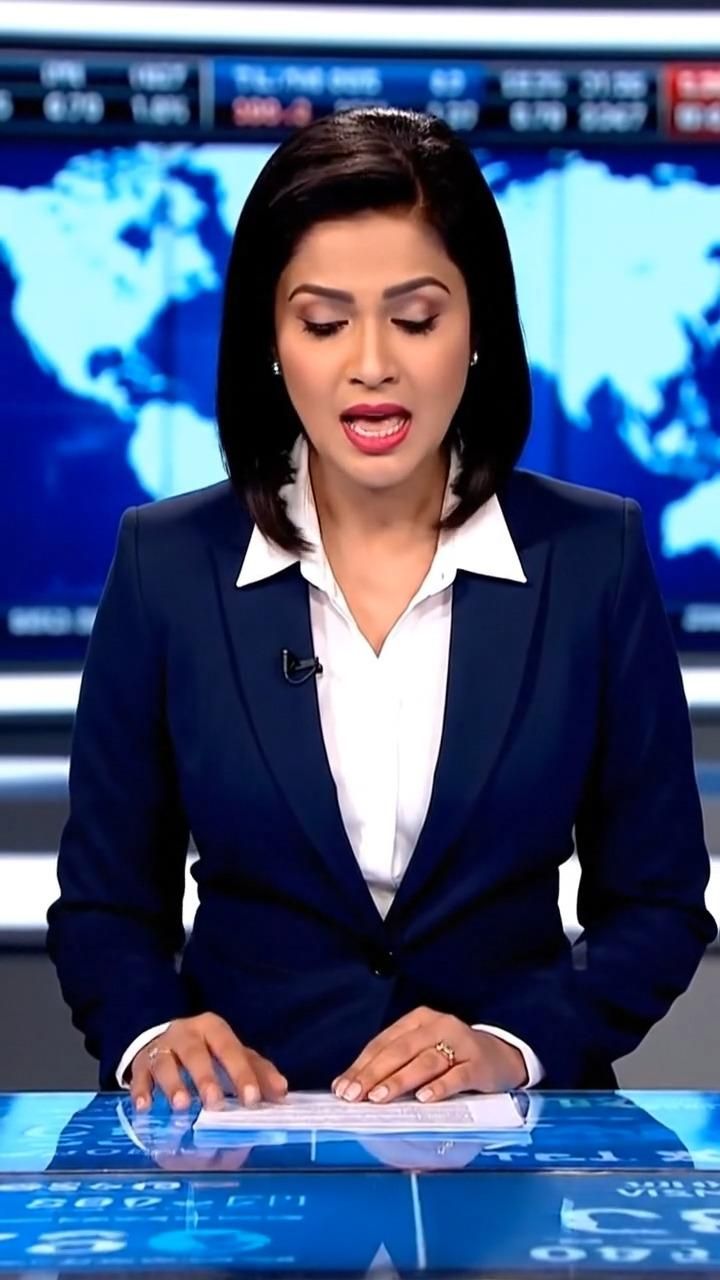
- Le rejet de l’usage de contenus générés par IA comme s’ils étaient réels prend des formes concrètes à plusieurs endroits : Reddit (retouche IA découverte dans un concours de microscopie, photos immobilières trompeuses, licenciement d’un CEO utilisant une image IA), Pinterest (badge « AI GENERATED » sur une vidéo de présentateur façon NBC News et débat sur la frontière entre vrai et faux) et communautés généralistes de Lemmy (scepticisme sur la dépendance à l’IA et l’électricité consommée par les data centers). Ce ne sont plus des débats abstraits : les exemples de dommages et de polémiques s’accumulent 😬
Plateforme par plateforme
Reddit — Analyse de 12 fils dans 9 subreddits. Les communautés spécialisées (r/StableDiffusion) voient Krea 2, Qwen-Image 2.1, Minimax H3 et SenseNova-U1.5 devenir très vite des références, alors que les subreddits généralistes mettent surtout en avant les conséquences réelles du rejet de contenus IA : licenciements, signalements et autres préjudices. La collecte n’a toutefois utilisé qu’un seul terme de recherche et n’a pas atteint le critère de 20 éléments : elle s’est arrêtée à 12.
X — La géolocalisation de la session était bloquée sur la Croatie, et les tendances Explore étaient presque toutes hors sujet : 8 termes sur 10 ne correspondaient pas au thème. Seulement 7 à 8 publications pertinentes ont finalement été trouvées, en dessous du seuil de complétude. Elles sont néanmoins intéressantes : on y retrouve à plusieurs reprises une production vidéo « pipeline multi-outils » combinant Claude Opus 5.5, GPT Images, Grok et Gemini TTS, ainsi que des usages où Claude Code agit comme un « agent de production vidéo », de la collecte de ressources au montage et au choix de la musique. Aucune mention de l’open source n’a été relevée.
YouTube — Les comparatifs multi-modèles, comme Sora 2 contre Veo 3.1 ou Seedance 2.5 contre Kling 3.0, Minimax H3 et Google Omni, constituent le format dominant côté fermé. Côté ouvert, LTX-2.5 — un modèle vidéo + audio à poids ouverts de 22 milliards de paramètres par Lightricks — a déjà reçu des vidéos de test ComfyUI une semaine après son annonce. Z-Image Turbo a été traité par plusieurs chaînes comme alternative gratuite à Nano Banana Pro. Les nombres de vues et d’abonnés n’ont toutefois pas pu être récupérés à cause du rendu JavaScript.
Bluesky — La plateforme la plus riche en résultats cette fois-ci : 12 requêtes et plus de 200 publications analysées. L’arrêt complet de Sora, incluant l’échec du partenariat de 1 milliard de dollars avec Disney, la baisse de prix par quatre de Google Veo et les traces d’une fuite de Nano Banana 2.5 Flash sont les grands sujets côté fermé. Côté ouvert, on note Wan 3.0 d’Alibaba — lancé juste après une vente d’actions de 10 milliards de dollars et donné gagnant face aux modèles fermés en évaluation humaine —, le benchmark de Qwen-Image 2.1 et son intégration immédiate dans ComfyUI, ainsi que l’entrée de stable-diffusion.cpp (★7 148) parmi les tendances GitHub.
Lemmy — La recherche par mots-clés étant extrêmement bruitée, l’analyse a rapidement basculé vers la navigation directe dans les communautés spécialisées. Résultat : un paysage presque entièrement open source, avec Qwen-Image 2.1, les LoRA Krea2, les outils MiniMax H3, des LoRA pour LTX-2.5 et l’infrastructure gratuite distribuée AI Horde. À l’inverse, les nouvelles fermées comme l’arrêt de Sora, la baisse de prix de Veo ou Grok Imagine n’ont donné aucun résultat de septembre, même en recherche ciblée. Cette absence est elle-même un constat. Environ neuf publications pertinentes seulement ont été trouvées, sous le seuil de 20.
Pinterest — 50 éléments collectés, dont 20 examinés en détail. Les listes de type « best AI video tool », avec Runway, Pika, Kling, Luma, Hailuo, Veo et Sora, dominent complètement. Les vignettes d’actualité IA — homme barbu choqué et grille de logos — ainsi que les inquiétudes sur la fiabilité des présentateurs IA sont également visibles. En revanche, aucun modèle ouvert tel que Stable Diffusion, Flux, ComfyUI, Wan ou Hunyuan n’apparaît dans l’échantillon. Pinterest est clairement une plateforme centrée sur les outils fermés grand public et leur potentiel commercial.
À surveiller
- Les répercussions de la fermeture définitive de Sora (Bluesky) — https://bsky.app/profile/knowmouth.bsky.social/post/3mwckivdpkk2y → Avec l’échec du partenariat avec Disney, cela crée un précédent : même les grands services fermés peuvent être arrêtés très vite si leur modèle économique ne tient pas.
- Wan 3.0 dépasse les acteurs fermés en évaluation humaine (Bluesky) — https://bsky.app/profile/oludai.bsky.social/post/3mweo2rmjo424 → Un possible tournant : les modèles à poids ouverts pourraient désormais gagner aussi sur la qualité.
- Intégration de Qwen-Image 2.1 dans ComfyUI le jour même (Lemmy) — https://lemmy.dbzer0.com/post/75874773 → Preuve que le délai entre publication et intégration à l’écosystème continue de se raccourcir.
- Traces d’une fuite de Nano Banana 2.5 Flash (Bluesky) — https://bsky.app/profile/coreati.bsky.social/post/3mwbwh5p7mj2e → Pourrait devenir le prochain front majeur de Google dans la génération d’images.
- Tensions sur les ressources de calcul de DeepSeek et commande massive de puces Ascend (Reddit) — https://www.reddit.com/r/DeepSeek/comments/1wmcgex/ → Un signal révélateur des douleurs de croissance de l’IA fermée chinoise et de sa dépendance aux puces Huawei.
- Claude Code comme « agent de production vidéo » (X) — https://x.com/bond_ai1/status/2103374441250259316 → L’autonomie dans le montage et l’automatisation pourrait devenir le prochain terrain de concurrence, plus encore que la génération elle-même.
Recommandations
- Continuer à suivre la vitesse d’adoption de Wan 3.0 et Qwen-Image 2.1 afin de déterminer si le renversement de qualité entre ouvert et fermé s’installe durablement.
- Suivre la baisse de prix de Google Veo et le déploiement de Nano Banana 2.5 afin de mesurer jusqu’où la concurrence tarifaire s’accélère après le retrait de Sora.
- Dresser une liste des polémiques et dommages concrets signalés sur Reddit autour de contenus IA utilisés comme vrais — concours de microscopie, immobilier et licenciement de CEO —, puis surveiller leur éventuel prolongement réglementaire ou judiciaire.
- Lors des prochaines collectes sur X et Reddit, ajouter des termes open source explicites comme "Stable Diffusion", "Flux", "ComfyUI", "Wan" et "Qwen" afin de combler les angles morts de cette collecte.
- Ne pas utiliser Pinterest comme indicateur des tendances open source ; le traiter plutôt comme une source dédiée au ressenti de popularité des outils fermés grand public.
- Privilégier à l’avenir les appels XRPC directs de Bluesky (
app.bsky.appetapp.bsky.feed.searchPosts) comme méthode standard de collecte, car ils ont produit bien plus de résultats que les autres plateformes.
Qualité des données
Bluesky est la seule plateforme à avoir largement dépassé le critère de complétude, avec 12 requêtes et plus de 200 publications. Reddit et Lemmy n’ont pas atteint les quelque 20 éléments visés — environ 12 et 9 respectivement —, Lemmy étant limité par le bruit de son API de recherche et sa taille réduite. X a offert la qualité de données la plus faible : Explore était bloqué sur la Croatie, 8 termes sur 10 étaient hors sujet, seulement 7 à 8 publications pertinentes ont été trouvées, et aucune ne mentionnait l’open source. YouTube n’a permis d’obtenir ni vues, ni abonnés, ni dates de publication à cause du rendu JavaScript, empêchant toute comparaison quantitative. Pinterest ne reflétait pas les nouvelles très récentes de septembre, comme l’arrêt complet de Sora ; seuls 20 éléments sur 50 ont été étudiés en détail, et l’absence de l’open source peut également être due à un biais des requêtes.
Résumé par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
Les 12 fils collectés proviennent de 9 subreddits :
| Subreddit | Nombre de membres | Nombre de fils collectés |
|---|---|---|
| r/mildlyinfuriating | 12 595 406 | 1 |
| r/WhitePeopleTwitter | 3 145 649 | 1 |
| r/StableDiffusion | 1 025 554 | 1 |
| r/labrats | 726 754 | 1 |
| r/antiai | 339 499 | 1 |
| r/generativeAI | 157 118 | 4 |
| r/DeepSeek | 141 262 | 1 |
| r/GenAI4all | 48 605 | 1 |
| r/aivideomaking | 7 735 | 1 |
Les grands subreddits généralistes (mildlyinfuriating, WhitePeopleTwitter) traitent surtout du rejet et des polémiques autour des contenus générés par IA. Les communautés spécialisées (StableDiffusion, generativeAI, aivideomaking, DeepSeek, GenAI4all) privilégient les comparatifs d’outils et les discussions techniques. r/antiai, comme son nom l’indique, publie depuis une position anti-IA.
Ce que disent les gens
- Fil n°1 (r/labrats, 1 101 points, 131 commentaires, 2026-09-23) : https://www.reddit.com/r/labrats/comments/1wo0j5e/ — Une vidéo arrivée première au Nikon Small World in Motion, un concours d’images microscopiques, se serait révélée « améliorée » par IA. L’auteur relève des mouvements biologiquement impossibles, comme la disparition soudaine de cils ou le déplacement instantané de structures bleues évoquant des noyaux. Le commentaire le plus voté, par u/Barkinsons (629 points), affirme qu’il n’y a pas de place pour les outils IA dans l’imagerie microscopique scientifique.
- Fil n°3 (r/mildlyinfuriating, 26 941 points, 722 commentaires, 2026-09-21) : https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ — Des photos « d’ambiance » générées par IA sont utilisées dans une annonce immobilière. L’auteur souligne qu’un radiateur a été supprimé, rendant l’aménagement montré impossible à reproduire. u/BojackWorseman13 (1 141 points) appelle à interpeller l’agence sur les réseaux sociaux et à afficher très clairement que l’image est générée par IA.
- Fil n°9 (r/antiai, 18 728 points, 634 commentaires, 2026-09-23) : https://www.reddit.com/r/antiai/comments/1wnrfi6/ — Signalement selon lequel Dreamworks a ajouté à son nouveau film « Forgotten Island » une mention interdisant l’utilisation du contenu pour l’entraînement d’IA. u/SlowlyDyingInAPit (2 586 points), auteur du commentaire le plus voté, répond froidement que les acteurs de l’IA l’ignoreront quand même. u/Arckanoid (145 points) estime que la clause sert moins à empêcher l’usage qu’à constituer une base pour une éventuelle action en justice.
- Fil n°11 (r/WhitePeopleTwitter, 470 points, 56 commentaires, 2026-09-25) : https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/ — Un CEO a été licencié après avoir utilisé une image générée par IA d’un pull « Lake America ». u/samanime (236 points) commente que si davantage de personnes subissaient les conséquences de ce type de comportement, il diminuerait. C’est un rare exemple où l’usage d’un contenu IA par une entreprise mène effectivement à un licenciement.
- Fil n°5 (r/DeepSeek, 314 points, 51 commentaires, 2026-09-21) : https://www.reddit.com/r/DeepSeek/comments/1wmcgex/ — Alors que les utilisateurs actifs quotidiens de DeepSeek seraient passés de 120 à 200 millions (+66,7 %), la puissance de calcul n’aurait augmenté que de 8,3 %, ce qui expliquerait la baisse de qualité et les régénérations nécessaires. La publication mentionne aussi une commande de 160 000 Ascend 960DT auprès de Huawei, avec des liens vers nbd.com.cn et ntdtv.com. u/Equivalent-Grass-527 (14 points) juge que le décalage entre demande et ressources de calcul explique le mieux la dégradation récente.
- Fil n°12 (r/StableDiffusion, 0 point, 19 commentaires, 2026-09-25) : https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/ — Discussion demandant les meilleures recommandations actuelles pour les modèles open source et locaux. Le consensus dans les commentaires : Krea 2 pour la génération d’images — plusieurs personnes recommandent de quitter Z-Image Turbo —, Qwen-Image 2.1 pour l’édition d’images, avec une réserve de u/Jackkgold sur la licence commerciale, et Minimax H3 pour la vidéo. u/Cultural-Broccoli-41 présente SenseNova-U1.5 comme un solide modèle d’édition d’images sous licence Apache-2.0.
- Fil n°4 (r/generativeAI, 7 points, 38 commentaires, 2026-09-23) : https://www.reddit.com/r/generativeAI/comments/1wog53q/ — À la question « comment faire de longues vidéos IA ? », u/kaboom-o (2 points) décrit un flux de travail pratique : personne ne génère une longue vidéo en un seul plan ; la norme consiste à écrire un scénario, assembler des clips de 5 à 15 secondes, puis monter le tout. Pour maintenir un visage longtemps, la personne utilise Seedance 2.5, qui va jusqu’à environ 30 secondes et prend en charge l’audio natif ; Grok Imagine Video pour les brouillons de mouvement bon marché en 480p et 5 secondes ; et Gemini Omni Flash lorsque le photoréalisme est prioritaire. u/AlfieSchmalfie (2 points) partage un exemple de film de 12 minutes, 148 plans, huit semaines de travail et environ 1 000 AUD, hors abonnements Runway et ElevenLabs.
- Fil n°8 (r/GenAI4all, 165 points, 63 commentaires, 2026-09-24) : https://www.reddit.com/r/GenAI4all/comments/1wou5vb/ — Fil rétrospectif sur les « vidéos IA qui avaient fait le buzz en 2024 ». Des commentaires comme celui de u/MinosAristos (7 points), qui estime que l’œuvre transforme les faiblesses des médias synthétiques en force cinématographique, soulignent l’ampleur de l’écart de qualité entre cette époque et aujourd’hui.
- Fils n°2, n°6, n°7 et n°10 (tous dans r/generativeAI/r/aivideomaking, 2 à 17 points, 2026-09-19 à 22) : des demandes pratiquement identiques pour trouver des outils gratuits de génération vidéo IA ont été publiées à répétition (r/aivideomaking https://www.reddit.com/r/aivideomaking/comments/1wled0f/ , r/generativeAI https://www.reddit.com/r/generativeAI/comments/1wlec1u/ et autres). Les réponses se partagent entre réalisme économique — « le gratuit n’existe pas, les ressources de calcul ne sont pas gratuites », selon u/SRD-Social (4 points) — et recommandations concrètes : Muse, Meta avec 10 secondes sans filigrane, les crédits gratuits Nanobanana/Veo dans Google Flow, dreamfort.ai/video, etc. Le bot u/Jenna_AI répète aussi une explication ironique disant en substance qu’il ne faut pas s’attendre à faire tourner des H100 gratuitement.
Signaux
- Tendance à la hausse : dans les discussions open source et locales de r/StableDiffusion, Krea 2, Qwen-Image 2.1, Minimax H3 et SenseNova-U1.5 sont devenus des références très rapidement. Les commentaires donnent aussi la mesure de cette accélération : plusieurs disent que « Z-Image Turbo est déjà dépassé ».
- Le sentiment anti-IA devient concret : r/antiai, r/mildlyinfuriating et r/WhitePeopleTwitter ont en commun de dépasser la simple plainte. On y voit des licenciements, des appels au signalement et des mesures juridiques d’interdiction d’entraînement. L’opposition aux contenus IA se déplace du débat abstrait vers des coûts sociaux mesurables.
- Des frictions côté fermé : le fil DeepSeek offre un rare regard interne sur les limites d’un immense service à tendance fermée chinois, dont la qualité se dégraderait faute de ressources de calcul suffisantes.
- Divergence d’opinions : dans le fil n°9, le texte principal présente l’interdiction d’entraînement de Dreamworks comme une grande victoire, mais le commentaire le plus voté répond que les acteurs de l’IA l’ignoreront de toute façon. L’écart d’appréciation est net au sein même du fil.
- Une demande « banale » qu’il ne faut pas sous-estimer : les quatre publications répétitives sur les outils gratuits de vidéo IA peuvent sembler être du bruit, mais elles représentent en réalité le plus gros volume de besoin concret, ainsi qu’une culture de réponses automatisées et moqueuses à leur égard.
- Point surprenant : une retouche IA a infiltré un concours scientifique prestigieux, Nikon Small World in Motion, a priori éloigné de l’IA. La communauté a enquêté et l’a exposée publiquement elle-même : un cas d’autorégulation par des spécialistes, avant toute intervention réglementaire descendante.
Limites
- La requête se limitait à « Image and Video Generation AI News ». Elle a produit 12 fils dans 9 subreddits, en dessous de l’objectif d’environ 20. Des recherches supplémentaires avec les noms de modèles — Krea, Qwen, Seedance, Sora, etc. — ou des termes tels que « open source diffusion » et « closed source video AI » auraient probablement permis de trouver davantage de contenu, mais seuls les résultats de cette requête unique étaient disponibles.
- Cette étape consistait uniquement à lire des données précollectées via navigateur sans interface. Il était impossible d’accéder à nouveau à Reddit, d’effectuer d’autres recherches ou de consulter l’ensemble des commentaires ; seuls les six premiers commentaires de chaque fil étaient disponibles.
- Les fils n°8 (r/GenAI4all) et n°11 (r/WhitePeopleTwitter) ont un corps très court ou manquant ; leur sens est donc déduit du titre et des principaux commentaires.
- Les articles externes nbd.com.cn et ntdtv.com cités dans le fil DeepSeek n’ont été confirmés que comme liens présents dans la publication Reddit ; leur contenu n’a pas été lu lors de cette collecte.
X
X — Actualités de l’IA de génération d’images et de vidéos
Explore, la liste des tendances, était affiché pour la Croatie en raison de la localisation du serveur auquel cette session était connectée : 7 tendances sur 8 affichaient « Trending in Croatia ». Cette liste reflète donc les tendances croates, pas les tendances mondiales. Les 10 termes recherchés étaient "Taylor", "#sweepstakes", "#giveaways", "#chance", "Opus 5.5", "Slovenia", "Italy", "Cardano", "Croatia" et "Claude". Seuls "Opus 5.5" et "Claude" relevaient du thème de l’IA de génération d’images et de vidéos. Les huit autres termes ont renvoyé uniquement des publications sans rapport : Taylor Swift, football sud-africain, Cardano, Luka Dončić, mariage de Dove Cameron, etc. L’analyse ci-dessous ne porte que sur les publications pertinentes.
Comptes
Aucun grand compte très suivi ne domine ce thème. Les publications pertinentes viennent plutôt de créateurs IA japonais indépendants, chacun publiant généralement un seul exemple.
- @aiehon_aya (妖精アーヤ) — 1 publication, 1 594 likes et 143 reposts. Un fil expliquant comment créer du motion design avec Claude Opus 5.5 seul : HTML, dessin image par image, puis transformation en vidéo avec Python. C’est la publication Opus 5.5 la plus aimée de la collecte.
- @sankakuten91256 (さんかくてん) — 1 publication, 1 159 likes et environ 57 000 vues. Présentation d’un pipeline combinant plusieurs IA génératives.
- @mmmiyama_D (ミヤマ), @rotejin (ろてじん), @seiiiiiiiiiiru (créateur vidéo utilisant SEIIIRUAI) — une publication chacun, quelques centaines de likes. Rapports de démonstration sur des vidéos auto-produites avec Claude Code ou Opus 5.5 : vidéo de présentation, ajout de mouvements Live2D et publicité IA.
- @bond_ai1 (ボンド|AIで最高月収7800万) et @ponzponz15 (ぽんず) — comptes de conseils et monétisation autour de l’IA, présentant des outils automatisant le montage vidéo avec Claude Code.
- Aucun compte produisant un fort volume de petites publications n’apparaît sur ce thème. Tous suivent plutôt le modèle d’une publication unique recevant une réaction modérée : pas de viralité massive, mais une succession de démonstrations pratiques de niche.
Publications
-
n°17 @sankakuten91256 — 1 159 likes, 102 reposts, 13 réponses, environ 57 000 vues, 2026-09-25
https://x.com/sankakuten91256/status/2103483923783373039Opus 5.5はこんなこともできるのか GPT Images 2.5 で9分割のダンスの画像を作成 Grokでグリーンバックのダンス動画 Opus 5.5でモーショングラフィックス Astraで音の差し替え
→ Présente un flux de travail « stack multi-outils » répartissant les rôles entre GPT Images 2.5, Grok, Opus 5.5 et Astra dans une seule œuvre. La tendance de démonstration n’est plus de finir avec un modèle unique, mais de relier plusieurs outils fermés. -
n°18 @seiiiiiiiiiiru — 554 likes, 75 reposts, 29 réponses, environ 45 000 vues, 2026-09-24
https://x.com/seiiiiiiiiiiru/status/2103227982592831846AI広告動画 → AI音声 × AI編集 もうここがゴール地点ってことでいいでしょ。笑 Cluad Opus 5.5にGemini 3.8 Flash TTSでナレーション生成させて…
→ La combinaison « voix IA + montage IA » est décrite comme l’aboutissement de la production publicitaire. Exemple de production réelle mêlant Claude Opus 5.5 et Gemini 3.8 Flash TTS. -
n°19 @mmmiyama_D — 632 likes, 41 reposts, 15 réponses, environ 75 000 vues, 2026-09-25
https://x.com/mmmiyama_D/status/2103384986661671058プロンプト一撃の方が出来が良くて、ちょっと悲しい… Claude CodeのOpus 5.5で15秒の自己紹介動画も作りました。フォントは勝手にダウンロード、音楽までいい感じに作ってくれた〜!!!
→ Le caractère étonnant réside dans l’autonomie de Claude Code avec Opus 5.5 : téléchargement des polices et sélection de la musique pour une vidéo de présentation de 15 secondes. Il est utilisé moins comme générateur vidéo que comme agent de production vidéo. -
n°20 @rotejin — 435 likes, 57 reposts, 8 réponses, environ 37 000 vues, 2026-09-25
https://x.com/rotejin/status/2103384608301830297Claude Codeに「新しいモーションを追加して」と頼むだけでLive2Dモーションを追加できるツールを使わせてもらいました…使ったモデルはOpus 5.5のxhigh。
→ Démonstration d’un outil qui ajoute automatiquement des mouvements Live2D — bâillements et éternuements — via Claude Code. Il ne s’agit pas de génération d’images ou de vidéos à proprement parler, mais d’automatisation de l’animation. La mention de « xhigh » comme niveau de raisonnement d’Opus 5.5 est notable. -
n°37 @ponzponz15 — 226 likes, 17 reposts, 7 réponses, environ 35 000 vues, 2026-09-24
https://x.com/ponzponz15/status/21029318249181064993Dカメラ×立体テキスト演出② After Effectsで作るような編集がClaude OpusやCodexでも可能に。 上 Seedance 2.5 prev 下 Codex + Hyperframes skill
→ Comparaison parallèle entre Seedance 2.5 et Codex + Hyperframes skill. Elle illustre la possibilité de remplacer des effets proches d’After Effects par de l’IA de génération de code. -
n°38 @aiehon_aya — 1 594 likes, 143 reposts, 12 réponses, environ 95 000 vues, 2026-09-25
https://x.com/aiehon_aya/status/2103403361022419005Claude Opus5.5 モーショングラフィックス 天才Opus5.5にどうやって作ったのか説明させてみた…index.html→1コマずつ描かせる→render.pyで動画ファイルに
→ La publication Opus 5.5 la plus aimée de cette collecte. L’approche consiste à faire écrire un programme de dessin, à produire les images une par une, puis à les convertir en vidéo, sans utiliser de modèle de génération d’images. -
n°40 @bond_ai1 — 499 likes, 46 reposts, 3 réponses, environ 69 000 vues, 2026-09-25
https://x.com/bond_ai1/status/2103374441250259316動画編集、Premiere Proもカット作業の外注もいらない時代が来ました。Claude Codeに素材を投げるだけで、完全自動でプロ品質の動画が仕上がる『video-use』が登場。
→ « video-use », un outil pour Claude Code, est présenté comme capable d’automatiser entièrement le montage. C’est un exemple d’extension de l’IA au montage automatique de ressources existantes, plutôt qu’à la génération elle-même.
(La publication n°39 de @samcoderx est un fil généraliste sur les usages de Claude et n’aborde pas directement la génération d’images ou de vidéos ; elle a donc été retenue à titre indicatif seulement.)
Signaux
- Hausse : la quasi-totalité des publications liées à Opus 5.5 montrent des pipelines multi-outils qui combinent Claude Opus 5.5 avec GPT Images 2.5, Grok, Gemini TTS, Astra et d’autres outils fermés pour finaliser une vidéo. Plutôt que de miser sur un prompt unique dans un seul modèle, les créateurs réutilisent Claude Code comme « agent de production vidéo » capable de collecter les ressources, monter et choisir la musique.
- Absent ou négligé : parmi les publications collectées, aucune ne cite une IA ouverte de génération d’images ou de vidéos — Stable Diffusion, Flux, ComfyUI, Wan, HunyuanVideo, etc. L’absence de ces mots-clés dans les recherches en est la cause directe, mais dans l’échantillon de 40 éléments et 7 publications pertinentes, la conversation est entièrement concentrée sur les outils fermés : Claude/Opus, GPT Images, Grok, Gemini et Seedance.
- Point surprenant : 8 des 10 tendances explorées — Taylor, #sweepstakes, #giveaways, #chance, Slovenia, Italy, Cardano et Croatia — n’avaient aucun rapport avec le thème. Les tendances croates ne font pas émerger ce type d’outils créatifs IA de niche ; la conversation est plutôt une longue traîne de praticiens partageant individuellement leurs expériences.
Limites
- Comme Explore était verrouillé sur la Croatie, les recherches « Slovenia », « Italy », « Cardano » et « Croatia » ont donné des résultats entièrement hors sujet et ont été exclues de l’analyse.
- « Taylor », « #sweepstakes », « #giveaways » et « #chance » étaient eux aussi hors sujet : actualités musicales, concours, football sud-africain et tags d’illustration coréenne.
- Les recherches n’incluaient aucun mot-clé open source en japonais ou en anglais correspondant à « Stable Diffusion », « Flux », « ComfyUI », « Wan » ou « open source ». Les tendances open source n’ont donc pas du tout été collectées sur X. Ces termes doivent être explicitement ajoutés lors de la prochaine collecte.
- Sur les 40 éléments récupérés, seuls 7 à 8 concernaient directement le thème, loin du critère d’environ 20 analyses. Cela résulte de la régionalisation d’Explore et du choix des termes de recherche.
YouTube
YouTube — Tendances récentes de la génération d’images et de vidéos par IA
Chaînes
Chaînes confirmées dans les résultats de recherche et via oEmbed — nombre d’abonnés indisponible, voir les limites :
- VEED STUDIO — chaîne d’outil de montage vidéo publiant notamment des comparatifs entre Sora 2 et Veo 3.1.
- AI Autopsy Dossier — chaîne de tests de modèles fermés de génération vidéo.
- Tao Prompts — spécialisée dans les comparatifs côte à côte de plusieurs modèles, notamment Seedance, Kling, Minimax et Google Omni.
- Better Stack — chaîne d’analyse de l’actualité de l’industrie IA, incluant xAI et Grok.
- Latent Space — podcast/chaîne d’entretiens avec des chercheurs en IA.
- AI Master — chaîne d’explications sur les outils Google Gemini, dont Nano Banana Pro.
- Zebra Techies Solution-ZTS Infotech — chaîne de comparatifs et de changements d’outils IA.
- SECourses — longues formations sur les modèles open source via ComfyUI et SwarmUI.
- LTX_io — chaîne officielle de Lightricks, avec la présentation de LTX-2.5.
- Prompt Engineer 48 — chaîne d’installation et de test local de modèles open source.
- Bijan Bowen / Codedigipt — chaînes de tests de modèles d’image open source tels que Z-Image Turbo.
- QUASA — chaîne d’explications techniques sur des modèles open source comme Qwen-Image.
Vidéos
[Modèles fermés]
-
Sora 2 Vs Veo 3.1 Comparison (Same Prompts, VERY Different Results) — VEED STUDIO — 2025-11-27 — nombre de vues inconnu — https://www.youtube.com/watch?v=kebWkj5ONzo — Compare Sora 2 et Veo 3.1 avec les mêmes prompts et conclut que Veo 3.1 est plus stable dans le comportement physique et la cohérence.
-
Seedance 2.5 vs Kling 3.0 | The Honest Truth About AI Video Generation in 2026 — AI Autopsy Dossier — 2026-06-27 — nombre de vues inconnu — https://www.youtube.com/watch?v=EtmdbF0DbHU — Affirme que Seedance 2.5 de ByteDance surpasse légèrement Kling 3.0 en mouvement et en physique, tandis que Kling garde l’avantage en cohérence des personnages.
-
Seedance 2.5 vs Minimax H3 vs Google Omni vs Kling 3.0 | Full Comparison — Tao Prompts — 2026-08-14 — nombre de vues inconnu — https://www.youtube.com/watch?v=G5D053drKB8 — Comparatif de quatre modèles fermés de génération vidéo. Le nouveau modèle « Omni » de Google y est présenté comme un concurrent sérieux.
-
xAI are killing it (Grok 4.6, Image 2.0 and more...) — Better Stack — vers août 2026 (« il y a environ un mois ») — nombre de vues inconnu — https://www.youtube.com/watch?v=ILHJqmJdWso — Soutient que Grok Imagine/Image 2.0 de xAI comble rapidement l’écart avec Veo et Sora.
-
Inside xAI: Building Grok Imagine in 3 Months, Videogen vs World Models, and Video Agents — Ethan He — Latent Space — date inconnue, probablement mi-2026 — nombre de vues inconnu — https://www.youtube.com/watch?v=jPtQlILfkhA — Entretien avec un ingénieur de xAI sur le développement de Grok Imagine en seulement trois mois et le choix d’une voie « world model » plutôt que d’un pur modèle de diffusion vidéo.
-
Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI — AI Master — date inconnue, 2026 — nombre de vues inconnu — https://www.youtube.com/watch?v=ZCw325FiS78 — Présentation complète des fonctions d’édition de Nano Banana Pro, le modèle d’image de Google basé sur Gemini 3.
[Open source]
-
Cancel Every Image AI Subscription You Have — Here's What Replaced Them in 2026 — Zebra Techies Solution-ZTS Infotech — 2026-06-24 — nombre de vues inconnu — https://www.youtube.com/watch?v=2qOWfES7R3I — Soutient qu’en 2026, les outils gratuits et open source peuvent remplacer des abonnements payants comme Midjourney.
-
Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models — SECourses — date inconnue, 2026 — nombre de vues inconnu — https://www.youtube.com/watch?v=3BFDcO2Ysu4 — Tutoriel de 37 minutes sur l’installation et l’optimisation de Wan 2.2, FLUX et Qwen-Image avec Lightning LoRA dans SwarmUI et ComfyUI.
-
LTX-2.5: The World Model the World Builds On — LTX_io (officiel Lightricks) — 2026-08-11 — nombre de vues inconnu — https://www.youtube.com/watch?v=ZDfjZae7Da0 — Annonce officielle de LTX-2.5, modèle à poids ouverts de génération vidéo et audio de 22 milliards de paramètres, présenté non seulement pour le cinéma mais aussi comme « world model » pour la robotique.
-
LTX-2.5 Is Open Weights - Full Setup and Test on ComfyUI — Prompt Engineer 48 — 2026-08-18 — nombre de vues inconnu — https://www.youtube.com/watch?v=sIOC9pzHzjs — Installation locale et test de LTX-2.5 dans ComfyUI seulement une semaine après l’annonce officielle. La vidéo confirme son fonctionnement sur des GPU grand public.
-
Alibaba Z-Image Turbo Test – The New KING of LOCAL Image Models — Bijan Bowen — date inconnue, estimée entre fin novembre 2025 et début 2026 — nombre de vues inconnu — https://www.youtube.com/watch?v=K0FgDU-9uik — Évalue Z-Image Turbo d’Alibaba/Tongyi, sous licence Apache-2.0, comme supérieur aux autres modèles d’image locaux en vitesse et en qualité.
-
Z Image Turbo (FREE): This Open-Source AI Changed Image Generation Forever! (Like nano banana pro) — Codedigipt — date inconnue — nombre de vues inconnu — https://www.youtube.com/watch?v=sPQQPpQ9X4E — Soutient que Z-Image Turbo, gratuit et open source, rivalise avec l’outil payant Nano Banana Pro de Google.
Signaux
- Les vidéos consacrées à la génération vidéo fermée privilégient les comparatifs multi-modèles — « Seedance contre Kling contre Veo contre Sora » — plutôt que les tests d’un modèle isolé, ce qui suggère une forte demande pour ce format (#2, #3).
- Grok Imagine de xAI était souvent associé, jusqu’au début de 2026, au contenu non censuré ou provocant. Dans les vidéos d’août environ (#4, #5), le discours a changé : il est évalué sérieusement comme rival de Veo et Sora.
- Google est fréquemment cité à la fois pour l’image, avec Nano Banana Pro, et la vidéo, avec Flow et Omni. Il est donc davantage présenté comme écosystème que comme modèle unique.
- Le mouvement open source est symbolisé par LTX-2.5 de Lightricks, annoncé le 11 août 2026 : une vidéo indépendante d’installation dans ComfyUI est apparue seulement une semaine plus tard (#10), illustrant la vitesse de réaction de la communauté.
- Z-Image Turbo d’Alibaba/Tongyi est présenté par plusieurs chaînes comme une « version gratuite de Nano Banana Pro ». L’opposition entre open source et fermé se reflète directement dans les titres (#11, #12).
- Les longs tutoriels de plus de 30 minutes, comme ceux de SECourses, supposent un flux combinant plusieurs modèles ouverts — Wan, FLUX, Qwen-Image —, signalant un passage d’un modèle unique à des workflows composés (#8).
Limites
- Les pages de recherche YouTube (
/results?search_query=...) et les pages de vidéos (/watch?v=...) sont rendues en JavaScript. WebFetch ne renvoyait que le pied de page statique — conditions d’utilisation, mentions de droits, etc. —, sans vues, abonnés, dates de publication ni commentaires. - WebSearch, via des requêtes telles que
site:youtube.com, et l’endpoint oEmbed de YouTube (https://www.youtube.com/oembed?url=...&format=json) ont permis d’identifier les titres et chaînes, mais aucun ne fournit les vues ni le nombre d’abonnés. Toutes les vidéos sont donc indiquées avec un nombre de vues inconnu. - Les dates de publication sont déduites des extraits WebSearch. Certaines sont restées sous forme relative, comme « il y a deux semaines » ou « il y a un mois », à partir de la date de référence du 26 septembre 2026.
- Les descriptions et commentaires n’étaient pas directement accessibles, de sorte que les réactions des spectateurs ne figurent pas dans ce rapport.
- Aucune vidéo YouTube traitant directement de l’arrêt de l’API Sora par OpenAI le 24 septembre 2026 n’a été trouvée ; les comparatifs disponibles sont tous antérieurs.
Bluesky
Bluesky — Actualités de l’IA de génération d’images et de vidéos
Le site bsky.app est une SPA rendue en JavaScript : WebFetch ne pouvait récupérer ni les pages de recherche ni les publications individuelles, seulement le texte « Bluesky ». L’endpoint officiel public.api.bsky.app répondait aussi par une erreur 403. L’API JSON app.bsky.feed.searchPosts sur api.bsky.app, sans public., restait accessible ; elle a donc permis d’analyser plus de 200 publications issues de 12 requêtes — stable diffusion, midjourney, Sora 2, Veo 3, Nano Banana, Flux image model, ComfyUI, Sora API shutdown, Wan 3.0 video, Seedance, Grok Imagine et HunyuanVideo/LTX Video — avec 20 à 25 résultats chacune. Seules les publications directement pertinentes sont reprises ci-dessous.
Comptes
- @aichina.news — compte quasi automatisé qui signale un par un les LoRA SDXL/FLUX publiés sur Modelers.cn, plateforme IA destinée aux NPU Ascend de Huawei. Presque toutes les publications obtiennent zéro like, mais leur volume est exceptionnel — plus de 20 par jour — et elles constituent un point d’observation de l’écosystème ouvert d’image générative Ascend.
- @oludai.bsky.social (🚀 olud.ai) — compte d’actualité sur les classements de modèles IA. Il a signalé que Wan 3.0 d’Alibaba avait atteint la première place des classements d’évaluation humaine pour la génération vidéo parmi les modèles à poids ouverts.
- @github-trending.bsky.social — publication automatisée des tendances GitHub. Il a signalé l’entrée de
stable-diffusion.cpp— ★7 148, moteur C++ léger d’inférence de modèles de diffusion — parmi les tendances. - @huggingfacetrends.bsky.social (tendances quotidiennes Hugging Face) — bot quotidien de tendances Hugging Face. Il a signalé le portage de Qwen-Image 2.1 dans ComfyUI.
- @aipromptingclinic.bsky.social — compte publiant chaque jour de nombreux conseils de prompt pour Seedance, Kling et Grok Imagine. L’engagement est presque nul, mais sa fréquence élevée montre l’élargissement de l’usage pratique des modèles fermés d’image et de vidéo.
- @aki-kisaragi.bsky.social (AKI) — créateur individuel publiant des icônes et illustrations produites avec Grok Imagine ; exemple d’usage de Grok Imagine dans la sphère japonaise.
- @hashimoto-ekuto.bsky.social (PuniQ) — créateur individuel documentant ses générations vidéo jusqu’à épuisement de ses crédits Seedance 2.5, avec une publication à 19 likes et 3 reposts.
- @dfl.bsky.social (DFL inc.) / @obeca.bsky.social — comptes publiant régulièrement des images créées avec Nano Banana 2, jusqu’à 27 et 21 likes respectivement.
- @alternativeto.net — média de comparaison d’outils ayant diffusé avec 11 likes la nouvelle de l’arrêt de Sora par OpenAI.
Publications
-
@knowmouth.bsky.social — 0 like, 0 repost, 2026-09-25T00:51
https://bsky.app/profile/knowmouth.bsky.social/post/3mwckivdpkk2y🎬 Sora is officially gone. OpenAI discontinued the Sora product earlier this year, and Sora 2, Sora 2 Pro and the Videos API reached their shutdown date on September 24, 2026.
→ Grande nouvelle côté fermé : OpenAI a mis fin à l’ensemble du produit vidéo Sora. Aucun calendrier de remplacement n’a été annoncé. -
@alternativeto.net — 11 likes, 0 repost, 2026-03-25T11:30
https://bsky.app/profile/alternativeto.net/post/3mhuyfrjnpz26OpenAI is shutting down its AI video slop social app, Sora, along with its API less than six months after launch... ending a billion-dollar partnership with Disney.
→ Publication Sora la plus aimée de la collecte : elle rapporte l’arrêt de l’application et de l’API, simultanément à la rupture d’un partenariat avec Disney estimé à un milliard de dollars. -
@aifoundersczech.bsky.social (AI Founders ONLINE) — 0 like, 0 repost, 2026-07-04T11:00
https://bsky.app/profile/aifoundersczech.bsky.social/post/3mpsvtc4hkd2uGoogle just priced its new video API 4x cheaper than its own flagship tier — on purpose... Sora finished burning $1M/day against $2.1M in lifetime revenue.
→ Présente l’arrêt de l’API Sora avec des chiffres : 1 million de dollars de pertes quotidiennes pour 2,1 millions de dollars de revenus cumulés. La publication mentionne aussi l’offensive tarifaire de Google Veo. -
@coreati.bsky.social (Core Ai News 🚨) — 0 like, 0 repost, 2026-09-24T18:52
https://bsky.app/profile/coreati.bsky.social/post/3mwbwh5p7mj2eGOOGLE 🔥: Nano Banana 2.5 Flash traces have been spotted...
→ Publication de fuite signalant des traces de la prochaine version 2.5 Flash du modèle d’image Nano Banana de Google, au cœur de la compétition fermée en génération d’images. -
@garutoroid.bsky.social (ガル・トロイド) — 3 likes, 0 repost, 2026-09-24T10:03
https://bsky.app/profile/garutoroid.bsky.social/post/3mwayvizumc2g同プロンプトのGPT Image 2.5とNano Banana 2版。
→ Expérience comparant GPT Image 2.5 et Nano Banana 2 avec le même prompt. Elle montre que les comparaisons directes de modèles fermés sont devenues ordinaires au niveau des utilisateurs. -
@ahiruai.bsky.social (あひる|楽すぎるAI副業) — 0 like, 0 repost, 2026-09-25T08:41
https://bsky.app/profile/ahiruai.bsky.social/post/3mwdeqlfflo2fRunwayの「Draft mode」を使うとSeedance 2.5のクレジット消費を抑えられる、という情報共有。
→ Astuce d’utilisation : le « Draft mode » de Runway permettrait de limiter la consommation de crédits de Seedance 2.5. C’est un exemple d’intégration de modèles vidéo fermés via une plateforme tierce. -
@oludai.bsky.social (🚀 olud.ai) — 1 like, 0 repost, 2026-09-25T21:00
https://bsky.app/profile/oludai.bsky.social/post/3mweo2rmjo424🏆 Wan 3.0, an open-weight model, tops the human-preference ranking for video generation—beating every closed rival.
→ Grande information côté ouvert : le modèle à poids ouverts Wan 3.0 d’Alibaba dépasserait tous les modèles fermés dans un classement de préférence humaine. -
@ai-linkstream.bsky.social — 0 like, 0 repost, 2026-09-25T17:50
https://bsky.app/profile/ai-linkstream.bsky.social/post/3mwedgzcgkh2gAlibaba has launched its AI video model, Wan 3.0, after a $10 billion share sale.
→ Le lancement de Wan 3.0 est signalé juste après une vente d’actions d’Alibaba de 10 milliards de dollars, ce qui donne une idée de l’ampleur des capitaux engagés dans l’IA ouverte. -
@riccinov.bsky.social (Ricci Research) — 0 like, 0 repost, 2026-09-24T15:07
https://bsky.app/profile/riccinov.bsky.social/post/3mwbjv6rqxt2fAlibaba's Qwen Image 2.1 is 7B parameters and scores 60.2...
→ Rapporte le score de benchmark de Qwen-Image 2.1, modèle ouvert d’image d’Alibaba comptant 7 milliards de paramètres : 60,2. -
@huggingfacetrends.bsky.social (tendances quotidiennes Hugging Face) — 0 like, 0 repost, 2026-09-25T15:04
https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mwe25zx3bn27Comfy-Org/Qwen-Image-2.1: Qwen-Image 2.1 repackaged for ComfyUI
→ Qwen-Image 2.1 a été distribué immédiatement sous forme de nœud ComfyUI. Cela illustre la vitesse à laquelle les modèles ouverts rejoignent l’écosystème. -
@github-trending.bsky.social — 1 like, 0 repost, 2026-09-24T19:17
https://bsky.app/profile/github-trending.bsky.social/post/3mwbxt7hrhr2q📦 leejet / stable-diffusion.cpp ⭐ 7,148 (+33) 🗒 C++ — Diffusion model(SD,Flux,Wan,Qwen Image,Z-Image,...) inference in pure C/C++
→ Un projet qui exécute SD, Flux, Wan, Qwen Image, Z-Image et d’autres modèles de diffusion ouverts dans un même moteur C++ est entré parmi les tendances GitHub. C’est un signal fort pour l’inférence légère et locale. -
@manilarope.bsky.social (Taimai🔞) — 2 likes, 1 repost, 2026-09-26T00:48
https://bsky.app/profile/manilarope.bsky.social/post/3mwf2swkkao2fComfyUIくんとのケンカがなんとか一段落して、MiniMaxH3で動画を生成できるようになってくれました。
→ Compte rendu personnel d’expérimentations pour faire fonctionner MiniMax H3 dans ComfyUI. Exemple d’intégration locale d’un modèle vidéo ouvert ou semi-ouvert.
Signaux
Évolutions côté fermé
- OpenAI a complètement mis fin à la marque Sora : l’application a été arrêtée en avril 2026, puis Sora 2, Sora 2 Pro, l’API Videos et tous les alias de modèles ont été désactivés le 24 septembre, sans feuille de route de remplacement. Un partenariat avec Disney de l’ordre d’un milliard de dollars aurait également échoué, avec un préavis inférieur à une heure pour Disney.
- La faible viabilité économique de Sora — 1 million de dollars de pertes par jour contre 2,1 millions de revenus cumulés — est désormais évoquée publiquement comme leçon : même un modèle de pointe peut disparaître s’il n’est pas rentable.
- En parallèle de la fin de Sora, Google a re-tarifé son API de génération vidéo Veo à un prix quatre fois inférieur à son propre niveau phare, engageant une offensive tarifaire.
- La famille Nano Banana de Google semble passer de la version 2 à 2.5 Flash. Des traces et rumeurs de fuite circulent déjà, tandis que les utilisateurs comparent directement les résultats de Nano Banana 2 et GPT Image 2.5 avec des prompts identiques.
- Seedance 2.5 de ByteDance se normalise parmi les créateurs vidéo, y compris via des plateformes tierces comme Runway. La vitesse à laquelle ses crédits sont consommés revient régulièrement dans les discussions.
- Kling 3.0 et Grok Imagine sont également intégrés aux workflows de créateurs individuels : icônes, vidéos de type vlog et fonctions d’Auto-Director combinant plusieurs modèles.
- Après l’arrêt de l’API Sora, certaines publications recommandent explicitement Seedance 2.0, LTX et Runway comme destinations de migration.
Évolutions côté open source
- Wan 3.0, le modèle vidéo à poids ouverts d’Alibaba, aurait dépassé les modèles fermés dans les classements d’évaluation humaine. Son lancement est intervenu juste après une vente d’actions de 10 milliards de dollars.
- Qwen-Image 2.1 d’Alibaba — 7 milliards de paramètres, score de benchmark de 60,2 — a reçu presque immédiatement un nœud de Comfy-Org pour ComfyUI, intégrant l’écosystème en quelques jours.
- Le moteur d’inférence C++ léger et local
stable-diffusion.cpp(★7 148), compatible avec SD, Flux, Wan, Qwen Image et Z-Image, est entré dans les tendances GitHub. - L’écosystème Ascend NPU de Huawei, notamment Modelers.cn, voit une production massive de LoRA SDXL/FLUX. Beaucoup sont de faible qualité — sans carte de modèle, mot déclencheur ni exemple —, alors que les LoRA plus soignés, sous Apache-2.0, utilisables commercialement et ne nécessitant pas de réentraînement, restent relativement rares.
- Des utilisateurs individuels tentent de faire fonctionner MiniMax H3 localement via ComfyUI, et des comparatifs de performances commencent à apparaître.
- Dans l’ensemble, l’open source progresse sur deux niveaux : la rapide migration vers ComfyUI des grands modèles d’Alibaba, Wan et Qwen, et la production plus artisanale de LoRA dans l’écosystème Huawei Ascend.
Limites
- Les pages de recherche et les publications individuelles de
bsky.appétant rendues côté client, WebFetch ne renvoyait que le mot « Bluesky » et aucun texte utile. - L’endpoint XRPC
public.api.bsky.appdocumenté officiellement renvoyait systématiquement 403 Forbidden dans cette session.api.bsky.appsans préfixepublic.fonctionnait, mais pourrait lui aussi être bloqué à l’avenir par des mécanismes anti-bot. - Les appels
curldirects depuis Bash demandaient une approbation réseau, indisponible dans cet environnement non interactif. La collecte a donc été réalisée uniquement via WebFetch. - La recherche du terme
Veo 3était fortement polluée par le verbe espagnol « veo » et par l’émission radio « Logan Veo ». Une seule mention directe de Google Veo a été trouvée, dans une publication liée à Nano Banana. Aucune recherche dédiée de type « Google Veo » n’a été faite. - La requête
HunyuanVideo/LTX Videon’a donné aucun résultat. Aucun contenu spécifique à ces deux modèles n’a donc été trouvé sur Bluesky avec les mots-clés employés. - L’API de recherche semble limiter les résultats à
limit=25, dans l’ordre antéchronologique. L’analyse ne couvre donc pas de tendances de long terme.
Lemmy
Lemmy — Actualités de l’IA de génération d’images et de vidéos
Plusieurs recherches ont été effectuées dans l’API /api/v3/search de lemmy.world, avec notamment « image generation AI », « video generation AI », « Sora shutdown », « Nano Banana », « Grok Imagine », « Wan 2.2 OR Wan 3 » et « Flux image model ». Elles étaient majoritairement remplies de résultats non pertinents, l’outil effectuant aussi des correspondances partielles dans les commentaires. Les recherches de termes ont donc été rapidement abandonnées au profit d’une navigation directe dans les communautés spécialisées existantes.
Communautés
| Communauté | Instance | Abonnés | Tendance |
|---|---|---|---|
| !«メールアドレス» | lemmy.dbzer0.com | 5 713 | Flux qui publie mécaniquement des liens HuggingFace/GitHub vers de nouveaux modèles open source, LoRA et nœuds ComfyUI. Activité presque quotidienne, jusqu’au 2026-09-22. dbzer0 exploite aussi AI Horde, réseau d’inférence SD distribué et collaboratif. |
| !«メールアドレス» | lemmy.dbzer0.com | 2 363 | Vitrine d’illustrations IA de Civitai repostées en miroir. Une dizaine de publications quotidiennes, jusqu’au 2026-09-26. |
| !«メールアドレス» | lemmy.world | 1 985 | Communauté consacrée à l’outil gratuit Perchance, dont la génération d’images utilise Flux. |
| !«メールアドレス» | lemmy.ml | 1 662 | Jadis active, désormais pratiquement à l’arrêt. Dernière publication substantielle le 2026-02-12 sur Qwen-Image-2.0 ; les précédentes traitaient principalement de la crise de gestion de Stability AI en 2024. |
| !«メールアドレス» | lemmy.world | 1 258 | Actualités ML/IA généralistes. Presque aucun contenu spécifiquement consacré à la génération d’images ou de vidéos ; sujets récents centrés sur l’électricité des data centers et la stratégie IA de Microsoft. |
| !«メールアドレス» (Generative Artificial Intelligence) | sopuli.xyz | 328 | Communauté de discussion sur l’IA générative en général. Peu d’actualités concrètes sur image/vidéo ; dernière publication substantielle le 2026-04-30, sur les fonctions de génération de fichiers de l’application Gemini. |
| !«メールアドレス» | lemmy.durstig.online | 52 | Bot RSS qui reflète mécaniquement les subreddits IA. Les scores sont systématiquement de 1 point et ne représentent pas un véritable engagement. |
| !«メールアドレス» | sh.itjust.works | 172 | Communauté d’exemples d’art IA inactive depuis 2023. |
Publications
-
Qwen-Image-2.1 in ComfyUI (!«メールアドレス», 13 points, 0 commentaire, 2026-09-22)
https://lemmy.dbzer0.com/post/75874773 → Publication de lien annonçant la prise en charge officielle du modèle ouvert Qwen-Image 2.1 d’Alibaba dans le blog ComfyUI, blog.comfy.org. Le même mouvement ayant été signalé à la même période sur Bluesky, Lemmy confirme qu’il s’agit d’un sujet majeur de l’open source. -
Supra2-IMG Model (!«メールアドレス», 8 points, 0 commentaire, 2026-09-22)
https://lemmy.dbzer0.com/post/75874769 → Annonce de sortie sur HuggingFace du nouveau modèle de génération d’imagesSupraLabs/Supra2-IMG. -
AI Horde New Interface (!«メールアドレス», 9 points, 0 commentaire, 2026-09-19)
https://lemmy.dbzer0.com/post/75736717 → Publication par haidra.net d’une nouvelle interface et de documentation pour AI Horde, infrastructure gratuite, distribuée et participative de génération d’images. Il s’agit d’une base de génération ouverte et décentralisée à laquelle la communauté Lemmy participe elle-même. -
Série concentrée d’outils ComfyUI pour MiniMax H3 (!«メールアドレス», 1 à 3 points chacun, 2026-09-12 à 09-16)
https://lemmy.dbzer0.com/post/75586072 (MiniMaxH3-PromptBuilder),
https://lemmy.dbzer0.com/post/75586070 (wan2gp-h3-latent-continue),
https://lemmy.dbzer0.com/post/75427444 (3d-Camera-control-H3-Minimax) et autres
→ Plus de cinq nœuds ComfyUI personnalisés et générateurs de prompts destinés au modèle vidéo MiniMax H3 ont été publiés coup sur coup en une semaine. Cela concorde avec le consensus observé sur Reddit selon lequel MiniMax H3 est la référence vidéo, et montre que les outils ouverts suivent rapidement. -
Krea2-Turbo-Distill-2step-LoRA (!«メールアドレス», publié deux fois les 2026-09-13 et 09-16, 1 à 2 points)
https://lemmy.dbzer0.com/post/75427441 / https://lemmy.dbzer0.com/post/75586071 → Publication HuggingFace d’un LoRA qui accélère Krea 2 en deux étapes. En parallèle du consensus Reddit désignant Krea 2 comme meilleure recommandation actuelle, les adaptateurs d’accélération se mettent déjà en place. -
LTX-2.5-22b-IC-LoRA-Ingredients (!«メールアドレス», 3 points, 0 commentaire, 2026-09-12)
https://lemmy.dbzer0.com/post/75382763 → Publication d’un LoRA pour LTX, modèle vidéo ouvert de Lightricks. -
Waters & World's Edge et autres illustrations Civitai quotidiennes (!«メールアドレス», jusqu’à 12 points, 2026-09-22 à 09-26)
https://lemmy.dbzer0.com/post/75841792 et plus d’une dizaine d’autres → Il s’agit davantage d’une vitrine de créations que de nouvelles, mais leur publication quotidienne ininterrompue montre que la communauté de génération locale reste active. -
We are saying goodbye to Sora (!«メールアドレス», -11 points, 4 commentaires, 2026-03-24)
https://lemmy.world/post/44702049 → Reprise intégrale de l’annonce d’OpenAI sur la fermeture de l’application Sora originelle, remerciant les personnes ayant créé avec Sora. La réaction de Lemmy est froide, avec un score négatif. Aucune publication récente sur l’arrêt complet de fin septembre, couvrant Sora 2 et l’API Videos, n’a été trouvée ; cette reprise de mars est le seul contenu Sora substantiel rencontré. -
Interesting Facts about Perchance (!«メールアドレス», 3 points, 18 commentaires, 2026-08-05)
https://lemmy.world/post/50319371 → Discussion indiquant que la génération d’images du site gratuit Perchance s’appuie sur le modèle ouvert Flux et qu’il utilise aussi des modèles de texte ouverts et gratuits DeepSeek. Exemple de pénétration des noms de modèles open source dans le contexte grand public des outils IA gratuits.
Signaux
- La hausse concerne presque exclusivement l’open source : la seule communauté spécialisée véritablement active,
!«メールアドレス», récupère mécaniquement les sorties HuggingFace et GitHub. Qwen-Image 2.1, Krea 2, MiniMax H3 et LTX y sont apparus de manière concentrée ces deux dernières semaines. Les mêmes modèles ouverts jugés « les plus chauds » sur Reddit et Bluesky arrivent sur Lemmy sans délai notable. - Les sujets fermés sont structurellement peu présents : malgré plusieurs recherches ciblées, aucune publication récente n’a été trouvée sur l’arrêt de Sora, Nano Banana, la baisse de Veo, Grok Imagine ou Seedance. La seule publication Sora est une reprise de mars, impopulaire à -11 points. Le public de Lemmy, plus technique et tourné vers l’auto-hébergement, paraît privilégier l’offre de modèles et outils qu’il peut faire fonctionner lui-même plutôt que les actualités de services fermés d’entreprise.
- L’engagement est globalement faible : les publications liées à
stable_diffusionont généralement de 1 à 13 points et zéro commentaire. Contrairement à Reddit, il y a peu de discussions actives. Il faut donc mesurer l’intérêt sur Lemmy par le volume et la fréquence de publication, pas par l’intensité des réactions. - Les communautés généralistes sont plutôt sceptiques à l’égard de l’IA : dans
!fuck_aiet!machinelearning, les sujets dominants concernent davantage la dépendance à l’IA, l’électricité des data centers ou l’histoire de la crise de Stability AI que la génération d’images et de vidéos elle-même.
Limites
- L’API de recherche de Lemmy est peu précise. Des requêtes comme « image generation AI », « video generation AI », « Sora shutdown », « Nano Banana », « Grok Imagine », « Wan 2.2 OR Wan 3 » et « Flux image model » ont produit surtout des résultats sans rapport, incluant des correspondances partielles dans les commentaires. L’analyse a donc privilégié la navigation directe dans les communautés spécialisées, avec le risque que des sujets soient restés cachés sur d’autres instances.
- Aucune communauté spécifiquement dédiée à la génération vidéo n’a été trouvée sur Lemmy. Les discussions sur les modèles vidéo sont observées uniquement à travers les publications d’outils ComfyUI dans
!«メールアドレス». - Aucune actualité de septembre sur les services fermés — OpenAI Sora, Google Nano Banana/Veo, xAI Grok Imagine ou ByteDance Seedance — n’a été trouvée. La seule publication pertinente est une ancienne reprise de mars. Ce calme total, contrairement aux autres plateformes, est lui-même révélateur de la nature de Lemmy.
- Le critère d’environ 20 publications analysées n’est pas atteint. Lemmy est une petite plateforme, et les publications substantielles directement liées au sujet se limitent à environ neuf ; le reste était composé de bruit ou de communautés inactives.
- Des communautés comme
!«メールアドレス», dont le nom apparaissait dans les résultats de recherche, renvoyaient une erreur 404 via l’API, empêchant de confirmer leur existence réelle.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
Thèmes visuels
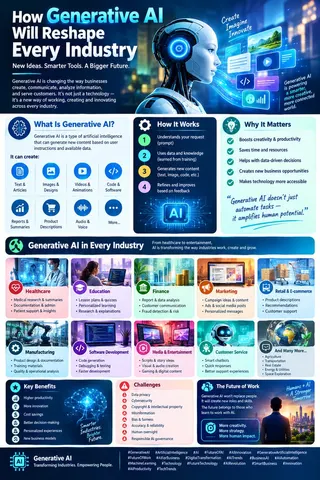
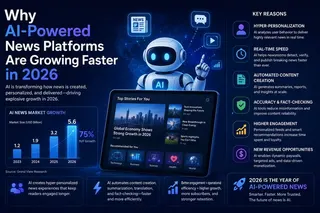
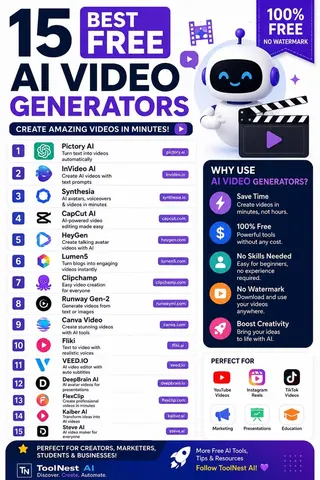
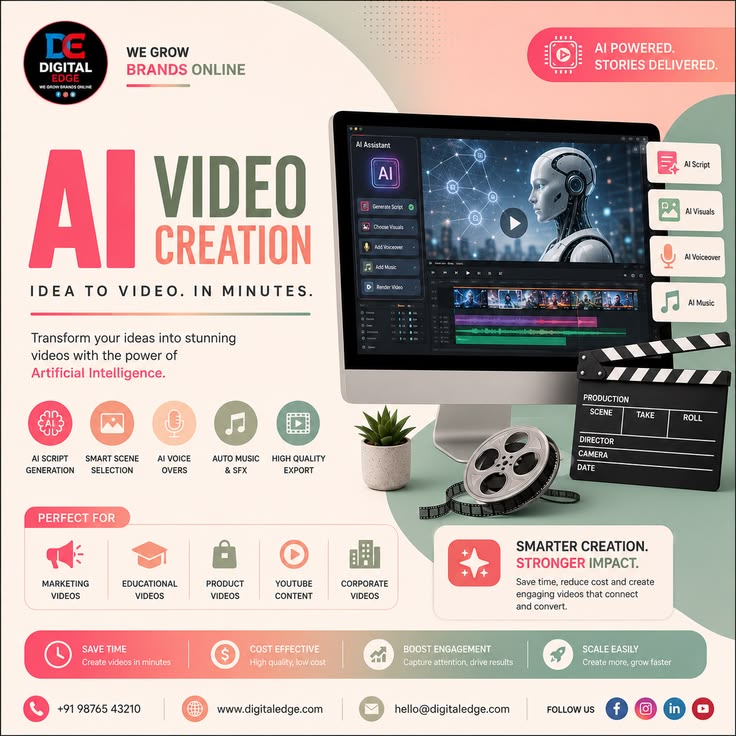
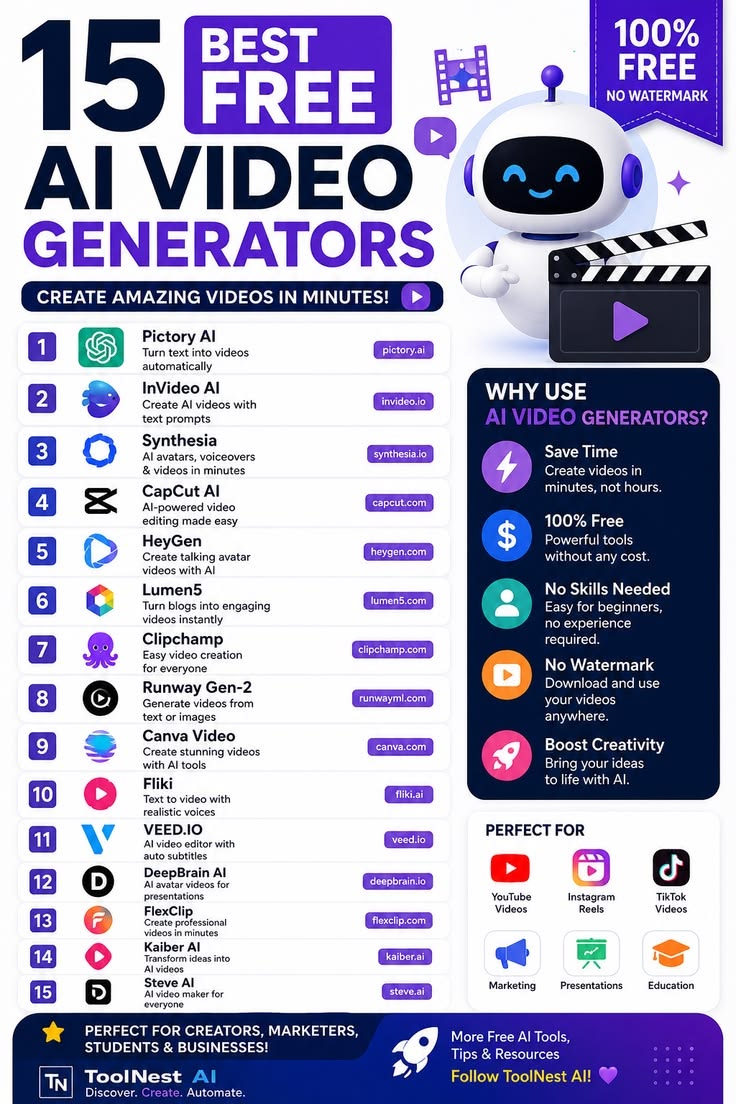
- Les infographies sous forme de listes des « meilleurs outils IA » dominent le tableau : fonds bleu marine ou noirs, dégradés néon violet/bleu/rose autour de titres sans-serif très épais — « 6+ BEST AI VIDEO GENERATION WEBSITES », « 12 BEST AI VIDEO GENERATORS » —, lignes numérotées ou cadre de téléphone, chaque ligne associant un logo d’outil à une promesse et à un exemple généré [1, 7, 42].
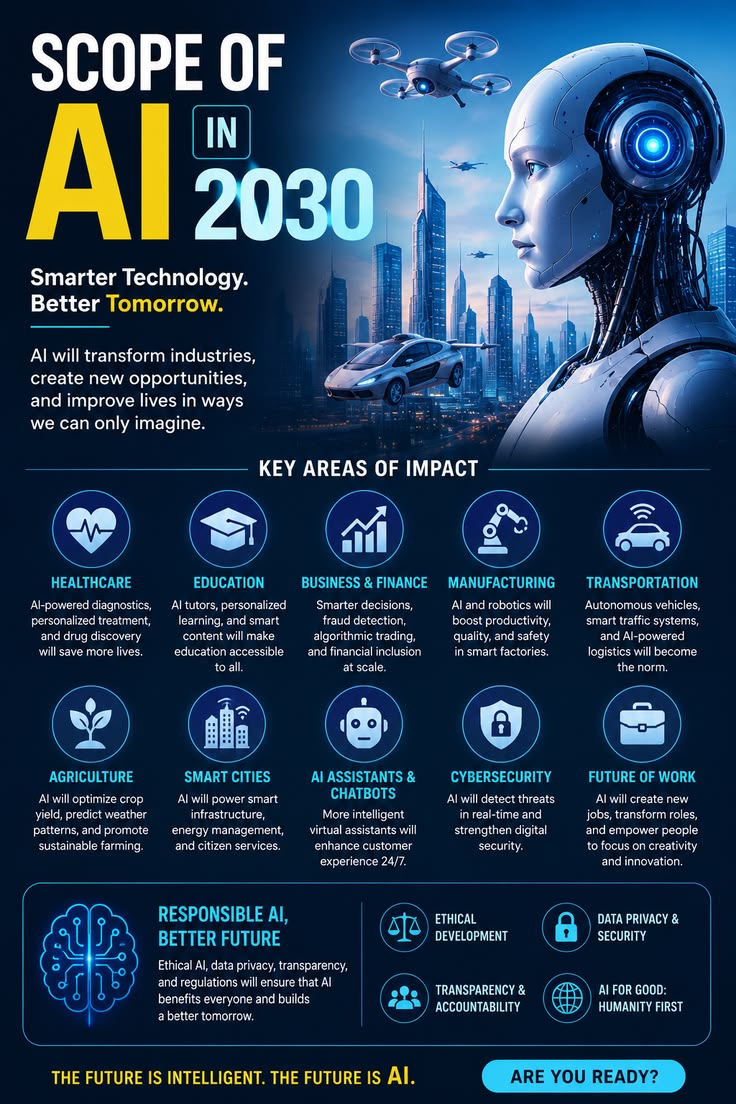
- Une tête de robot humanoïde chromée ou vitrée, vue de profil et éclairée en bleu, est l’illustration par défaut de tout contenu du type « l’IA change tout » ou « futur de l’IA ». Elle est utilisée indistinctement pour les actualités d’image générative, de vidéo générative et d’IA générale, ce qui rend les genres difficiles à distinguer des visuels de promotion génériques [2, 16, 19].
- Les captures réelles d’outils de vidéo générative apparaissent comme petites vignettes intégrées aux infographies, plutôt que comme images principales : par exemple le panneau intégré « Generate Video/Sound » d’Adobe Premiere [3], ou des images de démonstration de Luma Dream Machine et Kling AI dans des listes [1, 7].
- Les collages verticaux en piles de téléphones montrent des dizaines d’écrans affichant de courts formats — coureur, chat, paysages de montagne — qui montent dans le ciel comme un gratte-ciel. Ils illustrent « le contenu IA est partout » ou la croissance de la vidéo sociale, et non un outil précis [6].
- Les épingles d’actualités IA au format vignette YouTube montrent un homme barbu choqué ou enthousiaste à côté de 2 à 4 logos d’OpenAI, Google, Microsoft, Meta ou Notion, dans des carrés lumineux sur fond bleu/noir, avec un texte blanc « AI NEWS ». Il s’agit d’un format de miniature réemployé par plusieurs créateurs [24, 38].
- Les grilles avant/après et de comparaison pour les transformations vidéo montrent un clip source d’une personne en marche, transformé en blocs de bois, origami, briques colorées et fleurs, dans une grille à cinq colonnes marquée du filigrane Luma. C’est la démonstration produit la plus concrète de l’échantillon [28].
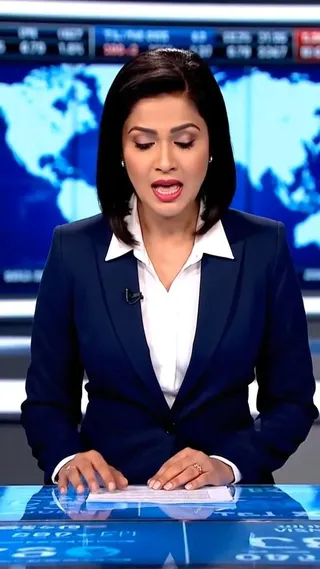
- Le cadrage de l’actualité par les présentateurs IA et deepfakes apparaît avec un badge « AI GENERATED » sur une vidéo façon NBC News d’une présentatrice météo dans la neige, illustrant directement le débat « peut-on faire confiance aux vidéos d’actualité IA ? » [32].
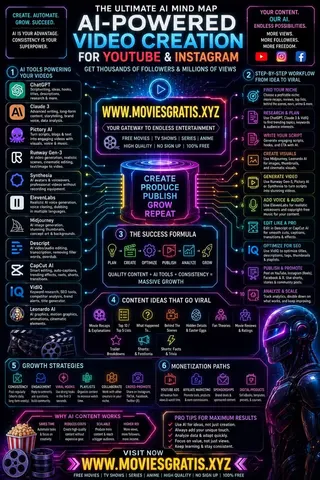
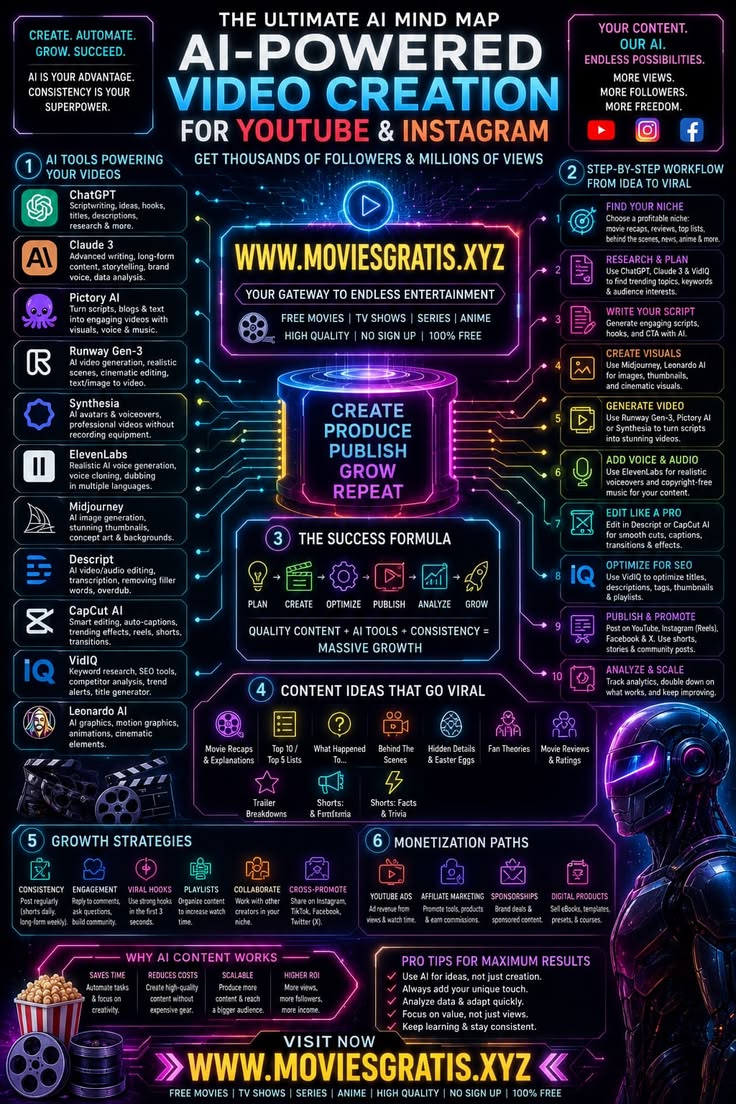
- Les infographies d’entonnoirs ou cartes mentales de pipelines complets comprennent un graphique circulaire d’« écosystème alimenté par IA » avec des icônes tenues par des mains [47], et une vaste carte « AI-Powered Video Creation for YouTube & Instagram » citant ChatGPT, Claude 3, Pictory AI, Runway Gen-3, Synthesia, ElevenLabs, Midjourney, Descript, CapCut AI, VidIQ et Leonardo AI dans un même flux. Elle est curieusement reliée à un site de streaming pirate, www.moviesgratis.xyz [13].
Épingles notables
- [1] « 6+ Best AI Video Generation Websites » — infographie complète classant Runway, Pika, Kling AI, Luma AI Dream Machine, Canva AI Video Generator et Hailuo AI, avec exemple visuel et public cible pour chacun. C’est la meilleure photographie unique des outils vidéo fermés actuellement mis en avant par les créateurs sur Pinterest.
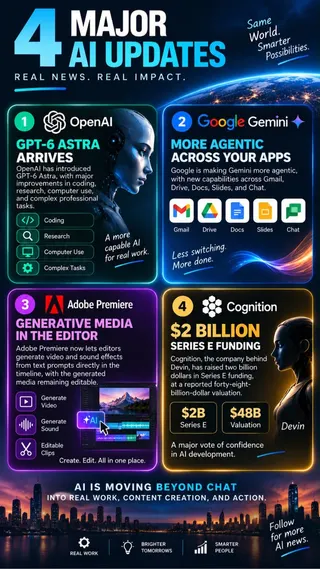
- [3] « 4 Major AI Updates You Need to Know in 2026 » — cite quatre éléments fermés concrets : « GPT-6 Astra » d’OpenAI, l’évolution plus agentique de Google Gemini dans Gmail, Drive, Docs, Slides et Chat, la nouvelle fonction de vidéo/son génératif intégrée à la timeline d’Adobe Premiere, et une levée de série E de 2 milliards de dollars pour Cognition, créateur de Devin, valorisée 48 milliards.
- [7] « 12 Best AI Video Generators in 2026 » — deuxième classement plus long : Google Veo, OpenAI Sora, Runway, Kling AI, Pika, Luma Dream Machine, HeyGen, Synthesia, InVideo AI, Vidu AI, Hailuo AI et PixVerse AI. Comparé à l’épingle [1], il confirme que Runway, Pika, Kling, Luma et Hailuo sont les noms répétés par des créateurs indépendants, donc la liste consensuelle actuelle.
- [13] « AI Content Studio & Automation Secrets » — carte mentale de moviesgratis.xyz associant ChatGPT, Claude 3, Pictory AI, Runway Gen-3, Synthesia, Midjourney, ElevenLabs, Descript, CapCut AI, VidIQ et Leonardo AI dans un pipeline « idée → publication ». Utile pour voir quels outils les créateurs SEO/affiliation considèrent comme stack vidéo par défaut, mais le site de destination ressemble à une page de génération de prospects associée au streaming piraté, pas à une source crédible.
- [24] « AI News: Anthropic Leak Shows Us The Future of AI » — épingle au format vignette YouTube, avec logos OpenAI/Google/Microsoft/OpenAI et visage de créateur choqué, affirmant une fuite chez Anthropic. La vignette elle-même ne présente aucun contenu Anthropic : cette affirmation ne peut donc pas être vérifiée à partir de l’image seule.
- [28] « Google announces ultra-high quality video... » — grille de cinq transformations appliquées à trois sujets — personne, chien et voiture — où une vidéo source devient bois, origami, briques jouet ou fleurs, avec filigrane Luma. C’est la démonstration la plus tangible de la sélection : une réelle capacité de transfert de style sur des images vidéo plutôt que du texte marketing.
- [32] « AI news videos blur line between real and fake reports » — clip aux couleurs de NBC News avec badge « AI GENERATED » sur un bulletin météo enneigé. L’image visualise directement la controverse des présentateurs IA, plutôt que de simplement la nommer.
- [38] « AI News: OpenAI Finally Released What We Asked For » — autre vignette d’actualité avec visage choqué et grille de logos OpenAI, Google, Meta et Notion. Sa proximité avec [24] suggère un modèle de vignette ou de chaîne récurrent plutôt qu’une information exclusive.
- [43] « generate ai images, art, illustration, using with midjourney » — une des rares épingles de la sélection à citer Midjourney directement plutôt que de l’enfouir dans une infographie multi-outils. L’image est toutefois une maquette générique de bureau à trois écrans, sans résultat Midjourney visible : elle ressemble davantage à une épingle SEO/affiliation qu’à une véritable démonstration.
Signaux
- Les outils vidéo fermés grand public dominent clairement la plateforme. Runway, Pika, Kling AI, Luma Dream Machine, Hailuo AI, Google Veo, OpenAI Sora, HeyGen, Synthesia, InVideo AI, Vidu AI et PixVerse AI reviennent dans des épingles indépendantes [1, 7]. C’est un signal plus robuste qu’une seule épingle : il s’agit du consensus « meilleur choix » actuel chez les créateurs de contenu marketing.
- L’inquiétude sur la confiance et l’authenticité est un sous-thème visible, pas seulement une promotion d’outils : deepfakes de présentateurs d’actualité IA [32], détecteurs de voix IA, graphismes de filigrane pour prouver l’origine [19, 40], et cadrage autour de « peut-on encore faire confiance au journalisme ? » accompagnent fréquemment les listes d’outils.
- L’actualité de l’IA d’entreprise et des agents se mêle au même tableau : la poussée agentique de Gemini dans Workspace et la levée de 2 milliards de dollars de Cognition/Devin [3] apparaissent dans une recherche sur l’IA image/vidéo. L’algorithme Pinterest mélange donc l’actualité générale de l’IA à cette niche, au lieu de les séparer nettement.
- Les modèles ouverts d’image et de vidéo sont presque totalement absents. Aucune épingle de l’échantillon ne cite Stable Diffusion, Flux, ComfyUI, LoRA, Hunyuan, Wan ou un autre modèle à poids ouverts. Midjourney [43] et les mentions génériques de « Midjourney/Leonardo AI » [13] s’en approchent le plus, mais restent des produits fermés. Cela constitue un résultat en soi : pour ce thème, le public et l’algorithme de Pinterest penchent vers les « meilleurs outils gratuits » monétisables et le contenu de revenus complémentaires, pas vers les communautés open source et auto-hébergées.
- Très peu de contenu primaire. L’immense majorité des épingles sont des agrégateurs secondaires : listes, vignettes « AI news » et cartes mentales, plutôt que des annonces d’entreprise ou des créations originales. La grille de transfert de style de Luma [28] est la seule qui ressemble à une véritable démonstration produit de première main.
Limites
- La recherche en navigateur sans interface a renvoyé un unique lot plat de 50 épingles pour la requête « Image and Video Generation AI News », sans sous-division par genre : toutes les épingles avaient le genre
"". Le rapport ne peut donc pas comparer des sous-genres définis comme le prévoit le playbook pour d’autres collectes. - Vingt images sur les 50 recueillies ont été lues et décrites en détail, réparties sur l’ensemble de l’index conformément au critère d’environ 20 publications. Les 30 autres n’ont pas été ouvertes individuellement, mais leurs titres, visibles dans
output/pinterest.pins.md, ont été examinés et suivent le même motif de listes et de vignettes d’actualité IA : « best free 15 ai tools » [42], « Latest AI News & Articles » [45], et plusieurs épingles d’images de stock sans titre [5, 10, 22, 25, 29, 33, 48, 49, 50]. - Plusieurs épingles n’ont pas de titre, « (untitled) » ; leurs images non ouvertes pourraient contenir des légendes ou du texte incrusté non récupérés ici.
- Aucun nom de modèle open source — Stable Diffusion, Flux, ComfyUI, Wan ou Hunyuan — n’a été trouvé dans l’échantillon. Il est impossible de dire si cette absence est réelle sur Pinterest ou due à la requête particulière utilisée ; une recherche ciblée sur « open source image generation » pourrait donner un autre échantillon.
- Conformément aux consignes, Pinterest n’a pas été exploré directement et les affirmations n’ont pas été vérifiées au-delà de ce que montrent les images collectées. Plusieurs vignettes d’actualité IA, dont la prétendue fuite Anthropic de [24], font des affirmations impossibles à confirmer à partir de la vignette seule.
Actions recommandées
- Continuer à surveiller la vitesse d’adoption de Wan 3.0 et Qwen-Image 2.1, afin de déterminer si le renversement de qualité entre ouvert et fermé se stabilise.
- Suivre la baisse de prix de Google Veo et le déploiement de Nano Banana 2.5 afin de mesurer l’accélération de la guerre des prix après le retrait de Sora.
- Répertorier les polémiques et cas de dommages liés à l’usurpation par des contenus IA relevés sur Reddit — concours de microscopie, immobilier et licenciement de CEO —, puis suivre leur éventuelle traduction en réglementation ou contentieux.
- Ajouter lors des prochaines collectes sur X et Reddit des mots-clés open source explicites, comme Stable Diffusion, Flux, ComfyUI, Wan et Qwen, afin de combler les omissions de cette fois-ci.
- Ne pas utiliser Pinterest comme indicateur des tendances open source ; le considérer comme une source spécialisée dans la popularité des outils fermés destinés au grand public.
Images collectées

















Note sur la qualité des données
Bluesky a largement dépassé le critère de complétude avec 12 requêtes et plus de 200 publications. Reddit, avec 12 éléments, X, avec 7 à 8 éléments et aucune mention de l’open source en raison du verrouillage régional sur la Croatie, et Lemmy, avec environ 9 éléments, n’ont pas atteint l’objectif d’environ 20. YouTube n’a pas permis de récupérer les vues ni les nombres d’abonnés à cause du rendu JavaScript.