Actualités de l’IA de génération d’images et de vidéos — 2026-10-02
Les modèles open source chinois (Qwen-Image-2.1, Z-Image Turbo) rattrapent les leaders propriétaires, au moment même où la confiance dans les modèles fermés s’érode à cause des garde-fous, des abus et de l’économie de Sora.
Actualités de l’IA de génération d’images et de vidéos — 2026-10-02
Franchement, le secteur de l’IA de génération d’images et de vidéos est en pleine ébullition en ce moment 😤. Les acteurs fermés (GPT Image 2.5 d’OpenAI, Veo 3.1/Nano Banana 2.0 de Google, Kling 2.5, Seedance 2.5, etc.) ne ralentissent pas leur course aux nouvelles fonctionnalités, mais, en parallèle, la confiance s’effondre aussi à cause du durcissement des garde-fous, des deepfakes et des pertes colossales de Sora 💸. De leur côté, les modèles ouverts, notamment chinois comme ceux d’Alibaba (Qwen-Image-2.1, Z-Image Turbo), gagnent vraiment du terrain, tandis qu’une culture du bricolage local autour de ComfyUI est visible sur Reddit, Lemmy et Bluesky 🔥. Cette fois, six plateformes ont été examinées — Reddit, X, YouTube, Bluesky, Lemmy et Pinterest — mais X a été un échec complet ; cela est donc signalé en toute transparence 👇.
Toutes plateformes confondues
- L’open source chinois monte en puissance, souvent présenté comme une « alternative aux modèles fermés » 🇨🇳 Sur YouTube, Z-Image Turbo (6 milliards de paramètres, fonctionne avec 6 Go de VRAM) est présenté comme supérieur à Flux 2 (https://www.youtube.com/watch?v=JF4Q5hXh-_Q), tandis que Qwen-Image-Edit est jugé équivalent ou supérieur à Nano Banana (https://www.youtube.com/watch?v=AIgYj5RG-FQ). Sur Lemmy, une WebUI et des LoRA autour de Qwen-Image-2.1 sont apparus la même semaine (https://github.com/ogoun/fooocus-qwen-image-2.1), et Simon Willison a également testé Qwen-Image sur du matériel réel sur Bluesky (https://bsky.app/profile/simonwillison.net/post/3lvlvsxkzp223). Comme ce phénomène se produit simultanément sur plusieurs plateformes, il semble s’agir d’une véritable tendance.
- Le renforcement des garde-fous fait fuir les utilisateurs 🚪 Sur Reddit, des personnes confrontées aux refus de ChatGPT se tournent vers Midjourney, Grok ou Venice AI (https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/), tandis que le durcissement des filtres de DreamFort.ai pousse vers Seedream Unfiltered ou MiniMax H3 (https://www.reddit.com/r/generativeAI/comments/1wtzefv/). Sur Bluesky, des experts avertissent que les modèles à poids ouverts tels que GLM-5.3 sont presque dépourvus de garde-fous (https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o). Une polarisation entre régulation renforcée et espace sans règles apparaît donc sur plusieurs réseaux.
- La « confiance » dans les outils propriétaires est ébranlée simultanément sous plusieurs angles ⚠️ D’un côté, une enquête de TIME relayée sur Bluesky montre que Veo3 peut créer de fausses vidéos d’un temple hindou en feu (https://bsky.app/profile/amanbatheja.bsky.social/post/3lqpalskjp22h). De l’autre, sur Reddit, Photoshop et Apple Photos seraient susceptibles de qualifier même de simples recadrages de « modifications par IA » et d’en retirer les crédits (https://www.reddit.com/r/mildlyinfuriating/comments/1wsupkx/). Les problèmes diffèrent — abus d’un côté, étiquetage erroné de l’autre — mais tous deux alimentent l’idée que les outils fermés ne sont pas fiables.
- ComfyUI est devenu l’atelier de travail par défaut du monde open source 🛠️ Le même nom revient partout : Reddit (nœud pour MiniMax-H3, https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/), Lemmy (inpainting LanPaint, https://github.com/scraed/LanPaint/), Bluesky (publication quotidienne d’illustrations avec Krea2, https://bsky.app/profile/ria-tatibana.bsky.social/post/3mwtrqf7glc2t) et YouTube (des tutoriels d’installation apparaissent immédiatement à chaque nouveau modèle).
- Les comparaisons côte à côte sont devenues un format incontournable 📊 Titres YouTube du type « WAN 2.5 is Open Source Veo3 », comparaison sur Lemmy de la même double page de Berserk colorisée par quatre modèles (https://www.reddit.com/gallery/1wfyqdy), et graphiques comparatifs néon sur Pinterest indiquant quoi choisir en version payante ou gratuite. Le public s’intéresse davantage à savoir « lequel est le meilleur » qu’aux nouvelles isolées.
- L’idée que la vidéo IA grand public n’est pas rentable est corroborée par plusieurs sources 💰 Sur Bluesky, un post affirme que Sora2 coûterait environ 5 milliards de dollars par an à exploiter pour environ 1,4 million de dollars de revenus (https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o). Sur Lemmy, une analyse indique qu’OpenAI arrête l’API Sora le 24 septembre, tandis que des offres destinées aux entreprises comme Kling lèvent des fonds (https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/).
Plateforme par plateforme
Reddit 🟠 12 fils répartis dans 9 subreddits ont été analysés. Côté fermé, le sujet qui a le plus progressé concerne Seedance 2.5 (via Higgsfield), désormais capable de permettre à une seule personne de réaliser un court-métrage de dix minutes avec des personnages cohérents (784 points, https://www.reddit.com/r/accelerate/comments/1wqqr4p/). Côté ouvert, les nœuds ComfyUI pour MiniMax-H3 ont été décrits comme « les meilleurs nœuds jamais utilisés » (https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/). C’est aussi là que les frustrations liées aux garde-fous apparaissent le plus concrètement.
X ⚫️ Ici, c’est vraiment un coup d’épée dans l’eau 😅. Les 40 posts collectés (33 comptes) ne portaient que sur le football, la K-pop, la politique britannique et des émissions de téléréalité, sans aucun sujet sur la génération d’images ou de vidéos par IA. Les termes de recherche utilisés par le collecteur étaient directement repris des tendances X — « Halloween », « Ronaldo », « #bb28 », etc. — au lieu de mots-clés liés à l’IA. La partie X ne fournit donc aucune information exploitable pour ce rapport.
YouTube 🔴 Du côté fermé, les vidéos sur la fonction « Sketch » de GPT Image 2.5 (https://www.youtube.com/watch?v=LYUr4BY33h4), l’accès gratuit à Veo 3.1 (https://www.youtube.com/watch?v=uj6eD31OxkA) et Nano Banana 2.0 jugé « supérieur à Photoshop » (https://www.youtube.com/watch?v=u22-XoQvI4I) sont apparues au même moment, illustrant la rapidité de la compétition fonctionnelle. Côté ouvert, les tutoriels expliquant comment faire fonctionner FLUX.2, Z-Image et Qwen-Image-Edit dans ComfyUI se multiplient. Attention toutefois : les vues, abonnés et commentaires n’ont pas pu être récupérés en raison du rendu JavaScript ; l’analyse repose uniquement sur les titres et les informations oEmbed.
Bluesky 🔵 L’API AT Protocol a été interrogée directement, et plus de 100 publications réelles ont été examinées. Côté fermé, les problèmes de génération de contenus racistes par Veo3 (❤️842, https://bsky.app/profile/eliothiggins.bsky.social/post/3ls6ridsm4s2y) et l’effondrement économique de Sora2 (❤️1 375) ont largement dominé. Côté ouvert, des comptes de chercheurs tels que Simon Willison et Ethan Mollick se distinguent en testant concrètement Qwen-Image et GLM-5.3. De nombreuses publications quotidiennes autour de ComfyUI + Krea2 ont également été relevées.
Lemmy 🟢 !«メールアドレス» en est le centre, mais les scores restent faibles, généralement entre 1 et 10. Malgré cela, des outils autour de Qwen-Image-2.1 — WebUI, LoRA, ControlNet — ont été publiés en série la même semaine, ce qui témoigne d’un certain élan. Les actualités sur les modèles fermés, comme l’arrêt de l’API Sora ou le retrait après une journée de la fonction Google Earth de Nano Banana 2 pour cause d’abus (https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/), proviennent presque toutes du bot miroir Reddit !ai_reddit ; il n’y a pratiquement pas de débat propre à Lemmy.
Pinterest 🟣 18 pins sur 50 ont été ouverts et vérifiés. Les visuels de synthèse d’actualité centrés sur les acteurs fermés (logos OpenAI/Google/Meta/Grok et visages étonnés) dominent très largement. Côté ouvert, AMD Amuse 3.0 est à peu près le seul outil cité explicitement. Les démonstrations de génération de visages photoréalistes — rides et textures très détaillées — sont utilisées par toutes les entreprises comme images de référence. Les chiffres d’engagement (enregistrements et mentions J’aime) n’ont toutefois pas pu être obtenus, et les pins provenaient uniquement de la collecte préalable du worker.
À surveiller
- La vitesse d’expansion de l’écosystème Qwen-Image-2.1 — WebUI, LoRA et ControlNet ont été publiés en série la même semaine sur Lemmy (https://github.com/ogoun/fooocus-qwen-image-2.1). Il vaut la peine de surveiller les prochaines sorties.
- L’effet des difficultés économiques de Sora2 sur la stratégie d’OpenAI — Le sujet brûle à la fois sur Bluesky (https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o) et sur Lemmy, avec l’arrêt de l’API Sora (https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/).
- La polarisation régulation ↔ absence de règles provoquée par les garde-fous — Reddit (https://www.reddit.com/r/generativeAI/comments/1wtzefv/) et Bluesky (https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o) décrivent la même structure depuis des angles différents.
- FLUX 3 de Black Forest Labs — Ce modèle fermé en accès limité génère des images et des vidéos sonores de 20 secondes, tandis que FLUX.2 est aussi publié en poids ouverts (https://bfl.ai/blog/flux-3). C’est un bon exemple du brouillage de la frontière entre ouvert et fermé.
- La voie basse VRAM de Z-Image / Qwen-Image — Z-Image est présenté sur YouTube comme meilleur que Flux2 (https://www.youtube.com/watch?v=JF4Q5hXh-_Q), ce qui pourrait élargir l’accès à la génération locale.
- La nécessité de réexaminer X — La collecte actuelle a échoué à cause de tendances hors sujet. Une nouvelle recherche avec des mots-clés directs tels que « Midjourney », « Sora » ou « Nano Banana » pourrait révéler des résultats intéressants.
Recommandations
- La prochaine collecte sur X (Twitter) devrait utiliser des mots-clés IA directs comme « Midjourney », « Sora », « Nano Banana », « ComfyUI » et « Flux ».
- La croissance rapide de l’écosystème Qwen-Image-2.1 devrait être suivie en continu comme indicateur clé des tendances open source.
- Le rapport entre coûts d’exploitation et revenus de Sora2 devrait être suivi comme indicateur de rentabilité pour l’ensemble des modèles fermés de génération vidéo.
- Les départs d’utilisateurs liés aux garde-fous devraient être cartographiés en continu : de quels outils partent-ils et vers quels outils se tournent-ils ?
- Pinterest devrait soit étendre l’échantillonnage aux 50 images, soit explorer une autre méthode pour obtenir les données d’engagement.
- Compte tenu de la dépendance de Lemmy à !ai_reddit, qui republie essentiellement Reddit, les voix propres à Lemmy devraient être recherchées principalement dans les communautés !stable_diffusion.
Qualité des données
Les données X étaient entièrement sans rapport avec le sujet de recherche, à cause d’une collecte erronée depuis l’onglet Tendances, et n’ont rien apporté cette fois. Sur YouTube, le rendu JavaScript a empêché de vérifier les vues, dates de publication, nombres d’abonnés et commentaires ; l’analyse se limite aux titres et aux informations oEmbed. Sur Pinterest, seules 18 images sur 50 ont été vérifiées visuellement, et les données d’engagement (enregistrements/mentions J’aime) n’étaient pas accessibles. Les publications Lemmy ont bien été vérifiées, mais leurs scores restent globalement faibles, de 0 à 10, et l’intensité des échanges y est moindre que sur les autres plateformes. Reddit et Bluesky reposent sur des données réelles collectées et offrent donc une fiabilité relative plus élevée.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
9 subreddits ont porté ce thème dans le jeu de données collecté (12 fils au total, tous trouvés avec l’unique terme de recherche « Image and Video Generation AI News ») :
- r/generativeAI — 159 938 membres — 3 fils (#1, #2, #7)
- r/TopologyAI — 24 052 membres — 1 fil (#3)
- r/StableDiffusion — 1 027 672 membres — 1 fil (#4)
- r/LocalLLaMA — 838 632 membres — 1 fil (#5)
- r/AI_Agents — 452 911 membres — 1 fil (#6)
- r/accelerate — 93 680 membres — 2 fils (#8, #12)
- r/aifails — 39 194 membres — 1 fil (#9)
- r/VideoEditors — 81 700 membres — 1 fil (#10)
- r/mildlyinfuriating — 12 610 232 membres — 1 fil (#11)
Ce que disent les gens
- La génération vidéo « gratuite » à partir de modèles fermés est un mythe, selon le consensus de la communauté — Fil #1, r/generativeAI, 71 points, 46 commentaires, 2026-09-30 (https://www.reddit.com/r/generativeAI/comments/1wty6zj/). L’auteur du post soutient que les coûts des GPU cloud rendent impossible une génération vidéo illimitée réellement gratuite ; u/opengradient confirme : « les vidéos ne sont pas comme les LLM bon marché, personne ne peut les offrir gratuitement » (5 points).
- Le filtrage NSFW des modèles fermés se durcit, poussant les utilisateurs vers des alternatives ouvertes ou non filtrées — Fil #2, r/generativeAI, 7 points, 14 commentaires, 2026-09-30 (https://www.reddit.com/r/generativeAI/comments/1wtzefv/). DreamFort.ai a renforcé les filtres de son offre fondée sur WAN 3.0 ; u/opengradient observe que « beaucoup de fournisseurs de modèles fermés ont récemment instauré des contrôles plus stricts, y compris Alibaba, qui possède Wan 3.0 » et renvoie vers Seedream 2.0 Unfiltered et MiniMax H3.
- Un flux de travail open source + Blender 3D est présenté comme la solution au contrôle de la génération vidéo, mais la communauté doute de sa réalité — Fil #3, r/TopologyAI, 437 points, 19 commentaires, 2026-09-28 (https://www.reddit.com/r/TopologyAI/comments/1wsmvvm/). Malgré le score élevé, les meilleurs commentaires sont surtout des questions confuses (« De quelle “IA 3D” s’agit-il ? » — u/stevester911, 5 points) et un rejet direct de u/amon_de_no : « C’est une fausse vraie IA » (5 points).
- Les outils open source de cohérence par référence pour MiniMax-H3 sont extrêmement bien accueillis — Fil #4, r/StableDiffusion, 690 points, 51 commentaires, 2026-09-30 (https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/). Un nœud ComfyUI gratuit (Fantastic-MiniMaxH3-PromptBuilder) a résolu les fuites d’identité dans les retouches vidéo à partir d’images de référence ; u/ClassicUse2579 : « Le chargeur média H3 est l’un des meilleurs nœuds Comfy que j’aie jamais utilisés. Il est vraiment excellent ! » (3 points).
- Les piles locales open source pour l’image et le chat sont assez mûres pour servir d’attraction amusante — Fil #5, r/LocalLLaMA, 194 points, 96 commentaires, 2026-10-01 (https://www.reddit.com/r/LocalLLaMA/comments/1wuxzdg/). Un Tandy 1000 des années 1990 est piloté en Wi-Fi par Qwen3.8-27B + Krea 2 (ComfyUI) exécutés localement, pour le chat et la génération d’images. Le meilleur commentaire relativise toutefois la présentation : u/Aggravating-Push-207 (113 points) : « Cela ne tourne pas sur le Tandy ; il envoie simplement des requêtes sur votre réseau domestique. »
- Les garde-fous des modèles fermés frustrent suffisamment les utilisateurs occasionnels pour les faire changer d’outil — Fil #6, r/AI_Agents, 0 point, 22 commentaires, 2026-09-29 (https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/). Un utilisateur ne parvient pas à faire générer un super-héros par ChatGPT en raison des refus des garde-fous ; les commentaires le redirigent vers Midjourney, Grok, VeniceAI et des modèles ouverts « uncensored sdxl ».
- Dans le segment gratuit ou peu coûteux, les outils fermés à crédits quotidiens dominent encore les recommandations grand public — Fil #7, r/generativeAI, 4 points, 59 commentaires, 2026-09-26 (https://www.reddit.com/r/generativeAI/comments/1wqfleb/). Les recommandations se divisent : u/Scuzzy_Womack conseille ComfyUI hors ligne (3 points, ouvert), tandis que d’autres recommandent Yodayo/MoescapeAI et Leonardo pour leurs crédits quotidiens gratuits (fermés).
- La vidéo fermée (Seedance 2.5 via Higgsfield) est désormais suffisamment bonne pour un court récit de dix minutes réalisé par une seule personne — Fil #8, r/accelerate, 784 points, 196 commentaires, 2026-09-26 (https://www.reddit.com/r/accelerate/comments/1wqqr4p/). Des références de fiches personnages alimentent chaque plan afin de garder Captain Walker cohérent d’une scène à l’autre ; u/JoseLunaArts (95 points) estime que le cadrage « sans budget » minimise les coûts en jetons, et u/Nabugu (7 points) relève l’uniformité récurrente du « beau visage IA ».
- La génération d’images échoue encore de manière absurde et digne de mèmes — rejetée comme divertissement, non comme tendance — Fil #9, r/aifails, 526 points, 76 commentaires, 2026-09-28 (https://www.reddit.com/r/aifails/comments/1ws6jzs/). Un prompt sur l’anatomie d’un poulet a produit un résultat incohérent ; meilleur commentaire de u/kasimirvendom : « Tout a une fin, seul un poulet en a deux » (52 points).
- Il est explicitement conseillé aux monteurs vidéo de ne pas encore s’appuyer sur les outils IA — Fil #10, r/VideoEditors, 4 points, 39 commentaires, 2026-09-26 (https://www.reddit.com/r/VideoEditors/comments/1wqkx27/). Le meilleur commentaire (u/VisibleExplanation, 33 points) : « Oubliez les outils IA. Téléchargez DaVinci Resolve et apprenez à l’utiliser... Aucun outil IA ne vous donnera de bons résultats sans une connaissance fondamentale des bases. »
- Le fait que des outils de retouche fermés requalifient discrètement des modifications mineures en « IA générative » suscite un rejet fondé sur la confiance — Fil #11, r/mildlyinfuriating, 1 268 points, 136 commentaires, 2026-09-28 (https://www.reddit.com/r/mildlyinfuriating/comments/1wsupkx/). Photoshop/Apple Photos marqueraient de simples recadrages comme édités par IA et supprimeraient l’attribution de copyright ; u/Kagevjijon (41 points) : « Il n’est pas possible que cela reste ainsi. C’est du vol pur et simple. » Une objection est formulée par u/teh_maxh (135 points) : « Je viens d’essayer de recadrer une image avec Photoshop, et aucune métadonnée n’a été ajoutée pour dire que j’avais utilisé une IA générative. »
- Les mods de jeux générés par IA, ouverts et portés par les communautés, connaissent un moment fort — Fil #12, r/accelerate, 193 points, 35 commentaires, 2026-09-30 (https://www.reddit.com/r/accelerate/comments/1wuhyiw/). u/Chopstik0-0 (38 points) décrit comment le subreddit de modding VR est passé de la résistance à l’enthousiasme lorsqu’il est devenu évident que « personne d’autre ne crée vraiment de nouveaux jeux VR ».
Signaux
- En hausse : les outils open source de cohérence par référence (le nœud ComfyUI du fil #4, la pile locale Qwen+Krea2 du fil #5) suscitent les réactions les plus clairement positives du corpus : scores élevés et commentaires techniques réellement enthousiastes, au-delà du simple battage médiatique.
- En hausse : la génération vidéo fermée a franchi le seuil du récit long format — le court-métrage de dix minutes avec personnages récurrents cohérents du fil #8 est le fil le plus engageant recueilli (784 points, 196 commentaires), et les critiques de la communauté visent le scénario et le jeu vocal, non les visuels.
- Rejeté : l’idée d’un générateur vidéo fermé réellement gratuit est considérée comme réglée et quelque peu lassante (fil #1) ; le débat s’est déplacé de « quel site gratuit ? » vers « quelle configuration locale open source ? ».
- Désaccord : le fil #3 montre un décalage entre l’enthousiasme de surface (437 points) et le scepticisme ou la confusion dans les commentaires sur ce qui est réellement présenté. Les posts vagues sur les flux de travail « IA 3D » peuvent accumuler des points sans que personne ne s’accorde sur l’outil montré.
- Surprise — les garde-fous sont désormais un moteur récurrent de changement de plateforme, et non une simple nuisance : le fil #2 sur le durcissement du filtrage NSFW fermé, comme le fil #6 sur les garde-fous de ChatGPT empêchant une image non explicite de super-héros, montrent des utilisateurs abandonnant un outil fermé précisément à cause de la modération. Ils se tournent alors vers un autre outil fermé (Grok, VeniceAI) ou un outil ouvert (Seedream Unfiltered, SDXL non censuré).
- Surprise — dans le fil #11, le rejet des outils fermés n’a rien à voir avec les filtres de contenu : il concerne l’attribution et les métadonnées — l’étiquetage automatique de retouches ordinaires comme « IA générative » et la suppression des informations de copyright — une plainte distincte de la frustration envers les garde-fous ailleurs dans le corpus.
Limites
- Le collecteur n’a utilisé qu’un seul terme de recherche (« Image and Video Generation AI News »), faisant remonter 12 fils dans 9 subreddits — moins que l’objectif d’environ 20 posts par réseau fixé dans les critères d’achèvement. Conformément au protocole, seul le contenu déjà collecté par le worker (
output/reddit.threads.md) a été lu ; Reddit n’a pas été parcouru directement pour compléter, car Reddit bloque WebFetch et les pages atteintes par recherche web. - Les fils #9, #11 et #12 ne contenaient pas de texte d’ouverture capturé, seulement leur titre ; ces constats reposent donc entièrement sur les commentaires et les scores.
- Aucun fil ne faisait spécifiquement remonter de grandes annonces de laboratoires fermés, comme le lancement d’un modèle nommé par OpenAI, Google ou Midjourney. Le corpus recueilli privilégie les retours d’expérience, les outils et les frictions liées aux garde-fous plutôt que les annonces produit.
X
X — Actualités de l’IA de génération d’images et de vidéos
Comptes
Aucun compte dans les données collectées ne parle d’IA de génération d’images ou de vidéos, qu’elle soit fermée ou open source. Les 33 comptes capturés ici (@Davesonude, @rcostadoazeite, @ChrisExcel102, @Louissaikyoo, @DlugoszMarcin, @khtaeverse et 27 autres) sont des comptes de mèmes sportifs, de fans de K-pop, de fans de Big Brother (#BB28), de politique britannique (Restore Britain) et de mèmes ou shitposts généralistes. Aucun ne traite des outils d’image ou de vidéo IA comme sujet principal ; il n’y a donc aucun « acteur qui mène le débat sur X » à signaler pour le thème réel de la recherche — voir ## Limites.
Publications
Aucune publication dans output/x.posts.md (40 posts, 33 comptes) ne fait référence à la génération d’images par IA, à la génération vidéo par IA, ni à un produit, une entreprise ou un projet open source associé (aucune mention de Midjourney, Sora, Stable Diffusion, Flux, Runway, Veo, Nano Banana, ComfyUI ou équivalent). La vérification ponctuelle des posts les plus engagés le confirme :
- Post #7, @Davesonude, ~291 000 vues, 22 958 mentions J’aime (2026-09-30),
https://x.com/Davesonude/status/2105273235965370529 — un mème de football sur Ronaldo. Trouvé en recherchant « Ronaldo ». - Post #19, @ChrisExcel102, ~343 000 vues, 7 886 mentions J’aime (2026-09-29),
https://x.com/ChrisExcel102/status/2104913863200096350 — un mème sur une relation de célébrités. Trouvé en recherchant « JubJub ». - Post #26, @Louissaikyoo, ~185 000 vues, 10 292 mentions J’aime (2026-09-30),
https://x.com/Louissaikyoo/status/2105090778766696620 — une blague de culture générale sur Disney Channel. Trouvé en recherchant « China ». - Post #36, @DlugoszMarcin, ~189 000 vues, 2 937 mentions J’aime (2026-09-30),
https://x.com/DlugoszMarcin/status/2105363575145394223 — un commentaire de football (Messi/Lewandowski/Ronaldo/Modrić). Trouvé en recherchant « Messi ».
Aucun de ces posts, ni aucun des 36 autres, ne touche au thème de la recherche. Il serait inapproprié de lister 5 à 12 « constats » sur la génération d’images ou de vidéos par IA, car aucun n’existe dans les données collectées ; le faire reviendrait à les inventer, ce que le protocole de cette analyse interdit explicitement.
Signaux
Aucun signal sur l’IA de génération d’images ou de vidéos, ouverte ou fermée, ne peut être déduit de ce jeu de données. Ce qu’il montre en revanche : les dix termes utilisés pour la collecte (« Halloween », « Ronaldo », « Britain », « Yess », « JubJub », « Gold », « China », « #bb28 », « Messi », « Balkans ») sont les sujets tendances de l’onglet Explore de X pour cette session, et non des thèmes liés à la génération de médias par IA. Le tableau Explore de output/x.posts.md le confirme : 6 des 10 tendances portent explicitement le libellé « Trending in Croatia », et les autres (« Ronaldo », « Britain », « China », « Messi ») sont des sujets mondiaux de sport ou de politique — aucun n’est lié à l’IA ou à la technologie. Il s’agit manifestement d’un décalage lors de la collecte : le worker a récupéré ce que X indiquait comme tendance au lieu de rechercher des termes de génération d’images ou de vidéos par IA. Les 40 posts obtenus portent donc sur le football, un parti politique britannique (Restore Britain), un conflit de fandom K-pop, une saison de téléréalité (#BB28) et des mèmes sans rapport.
Limites
- Les données collectées ne répondent pas au cahier des charges de recherche. Celui-ci demande des actualités sur l’IA de génération d’images et de vidéos, fermée et open source ; les dix termes employés par le worker étaient des tendances génériques de X pour cette session — principalement géolocalisées en Croatie selon le tableau Explore — et non des requêtes liées à l’IA. Les 40 posts ont été relus manuellement au regard du thème, et aucun ne convient.
- Conformément au protocole de cette étape, X n’a pas été parcouru directement, car un lecteur anonyme n’y voit rien ; l’analyse repose uniquement sur
output/x.posts.md/output/x.posts.jsontels qu’ils ont été collectés. - Bien que le critère de volume (« analyser environ 20 posts par réseau social ») soit atteint avec 40 posts, il ne l’est pas en pertinence. L’étape X devrait être relancée avec des termes comme « Midjourney », « Sora », « Stable Diffusion », « Flux », « Runway », « Veo », « Nano Banana », « ComfyUI » ou des requêtes similaires, à la place des tendances génériques utilisées ici.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos (fermée/open source)
Chaînes
- AI WITH Rithesh (Rithesh Sreenivasan) — chaîne individuelle qui teste le jour même les sorties liées à ChatGPT/OpenAI.
- Bart Slodyczka — chaîne qui résume les changements juste après la sortie de nouveaux modèles.
- Learn with LEESI — chaîne spécialisée dans les tutoriels autour de Google Gemini/Veo/Flow.
- WorldofAI(@intheworldofai) — chaîne qui passe en revue les actualités hebdomadaires sur l’IA propriétaire.
- MattVidPro — grande chaîne IA réputée pour les comparaisons et les actualités rapides sur les modèles de génération vidéo.
- There's An AI For That(@theresanaiforit) — chaîne d’actualités et de comparaisons de nouveaux modèles.
- Promptus AI(@promptusai) — chaîne spécialisée dans les tutoriels d’installation locale de modèles open source d’images et de vidéos.
- AI Late to Class(@ailatetoclass) — chaîne de tests de modèles open source de retouche d’images.
- MaxonShire — chaîne spécialisée dans les comparaisons de modèles vidéo locaux (HunyuanVideo, Wan, LTX, etc.).
- smallzero(@webdot3) — chaîne consacrée à l’utilisation de modèles open source dans ComfyUI (dont Z-Image).
- FlyMyAI — publie des bulletins quotidiens ou hebdomadaires d’actualité IA.
- Lev Selector(@lev-selector) — chaîne de synthèses hebdomadaires sur les mises à jour IA.
Le nombre d’abonnés n’a pas pu être vérifié directement, car le HTML des résultats de recherche YouTube est rendu en JavaScript (voir Limites).
Vidéos
Source fermée
- « ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked! » — AI WITH Rithesh / début septembre 2026 — Test de GPT Image 2.5, lancé par OpenAI le 8 septembre 2026, avec la nouvelle fonction de génération depuis croquis « Sketch » et une vitesse de génération améliorée jusqu’à 50 %. https://www.youtube.com/watch?v=LYUr4BY33h4
- « ChatGPT Image 2.5 Just Dropped — Here's Everything That's New » — Bart Slodyczka / septembre 2026 — Présentation complète des nouvelles fonctions de GPT Image 2.5. https://www.youtube.com/watch?v=dvpQHWwuaIo
- « Google Just Made VEO 3.1 FREE for Everyone with Unlimited AI Video Generation » — Learn with LEESI — Présente l’ouverture gratuite de Veo 3.1, avec prise en charge de l’image-vers-vidéo et de trois images de référence, via Google Flow/Vids. https://www.youtube.com/watch?v=uj6eD31OxkA
- « Google's Nano Banana 2.0: Best Text-To-Image Generation Model EVER! The Photoshop killer! » — WorldofAI — Test de Nano Banana 2.0 de Google DeepMind, un modèle de génération d’images de la famille Gemini, présenté comme supérieur à Photoshop. https://www.youtube.com/watch?v=u22-XoQvI4I
- « Kling 2.5 goes BEAST MODE for AI Video! » — MattVidPro — Rapporte une forte progression de Kling 2.5 dans le dynamisme des mouvements. https://www.youtube.com/watch?v=SGUxHC1cI1c
- « AI Video Models Are Getting Out of Control! (WAN 2.5, Kling 2.5, Wanimate) » — MattVidPro — Compare côte à côte Kling, fermé, et Wan, ouvert, et souligne l’intensification de la concurrence. https://www.youtube.com/watch?v=vFXe3uXb75k
- « Your AI news brief for September 3, 2026. » — FlyMyAI — Bulletin d’actualité IA générale au 3 septembre 2026, incluant des sujets de génération d’images et de vidéos. https://www.youtube.com/watch?v=JK6w9tA2jH8
- « Exciting AI Updates Weekly - September 25, 2026 » — Lev Selector — Synthèse hebdomadaire des mises à jour IA récentes, incluant des modèles de génération d’images et de vidéos. https://www.youtube.com/watch?v=iyZHPCNd8jI
Open source
- « Is FLUX 2.0 The New Open Source King? » — There's An AI For That — Évalue FLUX.2 de Black Forest Labs comme un sérieux candidat au titre de meilleur modèle à poids ouverts pour la génération et l’édition d’images. https://www.youtube.com/watch?v=YQuTkPVkCS8
- « New Open-Source Model DESTROYS Flux 2 — Z-Image + Promptus Tutorial »(le titre oEmbed est « Z-Image Open-Source Image Generator: Free Online and Local Setup ») — Promptus AI — Présente Z-Image Turbo de Tongyi-MAI, filiale d’Alibaba, un modèle de 6 milliards de paramètres fonctionnant avec 6 Go de VRAM, comme supérieur à Flux 2. https://www.youtube.com/watch?v=JF4Q5hXh-_Q
- « Z-Image Full Release: The New King of AI Influencers in ComfyUI? » — smallzero — Teste dans ComfyUI la sortie complète non distillée de Z-Image (Base). https://www.youtube.com/watch?v=ClVY5ll1sDU
- « Qwen Image 2.1 best open source Image Editor. Better than Nano Banana » — AI Late to Class — Évalue la dernière version d’Alibaba Qwen-Image-Edit, prenant en charge dix images de référence, les arrière-plans transparents et des performances accrues, comme équivalente ou supérieure à Nano Banana. https://www.youtube.com/watch?v=AIgYj5RG-FQ
- « HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model? » — MaxonShire — Compare HunyuanVideo 1.5 de Tencent et Wan 2.7 d’Alibaba comme modèles locaux de génération vidéo. https://www.youtube.com/watch?v=4GNT4-QYekg
Signaux
- Les modèles fermés rivalisent par la rapidité des ajouts de fonctionnalités : OpenAI (GPT Image 2.5 et « Sketch », le 08/09/2026), Google (ouverture gratuite de Veo 3.1 et intégration à Google Vids/Flow) et Kling 2.5 publient des mises à jour presque au même moment, ce qui maintient une compétition au rythme mensuel.
- Le camp open source est porté par les acteurs chinois, notamment Alibaba Tongyi-MAI et Qwen : Z-Image Turbo et Qwen-Image-Edit sont régulièrement mis en avant pour leur fonctionnement avec peu de VRAM, autour de 6 Go, et pour une qualité comparable à Nano Banana. La comparaison directe avec FLUX.2 de Black Forest Labs est devenue habituelle.
- Les comparaisons « ouvert vs fermé » sont devenues un genre à part entière : les titres tels que « WAN 2.5 is Open Source Veo3 » ou « Z-Image vs Flux 2 » sont très fréquents et présentent les modèles open source comme des alternatives aux modèles fermés.
- Les tutoriels d’exécution locale dans ComfyUI (Promptus AI, MaxonShire, smallzero) constituent le principal format de contenu pour l’open source : dès qu’un modèle sort, une vidéo expliquant son installation dans ComfyUI apparaît rapidement.
- Les chaînes de bulletins IA hebdomadaires ou quotidiens (FlyMyAI, Lev Selector) couvrent continuellement la génération d’images et de vidéos ; les nouvelles sur les modèles individuels se diffusent également via ces formats réguliers.
Limites
- Les pages de résultats YouTube (
youtube.com/results?search_query=...) et les pages vidéo (youtube.com/watch?v=...) étant rendues en JavaScript, WebFetch n’a pas pu récupérer directement les listes de vidéos ni le contenu des pages, comme les vues, dates de publication, nombres d’abonnés ou commentaires. Les titres et noms de chaînes ont été vérifiés individuellement avec l’endpointyoutube.com/oembed(JSON), et le contexte ou les périodes de publication ont été complétés par les extraits de recherche web et des articles connexes. - Par conséquent, les nombres exacts de vues, les dates de publication et les nombres d’abonnés de chaque vidéo n’ont pas pu être confirmés. Certains résultats affichaient une date relative de type « il y a X jours », mais nombre d’entre eux dataient de plus de 300 jours, au-delà de la fenêtre récente de 60 jours. Le rapport privilégie donc les sujets dont la période dans les 60 jours est clairement établie, comme GPT Image 2.5, le 08/09/2026, et les bulletins hebdomadaires dont la date est explicite.
- L’existence de vidéos liées à Runway Gen-4.5, Grok Imagine, Seedream 4.0 et Midjourney V8 a été constatée, mais il n’a pas été possible d’obtenir suffisamment d’informations pour confirmer leur période de publication ou les détails des chaînes ; elles ne sont donc pas incluses dans la section Vidéos.
- Les commentaires n’ont pas été analysés, car le contenu des pages vidéo n’était pas accessible.
Bluesky
Bluesky — Actualités de l’IA de génération d’images et de vidéos (fermée/open source)
Méthode d’enquête : le site officiel de Bluesky (bsky.app) est une SPA qui ne permet pas de rendre les résultats de recherche ; l’API publique AT Protocol (https://api.bsky.app/xrpc/app.bsky.feed.searchPosts, sans authentification) a donc été interrogée directement pour obtenir des données réelles — texte, auteur, nombre de mentions J’aime et date. Des recherches sur « Nano Banana », « Sora 2 », « Flux », « ComfyUI », « Z-Image », « Qwen Image », « open weights », « Veo 3 » et d’autres mots-clés ont permis d’examiner plus de 100 publications, dont une sélection pertinente est présentée ci-dessous.
Comptes
- Eliot Higgins(
eliothiggins.bsky.social, fondateur de Bellingcat, vérifié sur Bluesky) — communique régulièrement sur les risques de désinformation et de deepfakes liés à Veo 3. - Simon Willison(
simonwillison.net, chercheur indépendant en IA, vérifié sur Bluesky) — exécute réellement en local des modèles à poids ouverts tels que Qwen-Image et Qwen-Image-Edit, et publie des notes techniques. - Ethan Mollick(
emollick.bsky.social, professeur à Wharton, vérifié sur Bluesky) — commente régulièrement les capacités et les risques des modèles à poids ouverts. - Journalistes de 404 Media (Jason Koebler
jasonkoebler.bsky.social, Sam Colesamleecole.bsky.social) — enquêtent sur les problèmes de droits d’auteur et de modération de contenu de Sora 2. - obeca(
obeca.bsky.social, communauté turcophone) — compte individuel publiant presque chaque jour des images générées avec Nano Banana 2. - Ria_Tatibana(
ria-tatibana.bsky.social, communauté japonaise) — publie quotidiennement des illustrations avec ComfyUI + Krea2, un modèle open source. - cubby.jpg(
cubby-ai.bsky.social) — compte produisant en masse des œuvres d’art IA avec des modèles d’images open source tels que Z-Image et Qwen-Image. - AlternativeTo(
alternativeto.net) — compte automatisé de nouvelles logicielles qui signale rapidement les sorties de modèles comme Qwen-Image-2.1.
Publications
Source fermée
- Le problème selon lequel Google Veo 3 peut générer du contenu raciste — Eliot Higgins, 2025-06-22, ❤️842. « Google Veo 3 providing new and exciting ways to do racism. » https://bsky.app/profile/eliothiggins.bsky.social/post/3ls6ridsm4s2y
- TIME réussit à créer avec Veo 3 de fausses vidéos de musulmans incendiant un temple hindou, entre autres ; Google a ajouté un filigrane visible après avoir été interrogé — Aman Batheja, journaliste de TIME, 2025-06-03, ❤️431 · 🔁192 · citations 107. « New: TIME reporters were able to use Google's AI video tool to make convincing videos of Muslims setting fire to a Hindu temple... » https://bsky.app/profile/amanbatheja.bsky.social/post/3lqpalskjp22h
- Sora 2 coûterait environ 5 milliards de dollars par an à exploiter et n’aurait généré qu’environ 1,4 million de dollars de revenus — Peter Labuza, 2026-02-10, ❤️1 375 · 🔁368 · citations 192. « Sora 2 apparently cost something like $5 billion to run every year and so far made OpenAI around $1.4 million. » https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o
- Sora symboliserait l’effondrement de la prétention des entreprises d’IA à ne pas s’entraîner sur des œuvres protégées par le droit d’auteur — Jason Koebler, 404 Media, 2025-10-01, ❤️1 508 · citations 44. « The Sora thing is so bleak and shows how far we've come from AI companies pretending they did not train on copyrighted material » https://bsky.app/profile/jasonkoebler.bsky.social/post/3m25uzxbcak23
- Les utilisateurs se seraient fortement emportés lorsque Sora 2 a interdit la génération de personnages protégés par le droit d’auteur — Sam Cole, 404 Media, 2025-10-08, ❤️435 · citations 37. « the only thing people want to do on Sora, it seems, is generate images of copyrighted characters. now that they can't, they're crashing the fuck out » https://bsky.app/profile/samleecole.bsky.social/post/3m2ovizmqks2t
- Témoignage d’une personne trompée par une image générée de la famille Nano Banana (2) — furuakasaber.bsky.social, 2026-07-03, ❤️333. « This Nano Banana bullshit fooled me even tho I felt that it was something off about it. Kinda scary » https://bsky.app/profile/furuakasaber.bsky.social/post/3mpr6djkzsk2e
- Fatigue envers les infographies Nano Banana, jugées artificielles — garrison.corporate.fm, 2026-03-15, ❤️73 · 🔁9. « nano banana infographics must be stopped at any cost » https://bsky.app/profile/garrison.corporate.fm/post/3mh4g5avqp22p
Open source
- Alibaba Qwen publie Qwen-Image, son premier modèle de génération d’images, sous licence Apache 2.0 — Simon Willison, 2025-08-04, ❤️46. « Qwen released their first image generation model today, Qwen-Image - it's Apache 2.0 like their LLMs » https://bsky.app/profile/simonwillison.net/post/3lvlvsxkzp223
- Test réel de Qwen-Image-Edit : presque toute la RAM de 64 Go d’un Mac consommée et 54 Go d’espace disque nécessaires — Simon Willison, 2025-08-19, ❤️77. « Notes on running the new Qwen-Image-Edit model on my Mac...It took almost ALL of my 64GB of RAM and needed 54GB of disk space » https://bsky.app/profile/simonwillison.net/post/3lws3xfzhv22u
- Alibaba publie Qwen-Image-2.1, un modèle à poids ouverts de 7 milliards de paramètres, avec un changement de licence — AlternativeTo, 2026-09-24, ❤️6. « Alibaba Cloud has released Qwen-Image-2.1, a 7B parameter model...there's a license change. » https://bsky.app/profile/alternativeto.net/post/3mwaq75byhn2a
- Apple publie les poids ouverts de STARFlow et STARFlow-V, des modèles autoregressifs de flux Transformer pour la génération d’images et de vidéos — Sung Kim, 2025-12-02, ❤️13. « Apple released the open-weights of both STARFlow and STARFlow-V, state-of-the-art transformer autoregressive flow models for high-quality image and video generation. » https://bsky.app/profile/sungkim.bsky.social/post/3m6xsab2zj22w
- Avertissement : GLM-5.3, modèle à poids ouverts, est performant mais presque dépourvu de garde-fous et possède même des capacités cyber offensives — Ethan Mollick, 2026-08-28, ❤️88. « Open weights models have effectively no guardrails, and they only provide minimal risk testing » https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o
- Publications quotidiennes d’illustrations avec ComfyUI + Krea2, un modèle d’images open source, obtenant 50 à 80 ❤️ par post — Ria_Tatibana, plusieurs posts du 2026-09-28 au 10-01 (exemple : https://bsky.app/profile/ria-tatibana.bsky.social/post/3mwtrqf7glc2t, ❤️53). Les résultats de recherche pour ComfyUI sont principalement occupés par le partage quotidien d’œuvres d’illustrateurs IA.
- Attentes et ironie autour de la sortie de Z-Image, modèle léger open source d’Alibaba Tongyi — theophite.bsky.social, 2025-11-27, ❤️30. « not looking forward to the release of z-image » https://bsky.app/profile/theophite.bsky.social/post/3m6ldsilaz22f
Signaux
- Veo 3 s’est imposé comme un « outil de désinformation » : Eliot Higgins, fondateur de Bellingcat, le souligne régulièrement, et l’enquête de TIME a été largement relayée (❤️431, 107 citations). Le principal enjeu de la génération vidéo fermée s’est déplacé de la qualité vers les abus.
- Sora 2 connaît à la fois des difficultés économiques et des controverses persistantes : le chiffre de 5 milliards de dollars de coûts annuels contre 1,4 million de dollars de revenus (❤️1 375) a fortement circulé. Le renforcement des restrictions sur les personnages protégés par le droit d’auteur a provoqué une vive réaction des utilisateurs (❤️435), illustrant à répétition le schéma « changement des règles d’un modèle fermé → colère des utilisateurs ».
- Nano Banana de Google est devenu l’outil de génération d’images par défaut pour les utilisateurs grand public : des comptes individuels tels qu’obeca.bsky.social publient des images générées presque quotidiennement, y compris dans des communautés non anglophones, turcophones ou japonophones. Le sentiment que ces images sont difficiles à distinguer et donc inquiétantes reste toutefois fort (❤️333).
- La génération d’images open source se concentre techniquement autour de la famille Qwen-Image : des chercheurs IA comme Simon Willison réalisent des tests pratiques, jusqu’à relever la consommation de VRAM et de disque, et la licence Apache 2.0 est bien accueillie. Cependant, Qwen-Image-2.1 introduit un changement de licence, ce qui maintient une tension sur la question de savoir si le modèle est réellement ouvert.
- ComfyUI demeure le flux de travail de facto de la génération d’images open source : la plupart des résultats de recherche concernent des partages quotidiens d’illustrations réalisées avec ComfyUI et un modèle précis, comme Krea2 ou SDXL. Il ne s’agit plus seulement d’un outil technique, mais d’un outil intégré aux pratiques quotidiennes.
- Les modèles à poids ouverts sont vus comme très puissants mais dépourvus de garde-fous, et des experts tirent la sonnette d’alarme : des comptes de chercheurs reconnus, comme celui d’Ethan Mollick, évoquent les capacités offensives et le faible niveau des tests de risque des modèles comme GLM-5.3. De grandes entreprises comme Apple, avec STARFlow, rejoignent elles aussi la publication de poids ouverts, ce qui élargit le camp open source.
Limites
- Le site officiel de Bluesky, bsky.app, est une SPA et ne permettait pas de récupérer directement le texte via WebFetch ; l’endpoint de recherche de
public.api.bsky.apprenvoyait aussi une erreur 403. L’API identique deapi.bsky.app, sans « public. », répondait en revanche sans authentification et a donc été utilisée pour récupérer des données réelles. - Les mots-clés génériques ou ambigus comme « Flux », « Kling » ou « Wan », qui entrent en collision avec des termes relevant de jeux, de météo ou de noms de personnes, produisent beaucoup de bruit. Ils n’ont pas permis de collecter suffisamment de publications pertinentes : sur 15 résultats pour Flux, pratiquement aucun ne concernait la génération d’images. Les sujets spécifiques à FLUX.2 de Black Forest Labs n’ont pas produit suffisamment de publications sur Bluesky.
- Les noms individuels de modèles vidéo comme Kling 2.5, Wan 2.5, HunyuanVideo et Seedance n’ont pas généré assez de résultats avec les mots-clés utilisés ; leur présence dans les discussions Bluesky n’a donc pas pu être établie. D’autres plateformes, comme YouTube, pourraient être plus actives.
- Même avec
sort=top, l’API de recherche ne fournit pas nécessairement un véritable classement par popularité ; le parcours par curseur a fait apparaître des dates mélangées. Les publications représentatives sont donc une sélection fondée sur leur pertinence et leur existence vérifiée, non un classement strict de popularité.
Lemmy
Lemmy — Évolutions de l’IA de génération d’images et de vidéos (fermée/open source)
Communautés
- !«メールアドレス» — principale communauté pour les sorties de nouveaux modèles et outils open source. Les publications sont fréquentes, mais les scores restent généralement entre 1 et 10, ce qui reflète une petite échelle.
- !«メールアドレス» / !«メールアドレス» — communautés alimentées automatiquement via Civitai, publiant chaque jour des images générées avec Krea, des modèles SDXL et autres. Leur valeur d’actualité est faible, mais elles attestent d’un usage quotidien des modèles open source.
- !«メールアドレス» / !«メールアドレス» — communautés d’exemples d’art abstrait qui republient les mêmes images.
- !«メールアドレス» — communauté automatisée qui reflète des sous-reddits IA. Elle est la principale source d’actualités sur les modèles fermés, notamment Sora, Nano Banana et Seedream, mais les scores sont presque toujours de 0 à 1 et les discussions sont quasiment absentes.
- !«メールアドレス» / !«メールアドレス» / !tech — communautés où apparaissent ponctuellement des nouvelles, par exemple autour de FLUX de Black Forest Labs.
- !«メールアドレス» / !casual_perchance — communautés d’utilisateurs de Perchance.org, service gratuit de génération d’images dans le navigateur.
- Les nombres d’abonnés n’ont pu être obtenus pour aucune communauté, car les pages Lemmy.world (
/c/<name>) renvoyaient continuellement des erreurs 500/400, et l’API (/api/v3/community) n’a pas pu être interrogée avec les paramètres disponibles (voir Limites).
Publications
Tendance open source
- scraed/LanPaint — inpainting de haute qualité sans entraînement, utilisable avec n’importe quel modèle Stable Diffusion et compatible ComfyUI / !«メールアドレス» / score 8 / 2026-09-29 / https://github.com/scraed/LanPaint/
- DenRakEiw/scumble — éditeur de bureau dédié à l’inpainting par IA, avec calques, sélection de texte et pinceaux personnalisés. Il dessine avec son propre ComfyUI ou des fournisseurs d’API et prend en charge MCP / !«メールアドレス» / score 3 / 2026-09-29 / https://github.com/DenRakEiw/scumble
- ogoun/fooocus-qwen-image-2.1 — WebUI pour Qwen-Image-2.1 / !«メールアドレス» / score 2 / 2026-09-27 / https://github.com/ogoun/fooocus-qwen-image-2.1
- PrunaAI/Pruna-Qwen-Image-2.1 — adaptateur LoRA à peu d’étapes pour Qwen-Image-2.1, apparu en même temps que le ControlNet union expérimental
QwenImage_experimentalde Kijai ; l’écosystème d’outils autour de Qwen-Image-2.1 se développe rapidement / !«メールアドレス» / score 0 / 2026-09-26 / https://huggingface.co/PrunaAI/Pruna-Qwen-Image-2.1 - black-forest-labs/FLUX.2-klein-9b-kv-fp8 — version quantifiée FP8 du modèle à poids ouverts 9B de Black Forest Labs / !«メールアドレス» / score 8 / 2026-03-14 / https://huggingface.co/black-forest-labs/FLUX.2-klein-9b-kv-fp8
- Alice v1: Distillation-Enhanced Video Generation Surpassing Closed-Source Models — modèle open source de génération vidéo affirmant dépasser les modèles fermés grâce à une distillation améliorée / !«メールアドレス» / score 5 / 2026-05-13 / (pièce jointe webm, lemmy.dbzer0.com pictrs)
Tendance source fermée
- Black Forest Labs annonce « FLUX 3 » — génère des images ainsi que des vidéos de 20 secondes avec audio, d’abord dans le cadre d’un accès limité / !«メールアドレス» / score 1 / 2026-07-24 / https://bfl.ai/blog/flux-3
- OpenAI arrête l’API Sora la semaine suivante, le 24 septembre, tandis que des concurrents chinois lèvent 3 milliards de dollars — analyse affirmant que la vidéo IA grand public n’est pas rentable alors que des entreprises comme Kling attirent des financements / !«メールアドレス» / score 1 / 2026-09-20 / https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Google retire en une journée une fonction IA de Google Earth, Nano Banana 2 — arrêtée pour cause d’abus / !«メールアドレス» / score 1 / 2026-08-07 / https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Comparaison honnête et explication technique de Seedream 5.0 Pro face à Nano Banana Pro / !«メールアドレス» / score 1 / 2026-07-10 / https://www.reddit.com/gallery/1usc03q
- Comparaison : « la même double page de Berserk colorisée par quatre IA » — ChatGPT Images 2.5 / Wan 2.7 Pro / Nano Banana Pro / Seedream 5.0 Pro, avec des avis donnant GPT vainqueur / !«メールアドレス» / score 1 / 2026-09-14 / https://www.reddit.com/gallery/1wfyqdy
- Environ 40 personnes ont évalué à l’aveugle six modèles de vidéo IA sur le même prompt — Google Veo arrive premier, les trois meilleurs modèles étant très proches / !«メールアドレス» / score 1 / 2026-09-17 / https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- ByteDance annonce Seedance 2.5 — ajoute la création en une prise et des fonctions de référence flexibles / !«メールアドレス» / score 3 / 2026-08-01 / https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5
- Runway affirme avoir doublé son activité entreprise et dépasser 300 % de NRR / !«メールアドレス» / score 0 / 2026-08-30 / https://www.reddit.com/r/ArtificialInteligence/comments/1w2hnea/
Signaux
- Qwen-Image-2.1 est devenu le centre du monde open source sur Lemmy : une WebUI dérivée de Fooocus, un ControlNet de Kijai et un LoRA à peu d’étapes de PrunaAI ont été publiés en série au cours de la même semaine, les 26 et 27 septembre. La famille Qwen-Image est donc aujourd’hui un terrain majeur pour la communauté ComfyUI/Stable Diffusion.
- Les modèles fermés brouillent eux-mêmes la frontière : Black Forest Labs, historiquement orienté vers les poids ouverts, propose FLUX 3, avec vidéo et audio, dans un accès fermé limité, tout en publiant en parallèle des versions à poids ouverts comme FLUX.2-klein-9b. La séparation entre ouvert et fermé devient floue.
- Nano Banana 2 génère autant de controverse que d’attention : l’intégration à Google Earth puis son retrait en une journée à cause d’abus est la nouvelle la plus marquante en termes de score, à 6, tandis que les autres publications restent à de faibles niveaux.
- Le discours dominant pour la vidéo IA est que le grand public n’est pas rentable : plusieurs publications, via le miroir Reddit, opposent l’arrêt de l’API Sora par OpenAI aux entreprises Kling, Seedance et Runway, qui se concentreraient sur les clients professionnels et réussiraient mieux sur le plan des financements ou des revenus.
- Les contenus comparatifs côte à côte sont fréquents : Nano Banana Pro, Seedream 5.0 Pro, Wan 2.7 Pro et ChatGPT Images 2.5 sont régulièrement comparés dans les mêmes conditions. Les utilisateurs cherchent moins des nouvelles isolées que la réponse à la question : « lequel est le plus puissant ? »
- Les discussions propres à Lemmy sont presque absentes : la plupart des posts retrouvés viennent de !ai_reddit, un bot miroir de Reddit, avec des scores de 0 à 1 et peu de commentaires. Les analyses originales de Lemmy sont surtout les publications d’outils de !«メールアドレス».
Limites
- Lemmy ne possède pas de grande communauté dédiée à l’IA de génération d’images et de vidéos. Les discussions sont réparties entre la petite communauté !«メールアドレス», dédiée aux outils et modèles avec des scores à un chiffre, et !ai_reddit, une communauté bot qui retransmet les posts de Reddit avec des scores de 0 à 1. Cette dernière est, dans les faits, une republication de Reddit et non une opinion propre à Lemmy.
- Les nombres d’abonnés n’ont pas pu être récupérés.
https://lemmy.world/c/<community>renvoyait de manière répétée une erreur HTTP 500, ethttps://lemmy.world/api/v3/community?name=...une erreur HTTP 400 ; l’instance utilise peut-être une spécification de paramètres différente de la documentation v3 habituelle, ou applique des restrictions. - Les mots-clés « Grok Imagine », « Kling AI », « Runway Gen », « HunyuanVideo » et « Flux » pris isolément ont produit très peu de posts pertinents ou seulement du bruit. Lemmy semble peu discuter directement de ces noms.
- L’API de recherche de lemmy.world affirme effectuer une recherche fédérée entre instances, mais les résultats proviennent principalement de lemmy.world, lemmy.ml, lemmy.dbzer0.com, lemmy.today et lemmy.zip. Le temps n’a pas permis de rechercher séparément lemmy.ml ou lemm.ee.
- Les scores de publications sont globalement très faibles, la plupart étant compris entre 0 et 10 ; on ne peut donc pas parler d’un fort engouement. Cela tient à la petite taille de Lemmy et à l’absence de communautés spécialisées pour la génération d’images et de vidéos par IA.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
50 pins ont été collectés, sans classement par genre, dans un seul ensemble. Leurs titres et miniatures ont été effectivement ouverts et vérifiés.
Thèmes visuels
- Miniatures « youtubeur au visage étonné + assemblage de logos » — Des logos OpenAI, Google, Meta, Microsoft et Anthropic réunis dans un style néon, avec un homme au visage surpris à côté, reviennent dans de nombreuses miniatures « AI NEWS ». Les nouvelles sur les acteurs fermés utilisent presque toutes ce format
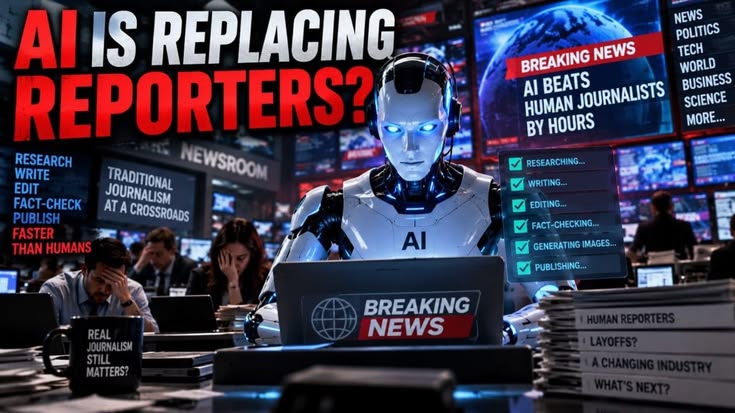
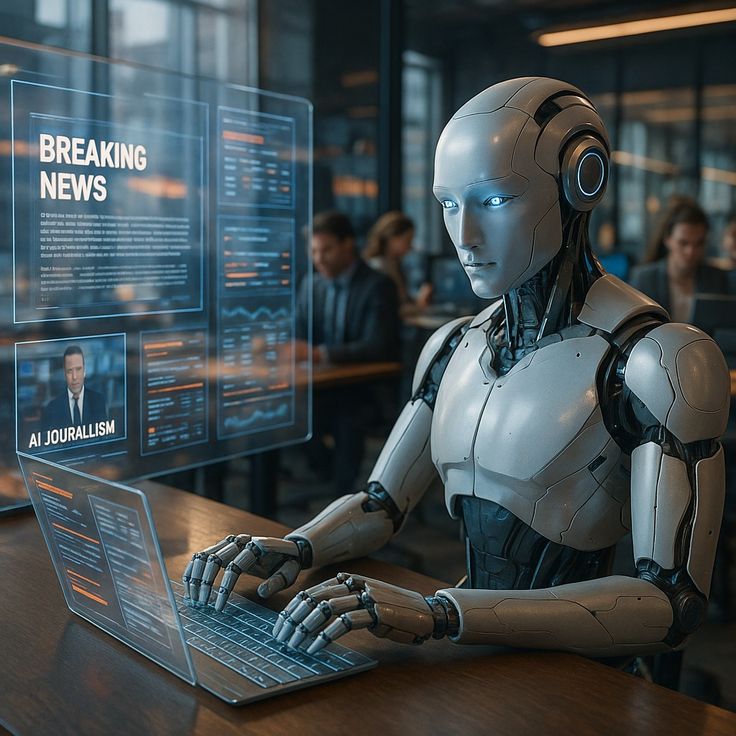
[2, 7, 23, 41]. - Le robot comme présentateur de journal — Un androïde blanc en costume devant un panneau « BREAKING NEWS », ou une vision futuriste d’un présentateur IA prenant le contrôle d’un studio d’information, apparaissent régulièrement
[23, 45]. - Démonstrations de portraits photoréalistes — Des visages d’hommes âgés travaillés avec beaucoup de soin, jusqu’aux rides, à la barbe et aux textures, sont utilisés à répétition comme image phare des annonces de nouveaux modèles, notamment AMD Amuse 3.0 et un gros plan d’œil de Luma Dream Machine. Le réalisme est devenu le benchmark visuel
[43, 47]. - Images en grille transformant une même vidéo source dans plusieurs styles — La même personne ou voiture est régénérée en sculpture sur bois, origami, Lego, composition florale et autres matériaux, afin de démontrer la cohérence de style
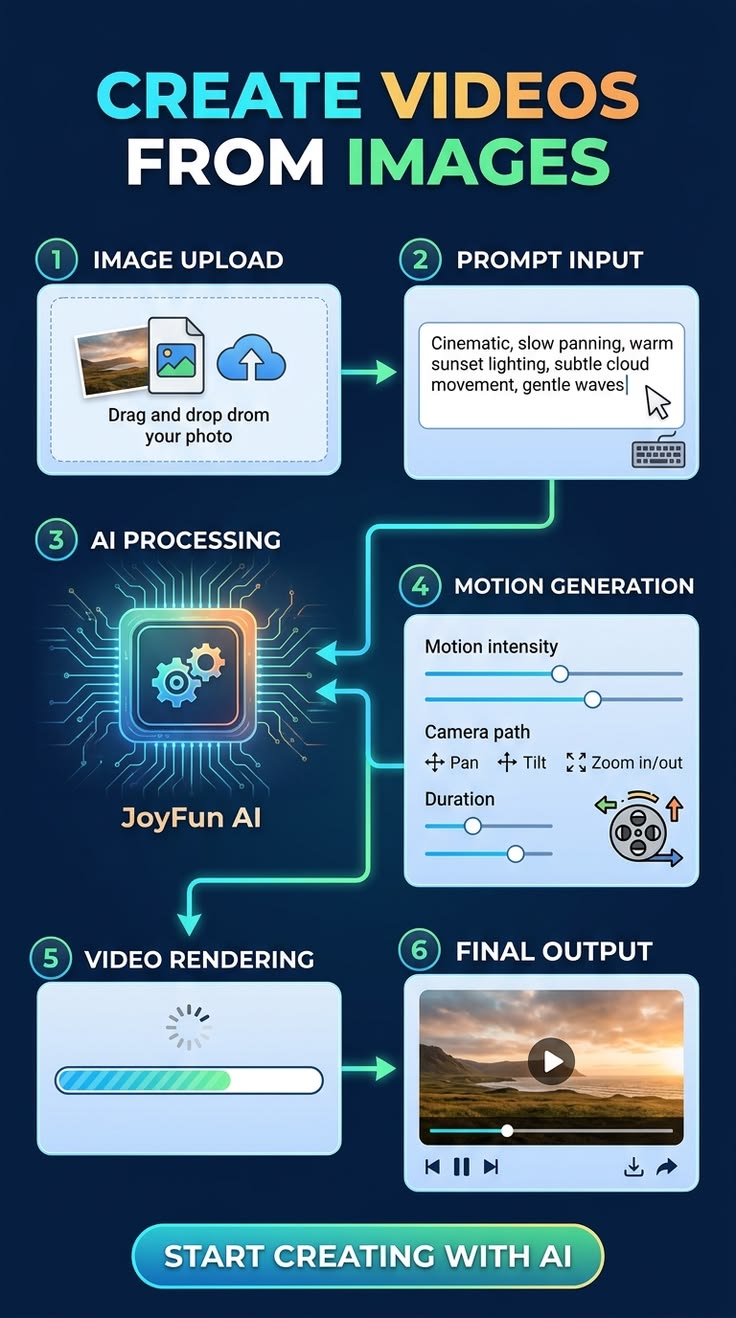
[4]. - Maquettes d’interface néon futuristes — Icônes lumineuses, silhouette de tête aux motifs de circuits et tableaux de bord holographiques qui vendent de manière abstraite la génération « image / vidéo / musique / texte »
[5, 9, 22, 50]. - Infographies de comparaison et d’aide au choix — Les logos de ChatGPT, Midjourney, Gemini, Runway, Pika, Krea et autres sont placés dans des grilles pour indiquer quoi choisir en version payante ou gratuite, sous forme de graphiques néon cyberpunk
[40]. - Visuels d’avertissement sur la détection des faux et l’éthique de l’IA — Un robot soupçonnant une image de chat marquée « FAKE », des infographies avant/après d’un œil indiquant qu’il ne faut pas se fier uniquement à l’apparence, et autres visuels sur la vérification des contenus IA sont assez présents
[1, 20, 32, 37]. - Certains pins présentent un décalage entre titre et image — Par exemple, un titre sur l’entrée de Stability AI dans la génération vidéo accompagne en réalité une collection de moodboards fantasy. Les miniatures recyclées visant le clic semblent fréquentes
[29].
Pins notables
- [2] AI News: Anthropic Leak Shows Us The Future of AI... — Miniature « AI NEWS » très classique avec les logos OpenAI, Google, Microsoft et Anthropic en lumière. Vidéo de synthèse sur les acteurs de l’IA propriétaire.
- [4] Google announces ultra-high quality video... — Image en grille régénérant la même personne et la même voiture en bois, origami, Lego et fleurs. Démonstration claire de cohérence de style.
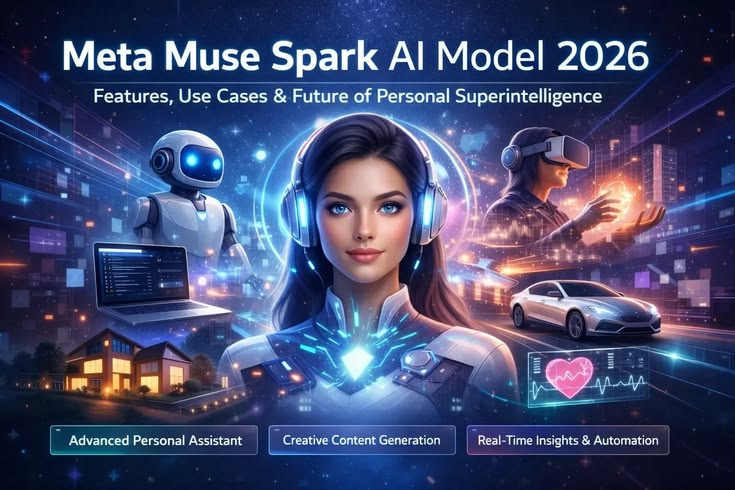
- [5] Meta Unveils Muse Image and Muse Video Generative... — Bannière SF sur « Meta Muse Spark AI Model 2026 », insistant sur une orientation d’assistant IA personnel.
- [23] Discover how Grok is revolutionizing video... — Présentateur de journal androïde blanc assis devant un panneau « BREAKING NEWS ». Une vision d’avenir où l’IA produit l’information.
- [26] Google's Gemini Omni Turns Anything Into Video — Logo « Omni » central, entouré d’icônes d’image, vidéo, audio et texte, mettant en avant l’intégration multimodale.
- [38] Google Unveils Veo 2: Advanced AI Video Generation... — Bannière de style officiel pour Veo2, avec l’accroche « state-of-the-art video generation model » et une série d’exemples réalistes et animés.
- [43] Introducing Luma Dream Machine - Next Generation AI Video — Gros plan d’un œil avec la typographie « Dream Machine ». Image emblématique mettant en avant la capacité de génération photoréaliste.
- [47] 'Amuse 3.0', an AI art creation tool that includes... — Outil de création artistique IA d’AMD, exécuté localement. Le visage photoréaliste d’un vieux pêcheur sert de démonstration et met en avant une génération substantielle sur GPU. C’est l’un des rares outils explicitement nommés, proche du local et de l’open source.
- [40] Top AI Video Generators of 2025 — Tableau comparatif néon classant ChatGPT Plus, Midjourney, Runway, Pika, Kaiber et d’autres par priorité de qualité ou de gratuité. Une information pratique pour choisir un outil.
- [20] 'AI is getting scary good.' — Infographie d’avertissement réunissant génération vidéo IA, détection de voix et ingénierie de prompts. Elle exprime l’idée qu’il ne faut pas croire une image sur sa seule apparence.
Signaux
- Sur Pinterest, les « actualités de l’IA de génération d’images et de vidéos » sont très largement dominées par des miniatures d’actualité autour des acteurs fermés : OpenAI, Google Veo/Gemini Omni, Meta Muse, Grok, Midjourney, Runway et Pika. Le format « visage étonné + assemblage de logos », semblant souvent reprendre des miniatures YouTube, domine et privilégie l’incitation au clic plutôt que la profondeur de l’information.
- Les sujets open source et de génération locale sont peu présents. Les seuls noms concrets relevés sont Stability AI — uniquement dans un titre alors que l’image est un moodboard sans rapport — et AMD Amuse 3.0, outil local sur GPU. Aucune image technique issue de communautés, telle qu’une interface ComfyUI, une page Hugging Face ou un schéma d’architecture de modèle de diffusion, n’a été trouvée.
- La génération de portraits photoréalistes, avec des visages très détaillés jusqu’aux rides et aux textures, est répétée par différentes entreprises comme visuel de référence pour dire « voilà ce qui est désormais possible ». C’est un signal de maturité technologique.
- Des infographies consacrées à la méfiance envers les contenus générés par IA et à leur vérification — détection des faux, authenticité vocale, éthique — sont présentes en nombre non négligeable. Elles rendent visible un intérêt pour les bonnes pratiques et la manière de distinguer le vrai du faux, au même titre que pour la génération elle-même.
- Ce qui est au contraire absent : des pins traitant directement de noms précis de modèles open source comme Stable Diffusion, FLUX, Wan ou HunyuanVideo ; des captures de dépôts GitHub ou de blogs techniques ; des pins montrant des articles scientifiques ou des chiffres de benchmark. Par nature, Pinterest est dominé par des résumés secondaires, tableaux comparatifs et bannières promotionnelles, plutôt que par les sources primaires de communautés techniques.
Limites
output/pinterest.pins.mdne contient pas de catégorisation par genre (genreest vide) et fournit un seul ensemble de 50 pins. Il n’a donc pas été possible de produire les synthèses par genre envisagées par le protocole ; l’ensemble a été analysé comme un seul corpus.- 18 images sur 50 ont été ouvertes et vérifiées, en tenant compte de la précision des titres et de la diversité des sujets. Les 32 autres n’ont pas été examinées, mais les répétitions de format dans l’échantillon vérifié rendent les tendances suffisamment visibles.
- Plusieurs pins présentent un décalage entre leur titre et leur image, comme le pin
[29]lié à Stability AI et illustré par un moodboard sans rapport. Ces pins sont évoqués pour le contexte de leur titre, et non pour le contenu réel de leur image. - Pinterest n’a pas été consulté directement dans le navigateur ; seules les images et titres précollectés par le worker ont été examinés. Les chiffres d’engagement réels, tels que les enregistrements et mentions J’aime, ainsi que le texte des articles liés, n’ont pas pu être vérifiés.
Actions recommandées
- Relancer l’étape X avec des mots-clés IA directs — Midjourney, Sora, Nano Banana, ComfyUI, Flux — au lieu de tendances génériques.
- Continuer à suivre l’écosystème Qwen-Image-2.1 — WebUI, LoRA, ControlNet — comme indicateur avancé de l’élan open source.
- Suivre l’écart entre coûts et revenus de Sora 2 comme indicateur indirect de la rentabilité des modèles fermés de génération vidéo.
- Cartographier les outils vers lesquels les utilisateurs migrent lorsqu’un outil fermé renforce ses garde-fous.
- Étendre l’échantillonnage Pinterest au-delà de 18 pins sur 50, ou trouver une manière de récupérer les chiffres d’engagement.
- Considérer la communauté !ai_reddit de Lemmy comme un miroir de Reddit, et non comme un signal indépendant, lors de l’évaluation de ses résultats.
Images collectées





























Note sur la qualité des données
L’étape X a collecté des posts à partir de sujets tendances génériques plutôt que de recherches liées à l’IA et n’a rien apporté. YouTube et Pinterest n’ont pas permis de confirmer les métriques d’engagement, telles que les vues, abonnés, enregistrements ou mentions J’aime, à cause du rendu JavaScript et des limites d’échantillonnage. Reddit et Bluesky reposaient quant à eux sur des données réelles collectées ou issues d’API, et sont les sources les plus fiables ici.