Actualités de l’IA de génération d’images et de vidéos — 2026-10-01
L’open source (Qwen-Image-2.1, LTX 2.5) gagne fortement en dynamisme autour de ComfyUI, tandis que les grands acteurs propriétaires (Google Nano Banana, OpenAI Sora, xAI Grok Imagine) font surtout parler d’eux pour des abus, des procès et des arrêts de service.
Actualités de l’IA de génération d’images et de vidéos — 2026-10-01
En bref : l’open source est vraiment en feu en ce moment 🔥 Qwen-Image-2.1 d’Alibaba (7B, mais transparence native et sortie 2K) et LTX 2.5, modèle vidéo open source, se répandent rapidement dans la communauté ComfyUI. L’environnement pour expérimenter en local, gratuitement et sans censure se renforce de plus en plus 😤 De l’autre côté, les offres propriétaires (la famille Google Nano Banana, OpenAI Sora, Midjourney, xAI Grok Imagine) ont des fonctionnalités brillantes, mais les « mauvaises nouvelles » — deepfakes, abus liés à la pornographie infantile, procès et fermetures de services — sont davantage visibles. L’ambiance médiatique est donc très différente 🙄 Pour être honnête, il a été presque impossible d’obtenir des données réellement pertinentes sur X et Bluesky pour ce thème ; désolé pour cela 🙏
Sur l’ensemble des plateformes
Trois tendances communes se dégagent de plusieurs plateformes !
- L’open source a fait de ComfyUI sa langue commune : Reddit (Vlo 0.3 a obtenu 1 055 points dans r/StableDiffusion), YouTube (une succession de vidéos explicatives sur Qwen-Image-2.1 et LTX 2.5) et Lemmy (des workflows dérivés de Qwen-Image-2.1 publiés quotidiennement dans !«メールアドレス») convergent clairement : ComfyUI est devenu, de fait, la plateforme standard 💪
- Les acteurs propriétaires deviennent plus facilement des sujets d’actualité par les abus et les polémiques : Reddit (SM Entertainment engage des poursuites contre des images deepfake de stars de K-pop, 730 points), Lemmy (la fonction Nano Banana de Google Earth a été arrêtée en un jour après des images de catastrophes falsifiées, score 473), Bluesky (le journaliste de 404 Media Emanuel Maiberg poursuit son enquête sur les images générées sans consentement), Pinterest (au moins 7 images sur 50 exploitent l’angoisse autour de « l’IA qui remplace les journalistes »). Il est vraiment intéressant que quatre plateformes très différentes montrent la même configuration 🫣
- Le renforcement de la censure pousse vers le local : sur Reddit, les utilisateurs discutent d’un passage à Seedream/MiniMax H3 après le durcissement du filtre NSFW de WAN 3.0, et recommandent Midjourney/VeniceAI en réaction à la censure excessive de ChatGPT. Sur Lemmy, les infrastructures distribuées et gratuites comme AI Horde sont soutenues. L’idée « réglementation trop stricte = repli vers l’open source » apparaît très nettement 🏃
Plateforme par plateforme
Reddit : 12 fils collectés, sans atteindre le critère de complétude de 20. Le procès autour de deepfakes de K-pop (730 points) et la polémique concernant un clip Vocaloid (327 points) dominent très largement ; les discussions d’éthique et de préjudices ont davantage buzzé que les fils présentant les tendances techniques. Les sujets couvrent à la fois le propriétaire et l’open source.
X : résultat franchement raté 😭 Les termes de recherche n’étaient pas des mots-clés liés au thème : ils réutilisaient tels quels des tendances croates (Spain, Tesla, JubJub, etc.). Parmi les 40 publications collectées, pratiquement aucune ne concerne le thème. La conclusion de l’étape X est qu’on ne peut rien dire sur l’IA de génération d’images et de vidéos.
YouTube : 10 vidéos examinées. Les projets open source Qwen-Image-2.1 et LTX 2.5 se sont propagés immédiatement, surtout auprès de chaînes anglophones. Les chaînes japonaises mettent davantage l’accent sur les comparaisons pratiques d’outils propriétaires comme Nano Banana, Flow et Sora2. La répartition de l’intérêt entre open source et propriétaire selon la langue était également intéressante.
Bluesky : l’API officielle de recherche plein texte (searchPosts) est restée inaccessible avec une erreur HTTP 403 ; l’enquête a donc basculé vers le suivi d’accounts individuels. Côté propriétaire, dfl.bsky.social publie quotidiennement des paysages générés avec Nano Banana 2. Les créateurs open source (comme doctordiffusion) ont, eux, cessé leur activité au cours du premier semestre 2025 ; les publications actuelles sont rares.
Lemmy : 11 éléments sélectionnés avec soin, après examen de plus de 60. !«メールアドレス» est de loin la source la plus dense d’informations techniques open source. Les sujets propriétaires se concentrent sur les polémiques autour de Google Earth et le procès relatif à du CSAM généré par xAI Grok Imagine. Le volume examiné atteint bien le critère de complétude.
Pinterest : les 50 pins ont tous été vérifiés. La plupart sont des images de stock optimisées pour le SEO ou des miniatures de listes d’outils ; la seule véritable démo produit notable est la grille de transformations de Lumalabs. Aucune image liée à l’open source (ComfyUI, Stable Diffusion UI, etc.) n’a été trouvée. Les visuels de marques propriétaires (Veo2, Gemini Omni) ressortent, mais certaines mêmes images sont réutilisées dans plusieurs pins.
À surveiller
- Qwen-Image-2.1 (Alibaba, poids ouverts 7B) : YouTube « A 7B Model That Beats Nano Banana 2.0? » https://www.youtube.com/watch?v=fwHS0ubmI7I et Lemmy https://lemmy.dbzer0.com/post/75874773 — ses benchmarks propriétaires affirment dépasser les grands modèles fermés ; c’est un symbole de l’élan open source 🚀
- LTX 2.5 (modèle vidéo entièrement open source) : YouTube https://www.youtube.com/watch?v=6B9WSxi6j8E — mise en pratique sur ComfyUI, y compris pour le multi-plan et une sortie 2K
- Polémique Google Earth « Nano Banana » : Lemmy https://lemmy.world/post/50167698 (score 473) — schéma typique d’un grand acteur propriétaire : lancement de fonction → abus → arrêt immédiat
- Essoufflement de Sora 2 : YouTube (TBS NEWS DIG) https://www.youtube.com/watch?v=_r9hojDlABM — après avoir fait parler de lui, le service s’oriente vers un arrêt progressif (la fin de l’API était annoncée pour le 2026-09-24)
- Procès de SM Entertainment sur les deepfakes de K-pop : Reddit https://www.reddit.com/r/kpop/comments/1wsdr6d/ — les atteintes au droit à l’image dues aux abus de l’IA, qu’elle soit ouverte ou fermée, suscitent les réactions les plus fortes
- Vlo 0.3 (éditeur vidéo IA open source) : Reddit https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/ — outil local intégrant Minimax H3/Qwen2.1/Krea2/LTX2.5
Recommandations
- Lors de la prochaine collecte, réinterroger X avec des mots-clés directement liés au thème (Midjourney, Sora, Stable Diffusion, Wan, Kling, etc.). Les données actuelles ne sont pas exploitables.
- Si
searchPostscontinue de renvoyer une erreur 403 sur Bluesky, envisager un autre mode d’accès, par exemple une API authentifiée. - Continuer de suivre l’adoption de Qwen-Image-2.1 et LTX 2.5 en tant qu’indicateurs open source lors du prochain cycle.
- Prioriser les actualités d’abus et de polémiques chez les entreprises propriétaires (Nano Banana/Google Earth, procès Grok Imagine), car elles maximisent généralement l’engagement.
- Répartir les requêtes Reddit entre plusieurs recherches afin d’élargir la collecte jusqu’à environ 20 éléments, conformément au critère de complétude.
- Vérifier lors de la prochaine analyse l’évolution du marché propriétaire de la vidéo après la fermeture de l’API Sora.
Qualité des données
Sur X, une erreur dans le choix des termes de recherche n’a produit que des données hors sujet : il s’agit de facto d’une absence de données. Sur Bluesky, l’API de recherche plein texte était bloquée par une erreur 403, imposant un suivi alternatif par compte et ne permettant pas d’atteindre le critère d’environ 20 publications. Reddit, avec une seule requête, n’a également obtenu que 12 éléments. À l’inverse, Lemmy (plus de 60 éléments examinés), Pinterest (50 images examinées) et YouTube (10 vidéos étudiées) ont fourni un volume globalement suffisant.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
Les 12 fils collectés proviennent de 9 subreddits. Le nombre de membres et d’éléments est le suivant ; tous les résultats proviennent de la recherche « Image and Video Generation AI News ».
| Subreddit | Membres | Éléments collectés |
|---|---|---|
| r/kpop | 3,893,359 | 1 |
| r/youtube | 3,462,568 | 1 |
| r/StableDiffusion | 1,027,325 | 1 |
| r/AI_Agents | 452,181 | 1 |
| r/Vocaloid | 218,928 | 1 |
| r/aiwars | 170,021 | 1 |
| r/generativeAI | 159,505 | 4 |
| r/B2BForHire | 139,944 | 1 |
| r/GenAI4all | 49,028 | 1 |
r/generativeAI arrive en tête avec 4 éléments, principalement des fils demandant quels outils d’IA peuvent être utilisés gratuitement. Les autres subreddits ne comptent qu’un résultat chacun, avec de nombreux sujets sur le cinéma, la musique ou la K-pop où GenAI a été utilisée, ou a suscité une polémique.
Ce que disent les gens
- Fil n°1 : « Dreamworks utilise GenAI depuis 2023 » (r/aiwars, 17 points, 48 commentaires, 2026-09-30, https://www.reddit.com/r/aiwars/comments/1wty4m6/) : affirmation selon laquelle des œuvres Dreamworks telles que Trolls Band Together et Kung Fu Panda 4 ont été produites avec GenAI. Le commentaire principal est sceptique : « Nothing you posted says that these movies are 'produced with gen AI'. ... You have no idea how they used AI in these productions. » (u/Majestic-Coat3855, 25 points)
- Fil n°2 : « Recherche d’alternatives image-vers-vidéo pour adultes après le renforcement des filtres de DreamFort » (r/generativeAI, 10 points, 8 commentaires, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wtzefv/) : la génération NSFW de WAN 3.0 est soudainement devenue plus stricte, et l’utilisateur cherche des alternatives propriétaires telles que Seedream 2.0 Unfiltered ou MiniMax H3.
- Fil n°3 : « Le contenu généré par l’IA tue YouTube » (r/youtube, 107 points, 21 commentaires, 2026-09-25, https://www.reddit.com/r/youtube/comments/1wqbl4f/) : signale l’augmentation des vidéos IA découpées-collées avec narration. « We have entered the realm of slop. » (u/three-sense, 2 points), « YouTube CEO says he's pro ai slop. » (u/HotUKTakes, 2 points)
- Fil n°4 : « Aucun outil de génération vidéo IA “entièrement gratuit” n’existe » (r/generativeAI, 55 points, 36 commentaires, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wty6zj/) : rappel réaliste que le coût des GPU cloud n’est pas une œuvre de charité. « videos are not like cheap LLMs, no one can give it away for free » (u/opengradient, 5 points)
- Fil n°5 : « Quel est le meilleur outil de génération d’images IA axé sur le gratuit ? » (r/generativeAI, 4 points, 54 commentaires, 2026-09-26, https://www.reddit.com/r/generativeAI/comments/1wqfleb/) : recommandations de Yodayo/MoescapeAI (50 crédits/24 h), Leonardo (jetons gratuits quotidiens), etc.
- Fil n°6 : « Recherche d’un créateur vidéo IA / gestionnaire de contenu IA » (r/B2BForHire, 2 points, 5 commentaires, 2026-09-25, https://www.reddit.com/r/B2BForHire/comments/1wpx42u/) : offre d’emploi recherchant une expérience de production vidéo hybride IA et entièrement générée par IA. Signe que la production vidéo IA se constitue déjà en métier.
- Fil n°7 : « AnythingBecomeMoe utilise GenAI dans son nouveau clip “DisplayHolic” » (r/Vocaloid, 327 points, 105 commentaires, 2026-09-28, https://www.reddit.com/r/Vocaloid/comments/1wsa4nz/) : avis partagés. « I don't understand when incredibly talented people embrace ai » (u/AungCowMyat, 297 points) contre « at least they're disclosing it... far better usage than some others who just straight up reject the fact that they used AI » (u/memorie_desu, 200 points)
- Fil n°8 : « SM Entertainment engage des poursuites contre des images générées par IA ciblant Lim Yoona et Winter d’aespa » (r/kpop, 730 points, 52 commentaires, 2026-09-28, https://www.reddit.com/r/kpop/comments/1wsdr6d/) : forte inquiétude concernant les deepfakes. « the deepfakes are so concerning. glad sm is taking action :( » (u/llamacana, 167 points)
- Fil n°9 : « Vlo 0.3 — éditeur/générateur vidéo open source spécialisé dans la composition par IA » (r/StableDiffusion, 1,055 points, 71 commentaires, 2026-09-28, https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/) : accueil favorable pour la compatibilité des workflows embarqués Minimax H3, Qwen2.1, Krea2 et LTX2.5. « Great ad, same as before :) I forgot about this app, I will Def try it. » (u/Maskwi2, 22 points)
- Fil n°10 : « Les vidéos IA devenues virales en 2024 : l’évolution de la qualité est folle aujourd’hui » (r/GenAI4all, 199 points, 66 commentaires, 2026-09-24, https://www.reddit.com/r/GenAI4all/comments/1wou5vb/) : fil nostalgique sur l’amélioration de la qualité d’image en quelques années. De nombreuses réactions vont dans le sens du titre : « the leap in quality since then is insane ».
- Fil n°11 : « Je veux un outil de génération d’images IA sans garde-fous » (r/AI_Agents, 0 point, 22 commentaires, 2026-09-29, https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/) : face à la censure excessive de ChatGPT, de nombreux commentaires conseillent Midjourney, VeniceAI et des modèles open source chinois.
- Fil n°12 : « Existe-t-il un outil IA gratuit pour créer des vidéos animées à partir d’un scénario ? » (r/generativeAI, 4 points, 23 commentaires, 2026-09-27, https://www.reddit.com/r/generativeAI/comments/1wrip4m/) : « Minimax H3 with comfyUI » (en supposant une installation locale, u/Amonsul_, 4 points) est la réponse la plus recommandée. La conclusion reste que la qualité a finalement un coût.
Signaux
- Tendance à la hausse : le rejet du renforcement des filtres propriétaires (fil n°2) alimente de manière cohérente dans plusieurs fils (n°2, n°11, n°12) une volonté de passer aux modèles open source et locaux (ComfyUI, Minimax H3, familles SDXL). La formule « pour éviter la censure, il ne reste que le local » devient une réponse type.
- Signes de professionnalisation : le fil d’emploi (n°6) et celui sur Dreamworks (n°1) indiquent que GenAI dépasse désormais le loisir et s’intègre à l’infrastructure opérationnelle du cinéma et de la création de contenu.
- Attentes écartées : la communauté elle-même juge irréaliste l’attente d’un outil de génération vidéo entièrement gratuit, illimité et sans filigrane (fils n°4 et n°5). Les commentaires les plus visibles insistent sur le coût réel des GPU cloud.
- Structure de conflit : les fils n°1 et n°7 montrent un clivage sur la valeur de la divulgation de l’usage de GenAI. Dans le fil Vocaloid, l’argument selon lequel divulguer son usage est plus honnête coexiste parmi les commentaires principaux avec l’idée qu’il est regrettable que des personnes talentueuses s’appuient sur l’IA. Cela ne se résume pas à une opposition simpliste entre pour et contre.
- Point surprenant : les scores les plus élevés concernent le fil sur les mesures légales contre des images IA malveillantes visant des idols de K-pop (n°8, 730 points) et celui sur la polémique du clip Vocaloid (n°7, 327 points), plutôt que les fils de présentation d’outils (n°5, n°12, etc.). Les préjudices aux personnes et les enjeux éthiques suscitent des réactions bien plus fortes que les tendances techniques elles-mêmes.
Limites
- Le critère de complétude du brief prévoit environ 20 publications analysées par plateforme, mais seuls 12 fils ont été collectés. Une seule requête, « Image and Video Generation AI News », a été utilisée ; aucune recherche complémentaire séparant « closed source » et « open source » n’a été menée.
- Aucun échec ni résultat vide n’est documenté dans threads.md. Les 12 éléments proviennent donc de cette seule requête, et le manque de volume est probablement dû à l’étroitesse de celle-ci.
- Pour les fils n°7 (Vocaloid), n°8 (kpop), n°9 (StableDiffusion) et n°10 (GenAI4all), le texte d’ouverture n’a pas été enregistré ; l’analyse repose uniquement sur les titres et les meilleurs commentaires.
X
X — Actualités de l’IA de génération d’images et de vidéos
##Note importante concernant les données collectées
Après examen de output/x.posts.md, les termes de recherche utilisés lors de cette collecte X étaient :
« Spain », « Tesla », « JubJub », « Holy », « Italy », « #bb28 », « Elon », « Croat », « Donald »
et « Roman ». Ils ne résultent pas d’une recherche sur le thème étudié — IA de génération d’images et de vidéos propriétaire/open source — mais réutilisent les termes tendances de X Explore figurant dans le tableau « What X says is happening » au début de output/x.posts.md (tendances visibles depuis une session géolocalisée en Croatie). Les 40 publications collectées, émanant de 37 comptes, portent donc presque toutes sur le football (Espagne contre Croatie), l’aide à la conduite Tesla, la WWE, Big Brother (#bb28), les déclarations politiques de Donald Trump, etc., et non sur le thème.
Ce qui suit est un rapport honnête fondé sur les données réellement collectées, mais il faut préciser d’emblée qu’elles ne représentent pas les évolutions de l’IA de génération d’images et de vidéos.
Comptes
La grande majorité des 37 comptes collectés n’a contribué qu’une seule publication, et aucun créateur pertinent pour le thème n’a été identifié. Les seuls comptes comptant plusieurs publications, tous hors sujet, sont :
- @ryu15 (Ryu) — 2 publications, notes techniques personnelles faisant tourner VRChat avec une « Tesla V100 » ; « Tesla » désigne accidentellement le modèle de GPU, et non la conduite autonome.
- @grouchoskie (Grouch Oskie) — 2 publications, messages quotidiens.
- @reigns_era (Roman Reigns SZN) — 2 publications de fan autour de Roman Reigns et de la WWE.
Aucun compte publiant régulièrement au sujet de l’IA de génération d’images ou de vidéos n’apparaît dans cet ensemble de données.
Publications
Les publications contenant des termes vaguement proches du sujet (« AI », « generation », etc.) sont très rares et ne portent jamais sur l’IA de génération d’images ou de vidéos elle-même.
-
@rammcodes (Ram Maheshwari) — 276 likes, 51 reposts, 4 réponses, environ 15 000 vues, 2026-09-29
https://x.com/rammcodes/status/2104962267267944848
« Holy Sh*t... this is like PDF parsing on steroids... A free, open-source PDF parser that converts PDFs into AI-ready Markdown, JSON, and HTML. »
→ Présentation d’un parseur PDF open source, dans le domaine de l’analyse documentaire et des outils pour RAG, sans lien avec la génération image/vidéo. -
@LuisBizarro (Luis Bizarro) — 930 likes, 48 reposts, 37 réponses, environ 52 000 vues, 2026-09-29
https://x.com/LuisBizarro/status/2104780688113455342
« Another AI slop and vibe coded experiment... based on Neon Genesis Evangelion. This took me like 45 minutes and three prompts. This is all Three.js and WebGL. »
→ Expérience 3D interactive réalisée par « vibe coding » avec IA, Three.js et WebGL. Le sujet est la génération de code, non les modèles de génération d’images ou de vidéos. -
@thomasunise (Thomas Unise) — 732 likes, 48 reposts, 43 réponses, environ 111 000 vues, 2026-09-29
https://x.com/thomasunise/status/2105003307232059397
« Elon is diabolical OpenAI drops dots https://Dot.com goes to Grok Bot »
→ Publication sur une petite rivalité liée à un domaine entre OpenAI et Grok, pas sur l’actualité technique des modèles génératifs. -
@LinusEkenstam (Linus ✦ Ekenstam) — 2 640 likes, 408 reposts, 354 réponses, environ 344 000 vues, 2026-09-30
https://x.com/LinusEkenstam/status/2105212016583422270
« This video is going Viral everywhere. A trillionaire and a pile of billionaires are unable to answer a simple question about regular laptop jobs... »
→ Publication montrant des figures reconnues de l’IA, dont Dario, mais portant principalement sur l’emploi, non sur la génération vidéo.
Les 36 autres éléments — football Espagne-Croatie, frustrations liées à la conduite autonome Tesla, messages de fans de JubJub, Big Brother #bb28, WWE, déclarations politiques de Trump, etc. — n’ont aucun rapport avec l’IA de génération d’images ou de vidéos.
Signaux
- Aucun signal clair relatif au thème n’a été détecté. Parmi les 40 publications collectées, aucune ne mentionne une IA propriétaire (Midjourney, Sora, Runway, Veo, Flux Kontext, etc.) ni une IA open source (Stable Diffusion, Wan, HunyuanVideo, ComfyUI, etc.) de génération d’images ou de vidéos.
- Le seul enseignement concerne le processus de collecte : les termes de recherche ont été directement repris des tendances régionales de X Explore, visibles en Croatie, et n’avaient aucun lien avec le thème du brief. Ce problème de logique de collecte est la principale découverte de cette étape.
Limites
- Le fait que les termes de recherche soient sans rapport avec le thème est la principale limitation. Les 10 termes — « Spain », « Tesla », « JubJub », « Holy », « Italy », « #bb28 », « Elon », « Croat », « Donald » et « Roman » — proviennent des tendances X Explore pour la Croatie, et non du sujet de l’IA de génération d’images ou de vidéos. Parmi les 40 publications, le nombre d’éléments réellement pertinents est donc pratiquement nul.
- Des termes directement liés au thème, tels que « Midjourney », « Sora », « Stable Diffusion », « Runway », « Flux », « Veo », « Kling » ou « HunyuanVideo », n’ont jamais été recherchés. Cette étape X ne permet donc, dans les faits, aucune conclusion sur le sujet.
- Le tableau de tendances Explore lui-même — Spain / Tesla / JubJub / Holy / Italy / #bb28 / Elon / Croat / Donald / Roman — se limite à une perspective issue d’un serveur croate et ne doit pas être interprété comme une tendance mondiale.
- En conclusion, les données actuelles ne permettent pas de rapporter une information valable sur les évolutions des IA open source/propriétaires de génération d’images et de vidéos sur X. Une nouvelle collecte devra utiliser des noms précis de modèles, d’outils et d’entreprises.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos, propriétaire/open source
Chaînes
- AI WITH Rithesh (@RitheshSreenivasan) — chaîne internationale consacrée aux outils IA ; a testé Qwen-Image-2.1 le jour même.
- Daily AI Roundup (@ai_roundup) — chaîne de récapitulatif quotidien de l’actualité IA ; a présenté la sortie de Qwen-Image-2.1 sous forme d’actualité.
- Veteran AI (@VeteranAI-y1r) — chaîne spécialisée dans les workflows ComfyUI ; couvre successivement LTX 2.5 et Qwen Image 2.1.
- MaxonShire (@MaxonShire) — chaîne de comparaisons d’IA vidéo locales, axée surtout sur HunyuanVideo et la famille Wan.
- 動画編集の中の人 — chaîne japonaise forte en comparaisons d’outils payants de génération d’images.
- AI大学【AI&ChatGPT最新情報】 (@AIAIChatGPT-cj4sh) — chaîne japonaise principalement consacrée aux explications et guides pour débutants.
- AIで創作効率化とマネタイズby呪喝蛙 (@AI_aaafrog) — chaîne japonaise proposant des présentations de modèles ComfyUI et des contenus axés sur la monétisation.
- TBS NEWS DIG — chaîne officielle de TBS News ; a traité Sora 2 au format d’un reportage télévisé.
Le nombre d’abonnés n’était pas disponible dans les résultats oEmbed/recherche obtenus : les pages vidéo ne l’affichent qu’après rendu JavaScript, voir les limites.
Vidéos
-
« Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! » — AI WITH Rithesh / fin septembre 2026, juste après la sortie de Qwen-Image-2.1 le 2026-09-20 / https://www.youtube.com/watch?v=3qGl0wiv2G0 — présente le modèle à poids ouverts 7B d’Alibaba, avec génération de PNG transparents, jusqu’à 10 images de référence et sortie native 2K, comme comparable aux grands modèles fermés.
-
« A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native 2K, RGBA & 10-Image Workflows » — Veteran AI / fin septembre 2026 / https://www.youtube.com/watch?v=fwHS0ubmI7I — explication du workflow ComfyUI de Qwen-Image-2.1. L’axe central est l’affirmation qu’un benchmark maison le place devant Nano Banana 2.0, un modèle propriétaire ; Tom’s Hardware évoque aussi Qwen Image Benchmark 60.2 contre Nano Banana 2.0 à 59.82.
-
« Alibaba Open-Sources Qwen-Image-2.1, A 7B Model With Native Transparency » — Daily AI Roundup / fin septembre 2026 / https://www.youtube.com/watch?v=cdZ4E7_kiJY — actualité rapide sur l’ouverture de Qwen-Image-2.1. La prise en charge native de la transparence, ou canal alpha, est la fonction phare.
-
« Master LTX 2.5 in ComfyUI: Multi-Shot, First-Last Frame & 2K Workflows » — Veteran AI / mi-août 2026, le résultat de recherche indiquant environ 40 à 48 jours depuis la publication / https://www.youtube.com/watch?v=6B9WSxi6j8E — guide pratique pour utiliser LTX 2.5, modèle vidéo entièrement open source, dans ComfyUI. Explique le multi-plan, la définition de première/dernière image et les workflows 2K.
-
« LTX 2.5 is a New Free and Opensource AI Video Model that is Insanely Fast in Generation » (Shorts) — mi-août 2026 / https://www.youtube.com/shorts/h8qy-MBDzho — courte présentation de la vitesse de génération de LTX 2.5.
-
« 使わにゃ損損!お得に生成するならComfyUI一択!2026年おすすめ生成モデルベスト! » — AIで創作効率化とマネタイズby呪喝蛙 / 2026, le résultat indiquait environ 172 jours auparavant, donc un contenu un peu plus ancien / https://www.youtube.com/watch?v=qmiPya-U2KM — vidéo récapitulative de modèles open source ComfyUI couvrant image, vidéo, musique, voix et 3D.
-
« 【ドS課金して判明】2026年おすすめ画像生成AIはコレ!NanoBananaPro・Seedream4.0・Midjourney・AdobeFireflyを徹底比較します! » — 動画編集の中の人 / 2026, récent mais date exacte non vérifiée / https://www.youtube.com/watch?v=vJLDbXaSKW4 — comparaison pratique de quatre services propriétaires payants : Nano Banana Pro, Seedream 4.0, Midjourney et Adobe Firefly.
-
« 【画像生成AIの頂点】Google最新の画像生成AI「Nano Banana 2(ナノバナナ)」を無料で使い倒す!最短スタート完全ガイド! » — AI大学【AI&ChatGPT最新情報】 / 2026, Nano Banana 2 étant sorti les 2026-02-26 à 27 et la vidéo continuant d’être visionnée par la suite / https://www.youtube.com/watch?v=Asuw6jHVcSs — guide pour débutants sur la prise en main gratuite de Nano Banana 2 (Pro), basé sur Gemini 3 Pro.
-
« 【Google Flow完全ガイド】無料で使えるAI映像制作ツールが超進化!Gemini Omni Flash・ナノバナナを使って動画や画像を作れる! » — AI大学【AI&ChatGPT最新情報】 / après mai 2026, avec mention de l’ajout de Gemini Omni Flash / https://www.youtube.com/watch?v=dBFK1yFJXOA — présente les évolutions de Flow, l’outil intégré propriétaire de Google, qui permet de traiter image Nano Banana et vidéo Veo dans un même outil.
-
« 最新動画生成AI「Sora2」リアルな映像が約3分で生成可能に…実演でわかったその性能 一方で著作権への懸念も【news23】 » — TBS NEWS DIG / 2026 / https://www.youtube.com/watch?v=_r9hojDlABM — reportage sur Sora 2, outil propriétaire, mêlant démonstration et préoccupations liées au droit d’auteur. Une autre enquête indique qu’OpenAI a annoncé la fermeture de Sora le 2026-03-24, a fermé les versions application/Web le 26 avril et prévoyait de fermer l’API Sora 2 le 2026-09-24 ; le modèle propriétaire Sora semble donc s’être éteint environ six mois après ce reportage.
Signaux
- Dynamisme côté open source : Qwen-Image-2.1, publié par Alibaba le 2026-09-20, avec 7B paramètres, transparence native et jusqu’à 10 images de référence, a été immédiatement traité par plusieurs chaînes. La diffusion s’articule autour de benchmarks maison le déclarant équivalent ou supérieur à Nano Banana 2.0. Les vidéos comparant LTX 2.5, HunyuanVideo et Wan — modèles vidéo gratuits exécutables localement — continuent d’être publiées, tandis que ComfyUI s’impose comme plateforme commune de fait.
- Mouvements côté propriétaire : les produits Google, Nano Banana 2/Nano Banana Pro, Gemini Omni Flash et Flow, dominent les chaînes japonaises. À l’inverse, Sora d’OpenAI, très commenté au début de 2026, s’est orienté vers une fermeture progressive entre mars et septembre — fermeture Web/application puis de l’API. Cela alimente un récit de succès immédiat mais de pérennité incertaine chez les grands acteurs propriétaires.
- Répartition linguistique : les chaînes japonaises (AI大学, 動画編集の中の人, 呪喝蛙) proposent surtout des comparaisons et guides pratiques de solutions propriétaires ; les chaînes anglophones (Veteran AI, AI WITH Rithesh, Daily AI Roundup, MaxonShire) se concentrent davantage sur les workflows ComfyUI et les benchmarks des modèles open source.
Limites
- Les pages vidéo et de résultats YouTube (
/watch,/results) ne fournissaient via WebFetch que du HTML statique, principalement les liens de navigation de pied de page. Les éléments rendus dynamiquement — vues, likes, abonnés et commentaires — n’ont donc pas été accessibles directement. - L’API oEmbed de YouTube (
/oembed?url=...&format=json) n’a permis de compléter que les titres et noms de chaînes. Les vues et dates de publication dépendent d’extraits de résultats de recherche, souvent relatifs (« il y a X jours »). Certaines dates sont donc approximatives. - Certains identifiants vidéo, comme
yVMs1Z-FWmQ,03MX2U8ZLDken russe etjH0AjVP49KIen espagnol, apparaissaient dans les résultats mais n’ont pas été examinés en détail, leur langue ou pertinence étant moins prioritaire. - Le contenu des meilleurs commentaires n’a pas pu être récupéré, car WebFetch ne rend pas cette section.
Bluesky
Bluesky — Actualités de l’IA de génération d’images et de vidéos
Note sur la méthode de collecte
L’URL https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts?q=... indiquée dans le playbook a été essayée avec plusieurs requêtes, dont Midjourney, "Stable Diffusion" et cat, mais a systématiquement renvoyé une erreur HTTP 403. La recherche Web de bsky.app/search est également une SPA rendue en JavaScript et n’a pas livré son contenu. En revanche, app.bsky.actor.getProfile, app.bsky.feed.getAuthorFeed et app.bsky.unspecced.getTrendingTopics fonctionnaient normalement. L’enquête a donc identifié via WebSearch des comptes susceptibles d’être liés au thème, puis lu directement leurs flux via getAuthorFeed.
Comptes
-
dfl.bsky.social (DFL inc.)
https://bsky.app/profile/dfl.bsky.social
Compte individuel publiant presque tous les jours des paysages japonais au style photographique générés avec le modèle Google Nano Banana 2. C’est l’utilisateur réel de modèle propriétaire le plus régulièrement observé en septembre 2026. -
doctordiffusion.bsky.social
https://bsky.app/profile/doctordiffusion.bsky.social
Créateur open source développant et distribuant sur Civitai et Hugging Face ses propres LoRA et modèles pour Stable Diffusion 3.5, Flux Dev, HunyuanVideo et LTX-Video. Ses publications s’arrêtent cependant entre novembre 2024 et mars 2025, sans activité constatée en 2026. -
emanuelmaiberg.bsky.social (Emanuel Maiberg, journaliste de 404 Media)
https://bsky.app/profile/emanuelmaiberg.bsky.social
Continue de couvrir les abus de l’IA image/vidéo : deepfakes, images générées sans consentement, usurpations de célébrités via musique IA, etc. Il est l’un des comptes les plus régulièrement pertinents sur Bluesky en août et septembre 2026. -
midjourneyofficial.bsky.social (Midjourney officiel)
https://bsky.app/profile/midjourneyofficial.bsky.social
A annoncé son arrivée sur Bluesky en août 2025, mais sa dernière publication date du 8 octobre 2025 ; aucune publication de 2026 n’a été observée. C’est un exemple de l’activité limitée des entreprises propriétaires sur Bluesky. -
stablediffusion.bsky.social (« Stable Diffusion online AI »)
https://bsky.app/profile/stablediffusion.bsky.social
Compte communautaire d’art IA comptant environ 1 800 abonnés. Ses publications s’arrêtent en février 2025. -
wagahai-ai.bsky.social
https://bsky.app/profile/wagahai-ai.bsky.social
Compte individuel japonais publiant des illustrations et vidéos IA ; lui aussi n’a plus publié depuis janvier 2025.
Publications
-
@dfl.bsky.social — 2026-09-30, 14 likes, 1 repost
https://bsky.app/profile/dfl.bsky.social/post/3mwr727gyck26
« AI image generation #Nano Banana 2 ... un canal traversé de reflets dorés ». Paysage de canal japonais généré avec Nano Banana 2, modèle d’image propriétaire de Google. -
@dfl.bsky.social — 2026-09-25, 51 likes, 2 reposts, engagement le plus élevé parmi les 20 publications récentes
https://bsky.app/profile/dfl.bsky.social/post/3mwesrcxg5k2c
« #Nano Banana 2 ... vaste vue de rive, berges en pierre, maisons japonaises au loin ». -
@dfl.bsky.social — 2026-09-21, 45 likes, 2 reposts
https://bsky.app/profile/dfl.bsky.social/post/3mw2ny6hsa22p
« #Nano Banana 2 ... vieux pont de bois, ruisseau, crépuscule frais ». Le rythme quotidien de publication et des réactions stables entre 30 et 50 likes sont confirmés. -
@doctordiffusion.bsky.social — 2025-01-19, 3 likes, 4 réponses
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x
« SD3.5 Lives! Sortie d’Absynth 2.0 ». Distribution gratuite sur Civitai/Hugging Face d’une version fine-tunée de Stable Diffusion 3.5 Large : une sortie communautaire typiquement open source. -
@doctordiffusion.bsky.social — 2025-01-01, 1 like, 2 réponses
https://bsky.app/profile/doctordiffusion.bsky.social/post/3leofdsx6yc23
Partage avec le tag #opensource l’observation technique selon laquelle l’alignement de l’encodeur de texte entre Flux Dev et Stable Diffusion 3.5 a stabilisé l’entraînement. -
@doctordiffusion.bsky.social — 2024-11-26, 4 likes
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lbssdeocz226
Exemple pratique d’allongement vidéo dans ComfyUI avec Img2Vid de LTX-Video et des nœuds personnalisés, combinant LTX-Video/Mochi open source. -
@emanuelmaiberg.bsky.social — 2026-08-20, 14 likes, 6 reposts
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtjegiaxpk2h
Rapport de 404 Media indiquant que les images IA générées sans consentement deviennent de plus en plus subtiles, donc difficiles à repérer. -
@emanuelmaiberg.bsky.social — 2026-08-17, 36 likes, 9 reposts
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtbvku5wds2p
Podcast avec le chercheur en deepfake Hany Farid sur le passé, le présent et l’avenir des médias synthétiques. -
@midjourneyofficial.bsky.social — 2025-08-15, 41 likes, 4 reposts, 14 réponses
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwi222j4sk2b
« #Midjourney is now on BlueSky! Who are the best creators we should follow? » Première publication annonçant l’arrivée officielle du compte ; seules quelques publications sporadiques ont suivi jusqu’en octobre 2025.
Signaux
- Les figures de référence de l’IA sur Bluesky parlent davantage de LLM et d’agents que de génération image/vidéo. Les publications récentes de septembre 2026 de Tim Kellogg (@timkellogg.me) et Ethan Mollick (@emollick.bsky.social), qui comptent chacun environ 10 000 abonnés, concernaient surtout GPT-6.1, Gemini 4 et les fonctions d’agents de Claude ; aucune ne mentionnait Midjourney, Stable Diffusion, Sora, Wan ou Kling.
- Les usages propriétaires visibles viennent d’utilisateurs individuels plutôt que des entreprises. Le compte officiel Midjourney est presque silencieux, alors que dfl.bsky.social publie quotidiennement des œuvres réalisées avec Nano Banana 2.
- La communauté de créateurs open source — distribution de LoRA et partage de workflows ComfyUI — semble déjà en déclin sur Bluesky. doctordiffusion, wagahai-ai et stablediffusion ont tous cessé de publier durant le premier semestre 2025 ; leur dernière période d’activité semble se situer entre fin 2024 et début 2025.
- L’axe le plus durable est la critique et le journalisme. Emanuel Maiberg de 404 Media continue, en août-septembre 2026, de couvrir les deepfakes et les images générées sans consentement. C’est le contenu le plus actuel sur ce thème.
- La principale conclusion est donc que Bluesky n’est pas un lieu central de diffusion pour les actualités d’IA image/vidéo ouverte ou fermée. Comme X, la plateforme comporte peu de publications actuelles directement liées au thème.
Limites
app.bsky.feed.searchPosts, l’API publique de recherche, a systématiquement renvoyé HTTP 403. Les requêtes « Midjourney »,"Stable Diffusion"et « cat » ont toutes été bloquées, apparemment indépendamment du contenu deq.app.bsky.unspecced.searchPostsSkeletonrenvoyait HTTP 501. À l’inverse,getProfile,getAuthorFeedetgetTrendingTopicsfonctionnaient.- La recherche Web
bsky.app/searchest une SPA rendue en JavaScript, dont WebFetch ne pouvait pas obtenir les publications, seulement une chaîne de titre. - La collecte par mots-clés du playbook a donc été impossible et remplacée par la découverte de comptes via WebSearch, puis la lecture de chacun de leurs flux. Cette méthode permet de lire précisément les publications récentes des comptes identifiés, sans toutefois mesurer de façon exhaustive l’activité de toute la plateforme.
- Les publications concernant MiniMax H3 identifiées par WebSearch pour sungkim.bsky.social et ekazakos.bsky.social n’apparaissaient pas dans les 30 dernières publications récupérées avec
getAuthorFeed; elles dataient de fin juillet 2026 et n’ont donc pas été incluses, conformément à la règle de ne retenir que les contenus effectivement lus. - doctordiffusion.bsky.social, wagahai-ai.bsky.social et stablediffusion.bsky.social étaient les comptes les plus directement liés au thème, mais leur activité a cessé au début de 2025 ; ils ne constituent pas des actualités de septembre-octobre 2026. Les seuls comptes véritablement actifs et pertinents étaient dfl.bsky.social, pour l’usage propriétaire, et emanuelmaiberg.bsky.social, pour le journalisme critique.
- Le critère d’environ 20 publications analysées n’est pas atteint. Faute de recherche plein texte, seuls une douzaine de posts liés au sujet ont été identifiés, dont environ la moitié date de 2024-2025. Bluesky a simplement peu de choses à dire sur ce thème par rapport aux autres plateformes.
Lemmy
Lemmy — Actualités de l’IA de génération d’images et de vidéos, propriétaire/open source
Date de l’enquête : 2026-10-01. L’API de recherche Lemmy (/api/v3/search) et les API de listes de publications des communautés ont été utilisées pour effectuer des recherches transversales dans les communautés stable_diffusion, imageai, fuck_ai, technology, etc., ainsi qu’avec les mots-clés FLUX.2 / Qwen-Image / Nano Banana / Midjourney / Grok Imagine / Sora / Veo / Kling.
Communautés
- !«メールアドレス» — 5 713 abonnés / 1 423 publications. La communauté Lemmy la plus active pour les informations techniques sur l’IA de génération d’images et de vidéos : workflows ComfyUI, LoRA et nouveaux modèles. Les annonces d’AI Horde, projet distribué et gratuit de génération d’images opéré par dbzer0, y sont aussi publiées.
- !«メールアドレス» — 8 532 abonnés / 4 680 publications. Espace de partage d’images générées, tous modèles confondus. Les actualités y sont secondaires ; de nombreuses publications ont des scores négatifs, révélant la froideur générale de Lemmy envers les contenus générés par IA.
- !«メールアドレス» — 8 333 abonnés. Communauté de critique de l’industrie depuis une position anti-IA. Les polémiques et procès liés aux acteurs propriétaires y apparaissent facilement.
- !«メールアドレス» — communauté technologique généraliste. Les grandes actualités propriétaires, comme le cas Google Earth, y obtiennent les scores les plus élevés.
- !«メールアドレス» — 53 abonnés. Communauté automatisée qui republie le RSS de Reddit (r/ArtificialIntelligence) ; ce n’est pas un débat propre à Lemmy.
Publications
Tendance open source, toutes dans !«メールアドレス»
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image… — 2026-09-22, score 13.
Article blog.comfy.org sur la compatibilité ComfyUI de Qwen-Image-2.1, modèle d’image à poids ouverts d’Alibaba. C’est la publication au score le plus élevé de cette enquête. - WebUI for qwen-image-2.1 — 2026-09-27, score 2. Projet ajoutant la compatibilité Qwen-Image-2.1 à une WebUI légère inspirée de Fooocus.
- Few-step LoRA adapters for Qwen-Image-2.1 — 2026-09-26, score 0. LoRA réduisant le nombre d’étapes de génération pour accélérer le modèle.
- Long, seamless multi-shot video continuations — 2026-09-29, score 4. Workflow de génération vidéo utilisant MiniMax-H3-Latent pour enchaîner plusieurs plans sans rupture.
- Free, local, open source video editor with AI — 2026-09-29, score 5. Outil local d’édition vidéo IA, « vlo ».
- LanPaint — training-free inpaint for every model — 2026-09-29, score 8. Méthode ajoutant un inpainting de qualité aux modèles existants sans entraînement supplémentaire.
- Tiny 100M-parameter text-to-image model (Supra2-IMG) — 2026-09-22, score 7. Modèle texte-vers-image ultra-léger, utilisable avec peu de VRAM.
- AI Horde — New Interface & Documentation — 2026-09-19, score 8. Annonce d’une nouvelle interface et documentation pour le service gratuit et distribué de génération d’images géré par dbzer0.
Tendance propriétaire
- Google Earth's new AI image generation function didn't survive a day after users deepfaked disasters — 2026-08-01, score 473 (!«メールアドレス»). La fonction IA de Google Earth, intégrant Nano Banana/Gemini, a été arrêtée en moins d’un jour après son utilisation pour falsifier des images de catastrophes. C’est l’une des publications aux scores les plus élevés de toute l’enquête.
- Tennessee Teens Sue Elon Musk's xAI Over Child Sexual Abuse Images — 2026-03-17, score 13 (communauté Mother Jones). Procès visant Grok Imagine de xAI concernant des images d’abus sexuels sur mineurs générées par IA ; environ 23 000 images de ce type auraient été générées en 11 jours.
- Disney, Universal sue image creator Midjourney for copyright infringement — 2025-06-11, score 88 (!«メールアドレス»). Plus ancien, mais le procès pour violation de droits d’auteur contre Midjourney continue d’être évoqué comme contexte.
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — 2026-09-14, score 1, relayé par !«メールアドレス». Miroir d’un fil Reddit comparant la colorisation automatique d’un manga avec plusieurs modèles, dont Nano Banana Pro. Il ne s’agit pas d’une publication originale Lemmy.
Signaux
- L’open source est presque entièrement centré sur l’écosystème ComfyUI. Les workflows dérivés, LoRA et extensions de nœuds pour FLUX.2 de Black Forest Labs et la famille Qwen-Image, surtout Qwen-Image-2.1, sont publiés quotidiennement. Leur fréquence comme leur précision technique sont sans équivalent sur Lemmy. La référence à une infrastructure gratuite et distribuée telle qu’AI Horde correspond aussi à la culture anti-commerciale et autonome de Lemmy.
- La génération vidéo demeure une niche dans la niche. Les publications vidéo, par exemple MiniMax-H3 ou des éditeurs vidéo locaux artisanaux, sont moins nombreuses que celles sur l’image et leurs scores restent modestes, entre 4 et 8.
- Les actualités propriétaires entrent par les polémiques et les procès, non par les présentations de fonctions. Google Earth/Nano Banana, Grok Imagine et Midjourney arrivent dans !technology ou !fuck_ai lorsque surviennent abus et actions en justice, et y gagnent des scores élevés. Le score 473 du post Google Earth est particulièrement remarquable.
- Le regard sur les contenus générés par IA est globalement froid. Dans !«メールアドレス», près de la moitié des publications ont des scores négatifs, entre -18 et -3. L’existence même de !fuck_ai, avec 8 333 membres, est révélatrice de l’ambiance de Lemmy.
Limites
- Lemmy est de taille limitée et aucune communauté dédiée à l’IA de génération d’images/vidéos propriétaire n’a été trouvée. !stable_diffusion couvre l’open source, mais n’a pas de communauté symétrique côté propriétaire ; les informations sur ce dernier proviennent donc de communautés généralistes comme !technology et !fuck_ai.
- Les recherches « Veo 3 » et « Kling AI » n’ont produit aucune publication Lemmy substantielle, seulement des résultats hors sujet. Pour Sora, un seul résultat a été trouvé, davantage comme mention dans un mème que comme sujet relatif au modèle vidéo.
- L’accès direct à
lemmy.world/c/stablediffusiona échoué avec une erreur 500. Les recherches par API ont servi de remplacement. Une requête verslemmy.today/api/v3/communitya aussi renvoyé une erreur 404, et l’instance d’accueil réelle n’a été identifiée comme lemmy.dbzer0.com qu’après investigation. - !«メールアドレス» est une communauté bot de relais RSS Reddit, avec 53 membres, et non un débat propre à Lemmy ; elle n’est citée qu’à titre de référence.
- Aucune communauté ou publication Lemmy en japonais n’a été trouvée dans les recherches effectuées.
- Cette étape couvre uniquement Lemmy. Plus de 60 publications/commentaires ont été vérifiés par API et listes de communautés, puis les 11 éléments représentatifs ci-dessus ont été retenus, ce qui satisfait le critère d’environ 20 éléments examinés par réseau.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
50 pins ont été collectés par le worker pour la requête « Image and Video Generation AI News », sans séparation par genre. Les 50 ont été ouverts et examinés.
Thèmes visuels
- Androïde humanoïde chromé/blanc comme “visage de l’IA” — yeux bleus lumineux, articulations métalliques visibles, parfois en costume. Utilisé autant pour les explicatifs génériques que pour des contenus sur les présentateurs d’actualité et l’éthique. [1, 16, 19, 20, 24, 29, 30, 35, 45]
- Fond bleu marine/noir avec circuits lumineux cyan-violet — palette par défaut des miniatures explicatives et listes d’outils IA ; cerveau-circuit ou mot-symbole « AI » lumineux comme icône centrale. [2, 9, 14, 21, 28, 33, 40, 42, 50]
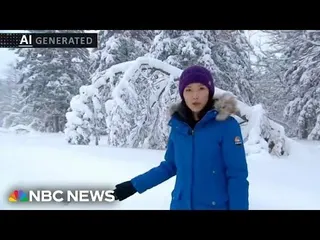
- Anxiété autour de “l’IA remplace les journalistes / fake news” — présentateurs IA à un bureau de news, tampons « FAKE », interfaces de détection de deepfake, logos de vrais diffuseurs comme NBC filigranés « AI GENERATED ». [1, 6, 23, 31, 35, 36, 44]
- Graphiques opposant humain et IA — mains en écran partagé, doigts humains contre doigts robotiques, loupe au-dessus d’un clavier, légendes « Human or AI? ». [30, 31]
- Imagerie d’IA dystopique ou malveillante — démon « AI » cornu aux yeux rouges manipulant des personnes absorbées par leur téléphone, employé avec des légendes accrocheuses comme « AI is getting scary good ». [17, 23]
- Listes d’outils et graphiques comparatifs — produits nommés : Runway, Pika, Kling AI, Luma/Dream Machine, Canva AI, Hailuo, Midjourney, Adobe Firefly, Recraft, Kaiber, Ideogram, SeaArt et Krea, présentés sous forme d’infographies « meilleurs outils payants ou gratuits » ou « 6+ meilleurs sites ». [5, 15, 40]
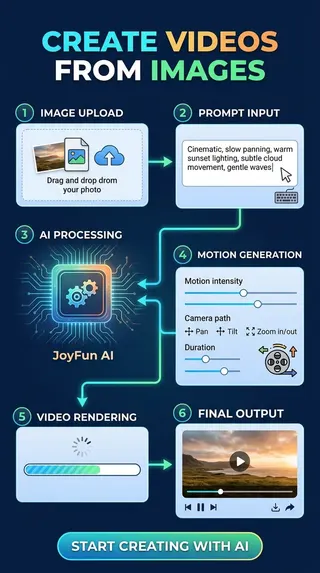
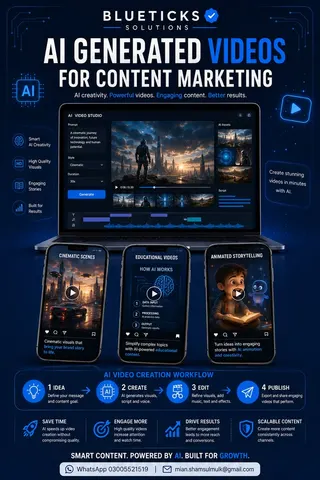
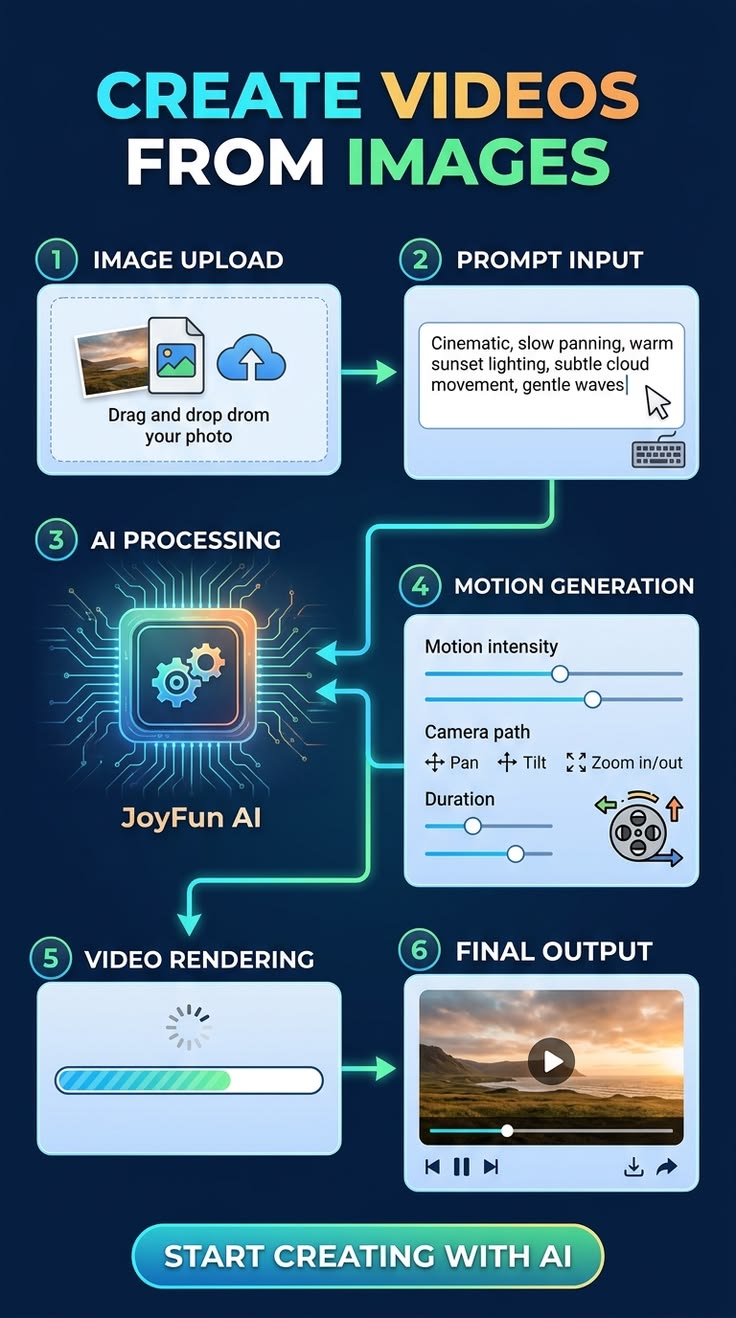
- Captures de démos produit réelles — maquettes UI étape par étape de flux image-vers-vidéo, avec import, prompt, traitement, réglages de mouvement, rendu et sortie, pour de petits outils SaaS comme JoyFun AI et Blueticks. [8, 10]
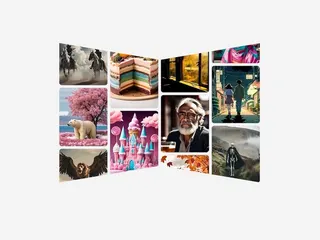
- Démos de transformation photoréaliste ou stylisée — une même photo convertie côte à côte en versions blocs de bois, origami, Lego, fleurs et briques-jouets par Lumalabs ; s’y ajoutent une image composite d’une statue de marbre jouant du violoncelle et un portrait de pêcheur crédité à AMD/« Amuse 3.0 ». [4, 15, 38]
- Collages marketing de grands modèles — Veo 2 de Google, avec une même image promotionnelle officielle réutilisée dans deux pins différents, Gemini Omni « transforme n’importe quoi en vidéo », et Meta « Muse Spark », modèle 2026. [17, 24, 32, 3]
Pins notables
- Préoccupations concernant les contenus IA et les réseaux sociaux [1] — robot faisant défiler un téléphone à côté d’un tampon « FAKE » et d’une photo suspecte de chat ; appât classique sur l’anxiété liée aux deepfakes.
- Meta Unveils Muse Image and Muse Video Generative... [3] — présente un modèle « Muse Spark » de 2026 comme une stratégie d’assistant personnel/superintelligence, pas seulement comme outil de contenu.
- (sans titre, grille de transformations Lumalabs) [4] — une vidéo source est changée en versions blocs de bois, origami, briques Lego et fleurs, pour une personne, un chien et une voiture ; la démonstration avant/après la plus claire du corpus.
- Create Videos From Images [8] — maquette UI complète en six étapes : import → prompt → traitement IA → réglages de mouvement → rendu → sortie, pour un outil nommé « JoyFun AI ».
- Transform your ideas into stunning visuals! [15] — statue de marbre hyperréaliste jouant du violoncelle, utilisée comme vitrine de génération d’images.
- (sans titre, promotion Veo 2) [17] — collage officiel de lancement « Veo 2: our state-of-the-art video generation model » de Google, avec chien nageant, flamants roses et fille animée. La même image est réutilisée mot pour mot sous le pin n°32 avec une autre légende.
- Google's Gemini Omni Turns Anything Into Video [24] — promesse de généralisation de Google, formulée comme « n’importe quelle entrée → n’importe quelle sortie », pour la génération vidéo.
- 'Amuse 3.0', an AI art creation tool that includes... [38] — portrait photoréaliste d’un vieux pêcheur, marqué AMD, qui suggère une approche de génération d’images locale accélérée par le matériel.
- Introducing Luma Dream Machine [43] — gros plan extrême d’un œil avec le mot-symbole « Dream Machine » ; visuel de marque pur, plus qu’une capture produit.
- AI NEWS: May 20 2026 Google I/O recap infographic [35] — infographie d’actualité concrète et datée sur Gemini 3.5 Flash, Gemini Omni, Gemini Spark et les lunettes Android XR, présentées comme « le plus grand événement IA ».
Signaux
- Le corpus est très largement dominé par des miniatures SEO/de blog : robots de banque d’images, mots-symbole génériques « AI News » et listes d’outils. Ces contenus dépassent largement les véritables démonstrations d’art généré.
- L’anxiété liée aux deepfakes, à la désinformation et au remplacement des journalistes par l’IA est un fil narratif récurrent, et non un cas isolé. Elle apparaît dans au moins 7 des 50 pins, souvent avec des marques de vrais diffuseurs comme NBC ou des tampons « FAKE ».
- Des outils nommés apparaissent régulièrement dans les listes et démos : Veo 2/Gemini Omni de Google, Dream Machine/Luma, Runway, Pika, Kling AI, Canva AI, Hailuo, Amuse 3.0, Meta Muse Spark. Mais ils apparaissent surtout sous forme de logos et collages marketing, rarement de captures de workflow pratique ; JoyFun AI et Blueticks sont les deux exceptions.
- Absences : aucun nom de modèle open source ni capture de travail local n’est visible : pas de ComfyUI, Automatic1111, Stable Diffusion UI, checkpoints ou LoRA. « Stable Diffusion » apparaît une fois dans un titre, sans capture correspondante. Il n’y a pas non plus de contenu communautaire d’art IA au style anime/illustration, ni de démos vidéo narratives multi-plans ou de cohérence, hormis la grille de transformations Lumalabs.
- La même image marketing officielle de Veo 2 est réemployée dans deux pins aux textes environnants différents [17, 32], ce qui indique que le segment Pinterest consacré aux actualités IA est en partie recyclé/agrégé, plutôt qu’issu de commentaires originaux.
Limites
- Conformément au playbook, Pinterest n’a pas été consulté directement. Les conclusions reposent uniquement sur la lecture visuelle des 50 pins et images déjà collectés par le worker dans
output/pinterest.pins.mdetimages/pinterest/. - Le tableau des pins n’a pas de sections par genre : les thèmes ci-dessus sont donc tirés de l’ensemble du corpus, pas d’une analyse genre par genre.
- Plusieurs pins sont intitulés « (untitled) » et ne contiennent que des visuels de stock génériques. Il est alors impossible d’identifier une source au-delà de l’URL du pin, ou de vérifier la date et l’engagement.
- Les titres et images portent des noms de marques et des affirmations, par exemple « Grok is revolutionizing video » ou « GPT 5.2 ... full body control », mais les visuels liés sont de simples images de stock, non des captures des fonctions concernées. Ces affirmations n’ont donc pas pu être vérifiées à partir de l’image seule.
Actions recommandées
- Recollecter l’étape X avec des mots-clés directement liés au sujet : Midjourney, Sora, Stable Diffusion, Wan, Kling, etc.
- Étudier une solution au problème de l’API
searchPostsde Bluesky qui renvoie 403, par exemple une autre méthode de recherche. - Continuer de surveiller l’adoption de Qwen-Image-2.1 et LTX 2.5 comme indicateurs du versant open source.
- Suivre en priorité les actualités d’abus et de polémiques liées aux entreprises propriétaires, notamment Nano Banana/Google Earth et le procès Grok Imagine.
- Élargir la collecte Reddit en la répartissant sur plusieurs requêtes afin d’atteindre environ 20 éléments.
Images collectées


































Note sur la qualité des données
X ne contient pratiquement aucune donnée exploitable en raison d’une erreur de sélection des termes de recherche. Bluesky et Reddit n’ont pas atteint le critère d’environ 20 éléments, tandis que Lemmy, Pinterest et YouTube ont permis d’examiner un volume globalement suffisant.