Actualités de l’IA de génération d’images et de vidéos — 2026-09-28
OpenAI a mis fin à Sora (application + API) le 2026-09-24, amorçant une recomposition des acteurs fermés de la vidéo, tandis que Qwen-Image-2.1, modèle léger de 7B, et Minimax H3 se sont imposés indépendamment comme les principaux modèles ouverts sur quatre plateformes.
OpenAI a mis fin à Sora (application + API) le 2026-09-24, amorçant une recomposition des acteurs fermés de la vidéo, tandis que Qwen-Image-2.1, modèle léger de 7B, et Minimax H3 se sont imposés indépendamment comme les principaux modèles ouverts sur quatre plateformes.
Actualités de l’IA de génération d’images et de vidéos — 2026-09-28
Salut tout le monde, désolé de vous avoir fait attendre ! Le monde de l’IA de génération d’images et de vidéos a été en ébullition cette semaine, alors voici le récap 🔥🔥 La plus grosse nouvelle est qu’OpenAI a brutalement arrêté Sora — l’application comme l’API — le 2026-09-24 : la question « est-ce que la génération vidéo peut être rentable ? » est enfin passée sur le devant de la scène. Du côté de l’open source, Qwen-Image-2.1 d’Alibaba (à peine 7B de paramètres, mais déjà proche des gros modèles fermés 🐉) et Minimax H3 ont clairement pris le rôle principal, et la communauté semble même plus enthousiaste à leur sujet. Mais toutes les plateformes sociales ne partagent pas la même humeur : les espaces techniques (r/StableDiffusion, la communauté stable_diffusion de Lemmy et les utilisateurs de ComfyUI sur YouTube) s’animent autour de comparaisons d’outils sérieuses, tandis que les espaces généralistes (les grands subreddits de Reddit et Pinterest) font surtout viraliser la méfiance du type « ces images IA ne vont pas un peu trop loin ? ». C’est l’une des grandes conclusions de cette édition 🙌 Et, fait assez inattendu, X a complètement raté le sujet cette fois-ci (j’explique pourquoi plus loin).
À travers les plateformes
Ce qu’il faut retenir du côté des solutions fermées (13 points au total 📸)
- OpenAI a entièrement arrêté Sora (application + API pour développeurs) le 2026-09-24. Cette sortie est décrite comme particulièrement précipitée — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- L’explication la plus crédible est que l’économie unitaire de la génération vidéo était trop mauvaise — Bluesky https://bsky.app/profile/richargh.de/post/3mhur4qo3vc2x
- Des informations indiquent aussi que Wan 3.0 d’Alibaba aurait dépassé Sora dans les classements de modèles vidéo — YouTube https://www.youtube.com/watch?v=5Hb429VYNUU
- GPT Image 2.5 arrive avec deux modes, Flare (vitesse) et Sunburst (détail), une latence divisée par deux et une meilleure fidélité aux images de référence — YouTube https://www.youtube.com/watch?v=QOfLgJ3TCrQ
- Midjourney a ajouté des aperçus de style en direct dans son alpha et continue d’avancer par mises à jour mensuelles, de V8 à V8.1 puis V8.2 — Bluesky https://gen-ai.news/stories/edit-updates-thumbnail-previews-and-more-20d5ed / YouTube https://www.youtube.com/watch?v=dvfH5HzCARY
- Adobe a intégré Photoshop, Lightroom, Firefly et Acrobat afin qu’ils puissent être utilisés directement depuis les chats Gemini et Claude — Bluesky https://gen-ai.news/stories/adobe-expands-its-ai-integrations-to-gemini-plus-further-powers-up-with-claude-6737b7
- Adobe a finalisé l’acquisition de Topaz Labs et intégrera rapidement ses technologies d’upscaling IA à Firefly et Photoshop — Bluesky https://gen-ai.news/stories/adobe-s-acquisition-of-topaz-labs-is-complete-as-double-down-on-ai-enhancements--3c3f96
- OpenAI a acquis la startup de traitement photographique Glass Imaging pour 300 millions de dollars, afin de couvrir la chaîne allant de la prise de vue à la génération — Bluesky https://gen-ai.news/stories/openai-reportedly-buys-photo-processing-company-glass-imaging-for-300-million-e004d2
- « Dramagic » de ByteDance est un pipeline complet qui génère par IA 95 % des mini-séries chinoises sans équipe de tournage humaine — Bluesky https://gen-ai.news/stories/bytedance-launches-dramagic-a-full-pipeline-ai-platform-for-producing-short-dram-20f217
- Runway développe les modèles de monde en temps réel GWM-1/GWM-2, qui comprennent continuellement un environnement au lieu de simplement générer des clips — Bluesky https://gen-ai.news/stories/runway-s-worldprompt-and-the-engineering-of-real-time-worlds-80e2b7
- Veo3, via l’API Gemini, prend en charge une génération image-vers-vidéo rapide avec audio natif ; Pinterest voit aussi se multiplier les contenus promotionnels associés — Pinterest https://www.pinterest.com/pin/871728071631063018/
- Une comparaison directe entre Kling 3.0, Grok Imagine, Runway Gen-4.5 et Veo 3.1 a également fait parler d’elle — YouTube https://www.youtube.com/watch?v=x5fMQvhKP60
- Le grand public consomme souvent les images et vidéos IA fermées comme des scandales : indignation face à des photos immobilières embellies par IA (27 008 points) — Reddit https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ , licenciement d’un PDG pour une image IA (594 points) — Reddit https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/ , et large soutien à une loi imposant des filigranes IA (13 925 commentaires) — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
Ce qu’il faut retenir du côté open source (12 points ici aussi 🛠️)
- Alibaba a publié Qwen-Image-2.1, un modèle open-weight léger de 7B, intégrant génération et édition, calques transparents et jusqu’à 10 images de référence — Bluesky https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r 、Lemmy https://lemmy.dbzer0.com/post/75874773 、YouTube https://www.youtube.com/watch?v=3qGl0wiv2G0
- Certains vont jusqu’à affirmer que Qwen-Image-2.1 dépasse le gigantesque modèle fermé de Google, « Nano Banana 2.0 », sur certaines tâches — YouTube https://www.youtube.com/watch?v=fwHS0ubmI7I
- Chez r/StableDiffusion, Krea 2 aurait remplacé Z-Image Turbo comme modèle vedette — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Des LoRA d’accélération pour Krea2, dont Turbo-Distill et inpaint-edit, continuent d’être publiés sur Lemmy — Lemmy https://lemmy.dbzer0.com (communauté stable_diffusion)
- Pour la vidéo, Minimax H3 est devenu le terrain central de l’open source ; les outils périphériques — AutoContext, interface de contrôle de caméra 3D, nœuds d’édition de timeline et LoRA TaoMate-H3 — se multiplient chaque semaine — Lemmy https://lemmy.dbzer0.com/post/75586069
- SenseNova-U1.5 a été publié sous licence Apache-2.0 et est déjà intégré à ComfyUI — Reddit r/StableDiffusion (fil 11)
- LTX-2.5 arrive comme modèle vidéo open-weight rapide, rivalisant avec MiniMax H3 et Seedance 2.5 en vitesse — YouTube https://www.youtube.com/watch?v=qVGpyw-F-rw
- Wan 3.0 n’est actuellement disponible que par API/bêta publique et n’a pas encore été publié en open weight (les anciennes versions Wan2.x l’étaient) ; Alibaba garde un pied dans les deux approches — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
- SupraLabs/Supra2-IMG, un modèle text-to-image extrêmement léger de seulement 100 millions de paramètres, fait parler de lui pour une qualité de pointe au regard de sa taille — Lemmy https://lemmy.dbzer0.com/post/75874769
- well9472/Nanosaur2-670M, un modèle DiT spécialisé dans l’illustration, entraîné pour seulement 600 dollars, vient d’apparaître — Lemmy https://lemmy.dbzer0.com/post/76110122
- AI Horde, le service distribué et gratuit de génération d’images, a entièrement renouvelé son interface, son frontend et son backend — Lemmy https://lemmy.dbzer0.com/post/75736717
- « Amuse 3.0 » de Stability AI, outil de génération d’images local soutenu par AMD, est également présenté sur Pinterest — Pinterest https://www.pinterest.com/pin/4601060441986715264/
Qwen-Image-2.1 et Minimax H3 ont été identifiés indépendamment comme les meilleurs modèles ouverts actuels sur quatre plateformes — Reddit, Lemmy, Bluesky et YouTube. C’est un signal vraiment solide 🙆
Plateforme par plateforme
Reddit : une seule requête n’a remonté que 12 fils, mais leur contenu est dense. Dans les échanges techniques de r/StableDiffusion, Krea 2, Qwen-Image 2.1 et Minimax H3 sont nommés comme les gagnants actuels. À l’inverse, dans les grands subreddits généralistes tels que r/mildlyinfuriating et r/CriticalState, les scandales du type « l’IA a embelli » ou « l’IA a menti » deviennent viraux à une échelle sans commune mesure, de plusieurs milliers à plus de 10 000 points. Le meilleur fil technique atteint 13 points, tandis que le soupçon de fraude au Nikon Small World atteint 1 104 points : cet écart de température illustre parfaitement la différence de réception entre les usages ouverts et fermés.
X : cette fois, c’est presque un échec total pour le thème 😅 La connexion de session était géolocalisée en Croatie, et les termes en tendance d’Explore — crypto, spam de concours, fandom F1, disputes historiques de l’ex-Yougoslavie, photos touristiques et Taylor Swift — ont été recherchés tels quels. Résultat : parmi 40 publications, aucune ne contenait « IA », « génération d’images » ou « génération de vidéos ». L’objectif quantitatif de 20 publications est atteint, mais le taux de pertinence thématique est de 0 %.
YouTube : 11 vidéos de test couvrent les principaux lancements, notamment GPT Image 2.5, Qwen-Image-2.1, LTX-2.5 et Wan 3.0. Côté open source, les vidéos d’installation ComfyUI vérifiant la vitesse d’exécution sur son propre GPU sont nombreuses ; du côté fermé, des formats de suivi récurrent comme les mises à jour mensuelles de Midjourney se sont installés. Toutefois, les vues et les noms de nombreuses chaînes n’ont pas pu être récupérés, ce qui empêche de mesurer l’ampleur réelle de l’intérêt.
Bluesky : le compte d’actualités automatisé gen-ai.news est au centre des sources de cette édition, avec une forte densité d’informations sur les offres fermées : Runway, Adobe, Midjourney, OpenAI, Meta et ByteDance annoncent presque quelque chose tous les jours. La publication sur l’arrêt de Sora, avec 3 571 mentions J’aime, est le plus gros succès de cette partie de l’étude. Côté open source, en dehors de Qwen-Image-2.1 avec 82 mentions J’aime, les publications portent surtout sur des contenus anciens du début de 2025 ; presque aucune publication personnelle récente sur Wan ou LTX n’a été trouvée.
Lemmy : !«メールアドレス» est le seul véritable hub. Les nouveautés des outils ComfyUI autour de Qwen-Image-2.1 et Minimax H3 y arrivent presque quotidiennement, ce qui donne au lieu l’allure d’une liste de nouveaux liens GitHub/HuggingFace. Il n’existe pas de communauté dédiée aux solutions fermées ; leurs controverses — retouches raciales à Stanford, fausses images satellites Google Earth ou publicités Meta pour des applications de déshabillage par IA — arrivent ponctuellement dans des communautés généralistes telles que technology, nottheonion ou dcstudios.
Pinterest : un espace strictement visuel sans chiffres d’engagement récupérables. Parmi les 50 épingles collectées, les miniatures à logo de solutions fermées telles que Veo3, Kling AI, Luma Dream Machine et Gemini Omni dominent presque entièrement. Une seule image liée à Stability AI a été trouvée pour l’open source, sans contenu centré sur ComfyUI, les LoRA ou les modèles OSS chinois. Les infographies expliquant comment distinguer une création IA d’un contenu réel forment également un genre à part entière, typique de Pinterest.
À surveiller
- L’élargissement de l’implémentation de Qwen-Image-2.1 dans ComfyUI — Lemmy https://lemmy.dbzer0.com/post/75874773
- Le rythme de prolifération des outils autour de Minimax H3, notamment AutoContext et TaoMate-H3 LoRA — Lemmy https://lemmy.dbzer0.com/post/75586069
- La recomposition de la génération vidéo après l’arrêt de Sora, autour de Veo, Kling, Grok, Runway et Seedance — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- L’élargissement du soutien aux lois imposant un filigrane IA — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
- La capacité de Krea 2 à détrôner totalement Z-Image Turbo — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Le choix de Wan 3.0 : publication open weight ou poursuite d’une stratégie fermée — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
Recommandations
- Vérifier chaque semaine l’écosystème ComfyUI autour de Qwen-Image-2.1 et Minimax H3, car plusieurs plateformes les confirment indépendamment comme les meilleurs modèles ouverts actuels.
- Lors de la prochaine collecte sur X, abandonner les tendances régionales et rechercher directement des mots-clés anglais et japonais tels que « image generation AI », « Stable Diffusion » et « Midjourney ».
- Suivre les prix et la concurrence fonctionnelle des acteurs fermés de la vidéo après Sora — Veo, Kling, Grok, Runway et Seedance — car le marché est en cours de contraction et de recomposition.
- Utiliser Pinterest surtout comme référence pour observer les langages visuels actuels, plutôt que pour évaluer les tendances, faute d’indicateurs d’ampleur tels que les enregistrements ou les mentions J’aime.
- Continuer à surveiller la méfiance à l’égard des contenus générés par IA, commune à Reddit, Lemmy et Pinterest, car elle influence directement le climat réglementaire autour de l’obligation de filigrane.
- Lors d’une nouvelle collecte sur Reddit, utiliser des requêtes distinctes pour « open source » et « closed source », afin d’augmenter le nombre de résultats et de se rapprocher du critère de 20 analyses par plateforme.
Qualité des données
X a subi un échec de collecte réel : une erreur de géolocalisation et des recherches fondées sur des tendances ont conduit à 0 publication pertinente sur 40. Bluesky n’a pas pu utiliser l’API officielle de recherche, qui renvoyait une erreur 403, et dépend fortement des articles d’un seul compte, gen-ai.news. Pinterest ne fournit pas de métriques d’engagement telles que les enregistrements ou les mentions J’aime ; YouTube n’a pas permis de récupérer de nombreuses données sur les vues et les chaînes. Les informations open source de Lemmy sont concentrées sur une seule communauté et un ou deux auteurs, et Reddit n’a remonté que 12 fils avec une seule requête, au lieu des 20 attendus.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
12 fils recueillis dans 9 subreddits, tous remontés par une seule recherche : "Image and Video Generation AI News".
| Subreddit | Membres | Fils recueillis |
|---|---|---|
| r/generativeAI | 157,870 | 3 |
| r/labrats | 726,970 | 2 |
| r/WhitePeopleTwitter | 3,145,768 | 1 |
| r/mildlyinfuriating | 12,600,570 | 1 |
| r/CriticalState | 43,691 | 1 |
| r/aivideomaking | 7,949 | 1 |
| r/ChaiUnofficial | 30,105 | 1 |
| r/StableDiffusion | 1,026,206 | 1 |
| r/AmItheAsshole | 24,612,930 | 1 |
r/generativeAI est le seul hub récurrent des discussions sur les recommandations d’outils. Les autres sont des apparitions isolées — essentiellement de très grands subreddits grand public (r/mildlyinfuriating, r/AmItheAsshole, r/WhitePeopleTwitter) réagissant à des contenus générés par IA plutôt que discutant de la technologie, ainsi que r/labrats, où un même scandale est traité dans deux fils.
Ce que disent les gens
- Fil 1 (r/generativeAI, 10 points, 2026-09-23) — À propos de la création de vidéos IA longues : u/kaboom-o décrit le pipeline actuel — « Les scripts deviennent une liste de plans, puis une pile de clips de 5 à 15 s, puis un montage… Pour les clips qui doivent conserver un visage plus longtemps, Seedance 2.5 (jusqu’à ~30 s, audio natif)… Pour les brouillons de mouvement bon marché… Grok Imagine Video en 480p, 5 s. Pour les résultats photoréalistes : Gemini Omni Flash. » — https://www.reddit.com/r/generativeAI/comments/1wog53q/
- Fil 1 — u/AlfieSchmalfie montre le coût réel d’une œuvre terminée : « Je viens de terminer une vidéo de 12 minutes. 148 plans… 8 semaines de montage. Budget d’environ 1 000 AUD, sans compter les abonnements à Runway et ElevenLabs… Cela en valait la peine. »
- Fils 2 et 4 (r/labrats, 1 104 pts / 134 commentaires et 419 pts / 90 commentaires, 2026-09-23/24) — Une vidéo de microscopie générée par IA a remporté le concours Nikon Small World in Motion ; Nikon a reconnu que l’IA avait été utilisée pour « améliorer » et appliquer de fausses couleurs. u/Barkinsons (630 votes positifs) : « Les outils IA n’ont pas leur place dans les images de microscopie scientifique, parce que nous avons l’obligation de reproduire nos images aussi fidèlement que possible. » L’auteur a ensuite admis qu’une « IA non supervisée avait été utilisée pour segmenter et étiqueter » des structures jamais vérifiées comme réelles ; u/Feline_Diabetes (301) : « C’est absolument trompeur… les images devraient être plus ou moins réelles — traitées, bien sûr, mais pas des rendus IA. » — https://www.reddit.com/r/labrats/comments/1wo0j5e/ and https://www.reddit.com/r/labrats/comments/1woxdhk/
- Fil 3 (r/generativeAI, 3 points, 2026-09-26) — Une personne cherchant de la génération d’images gratuite reçoit des recommandations d’options locales et gratuites : u/Scuzzy_Womack conseille « Comfy ui, non connecté à Internet et gratuit », tandis que d’autres suggèrent Yodayo/MoescapeAI et Leonardo pour leurs crédits quotidiens gratuits. — https://www.reddit.com/r/generativeAI/comments/1wqfleb/
- Fil 5 (r/generativeAI, 5 points, 2026-09-22) — Sur les générateurs vidéo, u/sharktank123456 signale un changement de plateforme : « Dream Machine n’est plus disponible pour les nouveaux abonnés, mais Luma Agents l’est… une plateforme complète avec tous les grands modèles. » u/jmbirn note que les services agrégateurs — Magnific AI, Fal et Krea — sont le moyen pratique de tester de nombreux modèles avec un seul compte. — https://www.reddit.com/r/generativeAI/comments/1wngj3w/
- Fil 6 (r/WhitePeopleTwitter, 594 points, 2026-09-25) — Un PDG d’une coopérative de crédit a été licencié après une image générée par IA de « Lake America sweaters » ; le commentaire principal, par u/samanime (298), dit : « Si davantage d’idiots comme lui subissaient des conséquences, il y en aurait beaucoup moins. » — https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/
- Fil 7 (r/mildlyinfuriating, 27 008 points, 723 commentaires, 2026-09-21) — Frustration face à des photos immobilières « mises en scène » par IA : « Je veux juste voir la maison telle qu’elle est aujourd’hui, sans avoir à analyser ce qui est réel ou non… l’IA peut par exemple retirer des radiateurs, alors qu’on ne pourrait jamais réellement aménager le lieu comme montré. » Le commentaire principal, par u/slothboy (5 794 pts), souligne qu’une salle de bains ajoutée par IA serait « un projet à cinq chiffres » à construire réellement. — https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/
- Fil 8 (r/CriticalState, 1 314 points, 13 925 commentaires, 2026-09-21) — Une « proposition de loi » sous forme de sondage imposant un filigrane sur toutes les images et tous les textes générés par IA connaît un engagement massif ; les commentaires les plus populaires sont des votes succincts « Oui ✅ », invoquant les risques de désinformation et la protection des personnes âgées face aux arnaques (u/Middle_Juggernaut298 : « À cause des personnes âgées qui se font escroquer ou autre chose. »). — https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Fil 9 (r/aivideomaking, 13 points, 2026-09-23) — Sur la génération de prompts pour la vidéo IA, u/3DisMzAnoMalEE : « Après quelques centaines de prompts et l’ajustement des gates, du cfg et surtout des prompts négatifs, c’est Grok qui était de loin le meilleur… aussi bien pour le contenu SFW que NSFW, difficile de le battre. » — https://www.reddit.com/r/aivideomaking/comments/1wo38ww/
- Fil 11 (r/StableDiffusion, 1 point, 2026-09-25) — Le récapitulatif open source le plus technique de l’échantillon : le consensus est que le domaine vient de passer de Z-Image Turbo à Krea 2 pour le text-to-image (« Au lieu de z image, c’est maintenant kre2… Krea2 fait tout ce que z image pouvait faire, mais en mieux » — u/Sirmckhalifa5566), Qwen-Image 2.1 pour l’édition et Minimax H3 en tête pour la vidéo. u/Cultural-Broccoli-41 signale également SenseNova-U1.5 comme solide alternative sous licence Apache-2.0, déjà connectée à ComfyUI. — https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Fil 10 (r/ChaiUnofficial, 5 points, 2026-09-21) — Les utilisateurs payants (« ultra ») sont mécontents d’un générateur image/vidéo ajouté à la hâte : u/ConsistentWolf2076 : « La génération d’images et de vidéos aurait dû être gratuite. Les images et vidéos ne sont même pas si bonnes. Je peux mieux dessiner que générer des images lol. » — https://www.reddit.com/r/ChaiUnofficial/comments/1wlxxa3/
Signaux
- En hausse : la valse des noms et versions est rapide et suivie naturellement par les praticiens — Z-Image Turbo a été remplacé par Krea 2, et Minimax H3 est régulièrement cité comme le meilleur modèle actuel pour la vidéo (fils 1, 9 et 11), avec presque aucun désaccord dans le public technique. La licence Apache-2.0 de SenseNova-U1.5 et son support natif de ComfyUI (fil 11) constituent le point de données open source suscitant le plus d’enthousiasme réel.
- En hausse : les plateformes agrégatrices et multi-modèles — Luma Agents, OneOver, Magnific AI/Fal/Krea — sont recommandées plutôt que les abonnements à un modèle unique, car les utilisateurs changent de modèles au milieu de leurs projets (fils 1 et 5).
- Rejet / retour de bâton : hors des subreddits centrés sur les outils, toute apparition d’images IA dans un contexte réel est lue comme un scandale, pas comme une innovation — victoire dans une compétition scientifique (labrats, deux fils, 1 104 + 419 points), licenciement d’un PDG (594 points), fraude aux photos immobilières (27 008 points) et sondage explosif sur une loi de filigrane (13 925 commentaires). Les subreddits techniques traitent les mêmes outils de manière neutre ; les subreddits généralistes y voient un problème de confiance.
- Surprenant : les deux fils Nikon Small World ont suscité bien plus d’engagement et d’énergie morale — 1 104 et 419 points, 134 et 90 commentaires — que n’importe quel fil demandant quel modèle est le meilleur ; le meilleur fil d’outils sur generativeAI/StableDiffusion plafonne à 13 points. Sur Reddit aujourd’hui, « une vidéo IA a fait quelque chose de malhonnête » attire plus que « une vidéo IA fait quelque chose de nouveau ».
- Désaccord : dans le fil 4, certains commentateurs estiment que toute utilisation d’IA en imagerie scientifique relève directement de la fraude (« Toute personne qui modifie le blot réel est une fraude », selon l’auteur du post), tandis que d’autres, comme u/thezfisher (44 pts), soutiennent que l’imagerie a toujours été manipulée et qu’il s’agit seulement d’un problème de visibilité : « aucune image n’est vraiment fiable aujourd’hui à moins qu’ils montrent leurs ajustements LUT. »
Limites
- Une seule requête — « Image and Video Generation AI News » — a été exécutée sur Reddit ; elle a renvoyé 12 fils, en dessous des ~20 demandés par les critères de complétion. Aucune recherche distincte sur les angles « open source » et « closed source » n’a été faite ; la collecte sous-estime donc probablement les discussions dédiées aux lancements de modèles.
- Le fil technique le plus pertinent, r/StableDiffusion, fil 11, n’avait qu’un vote positif et 20 commentaires : son contenu est bon, mais cela laisse penser que la requête a davantage fait remonter la viralité liée aux controverses que les espaces de discussion propres aux communautés techniques.
- Aucun fil de cet ensemble ne mentionne directement le lancement d’un modèle fermé, un changement de prix ou une annonce d’entreprise — Midjourney, Sora, Veo ou Runway, par exemple. Le signal sur les solutions fermées est indirect et provient de mentions dans des fils de recommandation, non de publications d’actualité dédiées.
- Il est impossible de vérifier indépendamment ces chiffres ou de consulter de nouveau Reddit : ce fichier repose entièrement sur
output/reddit.threads.md, Reddit refusant WebFetch et bloquant directement les pages de résultats de recherche.
X
X — Actualités de l’IA de génération d’images et de vidéos
Comptes
Parmi les 40 publications et 39 comptes recueillis cette fois, aucun compte ne publiait sur l’IA de génération d’images ou de vidéos, qu’elle soit fermée ou open source. Si l’on force une classification, on trouve :
- Crypto-monnaies, notamment les jetons $ADA/$SONG : @Nadalina04 (2 publications, 25 mentions J’aime), @SintoAndrej, @EAjdarovic — publications de promotion de la communauté Cardano.
- Rafales de spam de concours et cadeaux : @CSharp66427821, @dwayne_lepley, @DustinThel46652, @Jordan95133426 — plusieurs comptes publient de façon semblable le même texte, « Quad Goals by @Fanatics », avec des hashtags différents et presque aucun engagement.
- Culture jeu vidéo/joueurs : @hotdropfps (concours PC, 287 mentions J’aime), @Maki_D_Luffy, @Indie_RetroNEWS.
- Fandom F1 autour de Lando Norris : @ckno_ff, @4unclelala, @landoxeneize, @alukelipse — tous publient des conflits et débats entre fans autour de Norris, avec plusieurs centaines à plusieurs milliers de mentions J’aime.
- Histoire politique de l’ex-Yougoslavie et des Balkans, y compris des antagonismes ethniques : @TwiceDeadd (2 282 mentions J’aime, parmi les plus grands engagements), @mctogs, @vbspurs, @axeljarcor, @OssoKuka, @walsh_kirk91371, @jeffreybacic, @vragan95 — publications controversées sur les conflits historiques entre la Serbie et la Croatie. En règle générale, un compte publie une fois ; la forte viralité vient surtout d’une publication de @TwiceDeadd.
- Photos de paysages italiens : @prjipata (collection de mode Tod's), @PrettyCitiesX, @worldparadiseX (3 930 mentions J’aime), @naturalbeautyi7 (2 666 mentions J’aime) — photos de lieux touristiques attractifs.
- Contenus autour de Taylor Swift : @_daddydisco (67 235 mentions J’aime, environ 1,2 million de vues, le plus gros succès de cette collecte), @psychocrzzzy, @wandasattorney, @TSUpdating — records de ventes du nouvel album et sujets liés aux VMAs.
Publications
Aucune des 40 publications ne mentionne l’IA de génération d’images ou de vidéos. À titre indicatif, les publications les plus engageantes sont listées ci-dessous, mais elles sont toutes hors sujet.
- @_daddydisco (67 235 mentions J’aime, 4 941 reposts, 191 réponses, environ 1,2 million de vues, 2026-09-26) https://x.com/_daddydisco/status/2103642992342860157 — Poème métaphorique évoquant « un visage qui devient de l’argile ». C’est le plus gros succès de toute la collecte, sans lien avec l’IA.
- @wandasattorney (6 842 mentions J’aime, environ 138 000 vues, 2026-09-28) https://x.com/wandasattorney/status/2104362546107191455 — Sujet lié aux VMAs : « LISA winning best pop over Taylor Swift… ».
- @TwiceDeadd (2 282 mentions J’aime, 295 reposts, 55 réponses, environ 35 000 vues, 2026-09-27) https://x.com/TwiceDeadd/status/2104209913228771333 — Blague politique balkanique « we gotta try yugoslavia again », largement diffusée.
- @worldparadiseX (3 930 mentions J’aime, environ 91 000 vues, 2026-09-26) https://x.com/worldparadiseX/status/2103775750486986847 — Photo du paysage de Passo Giau, en Italie.
- @psychocrzzzy (2 995 mentions J’aime, environ 60 000 vues, 2026-09-27) https://x.com/psychocrzzzy/status/2104213800610152704 — Sujet sur le record Spotify d’une nouvelle chanson de Taylor Swift.
Toutes ces publications sont sans rapport avec l’évolution de l’IA de génération d’images et de vidéos, fermée ou open source : annonces de modèles, mises à jour d’outils ou discussions comparatives.
Signaux
- Les requêtes utilisées étaient hors sujet : les termes de recherche employés — « $SONG », « #chance », « #sweepstakes », « #giveaways », « #gaming », « Lando », « Yugoslavia », « Croats », « Italy », « Taylor » — ne sont pas liés à l’IA image/vidéo. Ils semblent provenir directement des tendances affichées dans X Explore, réglé sur la Croatie en raison de la localisation de session. Les résultats se concentrent donc sur la crypto, le spam de concours, les fans de F1, les querelles historiques balkaniques, les photos touristiques et Taylor Swift, sans trace d’actualité IA.
- Parmi 40 publications, aucune ne contient les mots-clés « AI », « génération d’images », « génération de vidéos », « Midjourney », « Stable Diffusion » ou « Sora ».
- Il n’existe même pas une seule publication permettant une association raisonnable avec l’IA ; il faut éviter d’en créer artificiellement une.
Limites
- La liste de tendances de X Explore est géolocalisée en Croatie d’après l’origine de la session. Les tendances 1 à 4, 8 et 10 sont indiquées comme « Trending in Croatia » ; les autres relèvent de Gaming, Motorsport, Politics ou Sports. Elles reflètent une tendance locale croate, pas une tendance mondiale, et encore moins une tendance du secteur de l’IA.
- Les 10 termes effectivement recherchés — $SONG, #chance, #sweepstakes, #giveaways, #gaming, Lando, Yugoslavia, Croats, Italy et Taylor — semblent avoir été repris directement des tendances Explore par le collecteur, sans rapport avec le thème de la génération IA. Aucune collecte n’a donc été menée avec des termes pertinents comme « image generation AI », « video generation AI », « Stable Diffusion », « Midjourney » ou « Sora ».
- Le critère de « l’analyse d’environ 20 publications » est atteint quantitativement avec 40 publications, mais aucune n’est pertinente. Les exigences de dix observations minimum pour le fermé et l’open source ne peuvent donc pas être satisfaites à partir des données X.
- En dehors des fichiers déjà collectés —
output/x.posts.mdetoutput/x.posts.json— aucun accès supplémentaire à X n’était disponible ; une nouvelle collecte fondée sur des mots-clés pertinents dépassait les autorisations de cette étape.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos (solutions fermées vs open source)
Chaînes
L’attribution des chaînes a été difficile à établir dans cette collecte, comme expliqué dans les limites : les pages /watch et /results de YouTube n’exposaient à WebFetch que le contenu statique du pied de page. La plupart des noms de chaînes ci-dessous proviennent donc d’extraits de résultats de recherche, et non des pages elles-mêmes.
- Woollyfern — anime une série mensuelle récurrente « Midjourney Update » couvrant toutes les mises à jour de V8, V8.1 et V8.2 au cours de 2026.
- Plusieurs chaînes de tutoriels et de comparaisons couvrent la pile ComfyUI open source, notamment Qwen-Image, LTX et Wan, à chaque lancement, mais leurs noms individuels n’ont pas pu être confirmés à partir des seuls extraits de recherche. Les titres et liens restent réels et traçables, comme indiqué dans la section Vidéos.
- Des chaînes de récapitulatif général de l’actualité IA, comme le créateur de « Exciting AI Updates Weekly », publient des synthèses hebdomadaires touchant aussi bien les sorties fermées qu’open source de génération d’images et de vidéos.
Vidéos
-
GPT Image 2.5 Review: What Changed and How to Actually Use It
— chaîne « Aristotto » — publiée peu après le 8 septembre 2026 —
https://www.youtube.com/watch?v=QOfLgJ3TCrQ
La vidéo soutient que les deux modes de GPT Image 2.5 — Flare pour la vitesse et Sunburst pour le détail — améliorent sensiblement la fidélité aux images de référence et la fiabilité des éditions multi-tours par rapport à GPT Image 2.0, avec environ 50 % de latence en moins. -
GPT Image 2.5 Is Here — Everything You NEED to Know
— chaîne non identifiée — publiée vers le 22 septembre 2026, selon l’extrait de recherche (« il y a 6 jours ») — https://www.youtube.com/watch?v=20vo5nW9yXI
Présente les évolutions de GPT Image 2.0 à 2.5, dont la sortie native de PNG/WebP à fond transparent. -
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!
— chaîne non identifiée — publiée vers le 22–24 septembre 2026, Qwen-Image-2.1 ayant été publié le 21 septembre 2026 selon MarkTechPost —
https://www.youtube.com/watch?v=3qGl0wiv2G0
La vidéo affirme que Qwen-Image-2.1, modèle open weight de 7B d’Alibaba, dépasse largement ce que laisse prévoir son nombre de paramètres et se rapproche de gros modèles fermés. -
A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native 2K, RGBA & 10-Image Workflows
— chaîne non identifiée — publiée vers le 23 septembre 2026 —
https://www.youtube.com/watch?v=fwHS0ubmI7I
Affirme que Qwen-Image-2.1 surpasse Nano Banana 2.0 de Google sur plusieurs tâches tout en fonctionnant localement, et montre la sortie 2K native, la transparence RGBA et l’édition avec 10 images de référence. -
LTX-2.5 Is Here: The Fastest Open AI Video Model Yet?
— chaîne non identifiée — 16 août 2026 —
https://www.youtube.com/watch?v=qVGpyw-F-rw
Première analyse de LTX-2.5 open weight de Lightricks, positionné face à MiniMax H3 et Seedance 2.5 en matière de vitesse de génération. -
LTX-2.5 Open Weights Running In ComfyUI With - Is this Better?
— chaîne non identifiée — 12 août 2026 —
https://www.youtube.com/watch?v=XAhuGRCI2tM
Installation et test local de LTX-2.5 dans ComfyUI le lendemain de sa publication open weight, avec la question de savoir s’il dépasse le précédent modèle LTX-2. -
I Tested WAN 3.0 With 5 INSANE AI Video Challenges
— chaîne non identifiée — 20 août 2026 —
https://www.youtube.com/watch?v=5Hb429VYNUU
Soumet Wan 3.0 d’Alibaba, disponible en bêta publique avec des clips de 30 secondes, à des tests exigeants et le compare à Seedance ; la vidéo note que Wan 3.0 est actuellement disponible uniquement par API/bêta, et non en open weight comme les précédentes versions de Wan. -
Alibaba Wan 3.0 Made a 30 Second App Commercial for $1.27
— chaîne non identifiée — 24 août 2026 —
https://www.youtube.com/watch?v=fHK7oYrokZY
Démonstration de coût et de qualité de Wan 3.0 juste après son arrivée sur OpenRouter, présentée comme une alternative bon marché aux générateurs vidéo fermés. -
Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI Style Creator, and More!
— chaîne Woollyfern — publiée en juillet 2026 —
https://www.youtube.com/watch?v=dvfH5HzCARY
Passe en revue la personnalisation et le créateur de style NIJI de V8.2 ; la vidéo fait partie d’un suivi mensuel de la feuille de route fermée de Midjourney, de V8 à V8.1 puis V8.2 entre février et juillet 2026. -
Kling 3.0 vs Grok Imagine vs Runway Gen-4.5 vs Veo 3.1: The Ultimate AI Video Comparison
— chaîne non identifiée — vers le 10 mars 2026, hors de la fenêtre de 60 jours mais conservée car c’est la comparaison la plus claire de quatre modèles vidéo fermés —
https://www.youtube.com/watch?v=x5fMQvhKP60
Classe les quatre générateurs vidéo fermés selon leur qualité cinématographique, la synchronisation labiale et la cohérence entre plusieurs plans. -
Exciting AI Updates Weekly — September 25, 2026
— créateur « Lev Selector » — 25 septembre 2026 —
https://www.youtube.com/watch?v=iyZHPCNd8jI
Récapitulatif hebdomadaire général de l’IA intégrant les sorties image/vidéo, telles que GPT Image 2.5 et Qwen-Image-2.1, parmi des actualités IA plus larges.
Signaux
- Les modèles open weight réduisent rapidement l’écart, et l’affirment ouvertement. Plusieurs titres de vidéos présentent explicitement Qwen-Image-2.1, le modèle 7B d’Alibaba, comme capable d’égaler ou de battre le bien plus gros Nano Banana 2.0 de Google (#3, #4). L’angle « petit modèle ouvert contre grand modèle fermé » est désormais un argument récurrent, pas un fait isolé.
- La vidéo open source se dispute surtout la vitesse locale, et pas seulement la qualité. LTX-2.5 (#5, #6) et la lignée Wan (#7, #8) sont principalement couvertes au travers de vidéos d’installation ComfyUI et de tests de vitesse, plutôt que de bandes-annonces élégantes : le public veut savoir comment les exécuter sur son propre GPU.
- La vidéo fermée se consolide. OpenAI met fin à toute l’API Sora 2 le 24 septembre 2026, ce qui est confirmé par le centre d’aide d’OpenAI et plusieurs médias, même si aucune réaction YouTube dédiée n’a été trouvée. Wan 3.0 d’Alibaba aurait dépassé Sora dans les classements mondiaux de modèles vidéo vers la même période. La course fermée se réduit autour de Veo, Kling, Grok, Runway et Seedance.
- Les leaders fermés de l’image publient selon une cadence mensuelle ou de versions mineures. Les passages de Midjourney de V8 à V8.1 puis V8.2 (#9), et d’OpenAI de GPT Image 2.0 à 2.5 (#1, #2), témoignent de sorties fréquentes et incrémentales plutôt que de versions majeures. Les chaînes ont adapté leur couverture avec des formats mensuels récurrents.
- Wan 3.0 est un signal partiel, pas une victoire open source nette. Il n’est actuellement disponible que par API/bêta publique (#7, #8), contrairement à la lignée Wan 2.x open weight. Alibaba semble donc équilibrer distributions ouvertes et fermées.
Limites
- Les nombres de vues et d’abonnés n’ont pas pu être récupérés. WebFetch sur les pages
youtube.com/watch?v=...etyoutube.com/results?search_query=...ne renvoyait que le pied de page juridique statique de YouTube. Les chiffres vivent dans les donnéesytInitialDatarendues en JavaScript, qui n’étaient pas disponibles. Les chiffres de vues et d’abonnés ont donc été omis plutôt que devinés. - Plusieurs noms de chaînes n’ont pas pu être confirmés. Lorsqu’un extrait de résultat de recherche ne nommait pas le créateur, l’entrée est marquée « chaîne non identifiée » plutôt que de spéculer.
- Aucune vidéo YouTube consacrée spécifiquement à l’arrêt de l’API Sora 2 n’a émergé, malgré des recherches ciblées. L’arrêt est donc mentionné dans les signaux comme contexte, mais ne compte pas comme constat YouTube.
- La couverture des recherches s’appuie sur les extraits indexés de Google plutôt que sur l’interface de recherche YouTube active, car celle-ci n’était pas récupérable. Cela sous-représente probablement les chargements très récents qui ne sont pas encore totalement indexés.
Bluesky
Bluesky — Dernières évolutions de l’IA de génération d’images et de vidéos
Comptes
- gen-ai.news(@gen-ai.news)— compte automatisé publiant des actualités sur l’IA générative. Du 18 au 27 septembre 2026, il a publié chaque jour un à trois résumés d’articles sur l’IA de génération d’images et de vidéos ; la majorité des informations récentes trouvées dans cette étape en proviennent.
- sungkim.bsky.social(@sungkim.bsky.social)— analyste métier suivant l’IA, le ML et l’analyse de données. Il compte 8 690 abonnés et publie fréquemment des annonces rapides de modèles open weight.
- edzitron.com(@edzitron.com)— compte issu d’une newsletter connue pour sa critique de l’industrie technologique. Sa publication sur Sora a largement circulé, comme indiqué plus loin.
- richargh.de(@richargh.de)— a publié son analyse de l’arrêt de Sora sous l’angle de l’économie unitaire.
- luok.ai(@luok.ai)、adinayakup.bsky.social(@adinayakup.bsky.social)— auteurs présentant des informations techniques sur des modèles open source de génération vidéo, notamment la famille SkyReels.
- dahara1.bsky.social(@dahara1.bsky.social)— utilisateur publiant en japonais ses retours de bêta-test sur l’IA générative.
Publications
Évolutions du côté fermé
- OpenAI met fin à Sora — @edzitron.com, 2026-03-24, 👍3,571 🔁984 💬99. Citant le WSJ et The Information, le compte écrit qu’OpenAI va « arrêter non seulement l’application, mais aussi l’accès à l’API pour développeurs, une décision plutôt précipitée ». C’est le plus gros succès Bluesky sur ce thème.
- L’arrêt de Sora vu comme l’échec de son économie unitaire — @richargh.de, 2026-03-25, 👍2 🔁0. Analyse : « Ils ont sans doute compris que l’économie unitaire de la génération vidéo était trop mauvaise. Peut-être n’ont-ils pas réussi à convertir les utilisateurs gratuits en utilisateurs payants. »
- L’arrêt de l’API Sora est effectif au 2026-09-24 (confirmé dans les articles de gen-ai.news et les résultats de recherche ; aucune publication propre à Sora n’a été trouvée. Source : Wikipedia: Sora pour recouper la date).
- GWM 2 de Runway — gen-ai.news, 2026-09-27. Un modèle de monde qui « ne génère pas simplement des clips, mais continue à comprendre l’environnement ».
- Runway développe un flux vidéo en temps réel avec GWM-1 — gen-ai.news, 2026-09-20. L’article évoque également des applications possibles en robotique et conduite autonome.
- L’alpha de Midjourney ajoute l’aperçu de style en direct — gen-ai.news, 2026-09-27, avec des changements antérieurs dans un article du 25 septembre. Il devient possible de vérifier l’apparence d’un style avant la génération.
- Les outils créatifs d’Adobe s’intègrent à Gemini et Claude — gen-ai.news, 2026-09-26. Photoshop, Lightroom, Firefly et Acrobat sont utilisables directement depuis une interface de chat.
- Adobe finalise l’acquisition de Topaz Labs — gen-ai.news, 2026-09-25. La technologie d’upscaling IA doit être rapidement intégrée à Firefly et Photoshop, tandis que la marque Topaz est conservée à court terme.
- OpenAI acquiert Glass Imaging pour 300 millions de dollars — gen-ai.news, 2026-09-19. La startup travaille sur le traitement d’images pour les appareils photo mobiles ; l’opération est analysée comme une ambition couvrant toute la chaîne de l’image, de la prise de vue à la génération.
- Dramagic de ByteDance génère 95 % des mini-séries chinoises par IA — gen-ai.news, 2026-09-22. Présenté comme un pipeline allant du scénario à l’image sans équipe humaine.
- Le conseil de surveillance de Meta ordonne le retrait de vidéos deepfake — gen-ai.news, 2026-09-19. Il demande aussi à Meta de renforcer ses politiques de détection et de retrait.
Évolutions du côté open source
- Alibaba publie Qwen-Image-2.1 en open weight — @sungkim.bsky.social, 2026-09-20, 👍82 🔁10 💬4. Le post présente « une architecture légère de 7B qui unifie génération et édition, avec une inférence multi-image fortement accélérée ».
- Explication détaillée du modèle — gen-ai.news, 2026-09-20. « Modèle de génération d’images open weight de 7B, fonctionnant sur GPU grand public, prenant en charge les calques transparents et jusqu’à 10 images de référence simultanées, et revendiquant des performances comparables à celles de gros modèles fermés dans les benchmarks. »
- SkyReels V1, premier modèle de base open source spécialisé dans les humains pour la vidéo — @luok.ai, 2025-02-18, 👍3 🔁1. Il est décrit comme un affinement de HunyuanVideo sur plus de 10 millions de clips, capable de représenter 33 types d’expressions et plus de 400 mouvements.
- SkyReels-A2, cadre de génération vidéo contrôlable à partir de texte et d’image — @adinayakup.bsky.social, 2025-04-04, 👍3 🔁2. Présenté comme un framework ouvert de Skywork et KunLun.
- Retour de bêta-test de HunyuanVideo, en japonais — @dahara1.bsky.social, 2025-03-06. L’utilisateur publie un résultat de synchronisation labiale animé après avoir généré une vidéo avec audio à partir d’une seule image, en image-vers-vidéo.
Signaux
- La seconde moitié de septembre est très dense en nouvelles du côté fermé : Runway, Adobe, Midjourney, OpenAI, Meta, ByteDance et Pinterest ont publié presque quotidiennement une annonce, une acquisition ou un changement de stratégie entre le 18 et le 27 septembre 2026. Les comptes d’actualités IA sur Bluesky suivent ce rythme.
- Une impression que « la génération vidéo ne rapporte pas d’argent » : l’arrêt de Sora, avec 3 571 mentions J’aime, est traité comme un point de bascule manifeste. Des analyses comme celle de richargh.de, qui évoque de mauvaises économies unitaires, semblent devenir un consensus communautaire.
- L’open source de l’image est dominé par Alibaba Qwen : Qwen-Image-2.1 a été couvert le même jour par un compte personnel, sungkim.bsky.social, et un compte d’actualité, gen-ai.news. Ses 82 mentions J’aime représentent la plus forte réaction observée sur une publication personnelle dans cette étape. L’idée centrale est celle d’un modèle léger de 7B rivalisant avec de gros modèles fermés.
- Les publications individuelles sur la vidéo open source sont rares et anciennes : les publications SkyReels et HunyuanVideo datent du début de 2025. Aucune publication personnelle significative sur Wan 2.7, LTX-2.3 ou FLUX.2 à la date de septembre 2026 n’a été trouvée par recherche Bluesky.
- L’actualité du secteur montre une certaine capacité d’autocorrection : le 23 septembre 2026, gen-ai.news a explicitement déclaré que « GPT-6 » et « Astra » n’existent pas et qu’il ne pouvait pas publier un article contenant des noms de produits inventés. Mais un post du même compte, le 21 septembre, affirme que Higgsfield AI a accéléré des fonctionnalités avec GPT-4o et un framework « Astra » d’OpenAI. Cette contradiction laisse fortement penser qu’une des deux affirmations est erronée ; les allégations liées à Astra ne doivent pas être reprises sans précaution.
Limites
- L’API officielle de recherche Bluesky,
app.bsky.feed.searchPosts, renvoyait constamment une erreur 403 Forbidden depuis cette session, empêchant une recherche complète par mots-clés. Les posts et comptes ont donc été trouvés par recherche Web, notammentsite:bsky.app, puis recoupés viaapp.bsky.feed.getPostThreadetapp.bsky.feed.getAuthorFeed, APIs publiques sans authentification, pour le texte, la date et les mentions J’aime. - Les pages de publications bsky.app, rendues en JavaScript, ne permettaient pas à WebFetch d’obtenir le contenu ou les chiffres ; seul le handle de l’auteur était lisible. Tous les chiffres sont limités aux données récupérées par les APIs ci-dessus.
- Les modèles open source de génération d’images et de vidéos censés être actifs en septembre 2026 — FLUX.2, Wan 2.7, LTX-2.3 et les partages de workflows ComfyUI — n’ont pas donné lieu à des publications personnelles significatives dans la recherche Bluesky. Les fils de comptes concernés, comme fluxkontext.bsky.social, wagahai-ai.bsky.social et aoi68k.bsky.social, ont été consultés directement, mais s’arrêtaient au début de 2025 ou ne reflétaient pas l’actualité récente.
- Par rapport au critère d’environ 20 publications à analyser, seules 16 publications ont pu être vérifiées avec leur texte et leurs chiffres : 11 fermées et 5 open source. La collecte est fortement concentrée sur gen-ai.news plutôt que sur des discussions organiques de plusieurs utilisateurs.
- Plusieurs comptes de la communauté japonaise, liés aux tags d’illustration et de vidéo IA, ont été trouvés, mais leurs contenus étaient anciens — 2024 à 2025 — ou limitaient à des œuvres génériques sans valeur d’actualité. Ils n’ont donc pas été retenus.
Lemmy
Lemmy — Dernières évolutions de l’IA de génération d’images et de vidéos
Communautés
- !«メールアドレス» — 5 714 personnes. C’est le seul véritable hub Lemmy pour les modèles open weight de génération d’images et de vidéos. Presque chaque jour, des liens vers GitHub et HuggingFace y sont publiés, dans un format de flux d’actualités.
- !«メールアドレス» (avec miroir sur sh.itjust.works) — environ 5 180 personnes. Communauté dédiée aux LLM locaux, qui aborde parfois la génération d’images ; aucune nouvelle publication liée aux images ou vidéos n’a été trouvée pendant cette collecte.
- !«メールアドレス» — 1 662 personnes. La communauté existe, mais son activité récente est presque inexistante.
- !fuck_ai — sur lemmy.world, lemmy.dbzer0.com, lemmy.zip, discuss.online, lemmy.blahaj.zone et d’autres instances — est active au regard de sa taille, avec de quelques dizaines à plus de 800 mentions J’aime par publication. Elle traite de l’opposition à l’IA en général, mais les posts spécifiquement liés à la génération d’images et de vidéos sont très minoritaires.
- !«メールアドレス» et ses miroirs — communautés technologiques généralistes où arrivent ponctuellement des actualités sur les produits fermés de génération d’images et de vidéos. Aucune communauté spécialisée n’a été trouvée.
- !«メールアドレス» / !«メールアドレス», !«メールアドレス», !«メールアドレス» — exemples de communautés consacrées au jeu ou à des marques particulières où des actualités sur le contenu généré par IA apparaissent ponctuellement.
Publications
Côté open source, depuis !«メールアドレス»
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — score 14, 2026-09-22. Le modèle open weight Qwen-Image-2.1 d’Alibaba est intégré à ComfyUI et prend en charge les sorties transparentes, avec canal alpha. https://lemmy.dbzer0.com/post/75874773
- SupraLabs/Supra2-IMG — score 8, 2026-09-22. Modèle text-to-image extrêmement léger de 100 millions de paramètres, entraîné uniquement avec des données synthétiques et présenté comme offrant une qualité de pointe au regard de sa taille. https://lemmy.dbzer0.com/post/75874769
- AI Horde : nouvelle interface, nouveau frontend, nouveau backend et documentation entièrement renouvelée — score 9, 2026-09-19. Mise à jour du service distribué et gratuit de génération d’images développé par db0, administrateur de cette instance Lemmy. https://lemmy.dbzer0.com/post/75736717
- well9472/Nanosaur2-670M, compatible avec ComfyUI — score 4, 2026-09-27. Modèle DiT text-to-image de 670 millions de paramètres spécialisé dans l’illustration, entraîné pour seulement 600 dollars. https://lemmy.dbzer0.com/post/76110122
- Concentration de publications sur les outils pour MiniMax H3 — du 13 au 26 septembre 2026, plus de cinq publications se sont succédé sur AutoContext, qui contourne les contraintes de mémoire sur les longues vidéos, une interface de contrôle caméra 3D, des nœuds d’édition de timeline et le LoRA d’accélération en trois étapes TaoMate-H3, avec des scores de 1 à 6. MiniMax H3 est clairement le terrain central de cette communauté pour la vidéo. Exemple : https://lemmy.dbzer0.com/post/75586069
- LoRA et outils d’accélération autour de Krea 2 — « Krea2-Turbo-Distill-2step-LoRA », débruitage 4,2 fois plus rapide, score 2, 2026-09-16, et « krea2-inpaint-edit », LoRA pour l’édition par masque, score -1, 2026-09-26. Krea2 s’installe comme une cible autour de laquelle la communauté peut créer ses propres LoRA.
Côté fermé, dispersé dans des communautés généralistes
- Midjourney demande aux studios hollywoodiens de révéler leur usage de l’IA — !«メールアドレス», 2026-07-05. https://lemmy.today/post/56011946
- Stanford reconnaît avoir utilisé des photos d’étudiants pour des retouches IA « changeant leur race » — !«メールアドレス», score 3, 2026-09-23. https://lemmy.world/post/52274704
- La nouvelle fonction IA de Google Earth permettrait à n’importe qui de fabriquer de fausses images satellites — !«メールアドレス», 2026-08-04. https://sh.itjust.works/post/64574916
- DC retire de YouTube une vidéo des coulisses après la découverte d’art conceptuel généré par IA — !«メールアドレス», score 5, 2026-08-13. https://lemmy.today/post/58316222
- Une publicité Meta promeut une application de déshabillage par IA ciblant de vrais adolescents comme « l’IA que les hommes utilisent réellement » — !«メールアドレス», 2026-09-08. https://lemmy.dbzer0.com/post/75191260
- EA s’associe à l’entreprise derrière Stable Diffusion, Stability AI, pour produire des jeux avec l’IA — !«メールアドレス», score 2, 2025-10-25. https://mander.xyz/post/40602787
- Publication-mème se moquant de « OpenAI arrête Sora, modèle de génération de vidéos IA slop » — !«メールアドレス», score 0, 2026-03-25. Elle ironise sur l’actualité réelle de l’arrêt de l’API Sora. https://lemmus.org/post/21091066
Signaux
- L’open source est concentré en un seul pôle : presque tous les posts de développement trouvés viennent d’une seule communauté, !«メールアドレス», et essentiellement d’un seul auteur, Even_Adder, ainsi que de l’administrateur db0. La quasi-totalité des publications n’a aucun commentaire ; il s’agit davantage d’une liste de nouveaux liens GitHub/HuggingFace que d’un espace de discussion.
- Le centre de gravité actuel du développement est Qwen-Image-2.1 pour l’image et MiniMax H3 pour la vidéo : la majorité des publications d’outils des deux dernières semaines concerne des adaptateurs, LoRA et nœuds ComfyUI pour ces deux modèles. Reddit les désigne également comme les meilleurs choix actuels, ce qui fournit une validation entre plateformes.
- Les produits fermés n’apparaissent que via la controverse ou l’éthique, pas les actualités de fonctionnalités : les posts sur Midjourney, Google, Meta et DC ne couvrent pas de nouvelles fonctions, mais des problèmes de droit, de deepfake, d’usurpation ou de falsification. Lemmy ne dispose pas de communauté qui suivrait de façon spécialisée les annonces techniques de Sora, Veo, Kling ou Grok Imagine.
- !fuck_ai n’est pas spécialisé dans l’IA image/vidéo malgré son activité : ses publications peuvent atteindre plusieurs dizaines ou centaines de mentions J’aime, mais se concentrent surtout sur les dérives d’agents LLM textuels, par exemple « Claude Code a supprimé 48 000 fichiers en 103 secondes » ou « l’agent d’OpenAI a modifié un site gouvernemental ». Les références à la génération d’images et de vidéos restent minoritaires.
- Les recherches directes des grands produits fermés ont presque toutes échoué : les requêtes « Kling AI », « Veo 3 », « Adobe Firefly », « Nano Banana » et « Grok Imagine » ont surtout produit des résultats sans rapport. Les publications ou discussions dédiées à ces produits sont donc presque absentes sur Lemmy.
Limites
- La recherche Lemmy, qu’il s’agisse de l’API lemmy.world ou de la recherche Web interne, est peu précise et renvoie beaucoup de publications sans lien avec les mots-clés. Par exemple, chercher « Kling AI » peut retourner un fil sur des réductions ferroviaires allemandes. L’absence dans les résultats ne prouve donc pas l’absence de discussion.
- Les informations open source dépendent pratiquement d’une seule communauté et d’un ou deux comptes. Les communautés comparables sur d’autres instances, telles que lemmy.ml ou lemm.ee, ont peu d’abonnés et presque aucune activité.
- Aucun lieu de rassemblement spécialisé n’a été trouvé du côté fermé ; les informations ont dû être récupérées dans des communautés généralistes comme technology, nottheonion, games, dcstudios ou googlepixel. La couverture est donc limitée.
- Plus de 40 publications ont été ouvertes au total à travers les listes de communautés et les résultats de recherche, notamment 20 nouvelles publications de stable_diffusion et de nombreux résultats supplémentaires. Le seuil d’environ 20 est donc atteint en nombre, mais très peu de fils contenaient une discussion active : la plupart avaient zéro commentaire.
- Lemmy est globalement une plateforme de faible volume, en utilisateurs comme en publications, et offre moins de profondeur que Reddit, X ou Bluesky pour suivre l’actualité de la génération d’images et de vidéos.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
Parmi les 50 épingles collectées (pinterest.pins.md、manifest.json), 26 images ont été ouvertes et inspectées visuellement. La collecte provient d’une requête unique, non catégorisée : "Image and Video Generation AI News".
Thèmes visuels
- L’esthétique « IA » en fond noir, néon bleu/violet domine : mains et visages robotiques avec effet lumineux, motifs de circuits brillants et typographie
AIreviennent sans cesse. C’est le ton visuel d’une grande partie de l’échantillon [1, 7, 8, 20, 37, 38, 40]. - Le robot humanoïde blanc, lisse, avec des yeux ou articulations bleu lumineux, est largement utilisé comme icône anthropomorphique de l’IA [8, 20, 37, 38, 40]. Ces illustrations de type banque d’images sont bien plus présentes que les captures d’écran d’interfaces produit réelles.
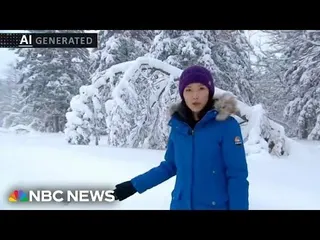
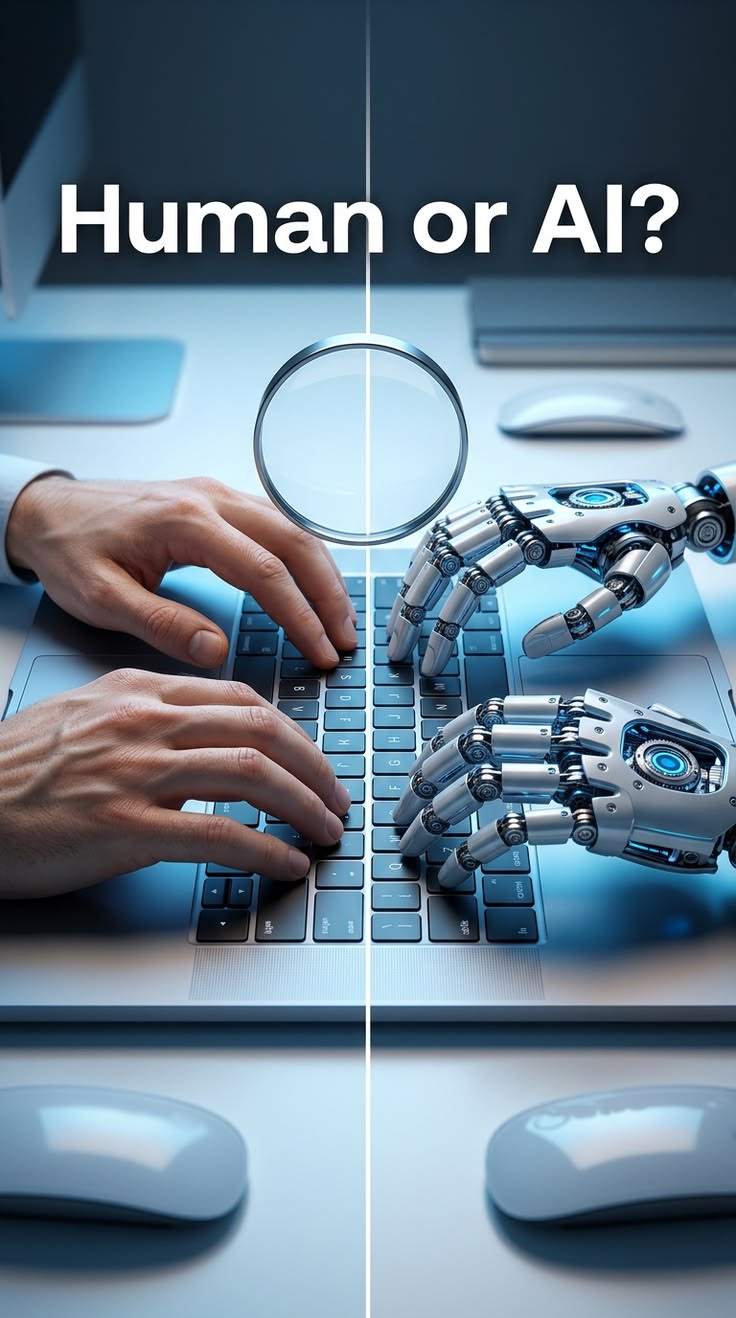
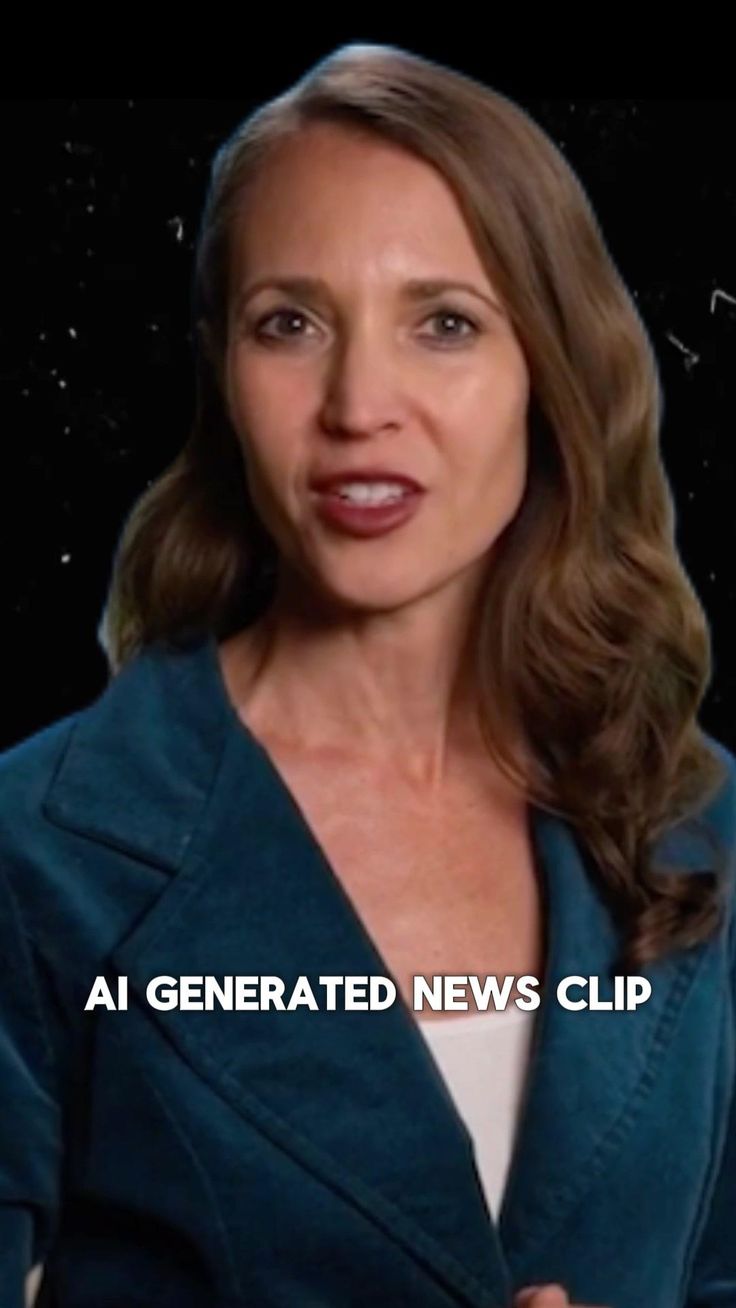
- Les contenus d’avertissement et de comparaison « c’est généré par IA » forment une catégorie majeure : tampons de détection de faux, images divisées Human/AI et captures d’écran de faux présentateurs de journaux générés par IA mettent l’accent sur la manière de reconnaître ces contenus ou sur la méfiance à leur égard [3, 32, 39, 42, 43, 44, 45, 48].
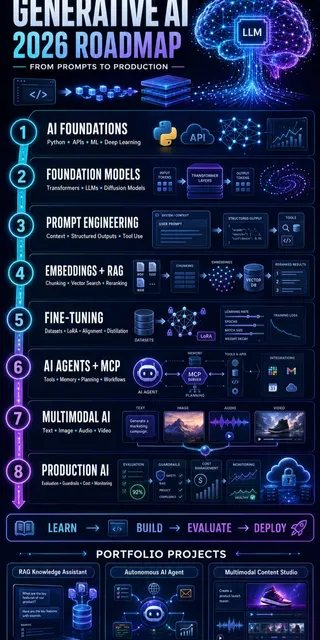
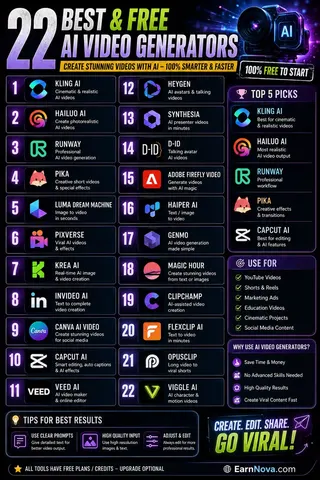
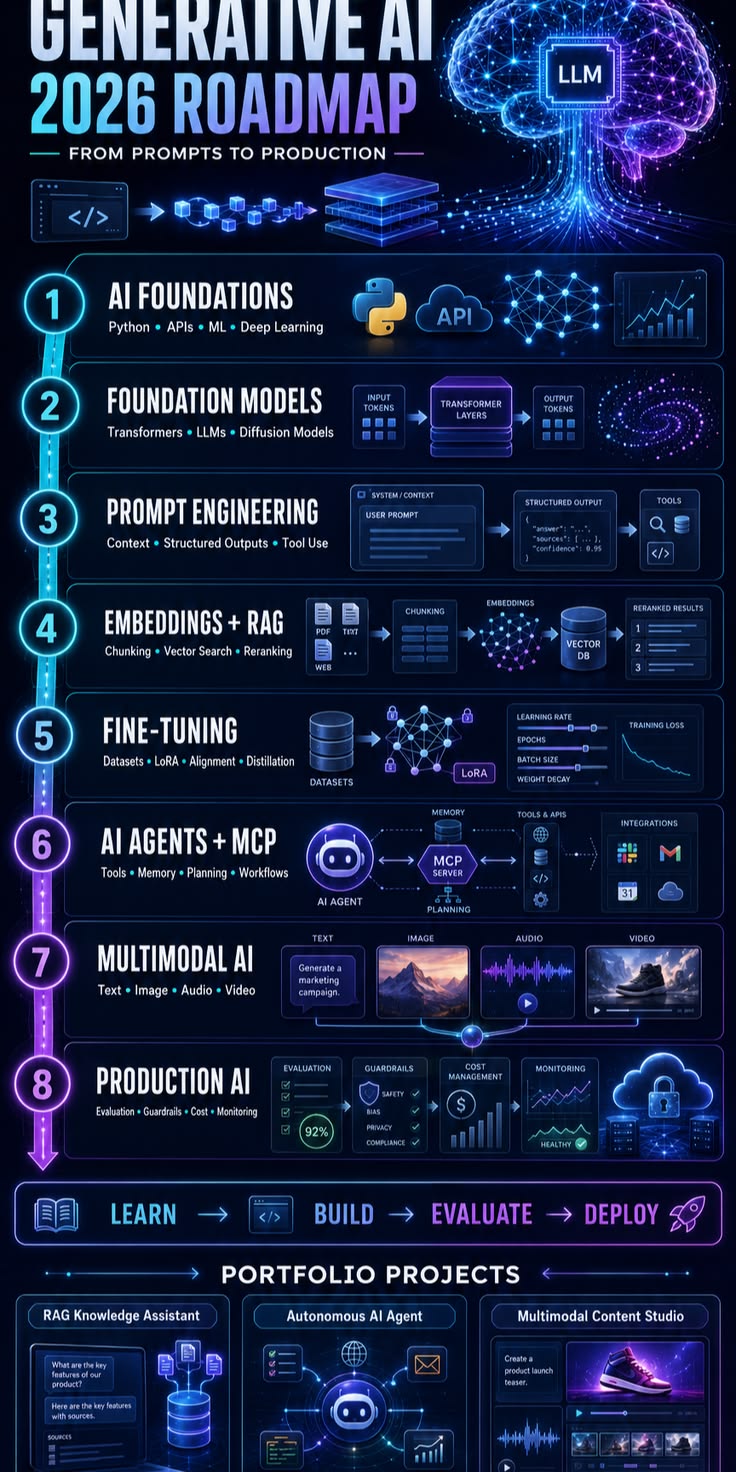
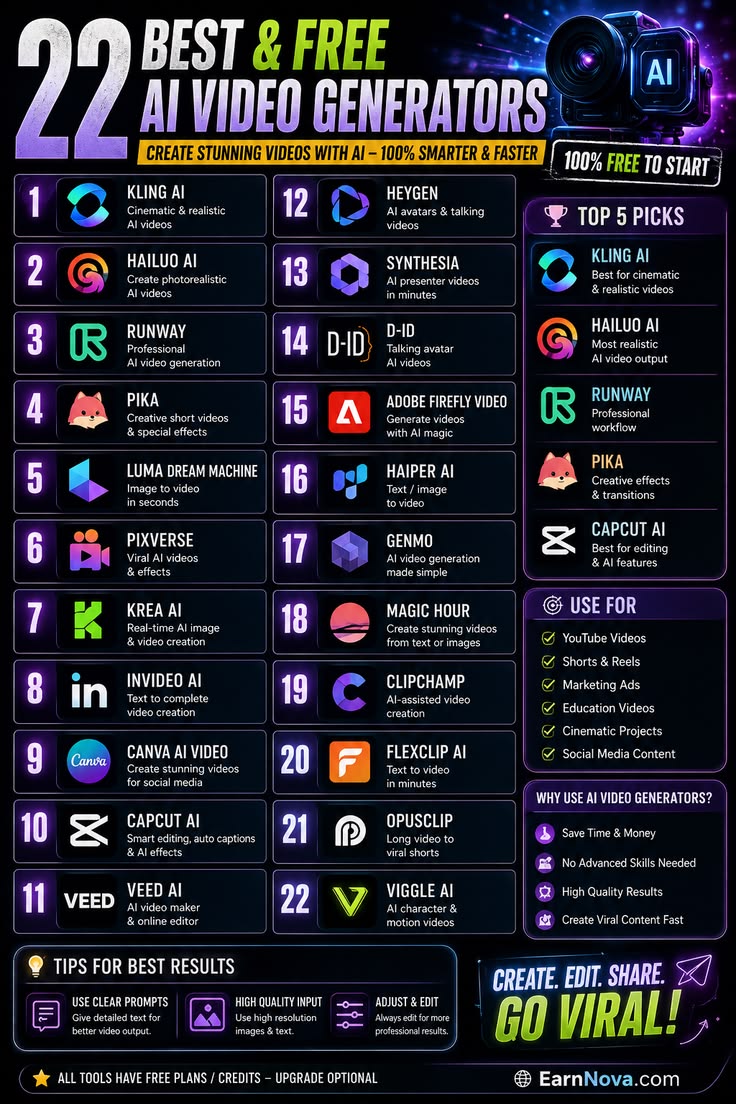
- Les infographies de comparaison et classement d’outils, sous forme de listes verticales, sont nombreuses : « Best Quality vs Best Free », « 22 Best & Free AI Video Generators », avec les logos de nombreux outils [7, 47]. Les feuilles de route d’apprentissage relèvent de la même famille [34].
- Les miniatures mettant en avant logos et noms de grandes solutions fermées : Google Gemini/Omni, Veo3, Kling AI, Luma Dream Machine et le logo OpenAI sont placés bien en évidence [1, 9, 13, 19, 31, 33, 47]. À l’inverse, les images centrées sur l’open source — Stable Diffusion, ComfyUI ou LoRA — sont pratiquement absentes. La seule image Stability AI [49] est une composition de produits, pas un véritable écran de workflow.
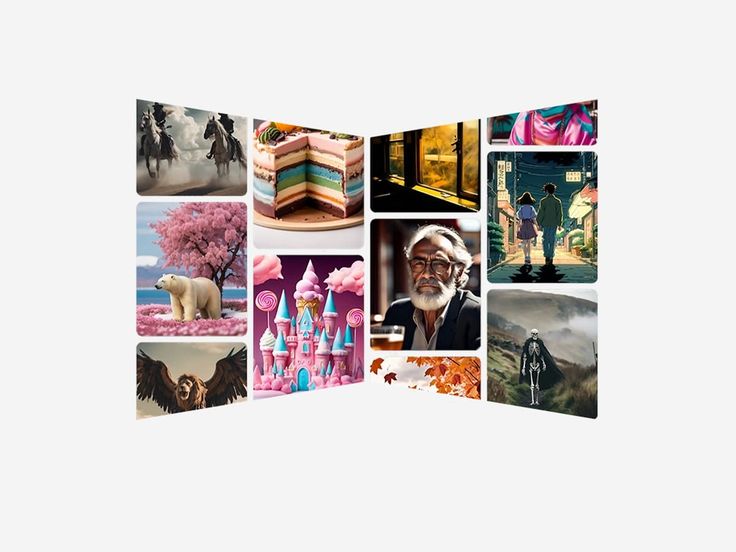
- La démonstration consistant à transformer une image en plusieurs styles : une grille comparative transforme la même photo de personne en versions en blocs de bois, origami, Lego ou fleurs. Elle sert de démonstration visuelle des capacités d’édition par IA [2].
- Les gros plans d’yeux et le motif « impossible à distinguer du réel » : l’œil en gros plan de Luma Dream Machine [33], ainsi que les mises en scène macro comparant IA et humains [43], insistent sur le réalisme.
- L’association de logos d’entreprises réels et de documents administratifs pour créer un ton d’actualité : photo d’enseigne Google [28], visuel de documents juridiques liés à l’État de New York [18], et nombreuses présentations de type « actualités résumées » combinant photo de banque d’images et texte superposé.
Épingles notables
- [1] "AI News: Anthropic Leak Shows Us The Future of AI..." — composition typique de miniature YouTube d’actualités IA : visage surpris et logos des grandes entreprises technologiques, OpenAI, Google et Microsoft.
- [2] "Google announces ultra-high quality video..." — il s’agit en réalité d’une grille de démonstration de transformation d’images, où un même contenu vidéo est converti en versions de sculpture sur bois, origami, Lego et art floral. Un exemple représentatif de la puissance visuelle de l’édition IA.
- [9] "Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API" — met en avant la génération vidéo rapide et l’audio natif de Veo3 via l’API Gemini. C’est un support promotionnel pour une fonctionnalité récente fermée.
- [13] "Kling.ai AI-Powered Text-to-Video Generation" — épingle verticale au format « My Top Picks » recommandant Kling AI. Elle témoigne de la notoriété élevée de cet outil chinois fermé de génération vidéo.
- [19] "Google's Gemini Omni Turns Anything Into Video" — image de marque condensant l’intégration multimodale, image, son et texte vers vidéo, dans une seule icône.
- [31] "'Amuse 3.0', an AI art creation tool that includes..." — portrait hyperréaliste d’un outil de génération d’images local soutenu par AMD. C’est l’un des rares contenus mettant en avant la génération sur appareil.
- [32] "AI news videos blur line between real and fake reports" — image fixe d’un présentateur généré par IA dans un style de reportage NBC, avec le filigrane "AI GENERATED". Elle symbolise les inquiétudes concernant les abus de l’IA générative dans l’information.
- [44] "AI News Anchors & Creator-Led Coverage Take Over U.S. Media!" — illustration composite surplombant une salle de rédaction, présentée comme un compte rendu de l’essor des présentateurs IA et de l’information menée par les créateurs.
- [47] "22 Best & Free AI Video Generators in 2026" — infographie classant 22 outils, dont Kling, Hailuo, Runway, Pika et Luma. Elle représente typiquement les contenus d’aide au choix focalisés sur les offres gratuites.
- [49] "Stability AI's Stable Diffusion Maker Can Now Build AI Generative Video" — collage lié à Stability AI, mêlant scène de bureau, écran de code et exemple de portrait généré. C’est l’un des rares exemples open source, mais il ne montre ni interface précise ni nom de modèle détaillé.
Signaux
- Pinterest est actuellement presque entièrement dominé par la génération vidéo fermée : Veo3/Gemini Omni, Kling AI, Luma Dream Machine et Runway apparaissent régulièrement avec leurs logos. Les infographies comparatives [7, 47] listent elles aussi presque exclusivement des outils SaaS fermés ; même lorsque le terme « gratuit » est mis en avant, il ne s’agit pas du contexte open source et auto-hébergé.
- La méfiance envers les contenus générés par IA et l’apprentissage de leur détection constituent une demande forte, caractéristique de Pinterest : les contenus de détection de faux, les abus dans l’information et les comparaisons Human or AI? forment une catégorie indépendante. À la différence des discussions techniques de Reddit et des sites d’actualité, ils sont consommés ici comme infographies de sensibilisation.
- Les sujets propres à l’open source — ComfyUI, LoRA, modèles OSS chinois tels que Wan ou HunyuanVideo, débats sur les licences — sont presque absents. Un seul contenu lié à Stability AI a été trouvé ; aucune interface de workflow précise ou création communautaire n’a été observée.
- Les métriques d’engagement telles que les enregistrements et les mentions J’aime ne figurent pas dans les données collectées, ce qui empêche de savoir quelles épingles font réellement parler d’elles.
Limites
- Seules 26 images sur 50 ont été réellement ouvertes et examinées ; les 24 restantes n’ont été consultées qu’à travers leur liste de titres dans
pinterest.pins.md. - La collecte Pinterest avait déjà été effectuée par un collecteur ; il n’a pas été possible de parcourir la plateforme soi-même ni d’ajuster les requêtes. Les résultats proviennent d’une seule requête en anglais, sans nouvelles recherches en japonais, « open source » ou « closed source ».
- Seules des images fixes ont été collectées. Malgré le thème de la génération vidéo, aucun résultat généré en mouvement n’a pu être inspecté ; l’analyse reste fondée sur les miniatures et visuels promotionnels.
- Les données ne contiennent ni nombres d’enregistrements ni commentaires, donc l’ampleur de la popularité et de la diffusion ne peut pas être évaluée.
Actions recommandées
- Vérifier chaque semaine l’écosystème ComfyUI autour de Qwen-Image-2.1 et Minimax H3.
- Ne plus fonder la collecte X sur les tendances régionales et rechercher directement des mots-clés liés à l’IA de génération d’images et de vidéos.
- Suivre la recomposition des acteurs fermés de la vidéo après Sora, notamment Veo, Kling, Grok, Runway et Seedance.
- Utiliser Pinterest comme source de référence sur les langages visuels, car il ne fournit pas de mesures de popularité.
- Continuer à surveiller la méfiance croissante envers les contenus générés par IA et le débat sur l’obligation de filigrane.
- Lors d’une nouvelle collecte Reddit, employer des recherches dédiées aux solutions open source et fermées afin de se rapprocher du critère de 20 éléments.
Images collectées






























Note sur la qualité des données
X n’a trouvé aucune publication pertinente à cause d’une géolocalisation erronée et de recherches fondées sur les tendances ; Bluesky a été limité par une API de recherche renvoyant 403 et par une dépendance aux articles d’un seul compte ; Pinterest ne fournit aucune métrique d’engagement ; les vues YouTube ne sont pas récupérables ; les informations open source de Lemmy sont essentiellement concentrées dans une communauté ; et Reddit reste à 12 fils, sous le seuil de 20 attendu.