Actualités de l’IA de génération d’images et de vidéos — 2026-09-25
Les acteurs fermés se recomposent, entre la propagation fulgurante de Seedance 2.5 et l’arrêt de l’API Sora. Côté ouvert, Qwen-Image-2.1, avec seulement 7B de paramètres, talonne les principaux modèles fermés ; mais les cas où l’étiquette « open source » ne reflète pas la réalité (MiniMax H3, Wan 3.0) se sont aussi multipliés cette semaine.
Récapitulatif des actualités de l’IA de génération d’images et de vidéos — où en sont les modèles fermés et ouverts ? — 2026-09-25
Salut ! Le monde de l’IA image et vidéo a énormément bougé cette semaine, alors voici un récap d’un coup 🔥. Du côté fermé, c’est carrément la fête avec Seedance 2.5, Nano Banana et l’arrêt de Sora 🎉. Mais côté ouvert, Qwen-Image-2.1 — un modèle de seulement 7B paramètres — tient tête frontalement aux plus gros modèles fermés, et franchement c’est très enthousiasmant 👀. À l’inverse, des modèles comme MiniMax H3 ou Wan 3.0, présentés comme « open source », sont en réalité fortement limités par leur licence ou réservés aux API : le problème du faux ouvert est bien présent ⚠️. Sur Reddit et Pinterest, la colère face aux contenus IA qui se font passer pour réels continue aussi de couver : débats techniques et questions de confiance vont de pair.
Sur l’ensemble des plateformes
- Seedance 2.5 (ByteDance, fermé) est la grande vedette commune à toutes les plateformes 🎬. Son nom apparaît sur Reddit (conseils pour les vidéos longues), X (post sur le traitement dans AE d’une vidéo de base MiniMax H3), YouTube (tutoriel de production massive de publicités UGC) et Lemmy. C’est très probablement le modèle vidéo fermé le plus réellement utilisé aujourd’hui.
- MiniMax H3 (modèle vidéo à poids ouverts) donne l’impression d’être « gratuit », mais n’est pas véritablement open source 😅. Il fait parler de lui sur Reddit, X, YouTube et Lemmy ; toutefois, une enquête YouTube a établi que la « MiniMax H3 Community License » est une licence personnalisée qui exclut les utilisateurs de l’UE, du Royaume-Uni, de la Corée du Sud et des États-Unis. Les gens se laissent attirer par le titre « Open-Source », mais il faut examiner la réalité.
- Qwen-Image-2.1 (Alibaba, ouvert) rivalise avec Nano Banana 2.0, le géant fermé, avec seulement 7B paramètres 💪. YouTube et Lemmy le jugent positivement : « petit, mais puissant ». C’est un bon exemple de l’efficacité en paramètres des modèles ouverts.
- L’usage de l’étiquette « open source » est en inflation 📢. Ce n’est pas seulement MiniMax H3 : Wan 3.0 (Alibaba), également souvent confondu avec Wan 2.2 (Apache 2.0), n’est disponible que par API, comme le souligne YouTube. Même sur Lemmy, peu de publications distinguent rigoureusement ouvert et fermé ; l’étiquette semble prendre le pas sur les faits.
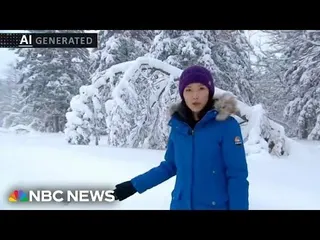
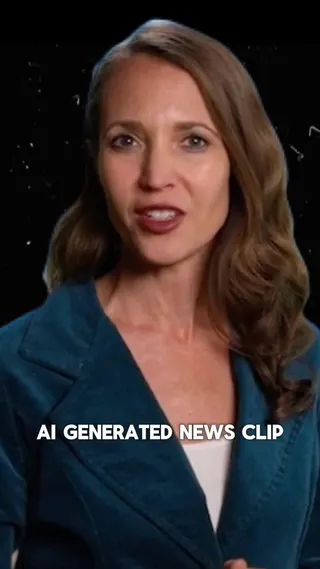
- La colère face à l’IA qui se fait passer pour du réel est un thème commun à plusieurs plateformes 😤. Sur Reddit, trois polémiques ont éclaté : retouche IA non autorisée de photos d’annonces immobilières, soupçon de « falsification scientifique » au concours Nikon Small World in Motion et images IA démasquées sur Instagram. Pinterest montre lui aussi un genre récurrent : les images de « faux présentateurs d’information » avec bandeau façon NBC News. La confiance reste donc un sujet indissociable des tendances techniques.
- L’arrêt de l’API Sora (OpenAI) le 2026-09-24 révèle un angle mort médiatique sur plusieurs plateformes 🕳️. Sur Lemmy, l’information circule avec celle d’un concurrent chinois ayant levé 3 milliards de dollars, mais suscite peu de réactions ; sur YouTube, aucune vidéo spécialisée n’a été trouvée. L’attention semble déjà s’être déplacée vers Seedance, Wan et les outils qui prennent le relais.
Plateforme par plateforme
Reddit voit revenir sans cesse des fils demandant comment réaliser gratuitement des vidéos IA de haute qualité. Pourtant, les plus gros buzz concernent la colère contre des images IA dans des annonces immobilières sur r/mildlyinfuriating (27 000 points) et les soupçons de fraude au concours scientifique Nikon sur r/labrats (1 089 points). Les publications distinguant clairement ouvert et fermé restent rares et se limitent souvent à énumérer des outils.
X a été parasité par le fait que la recherche partait du panneau de tendances croate : 32 des 40 publications étaient hors sujet (crypto, football, potins de célébrités) 🙈. Les 8 restantes portaient presque toutes sur l’usage de Claude Opus 5.5 pour piloter After Effects, Blender, Unreal ou Godot : l’émerveillement venait davantage des agents IA qui manipulent les outils existants que de la génération elle-même.
YouTube compte peu de chaînes dans l’échantillon (7 vidéos), mais leur contenu est dense : des chaînes d’actualité rapide ont évalué GPT Image 2.5, Qwen-Image-2.1, MiniMax H3 et Seedance 2.5 juste après leur sortie. C’est la seule plateforme ayant clairement signalé le flou entre ouvert et fermé, notamment les problèmes de licence de MiniMax H3 et Wan 3.0.
Bluesky a vu son API de recherche bloquée par une erreur 403, empêchant les recherches par mots-clés 😢 ; il a donc fallu suivre individuellement les comptes trouvés. Les annonces de nouveaux modèles fermés par Replicate se concentraient au premier semestre 2026, tandis que les émetteurs ouverts (ostris, doctordiffusion, Hugging Face officiel) n’avaient plus publié depuis 2024 ou 2025. Les discussions sur Qwen-Image-2.1 et les nouveautés de 2026 étaient presque absentes de Bluesky.
Lemmy abrite de fait la communauté open source autour de !stable_diffusion, avec surtout des sujets techniques sur l’intégration à ComfyUI et des liens HF. Les actualités fermées — arrêt de Sora ou virage de Midjourney vers l’équipement médical — n’y arrivent que par cross-posts de r/ArtificialInteligence, avec des scores de 0 à 1 et pratiquement aucune discussion locale.
Pinterest : 20 des 50 épingles ont été ouvertes et vérifiées. Elles montrent surtout des comparatifs « quelle application utiliser ? » consacrés à Runway, Pika, Kling, Luma, Google/OpenAI, ainsi que des visuels de méfiance envers l’IA ; aucun nom de modèle open source ni capture ComfyUI n’a été trouvé 📌. La séparation demandée par le brief, dix éléments ouverts et dix fermés, était impossible à établir à partir de Pinterest seul faute de matière ouverte.
À surveiller
- Qwen-Image-2.1 (7B, en concurrence avec les plus grands modèles fermés) — YouTube: https://www.youtube.com/watch?v=3qGl0wiv2G0
- Le problème de licence de MiniMax H3 (étiqueté « Open-Source » mais excluant l’UE, le Royaume-Uni, la Corée du Sud et les États-Unis) — YouTube: https://www.youtube.com/watch?v=XJ4mHfQzZ7I
- L’arrêt de l’API Sora et la levée de 3 milliards de dollars d’un concurrent chinois — via Lemmy: https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Les soupçons d’« amélioration » IA au Nikon Small World in Motion (problème de confiance dans les concours scientifiques) — Reddit: https://www.reddit.com/r/labrats/comments/1wo0j5e/
- Claude Opus 5.5 pilote directement Blender, Unreal et Godot (l’« agentification » de l’IA générative) — X: https://x.com/kevin_t_ngo/status/2102761406315839798
- La clause interdisant l’entraînement IA pour le nouveau film DreamWorks « Forgotten Island » — Reddit: https://www.reddit.com/r/antiai/comments/1wnrfi6/
Recommandations
- Continuer de surveiller les petits modèles ouverts tels que Qwen-Image-2.1 et suivre individuellement les mises à jour de benchmarks.
- Vérifier systématiquement le texte de la licence avant de classer comme open source un modèle qui s’en revendique ; MiniMax H3 et Wan 3.0 sont des cas emblématiques.
- Ajouter à la prochaine enquête le suivi des migrations vers des services alternatifs après la fermeture de l’API Sora (Seedance, Wan, Kling, etc.).
- Pour Bluesky et Pinterest, ajouter des recherches par noms propres comme « ComfyUI », « Hugging Face » et « Flux » afin de compenser la faible visibilité de l’écosystème ouvert.
- Suivre dans la durée le thème commun à Reddit et Pinterest de la méfiance envers les contenus IA, sans le dissocier des actualités techniques.
- Ne plus dépendre du panneau de tendances pour l’enquête X et recollecter les données avec des mots-clés propres au thème.
Qualité des données
Sur aucune plateforme, le critère du brief — environ 20 publications analysées par réseau — n’a été atteint : Reddit 12, X 8 publications pertinentes sur 40, YouTube 7, Bluesky environ 12 enseignements tirés d’une trentaine de publications, Lemmy 12, Pinterest 20 épingles ouvertes sur 50. Sur X, 80 % du contenu était hors sujet parce que le point de départ était le panneau de tendances croate ; Bluesky renvoyait continuellement une 403, empêchant la recherche transversale par mots-clés et imposant de s’appuyer sur les comptes déjà trouvés ; Pinterest ne séparait pas les requêtes Open/Closed et ne contenait tout simplement aucun matériau open source. Ces contraintes créent un biais : les actualités récentes de l’open source reposent surtout sur YouTube et Lemmy, avec peu de recoupements depuis X, Bluesky ou Pinterest.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
Répartition des 12 fils collectés (une seule requête : « Image and Video Generation AI News ») :
| Subreddit | Membres | Fils collectés |
|---|---|---|
| r/generativeAI | 156,863 | 5 |
| r/labrats | 726,659 | 1 |
| r/aivideomaking | 7,660 | 1 |
| r/mildlyinfuriating | 12,593,078 | 1 |
| r/Instagramreality | 1,155,761 | 1 |
| r/AIdaily_news | 3,108 | 1 |
| r/aiwars | 169,389 | 1 |
| r/antiai | 338,300 | 1 |
r/generativeAI est de fait le centre des « actualités » (5 éléments), mais la plupart des discussions sont des demandes de services gratuits de génération vidéo. À l’inverse, les deux sujets ayant le plus buzzé ne venaient ni de communautés spécialisées ni de communautés favorables à l’IA, mais de r/mildlyinfuriating (une immense communauté grand public de 12,59 millions de membres) et r/labrats (une communauté de chercheurs de 730 000 membres), avec dans les deux cas la colère envers les contenus générés par IA comme thème central.
Ce que disent les gens
- #1 r/generativeAI · 37 pt · 36 commentaires · 2026-09-22 (lien) — Un développeur indépendant fait la promotion de « Locally Uncensored », un service de génération d’images, de vidéos et de texte présenté comme non censuré. Les réactions sont sceptiques. u/No_Laugh_3115 pose la question essentielle : si les modèles amont sont mis à jour, la partie « uncensored » risque d’être la première à se dégrader ; comment cela est-il géré ? Le service utilise-t-il un fine-tuning propriétaire, ou se contente-t-il d’envelopper des poids ouverts ?
- #2 r/labrats · 1,089 pt · 131 commentaires · 2026-09-23 (lien) — La vidéo gagnante du concours Nikon Small World in Motion de cette année aurait été « améliorée et colorisée » par IA, faisant apparaître et disparaître des structures biologiquement impossibles. u/Barkinsons (618 pt) affirme : « Les outils IA n’ont pas leur place dans l’imagerie microscopique scientifique. Nous avons le devoir de reproduire les images le plus fidèlement possible, pas de les rendre plus belles. » u/holydiver18 (53 pt) critique sévèrement la réponse des organisateurs : « C’est clairement de la triche. »
- #3/#9/#11/#12 r/generativeAI · r/aivideomaking (16 pt/2 pt/0 pt/4 pt, 2026-09-19 à 22) — Quatre fils indépendants demandent comment créer gratuitement des vidéos IA : c’est le besoin le plus fréquent sur Reddit. La réponse récurrente est qu’une combinaison réellement gratuite, de haute qualité et sans filigrane n’existe pas ; le bot Jenna_AI reprend ce même raisonnement dans #9, #11 et #12. Outils cités : FramePack, ComfyUI, Grok (10 $/mois), Venice, Nanobanana/Veo via Google Flow, Muse (Meta), dreamfort.ai.
- #4 r/mildlyinfuriating · 26,766 pt · 719 commentaires · 2026-09-21 (lien) — De loin le score le plus élevé de la collecte. Les utilisateurs s’indignent de voir des « images d’inspiration » générées par IA ajoutées sans avertissement à des photos d’annonces immobilières. u/slothboy (5,749 pt) note que transformer cette salle à manger en salle de bains serait un chantier coûtant cinq chiffres. u/BojackWorseman13 (1,138 pt) propose d’apposer en très gros sur la photo qu’elle a été générée par IA.
- #5 r/generativeAI · 7 pt · 31 commentaires · 2026-09-23 (lien) — À propos de la création de longues vidéos IA, l’explication pratique de u/kaboom-o (2 pt) est utile : personne ne réalise une longue vidéo en une seule génération ; il faut décomposer le script en plan de tournage, produire une grande quantité de clips de 5 à 15 secondes, puis les monter. Pour maintenir une expression faciale longtemps, la réponse recommande Seedance 2.5 (jusqu’à environ 30 secondes et audio natif) ; pour l’ébauche de mouvement, Grok Imagine Video (480p, 5 secondes) ; et pour une qualité proche de la photo, Gemini Omni Flash.
- #6 r/Instagramreality · 2,206 pt · 351 commentaires · 2026-09-18 (lien) — Fil signalant qu’une image IA bien notée sur Reddit était en réalité fausse. u/Smart-Membership-117 (427 pt) relève que la moulure près du genou diffère entre les photos 2 et 3, et que la végétation à l’extérieur de la fenêtre a entièrement changé. u/Habibti-Mimi81 (154 pt) répond : « Honnêtement, je ne l’aurais pas remarqué. C’est une époque triste et dangereuse. »
- #7 r/AIdaily_news · 0 pt · 12 commentaires · 2026-09-24 (lien) — Fil rétrospectif sur les vidéos IA qui ont fait parler d’elles en 2024. Le commentaire de u/Erosion139 (1 pt) résume l’ambiance : « C’était l’époque où l’IA rêvait » — beaucoup regrettent les artefacts étranges de cette période.
- #8 r/aiwars · 0 pt · 144 commentaires · 2026-09-24 (lien) — Débat très partagé autour d’un clip d’animation créé seul pour 13 $ avec Seedance 2.5. L’auteur y voit l’avènement d’une époque où l’on peut produire un travail professionnel sans devenir animateur. u/GameMask (4 pt) répond que le fait d’avoir pu le faire pour 13 $ est justement embarrassant et ne représente aucun progrès pour l’industrie de l’animation. u/Onionadin (7 pt) va plus loin : le post semble célébrer une meilleure capacité à tromper les gens.
- #10 r/antiai · 18,115 pt · 623 commentaires · 2026-09-23 (lien) — La communauté antiai se réjouit de l’ajout par DreamWorks d’une clause interdisant l’entraînement IA pour son nouveau film « Forgotten Island ». Mais u/SlowlyDyingInAPit (2,561 pt), auteur du commentaire principal, reste lucide : c’est positif, mais les partisans de l’IA l’utiliseront quand même pour produire du contenu médiocre ; l’interdiction les poussera même à le faire davantage. u/Arckanoid (143 pt) y voit surtout une stratégie juridique : l’objectif n’est pas d’arrêter les usages immédiatement, mais de créer un fondement pour des poursuites.
Signaux
- Présence de l’open source et du local : ComfyUI, FramePack, Seedance 2.5 et MiniMax H3, entre autres, apparaissent à plusieurs reprises dans les fils. La réponse de kaboom-o dans #5 est particulièrement appréciée comme savoir-faire pratique de « chaînage » de modèles.
- Le fermé est évoqué comme une expérience fragmentée : face à la multitude de services fermés — Grok, Veo, Nanobanana, Runway, Luma, Kling, Hailuo, Pixverse — l’idée qu’il est impossible d’avoir simultanément gratuité, haute qualité et absence de filigrane est si ancrée qu’elle est répétée sous forme de commentaire standard par le bot Jenna_AI dans trois fils (#9, #11, #12).
- L’opposition s’intensifie autour de la capacité à détecter le faux : #6 (Instagramreality) et #2 (Nikon) expriment surtout la colère que des productions IA soient consommées comme authentiques. #8 (aiwars) montre directement l’affrontement entre ceux qui voient la démocratisation de la technologie comme positive et ceux qui y voient un outil de tromperie.
- Élément surprenant : une vidéo contenant une « amélioration » IA — en pratique une falsification — a gagné le grand prix du prestigieux concours scientifique Nikon Small World in Motion, et les organisateurs ont répondu de manière défensive (#2). La réaction de la communauté scientifique est extrêmement dure : il ne s’agit plus d’un simple débat sur l’art IA, mais d’éthique de la recherche.
- Sujet sous-estimé ou déjà résigné : les demandes de vidéos IA gratuites et de qualité (#3, #9, #11, #12) aboutissent à chaque fois à la même conclusion — le gratuit n’existe pas, quelqu’un paie l’électricité et les GPU. Le sujet commence à lasser la communauté.
Limites
- Une seule requête a été utilisée :
"Image and Video Generation AI News". Aucune recherche avec des variantes, par exemple les noms individuels de modèles open source ou de services fermés, n’a été menée. Seuls 12 fils ont été collectés, loin de l’objectif d’environ 20 publications par réseau. - Le texte initial des fils #6 (r/Instagramreality) et #7 (r/AIdaily_news) ne figurait pas dans les données collectées ; leur contenu a été déduit uniquement des meilleurs commentaires.
- Toute la collecte est biaisée vers les subreddits anglophones ; aucun fil Reddit japonais ou non anglophone n’a été recueilli, malgré le fait que le brief soit en japonais.
- Peu de fils distinguent explicitement « closed source » et « open source » ; la plupart se limitent à une liste mêlée d’outils. Les résultats Reddit seuls ne permettent donc pas de séparer strictement les 10 tendances ouvertes et les 10 fermées demandées par le brief.
X
X — La prise de contrôle agentique des outils créatifs par Claude Opus 5.5 est le seul signal IA image/vidéo dans cette fenêtre
Origine de cette liste
Le panneau Explore de X ayant fourni les termes de recherche était géolocalisé en Croatie (output/x.posts.md, « What X says is happening ») : 6 de ses 10 tendances étaient explicitement indiquées comme « Trending in Croatia », les autres étant des tendances génériques de sport, musique, économie et technologie. Il s’agit donc d’un instantané local croate de X, non d’une vue mondiale. Seuls 2 termes sur 10 — « Opus 5.5 » et « Claude » — concernaient l’IA de génération d’images ou de vidéos ; les 8 autres ($song, Serbia, Taylor, Cardano, Croats, Croatia, NFTs, England) relevaient de la crypto, du football, des potins de célébrités et de la géopolitique. Voir ## Limits pour les conséquences sur la couverture.
Comptes
Tous les comptes publiant sur le thème ne l’ont fait qu’une fois, sauf un :
- @KanaWorks_AI (KANA|東京AI映像) — le seul compte récurrent, avec 2 publications (150 et 335 likes). Compte tokyoïte spécialisé dans la « vidéo IA », les deux posts portent sur l’usage de Claude Opus 5.5 pour piloter des moteurs de jeu, d’abord Unreal puis Godot.
- @kevin_t_ngo (Kevin Ngo) — 1 publication, mais la portée la plus élevée de l’ensemble : 3,480 likes et environ 236,000 vues. Mentionne directement
@claudeai; une animation Python/Blender a été rendue par Claude Opus 5.5. - @developedbyed (Dev Ed) — 1 publication, 1,071 likes et environ 70,000 vues. Compte connu d’éducation au développement, proposant une comparaison d’animation « OPUS 5.5 vs GPT 6 Astra ».
- @ring_hyacinth — 1 publication, 712 likes et environ 44,000 vues. Créateur individuel relatant une expérience personnelle : transformer un ancien court-métrage en jeu pixel art.
- @aicreataro — 1 publication, 444 likes et environ 45,000 vues. Compte de créateur IA partageant un journal de test structuré : clip de base + opérations dans After Effects.
- @seiiiiiiiiiiru (SEIIIRUAIを使う映像クリエイター) — 1 publication, 163 likes et environ 7,900 vues. Compte japonais de créateur vidéo IA, qui se présente lui-même par l’outil utilisé.
- @ponzponz15 (ぽんず) — 1 publication, 212 likes et environ 32,000 vues. Créateur japonais documentant une technique d’édition précise.
En bref : un compte spécialisé vidéo IA publiant deux fois, et six créateurs individuels présentant chacun une démo ou un test à fort engagement. Aucun n’est un média d’actualité ou industriel : tout relève du format personnel « j’ai essayé ».
Publications
-
@developedbyed (1,071 likes · 26 reposts · 35 réponses · ~70,000 vues · 2026-09-23) — https://x.com/developedbyed/status/2102789774461280370
OPUS 5.5 vs GPT 6 Astra Loss Screen Animation
Comparaison directe d’animations entre modèles depuis un compte à vaste audience de développeurs : le contenu le plus proche d’un benchmark « fermé contre fermé » de l’échantillon. -
@kevin_t_ngo (3,480 likes · 167 reposts · 81 réponses · ~236,000 vues · 2026-09-23) — https://x.com/kevin_t_ngo/status/2102761406315839798
Thank you @claudeai ! GIF animated in Python and rendered in Blender by Claude Opus 5.5
La publication la plus engageante des 40 posts associés au thème. Elle indique une vraie surprise devant la capacité d’un LLM à piloter un moteur de rendu 3D de bout en bout, plutôt qu’à générer simplement une image statique. -
@ring_hyacinth (712 likes · 81 reposts · 51 réponses · ~44,000 vues · 2026-09-23) — https://x.com/ring_hyacinth/status/2102865595675050010
Opus 5.5 is really amazing! I sent the short film Pixel Shanghai that I made a year ago to Opus 5.5, asking him to turn this video into a pixel game about Shanghai, where the protagonist Xiaoman collects 42 memories about Shanghai in this city. The scenes use the pixel [text cut off by X]
Transformation d’une vidéo en ressources de jeu : Opus sert de couche de direction créative au-dessus d’images existantes, plutôt que de générateur à partir de zéro. -
@aicreataro (444 likes · 66 reposts · 7 réponses · ~45,000 vues · 2026-09-23) — https://x.com/aicreataro/status/2102656273112326609
Opus 5.5にAfter Effectsを操作させて、AI動画を加工するテスト。■ベース MiniMax H3で15秒を1本 ■AEでやらせたこと ・カットの切れ目を拍に合わせて速さを調整 ・区間ごとにエフェクトを1つずつ(粒子/光線/万華鏡/データモッシュなど)■わかったこと [cut off]
Indique un véritable modèle vidéo comme couche de base (MiniMax H3, clip de 15 secondes), tandis qu’Opus 5.5 prend en charge la postproduction dans After Effects : un détail concret sur une chaîne ouverte/fermée. -
@KanaWorks_AI (335 likes · 39 reposts · 16 réponses · ~18,000 vues · 2026-09-24) — https://x.com/KanaWorks_AI/status/2102955708321062975
Claude Opus 5.5 × Godotで3Dゲーム開発。Godotでゲームを作るのは、Unityより少し手軽に感じる。動作も軽くて、仕上がりもかなりいい感じ
Le second post du même compte montre qu’il ne s’agit pas d’un essai isolé : il mène une petite série de tests d’Opus 5.5 avec différents moteurs. -
@KanaWorks_AI (150 likes · 16 reposts · 11 réponses · ~8,300 vues · 2026-09-24) — https://x.com/KanaWorks_AI/status/2103138051165933661
Claude Opus 5.5 × Unreal まさか、自分でこんなARPGを作れる日が来るなんて思ってもいませんでした。コントローラーを握って、キャラクターを走らせて、ローリングして、剣を振る。実際に動かしてみた瞬間、心臓がドキドキして、手のひらは汗びっしょり。
Réaction émotionnelle à la création par Opus 5.5 d’un ARPG jouable dans Unreal Engine : le post présente cela comme un jalon personnel, non comme une annonce produit. -
@ponzponz15 (212 likes · 17 reposts · 7 réponses · ~32,000 vues · 2026-09-24) — https://x.com/ponzponz15/status/2102931824918106499
3Dカメラ×立体テキスト演出② After Effectsで作るような編集がClaude OpusやCodexでも可能に。上 Seedance 2.5 prev 下 Codex + Hyperframes skill #dreaminacpp
Cite deux autres éléments de génération et d’outillage — Seedance 2.5 et une compétence Codex + « Hyperframes » — chaînés avec Claude pour produire des animations façon After Effects. -
@seiiiiiiiiiiru (163 likes · 23 reposts · 9 réponses · ~7,900 vues · 2026-09-24) — https://x.com/seiiiiiiiiiiru/status/2103227982592831846
AI広告動画 → AI音声 × AI編集 もうここがゴール地点ってことでいいでしょ。笑 Cluad Opus 5.5にGemini 3.8 Flash TTSでナレーション生成させて、その音声に合わせた動画をそのままClaudeでAEやその他ツールを操作して作りました。
Pipeline complet de publicité vidéo : Gemini 3.8 Flash TTS génère la narration et Claude Opus 5.5 orchestre After Effects afin de synchroniser le montage avec la voix.
Signaux
- En hausse : sur X, la conversation n’est pas « saisir un prompt, obtenir une image ou une vidéo », mais Claude Opus 5.5 comme agent pilotant des logiciels créatifs existants (After Effects, Blender, Unreal, Godot) au-dessus de clips ou ressources provenant d’ailleurs. Dans toutes les publications pertinentes, c’est la partie nouvelle et excitante, non l’étape de génération.
- En hausse : un modèle de chaînage s’installe. Un modèle génératif spécialisé produit la matière brute (MiniMax H3, Seedance 2.5, Gemini 3.8 Flash TTS), puis Opus 5.5 assure l’assemblage, la postproduction et la direction. Deux posts, @aicreataro et @ponzponz15, nomment explicitement le générateur amont.
- Surprise : la publication ayant le plus d’engagement (@kevin_t_ngo, ~236,000 vues) ne porte pas sur la qualité visuelle, mais sur le fait qu’un LLM puisse piloter Blender de bout en bout. Les réactions concernent la capacité d’action, pas la fidélité visuelle.
- Écarté ou absent : aucune mention de Midjourney, Stable Diffusion, Flux, Sora, Runway, Kling, ni de cadrage explicite « open source contre closed source » dans les publications récupérées. Toute synthèse selon cette grille serait une inférence, pas une citation de X.
Limites
- Les termes de recherche étaient la liste de tendances de X, pas le thème. Les 10 requêtes provenaient directement du panneau Explore de X (
output/x.posts.md), géolocalisé en Croatie. Seuls « Opus 5.5 » et « Claude » sont liés à la génération image/vidéo ; les huit autres ont produit crypto, football, potins et débats politiques balkaniques : 32 des 40 posts collectés n’étaient pas utilisables pour ce brief. - Sous l’objectif d’environ 20 posts. Seuls 8 des 40 posts sont dans le thème. Le fichier collecté n’offre aucune marge supplémentaire : le déficit relève de la collecte, non de la lecture.
- Aucune publication directement centrée sur ouvert contre fermé. Rien ne formule explicitement cette opposition ; la répartition ci-dessus est inférée à partir des outils cités.
- Plusieurs textes sont tronqués au point où la collecte X s’est arrêtée, notamment ceux de @aicreataro et @ring_hyacinth.
- Seules des publications en anglais et en japonais sont apparues ; les communautés chinoises, coréennes ou autres communautés de créateurs IA actives sur X ne sont pas couvertes.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos (closed source / open source)
Chaînes
Les nombres d’abonnés n’ont pas pu être récupérés directement, car les pages de résultats YouTube sont rendues en JavaScript ; seules les informations obtenues via oEmbed et recherche web sont indiquées.
- AI WITH Rithesh (RitheshSreenivasan, plus de 10 000 abonnés et plus d’un million de vues cumulées) — Chaîne indienne d’éducation à l’IA. Elle a évalué ChatGPT Images 2.5 d’OpenAI et Qwen-Image-2.1 d’Alibaba dès leur sortie ; c’est l’un des rares exemples suivant les deux camps sur une même chaîne.
- Astrovah (@astrovah) — Chaîne d’outils IA pour créateurs, publiant des vidéos d’« avis honnête » sur GPT Image 2.5.
- REBEL AI (@realrebelai) — A publié une démonstration d’accès anticipé à Qwen-Image 2.1, sous forme de vitrine d’un modèle d’image open source.
- Adrian Viral AI Marketing (@AdrianViralAIMarketing) — Chaîne de comparaison classant les nouveaux modèles pour les spécialistes du marketing IA, ouverts comme fermés.
- Miko (@MikoxAI) — Chaîne de tutoriels sur la production massive de publicités UGC avec des modèles vidéo fermés tels que Seedance 2.5.
- jingchen573 — Spécialisée dans l’exécution locale avec ComfyUI et ayant publié rapidement l’annonce des poids ouverts de MiniMax H3.
Vidéos
-
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! — AI WITH Rithesh — vers le 2026-09-20, juste après la sortie de Qwen-Image-2.1 — https://www.youtube.com/watch?v=3qGl0wiv2G0
Présente Qwen-Image-2.1, modèle d’image à poids ouverts publié par Alibaba le 2026-09-20, avec un générateur de seulement 7B paramètres, et indique qu’il atteint des benchmarks comparables à ceux de Nano Banana 2.0 de Google, un modèle fermé. -
Qwen-Image 2.1 | Early Access Showcase — REBEL AI — fin septembre 2026 — https://www.youtube.com/watch?v=tP_gGGJzEqg
Démonstration d’exemples de génération en accès anticipé. La vidéo met en avant la capacité à générer et modifier des images transparentes avec un seul modèle. -
[ComfyUI] Breakthrough Release: MiniMax H3, the New Leading Open-Source Video Model — jingchen573 — vers le 2026-08-03, date de publication des poids ouverts de MiniMax H3 — https://www.youtube.com/watch?v=XJ4mHfQzZ7I
Annonce la publication Hugging Face de MiniMax H3 (33 milliards de paramètres, omni-modal, jusqu’à 2K/24 fps et audio stéréo natif), avec installation dans ComfyUI. Le titre le présente comme « Open-Source », mais la licence exclut en fait l’UE, le Royaume-Uni, la Corée du Sud et les États-Unis. -
ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked! — AI WITH Rithesh — vers le 2026-09-10, deux jours après la sortie de GPT Image 2.5 — https://www.youtube.com/watch?v=LYUr4BY33h4
Évaluation, 48 heures après la sortie, de ChatGPT Images 2.5 publié par OpenAI le 2026-09-08 : latence réduite jusqu’à 50 % et nouvelle fonction « Sketch ». -
GPT Image 2.5 - Creative Use Cases You've Probably Missed And A Honest Review — Astrovah — vers le 2026-09-21 — https://www.youtube.com/watch?v=_S71zN5tgQY
« Avis honnête » explorant des usages moins connus, mais pratiques, du même modèle. -
I Ranked Every New AI Video Model (Omni 1.1, Seedance 2.5, H3 Max, Wan 3.0, Flux 3, Grok) — Adrian Viral AI Marketing — fin août 2026, environ un mois auparavant — https://www.youtube.com/watch?v=4BoTXsJrxQ4
Classe Gemini Omni 1.1, Seedance 2.5 et Grok (fermés), ainsi que Wan 3.0 et Flux 3, dont certains sont souvent pris à tort pour des modèles ouverts. Une vidéo comparant les options disponibles aujourd’hui, tous statuts confondus. -
Seedance 2.5 + Grok Bot = 50 Viral AI UGC Ads a Day (Full Tutorial) — Miko — 2026-08-22 — https://www.youtube.com/watch?v=mcY7ReDNrd0
Tutoriel pratique de production massive de publicités UGC en combinant les outils fermés Seedance 2.5 et Grok, exemple typique d’un créateur individuel utilisant intensivement des API fermées pour un pipeline commercial.
Signaux
- La frontière entre ouvert et fermé se brouille : de nombreuses vidéos qualifient MiniMax H3 d’« Open-Source », alors que sa véritable licence personnalisée exclut les États-Unis, l’UE, le Royaume-Uni et la Corée du Sud. Les vidéos confondent fréquemment « poids ouverts » et open source réellement libre d’usage.
- Wan 3.0 n’est pas ouvert non plus : la dernière version de la série Wan d’Alibaba, Wan 3.0, publiée par API vers le 2026-08-06, n’a ni poids sur Hugging Face ni dépôt GitHub public. Elle est fréquemment confondue avec Wan 2.2, l’ancienne version sous Apache 2.0, ce qui pousse les spectateurs à croire que tous les modèles Wan sont open source.
- Les modèles ouverts rivalisent avec les leaders grâce à 7B paramètres : Qwen-Image-2.1 est considéré comme comparable à Nano Banana 2.0 malgré son générateur de seulement 7B paramètres. L’efficacité en paramètres constitue un récit fort pour l’écosystème open source.
- Les modèles fermés se différencient par l’UX d’édition, notamment « Sketch » : les critiques de GPT Image 2.5 s’intéressent moins à la qualité brute qu’à la conversion d’un croquis en image via « @Sketch » et à la cohérence des modifications multi-tours. La concurrence se déplace de la génération pure vers les workflows d’édition.
- La génération vidéo devient une chaîne d’outils : les tutoriels comme Seedance 2.5 + Grok de Miko, qui combinent des API fermées pour produire massivement des publicités UGC, montrent que l’attention passe de la comparaison de modèles isolés à la manière de les combiner et de les monétiser. Cette tendance rejoint les résultats de X.
- OpenAI Sora est un vide médiatique : l’API Sora a été arrêtée le 2026-09-24, la veille de l’enquête, mais aucune vidéo YouTube spécifiquement consacrée à cet arrêt n’a été trouvée. L’attention des créateurs s’est déjà déplacée vers Seedance, Wan, Kling et d’autres alternatives.
Limites
- Les pages de résultats YouTube (
youtube.com/results?...) étant rendues en JavaScript, WebFetch ne pouvait pas récupérer directement la liste des vidéos, leurs titres, leurs vues et leurs dates. La collecte a combiné WebSearch (site:youtube.com) et l’API oEmbed de YouTube ; les titres et chaînes ont été confirmés par oEmbed, les dates estimées à partir de snippets de recherche relatifs (« il y a n jours »). - Les vues et les nombres d’abonnés n’ont pas pu être obtenus pour la plupart des vidéos. oEmbed ne renvoie pas les vues et les snippets n’affichent souvent aucun nombre ; la comparaison avec les performances habituelles des chaînes n’a donc pas été possible.
- De nombreuses dates de publication sont des estimations calculées depuis des indications du type « il y a n jours/semaines », avec le 2026-09-25 comme référence.
- L’objectif d’environ 20 publications analysées n’est pas atteint strictement. Sept vidéos ont été collectées, dans la fourchette de 5 à 12 du playbook, mais sous le seuil général des autres plateformes.
- Aucune vidéo YouTube spécialisée sur l’arrêt de l’API Sora n’a été trouvée. Les blogs et sites d’actualité en parlent, mais le sujet semble noyé parmi les vidéos présentant les alternatives.
- Les commentaires n’ont pas été analysés. L’analyse se limite aux titres et descriptions, faute d’accès aux pages vidéo.
Bluesky
Bluesky — Actualités récentes de l’IA image et vidéo
Comptes
- replicate.com (Replicate) — Annonce de nouveaux modèles API, ouverts comme fermés. Le seul compte réellement actif en 2026 pour les actualités de génération d’images et de vidéos.
- ostris.com (Ostris / développeur d’AI-Toolkit) — Publie sur le fine-tuning LoRA de modèles à poids ouverts FLUX, Flex et Wan2.1. Plus aucune mise à jour depuis avril 2025.
- doctordiffusion.bsky.social — Créateur du modèle dérivé de Stable Diffusion 3.5 « Absynth ». Publiait aussi sur l’entraînement LoRA de HunyuanVideo, mais n’a plus mis à jour depuis mars 2025.
- reach-vb.hf.co / hf.co (Hugging Face officiel et équipe) — Présentation de Spaces de modèles ouverts. Les derniers posts relatifs à la génération image/vidéo datent de décembre 2024.
- simonwillison.net — Chercheur IA indépendant. Pas spécialiste de l’image générative, mais mentionne des fonctions multimodales des LLM de pointe et reste actif en septembre 2026.
- midjourneynews.bsky.social — Compte de fan/communauté publiant des expériences de prompts Midjourney. Faible engagement, avec des posts épars jusqu’en juin 2026.
Publications
Modèles fermés
-
GPT Image 2 (OpenAI) ajouté à Replicate — « Killer photorealism and crisp text rendering with strong adherence to layouts, UI, and design use cases. »
2026-04-21|likes 5 · reposts 0|https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Seedance 2.0 (ByteDance) disponible pour tous les utilisateurs — Modèle unifiant texte, image, vidéo et audio, générant des vidéos de qualité studio avec synchronisation audio stéréo et simulation physique.
2026-04-09|likes 2 · reposts 1|https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Article d’évaluation de Seedance 2.0 — « We've spent a lot of time with Seedance 2.0. Here is what we found. » avec lien vers le blog Replicate.
2026-04-15|likes 1 · reposts 0|https://bsky.app/profile/replicate.com/post/3mjkkogr7nd2f -
Vidu Q3 arrive sur Replicate — Génération vidéo depuis texte, image ou image de début/fin, jusqu’à 16 secondes en 1080p, avec synchronisation audio.
2026-03-11|likes 1 · reposts 0|https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w -
Lancement de Runway Gen-4.5 — Nouvelle génération vidéo promettant une « unprecedented physical accuracy and realism ».
2026-02-18|likes 2 · reposts 0|https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Kling 3.0 / o3 ajouté à Replicate — Génération multi-plans en 4K, synchronisation audio, jusqu’à 15 secondes, montage vidéo et transfert de style.
2026-02-17|likes 2 · reposts 0|https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
Création d’un pélican 3D avec GPT-6 Astra et Blender — Simon Willison relate une expérience où GPT-6 Astra construit progressivement un modèle Blender ; un workflow image-vers-3D.
2026-09-05|likes 406 · reposts 30|https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s
Open source (2024–2025, aucune actualisation récente confirmée)
-
Publication de Flex.2-preview — « text to image, universal control (line, pose, depth), and inpainting all baked into one model. Fine tunable with AI-Toolkit, Apache 2.0 license, 8B parameters. »
2025-04-22|likes 4 · reposts 0|https://bsky.app/profile/ostris.com/post/3lngo5cf66k2a -
Prise en charge du fine-tuning LoRA de HiDream — Disponible dans l’interface CLI/GUI d’AI-Toolkit, avec au moins 36 Go de VRAM requis.
2025-04-16|likes 3 · reposts 0|https://bsky.app/profile/ostris.com/post/3lmxfwzrjlc2v -
Vidéo de vacances « AI me » entraînée avec LoRA sur HunyuanVideo — Partage aussi de la méthode d’entraînement utilisant diffusion-pipe.
2024-12-25|likes 1 · reposts 0|https://bsky.app/profile/doctordiffusion.bsky.social/post/3le5ovtycmk23 -
Publication d’Absynth 2.0, dérivé de Stable Diffusion 3.5 — « SD3.5 Lives! 🎨🤖 », disponible sur Civitai/Hugging Face.
2025-01-19|likes 3 · reposts 0|https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x -
Récapitulatif hebdomadaire des Spaces Hugging Face — Présente des Spaces de génération d’images ouverts tels que « Flux Kolors Character » et « JanusFlow 1.3B ».
2024-11-18|likes 7 · reposts 0|https://bsky.app/profile/reach-vb.hf.co/post/3lb7slz2ycc2j
Signaux
- Les modèles fermés se sont mis à jour très rapidement au premier semestre 2026 : GPT Image 2 d’OpenAI, Seedance 2.0 de ByteDance, Kling 3.0, Runway Gen-4.5 et Vidu Q3 sont apparus entre février et avril. Les séquences multi-plans, l’audio synchronisé et la 4K/1080p deviennent les spécifications standard des modèles vidéo. Sur Bluesky, Replicate est pratiquement l’unique source primaire.
- La communication open source sur Bluesky est de fait à l’arrêt : les créateurs qui parlaient du fine-tuning de FLUX/Flex/Wan2.1/HunyuanVideo, ainsi que les comptes Hugging Face, n’ont plus publié de contenu image/vidéo depuis fin 2024 ou printemps 2025. Or les recherches web confirment des sorties de poids ouverts en 2026 — Qwen-Image-2.1 le 20 septembre, HunyuanImage 3.0, Z-Image Turbo — presque invisibles sur Bluesky.
- L’engagement est globalement faible : hors comptes atteignant le grand public tech comme Simon Willison, les publications ne recueillent que quelques likes. Bluesky ne semble pas être un hub d’information primaire pour ce domaine ; X, Discord et Hugging Face paraissent être les lieux principaux.
Limitations
app.bsky.feed.searchPosts, l’API de recherche officielle, a renvoyé HTTP 403 pour tous les mots-clés testés, dont « image generation AI » et « nano banana ». La version web debsky.app/search, pilotée par JavaScript, ne pouvait pas non plus être récupérée. La solution de remplacement a consisté à appeler individuellementgetAuthorFeedpour des comptes trouvés par recherche web.- La couverture est donc limitée aux publications des comptes découverts, non à une recherche exhaustive par mots-clés. Des comptes et publications populaires non trouvés peuvent manquer.
- Les comptes attendus de Black Forest Labs, fal.ai, Stability AI ou Civitai n’ont pas pu être résolus sur Bluesky.
- Aucune publication primaire Bluesky n’a été trouvée pour les grandes sorties de poids ouverts de 2026, comme Qwen-Image-2.1, HunyuanImage 3.0 ou Z-Image Turbo.
- Environ 30 publications candidates provenant de 6 comptes ont été récupérées et 12 enseignements concrets ont été rapportés ; le seuil d’environ 20 par réseau n’est pas atteint, la recherche API étant indisponible.
Lemmy
Lemmy — Tendances récentes de l’IA de génération d’images et de vidéos
Communautés
- !«メールアドレス» (également fédérée sur lemmy.world) — 5.71K abonnés, dont 894 locaux. Espace consacré aux technologies favorites de génération d’art IA ; les sujets portent surtout sur les outils ouverts, l’intégration ComfyUI et les liens Hugging Face/GitHub. C’est le foyer de fait du thème sur Lemmy.
- !«メールアドレス» — 2.36K abonnés, 362 locaux, 3.55K publications, 31 utilisateurs actifs par jour et 97 par semaine. Partage de créations réalisées avec Stable Diffusion ou des modèles à poids ouverts, avec une activité presque quotidienne.
- !share_anime_art (lié à stable_diffusion_art) — Publications d’art IA consacrées aux personnages d’anime, par exemple Fate, Idolmaster ou Disgaea.
- !stable_diffusion_abstract / !stable_diffusion_mycology — Petites communautés où PapaSkwat utilise un LoRA personnel entraîné sur ses peintures à l’huile et à l’acrylique, exécuté localement avec SDXL, pour produire des œuvres abstraites et des motifs de champignons.
- !ai_reddit (instance inconnue, probablement cross-post automatique de r/ArtificialIntelligence) — Reçoit beaucoup d’actualités fermées sur l’arrêt de l’API Sora, Nano Banana, Seedance, Veo et Kling, mais les scores restent généralement entre 0 et 1 et il y a très peu de discussion réelle.
- !hackernews — Communauté miroir de Hacker News, où apparaissent à l’occasion des liens vers les annonces officielles de Qwen-Image-2.1 ou Seedance 2.5.
- Référence : !«メールアドレス», !«メールアドレス» et !«メールアドレス» sont aussi consacrées à l’IA, sans être spécialisées dans la génération d’images ou de vidéos.
Publications
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — !stable_diffusion, score 13, 2026-09-22. Nouvelle version d’un modèle d’image à poids ouverts : 7B paramètres, sortie native 2K, transparence RGBA et édition possible à partir de 10 images. https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
- Qwen-Image-2.1: Compact, efficient, and unified image creation — !hackernews, score 2, 2026-09-20. Annonce officielle Qwen. https://qwen.ai/blog?id=qwen-image-2.1
- ComfyUI-Fantastic-MiniMaxH3-PromptBuilder / ComfyUI_MinimaxH3_AutoContext / comfyui-obvpm-timeline — !stable_diffusion, scores 1 à 6, 2026-09-16 à 09-22. Arrivée successive d’outils ComfyUI pour MiniMax H3 : génération de longues vidéos et gestion de prompts.
- tencent/HunyuanVideo-I2V — !stable_diffusion, score 5. Modèle open source image-vers-vidéo, avec modèle FP8 et workflow d’intégration ComfyUI. https://huggingface.co/tencent/HunyuanVideo-I2V
- I ran the same prompt through 6 AI video models and had ~40 people blindrank the results — !ai_reddit, score 1, 2026-09-17. Évaluation subjective : Veo en première place, Seedance 2.5 très proche en deuxième, Hailuo loin derrière. https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !ai_reddit, score 1, 2026-09-20. Bilan selon lequel les produits grand public spectaculaires échouent, tandis que les solutions B2B plus discrètes — Synthesia, Heygen, Kling, Argil — génèrent des revenus. https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Seedance 2.5 annonce officielle — !hackernews, score 3, 2026-08-01. Améliorations incluant des vidéos de 30 secondes et jusqu’à 50 images de référence. https://seed.bytedance.com/en/blog/
- Google quietly discontinues its Earth AI feature a day after its rollout — !ai_reddit, score 1, 2026-08-07. Après l’intégration de Nano Banana 2 à Google Earth, des utilisateurs ont généré de fausses images de catastrophes et conflits en lieux réels ; la fonctionnalité a été retirée en 24 heures. https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Nano Banana 2 Lite page officielle — !hackernews, score 1, 2026-06-30. Lancement comme modèle de génération d’images à faible coût, environ 3 yens par image. https://deepmind.google.com/models/gemini-image/flash-lite/
- Microsoft's MAI-Image-2.5 Pulls Even With Google's Nano Banana 2 on Benchmarks — !ai_reddit, score 1, 2026-05-28. Monte à la troisième place du classement Arena. https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/
- Midjourney pivots from AI image generation to body scanning medical spa / Midjourney Medical — !technology (score 58) / !hackernews / !techtakes (score 40), 2026-06-18 à 19. Nouvelle surprenante : Midjourney, emblème de la génération d’images, se réoriente vers des scanners médicaux « Ultrasonic CT ». Une information parallèle évoque une action demandant aux studios d’Hollywood de révéler leur usage de l’IA. https://www.theregister.com/ https://techcrunch.com/
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — !ai_reddit, score 1, 2026-09-14. Comparaison de colorisation automatique de manga avec ChatGPT Images 2.5, Wan 2.7 Pro, Nano Banana Pro et Seedream 5.0 Pro ; ChatGPT est jugé meilleur pour préserver le trait. https://www.reddit.com/gallery/1wfyqdy
Signaux
- Lemmy est lui-même plutôt froid envers l’IA : dans un post intitulé « Where are the AI user communities on Lemmy? », le commentaire le plus voté, 36 voix, recommande de chercher hors du Fediverse, Lemmy étant plutôt anti-IA. Les communautés !stable_diffusion de l’instance db0 concentrent donc l’essentiel de l’accueil pour les utilisateurs de modèles ouverts.
- L’écosystème ouvert publie surtout du “faire et utiliser” : !stable_diffusion se concentre sur les nœuds ComfyUI et liens Hugging Face ; !stable_diffusion_art sur les œuvres générées chaque jour, avec Krea2 turbo, Qwen et LoRA personnels. Les scores restent faibles, mais l’activité est continue.
- Les actualités fermées sont presque entièrement importées : arrêt de Sora, Nano Banana, Seedance et virage médical de Midjourney arrivent sur Lemmy seulement via des cross-posts de r/ArtificialInteligence, avec des scores proches de 0 à 1. Il n’y a quasiment pas de discussion locale.
- Douze éléments ont été vérifiés au total, environ six ouverts et six fermés ; la limite de 12 du playbook a donc été atteinte.
Limites
- Les requêtes directes à l’API officielle Lemmy (
/api/v3/community,/api/v3/post/list) ont renvoyé des erreurs HTTP 400/500. L’accès aux publications et à certains nombres d’abonnés repose donc sur des fragments de recherche web et de pages. - Plusieurs mots-clés ont généré beaucoup de bruit politique et social ou aucun résultat direct, notamment « Flux AI », « Runway AI » et « Kling AI ».
- L’instance exacte de !ai_reddit n’a pas pu être identifiée.
- Le seuil d’environ 20 publications analysées n’est pas atteint, car la densité de publications Lemmy est faible. Plus de 30 candidats ont toutefois été examinés avant d’écarter doublons et contenus hors sujet.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
50 épingles ont été collectées à partir d’une seule recherche (« Image and Video Generation AI News », sans séparation par genre). J’ai ouvert directement 20 images — indices 1–13, 16, 22, 25–26, 28, 31–33, 36, 38–39, 41–43, 45 et 47–49 — pour vérifier ce qu’elles montrent réellement, car la plupart des titres sont vagues ou génériques.
Thèmes visuels
- Miniatures YouTube « AI NEWS » : homme barbu, yeux écarquillés ou expression choquée, à côté d’une grille de logos 3D néon d’OpenAI, Google, Microsoft, Meta et Notion. Un cadrage clickbait à la MrBeast appliqué aux récapitulatifs IA [1, 28].
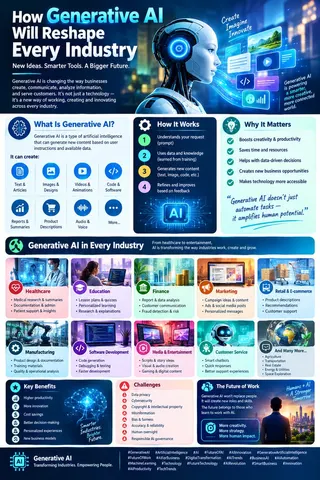
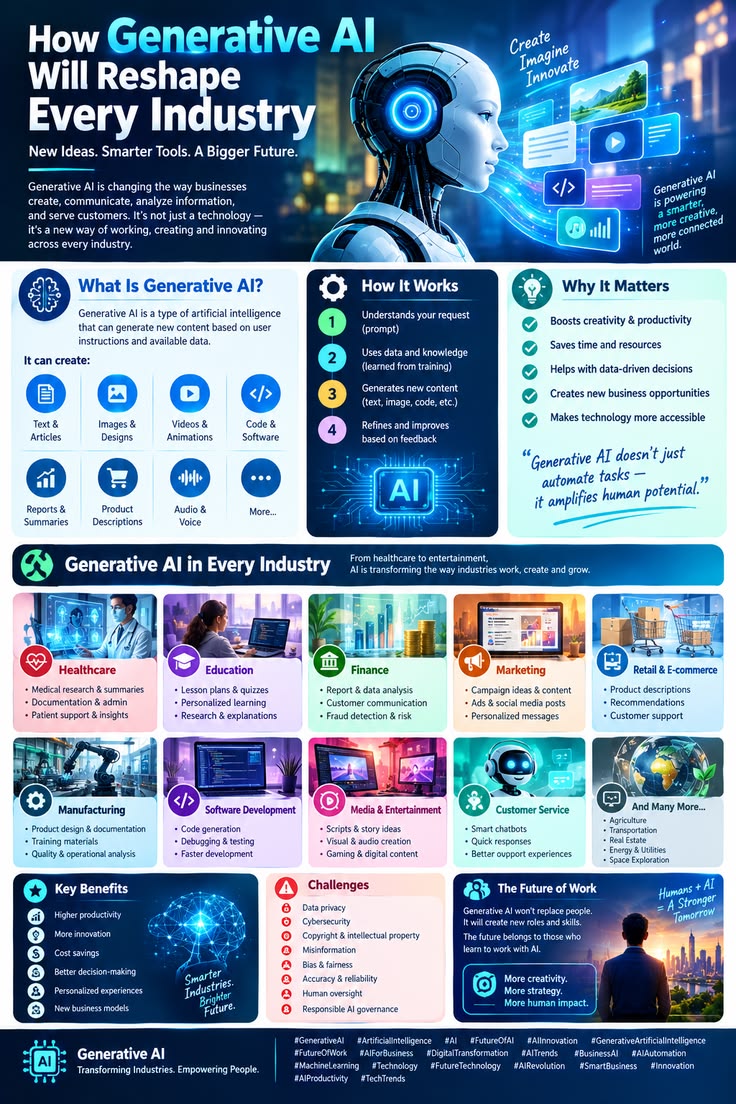
- Gros plans de robots humanoïdes blancs ou d’androïdes aux yeux bleus lumineux, utilisés comme symbole générique de l’IA dans des sujets sans rapport direct : détection de fausses informations, éthique, infographies sur l’IA dans l’industrie et illustration de présentateur d’actualité [3, 22, 41, 43, 48, 49].
- Infographies publicitaires SaaS néon sur fond bleu marine : fonds très sombres, cadres lumineux rose-violet-cyan et typographie condensée en gras, avec des titres comme « 6+ BEST AI VIDEO GENERATION WEBSITES » ou « AI IMAGE VIDEO — BEST QUALITY VS BEST FREE ». C’est le format dominant pour les comparatifs d’applications [4, 9, 39].
- Grilles de logos et comparatifs d’outils reprenant toujours les mêmes produits : Runway, Pika, Kling AI, Luma/Dream Machine, Canva AI et Hailuo AI pour la vidéo ; ChatGPT/DALL·E, Midjourney, Gemini, Adobe Firefly, Recraft, Ideogram et Krea pour l’image [4, 9, 39].
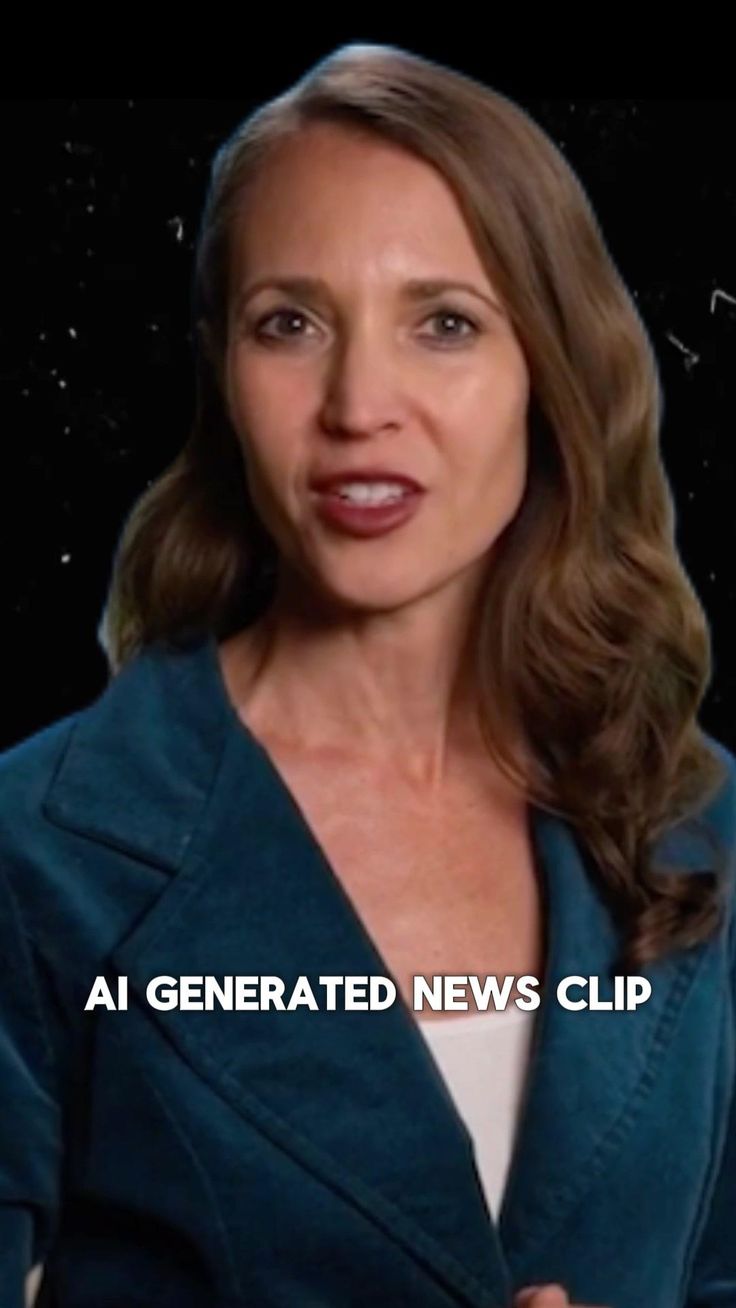
- Visuels d’anxiété autour des informations générées par IA : bandeaux de journal télévisé réalistes marqués « AI GENERATED » ou dans le style NBC News sur des présentateurs visiblement synthétiques, ainsi que tampons « FAKE » sur des robots tenant un téléphone [3, 32, 45, 48].
- Macros de puces et circuits avec le mot “AI” lumineux intégré au silicium, utilisés comme images génériques de matériel et de calcul [5].
- Grilles de démonstration de transfert de style et préservation d’identité : une vidéo ou photo source est re-rendue en styles « blocs de bois », « origami », « lego » ou « fleurs » [2].
- Motif de collage ou mur de miniatures : des dizaines de petites images vidéo IA ou cartes de vidéos verticales réunies dans une seule image haute, symbolisant l’inondation des fils par les contenus IA [31, 49].
Épingles notables
- #1 — « AI News: Anthropic Leak Shows Us The Future of AI... » : miniature réactionnelle citant Anthropic avec les logos OpenAI/Google/Microsoft ; les actualités des laboratoires fermés sont emballées comme du drame ou des fuites à cliquer.
- #2 — « Google announces ultra-high quality video... » : grille 3x5 qui re-rend une même vidéo en bois, origami, lego et fleurs ; démo concrète de restylage vidéo préservant l’identité, de type Nano Banana/Gemini, pas une simple diapositive de logos.
- #4 — « 6+ Best AI Video Generation Websites » : infographie citant Runway, Pika, Kling AI, Luma, Canva et Hailuo comme boîte à outils vidéo par défaut, avec une statistique indiquant que 80 % du contenu en ligne inclura de la vidéo d’ici 2026.
- #9 — « AI Image Video: Best Quality vs Best Free » : arbre de décision séparant les offres payantes — ChatGPT Plus, Gemini Advanced, Midjourney, Adobe Firefly, Recraft, Runway Gen-3, Luma, Pika Pro, Kaiber, Synthesia — des offres gratuites — Ideogram, Gemini Free, SeaArt, Playground, Krea, Canva, Inkscape, CapCut, Pika Free, Runway Free. C’est un instantané utile de ce que Pinterest considère comme le haut de gamme.
- #11 — « Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API » : graphique en entonnoir faisant converger image et texte vers un flux de sortie, marqué « Gemini API ». La vidéo avec audio native est commercialisée comme produit d’API pour développeurs, pas seulement comme application grand public.
- #26 — « Google’s Gemini Omni Turns Anything Into Video » : une agence marketing tierce, Osiz Technologies, réemballe une annonce de capacité Gemini Omni : signe que les nouveautés de modèles fermés sont immédiatement réutilisées comme contenu SEO et génération de prospects.
- #28 — « AI News: OpenAI Finally Released What We Asked For » : même créateur et même format de miniature réactionnelle que #1, cette fois centré sur OpenAI ; il s’agit donc d’une série récurrente.
- #38 — « Amuse 3.0 » : portrait photoréaliste d’un vieux pêcheur, crédité comme image générée par IA sur AMD ; l’une des rares épingles reliant la génération d’images à un fabricant de matériel et à l’exécution locale/NPU plutôt qu’à une API cloud.
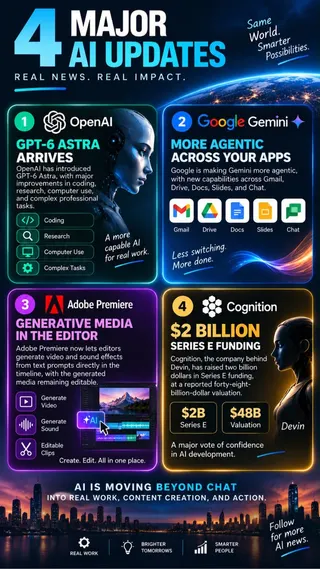
- #39 — « 4 Major AI Updates » : cite GPT-6 Astra, Gemini agentique entre applications, la génération vidéo/son intégrée à Adobe Premiere, et la série E de 2 milliards de dollars de Cognition pour une valorisation de 48 milliards. Le digest d’actualité fermée le plus concret et le plus daté de l’échantillon.
- #45 — « AI Generated News Clip » : présentateur synthétique explicitement étiqueté sur l’image ; l’illustration la plus claire du passage de la vidéo IA à la production d’information, en écho aux épingles #32 et #48 de style NBC News.
Signaux
- Ce qui domine actuellement : Pinterest est dominé par le même petit groupe de noms fermés — Runway, Pika, Kling, Luma/Dream Machine, Google Gemini/Veo, OpenAI et Adobe Firefly/Premiere. Les modèles ouverts, tels que Stable Diffusion, Flux, HunyuanVideo, Wan, LTX ou ComfyUI, n’apparaissent pratiquement jamais. L’audience Pinterest privilégie les comparatifs « quelle application payante ou gratuite utiliser ? » et les récapitulatifs d’actualité, pas la discussion technique au niveau des modèles.
- Une forte tendance secondaire : les contenus liés à l’anxiété et à la confiance — tampons « FAKE », présentateurs IA, clips d’actualité façon NBC, illustrations de détection de voix — sont presque aussi fréquents que les comparatifs d’outils. La désinformation et la confiance médiatique sont un genre visuel de premier plan.
- Absent : aucun nom de modèle open source ou de dépôt, aucune marque Hugging Face, aucune capture de workflow LoRA/fine-tuning/ComfyUI, aucun graphique de benchmark et très peu de recherche technique sur la génération vidéo. La version Pinterest du sujet est orientée grand public et marketing, contrairement à Reddit ou X.
- Plusieurs épingles sont d’anciens contenus SEO récurrents plutôt que des informations de la semaine. La fraîcheur doit être évaluée au cas par cas depuis les dates et versions visibles, comme « GPT-6 Astra » ou « Amuse 3.0 », sans la supposer à partir du résultat de recherche.
Limites
- Le playbook indiquait que les images avaient déjà été collectées par un worker de navigateur sans interface ; Pinterest n’a pas été parcouru directement et aucune recherche supplémentaire au-delà de
pinterest.pins.md/images/pinterest/n’a été possible. - Les 50 épingles proviennent d’une requête unique et non séparée par genre. Il était impossible de produire la structure ouverte/fermée demandée par le brief, car le jeu lui-même ne fait ressortir aucun projet open source.
- Vingt images seulement ont été inspectées individuellement ; les 30 autres, principalement des entrées génériques « (untitled) », semblent répéter les mêmes motifs visuels selon leurs titres.
- Les métriques d’engagement Pinterest, telles que sauvegardes et commentaires, ne sont pas exposées. La notion de tendance est donc inférée de la répétition visuelle et thématique, non de signaux de popularité.
Actions recommandées
- Suivre en continu les mises à jour de benchmarks des petits modèles ouverts comme Qwen-Image-2.1.
- Vérifier les clauses de licence avant de classer un modèle se disant open source.
- Inclure dans la prochaine enquête les migrations vers les alternatives après l’arrêt de l’API Sora.
- Ajouter des recherches par noms propres, notamment ComfyUI et Hugging Face, pour Bluesky et Pinterest afin de compenser la faible visibilité du monde ouvert.
- Pour X, repartir de mots-clés liés au thème plutôt que du panneau de tendances.
Images collectées
































Note sur la qualité des données
Sur les six plateformes, l’objectif du brief — environ 20 éléments par réseau — n’a jamais été atteint. Sur X, seules 8 des 40 publications collectées correspondaient au thème, en raison du panneau de tendances croate servant de point de départ ; l’API par mots-clés Bluesky renvoyait une 403 et imposait de s’appuyer sur les comptes déjà identifiés ; Pinterest, avec une requête unique, ne contenait aucun matériau open source.