Actualités de l’IA de génération d’images et de vidéos — 2026-09-22
La fermeture de l’API Sora le 2026-09-24 est l’histoire closed source marquante du moment, tandis que MiniMax H3 et les laboratoires chinois à poids ouverts (Alibaba/Qwen, ByteDance, Baidu, Tencent) portent l’écosystème open source à la croissance la plus rapide, centré sur ComfyUI.
Actualités de l’IA de génération d’images et de vidéos — 2026-09-22
Le principal sujet côté closed source est l’arrêt total de l’API de génération vidéo Sora d’OpenAI le 2026-09-24 (deux jours après ce rapport) — l’application a déjà fermé en avril, sur fond de dégradation de la rentabilité : environ 1 million de dollars de coûts d’exploitation quotidiens pour environ 2,1 millions de dollars de recettes cumulées. Parallèlement, GPT Image 2.5 et Nano Banana Pro/2 de Google DeepMind rivalisent en vitesse et en photoréalisme, et la concurrence entre acteurs closed source s’intensifie avec des mises à jour toutes les quelques semaines. Côté open source, l’écosystème ComfyUI continue de croître autour de MiniMax H3, avec une succession notable de nouveaux modèles des laboratoires chinois Alibaba (Qwen), ByteDance, Baidu et Tencent. Sur plusieurs plateformes, certains estiment également que l’écart de qualité perçue entre solutions closed et open se réduit.
Toutes plateformes confondues
- La fin de l’API Sora (2026-09-24) est le principal thème commun côté closed source. Le post Bluesky d’Ed Zitron (3 572 likes, le plus fort engagement de toute cette collecte) a annoncé la nouvelle ; une vidéo YouTube récapitulative sur l’état de la vidéo IA et un post !ai_reddit sur Lemmy abordent le même sujet. Trois plateformes considèrent indépendamment cet événement comme prioritaire, en le présentant comme un exemple montrant que le closed source n’est pas nécessairement un marché où le gagnant rafle tout, compte tenu de la détérioration du rapport revenus/coûts.
- MiniMax H3 est le mot-clé commun de la génération vidéo open source. Reddit discute concrètement des moyens d’utiliser gratuitement Wan et MiniMax H3 ; Adina Yakup sur Bluesky présente « HyperFlow », une variante MiniMax H3 distillée en huit étapes et accélérée ; Lemmy compte plus de cinq publications de nœuds liés à MiniMax H3 pour ComfyUI entre août et septembre 2026. Le même modèle ressort indépendamment sur trois plateformes : c’est sans doute le modèle vidéo à poids ouverts le plus dynamique.
- GPT Image 2.5 est mentionné sur trois plateformes comme modèle phare de la génération d’images closed source. Sur Reddit (r/ImagineAiArt, fil à 92 points), il est à la fois encensé et jugé indiscernable de KREA2 ; YouTube détaille une réduction de 50 % de la latence de génération et la fonctionnalité Sketch ; Simon Willison sur Bluesky l’a aussi utilisé pour produire une image conceptuelle.
- Les laboratoires chinois se distinguent nettement côté open source. Alibaba (Qwen-Image-2.1), ByteDance (Lance, Seedance), Baidu (ERNIE-Image) et Tencent (HunyuanVideo 1.5) sont régulièrement cités sur Bluesky, YouTube et Lemmy. Ces modèles à poids ouverts sous licences de type Apache-2.0 confirment sur plusieurs plateformes que les acteurs chinois dominent presque entièrement la dynamique open source.
- ComfyUI est devenu l’infrastructure commune de fait. Presque toutes les vidéos de test YouTube et la majorité des posts !«メールアドレス» évoquent des implémentations ou workflows ComfyUI : l’usage concret des outils open source semble s’y concentrer.
- L’écart de qualité perçue entre closed et open se resserre. Sur Reddit, un commentaire estime que « GPT Image 2.5 et KREA2 donnent le même résultat » ; Pinterest est au contraire écrasé par le marketing closed source et ne mentionne presque jamais l’open source. Cette asymétrie suggère moins une faiblesse technique de l’open source qu’un déficit de visibilité auprès du grand public.
Plateforme par plateforme
Reddit : 12 fils provenant de 7 subreddits ont été collectés. La demande de génération vidéo IA gratuite s’oppose à une ambiance de plus en plus sèche — « comprenez que ce n’est plus possible » —, tandis que les recommandations vers les modèles à poids ouverts tels que Wan et MiniMax H3 apparaissent spontanément. La hausse rapide des utilisateurs de DeepSeek (+66,7 %) et le manque de capacité de calcul constituent aussi un signal clair. Des commentaires promotionnels utilisant le même code de parrainage réapparaissent dans plusieurs fils : il faut rester attentif à l’intrusion publicitaire dans les discussions organiques.
X : parmi les 32 posts collectés depuis 31 comptes, aucun ne concernait l’IA de génération d’images ou de vidéos. Les termes de recherche utilisés (Bitcoin, Zelensky, Zagreb, etc.) reprenaient tels quels les tendances Explore standard de X, vraisemblablement locales autour de la Croatie, plutôt que des requêtes liées au sujet. Aucune connaissance substantielle sur ce thème n’a donc été obtenue sur X.
YouTube : plus de 30 titres ont été repérés par WebSearch, dont 13 vidéos représentatives retenues. Côté closed source, les comparaisons à trois entre GPT Image 2.5, Nano Banana Pro/2, Sora 2, Veo 3.1 et Kling 3.0 sont un format récurrent. Côté open source, Z-Image Turbo, Qwen-Image-2.1, LTX-2 et HunyuanVideo 1.5 illustrent une tendance continue à alléger les modèles sans réduire leurs performances. Les pages étant rendues en JavaScript, les vues et dates exactes n’ont pas pu être obtenues et doivent être considérées comme approximatives.
Bluesky : l’API de recherche (searchPosts) est restée inaccessible avec une erreur 403 ; l’analyse a donc été remplacée par une lecture directe des feeds de comptes pertinents. Le post d’Ed Zitron sur l’arrêt de Sora a obtenu le plus fort engagement. Les actualités open source reposent presque entièrement sur Adina Yakup de Hugging Face, tandis que les comptes officiels de Civitai, ComfyUI et Stability AI étaient silencieux ou inactifs.
Lemmy : 16 posts répartis dans 8 communautés ont été analysés. Les nouvelles closed source sont presque toutes des reprises indirectes via un miroir Reddit (!ai_reddit) ou Hacker News (!hackernews), avec de faibles scores. Le seul sujet devenu viral est la réorientation de Midjourney de la génération d’images vers les scanners CT médicaux à ultrasons (score 40). Côté open source, les posts de nœuds ComfyUI pour MiniMax H3 se sont poursuivis d’août à septembre.
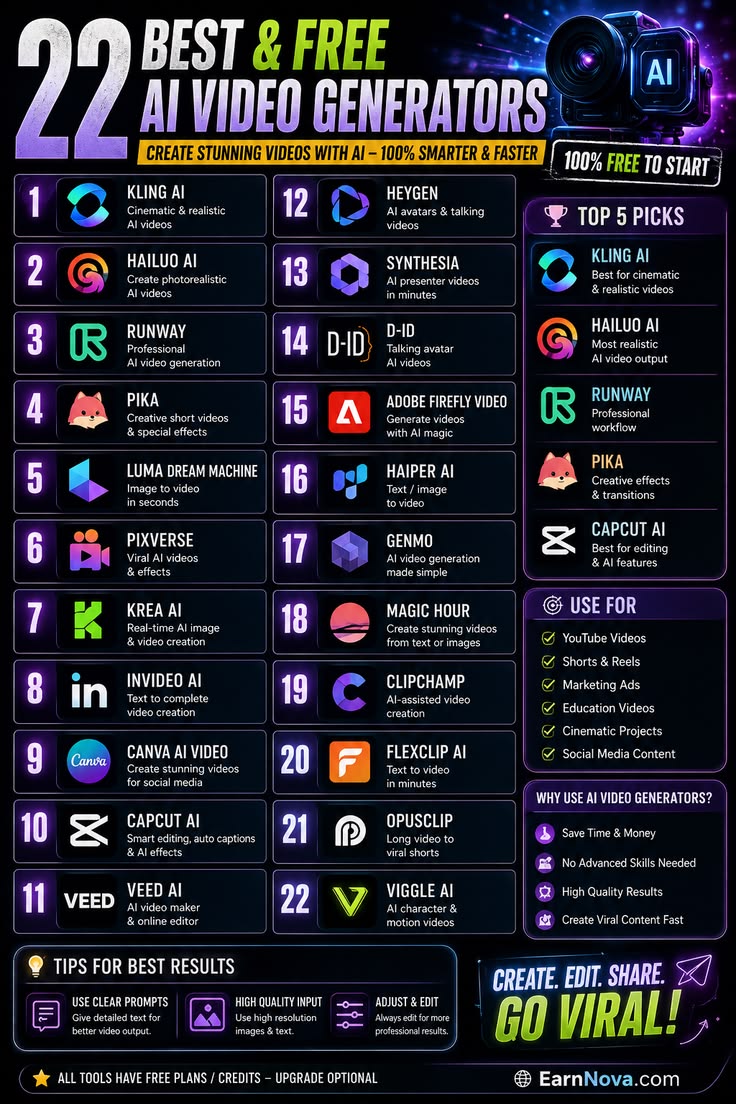
Pinterest : 50 pins ont été analysés. Ils sont majoritairement composés de visuels de listes « Best AI Video Generator » et d’illustrations génériques de robots IA ; Kling AI et Hailuo AI figurent désormais parmi les solutions de premier plan aux côtés de Runway, Pika et Luma. Les références à l’open source sont pratiquement nulles : une seule occurrence du titre « Open Models. Open weights. ». C’est en soi une observation importante : sur les plateformes tournées vers le grand public, l’open source est presque invisible.
Parmi les six plateformes demandées dans le brief, X (effectivement zéro résultat en raison d’un mauvais choix de requêtes) et Reddit (12 fils pour un objectif d’environ 20) ne satisfont pas le critère de complétion d’« analyse d’environ 20 publications ». Ces lacunes sont explicitées ; l’absence d’autres plateformes non demandées par le brief est hors périmètre.
À surveiller
- La compétition pour récupérer les utilisateurs après l’arrêt de l’API Sora (2026-09-24) — Bluesky, post d’Ed Zitron : https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- La question de la licence « recherche non commerciale » de Qwen-Image-2.1 — débat sur la possibilité de le qualifier d’open source. YouTube : https://www.youtube.com/watch?v=tP_gGGJzEqg
- Le rythme d’expansion de l’écosystème MiniMax H3 × ComfyUI — Lemmy : https://lemmy.dbzer0.com/post/74279236
- LTX-2 peut-il devenir le nouveau benchmark de la vidéo open source ? — YouTube : https://www.youtube.com/watch?v=27UAb_Tlv4E
- Les conséquences de la hausse de la demande DeepSeek (+66,7 %) et de l’insuffisance de calcul — Reddit : https://www.reddit.com/r/DeepSeek/comments/1wmcgex/
- Les suites de la réorientation de Midjourney vers les dispositifs médicaux — Lemmy : https://awful.systems/post/8731127
Recommandations
- Suivre lors de la prochaine recherche la destination du trafic migré après l’arrêt de Sora : Seedance 2.5, MiniMax H3 ou Kling v3.
- Continuer de surveiller les annonces officielles de Hugging Face et Alibaba pour voir si la politique de licence de Qwen-Image-2.1 évolue.
- Observer à fréquence fixe les publications de nœuds ComfyUI liés à MiniMax H3 comme indicateur avancé de l’élan de la vidéo open source.
- Lors de la prochaine collecte sur X, abandonner les tendances régionales au profit de requêtes propres au sujet, telles que "AI image generation", "Sora" et "Midjourney".
- Passer sur Reddit d’une requête unique à plusieurs recherches par nom de modèle afin d’atteindre le critère de complétion de 20 publications.
- Vérifier la réorientation de Midjourney vers les CT médicaux à ultrasons auprès de la source primaire (midjourney.com/medical), afin de la distinguer de l’information secondaire devenue virale.
Qualité des données
Sur X, une erreur de sélection des termes de recherche a produit 32 résultats dont aucun n’était lié au sujet ; aucune information substantielle n’a donc pu être apportée. Reddit n’a recueilli que 12 fils avec une seule requête, loin de l’objectif d’environ 20. Sur Bluesky, l’API de recherche officielle étant constamment inaccessible avec une erreur 403, l’échantillonnage a basculé vers la lecture directe de comptes et ne constitue pas une recherche exhaustive par mots-clés. YouTube étant rendu en JavaScript, les nombres de vues et dates de publication exactes n’ont pas pu être obtenus ; les dates sont approximatives. Lemmy ne permet pas de recherche transversale entre toutes ses instances distribuées, et l’examen s’est limité à six instances principales. Pinterest a permis d’analyser 50 pins, mais leur absence quasi totale de références open source biaise les données vers le point de vue closed source.
Synthèse par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
Les 12 fils collectés proviennent de 7 subreddits.
| Subreddit | Membres | Fils collectés |
|---|---|---|
| r/generativeAI | 155,851 | 5 |
| r/ImagineAiArt | 19,415 | 1 |
| r/aivideomaking | 7,414 | 2 |
| r/DeepSeek | 140,403 | 1 |
| r/Purdue | 100,714 | 1 |
| r/aivideos | 123,539 | 1 |
| r/Instagramreality | 1,155,229 | 1 |
r/generativeAI est le plus représenté ; le sujet central est la demande elle-même de « créer gratuitement des vidéos IA ». Les sous-forums spécialisés (r/aivideomaking, r/aivideos, r/ImagineAiArt) discutent d’outils et de techniques concrets ; r/DeepSeek traite de l’actualité d’un modèle spécifique ; r/Purdue et r/Instagramreality (immense communauté de plus de 1,15 million de membres) abordent des cas où des créations IA se sont mêlées au monde réel et ont suscité une polémique.
Ce que disent les utilisateurs
- La demande de génération vidéo IA gratuite reste forte, mais l’ambiance communautaire tend vers « comprenez que ce n’est plus possible ». Dans le fil #2 « Why do so many people expect to find a free AI video generator? » (39 points, 79 commentaires, 2026-09-21, https://www.reddit.com/r/generativeAI/comments/1wm2csy/), l’auteur note lui-même que « Sora 2 a été mis à disposition gratuitement et a attiré beaucoup d’utilisateurs, mais OpenAI a fini par l’arrêter », pour conclure que « AI video generation is just expensive, and free is not a sustainable model ».
- Dans les commentaires de ce fil, u/buttchuckjones (4 points) indique être passé de 10 Go de VRAM à une 5080 (16 Go) pour générer localement et souhaite que davantage de personnes sur le subreddit adoptent la génération locale, soutenant ainsi l’approche locale/open source.
- Dans le fil #1 « Which AI video generator can still be used for free? » (20 points, 68 commentaires, 2026-09-16, https://www.reddit.com/r/generativeAI/comments/1whtesl/), u/RioMetal (4 points) recommande des modèles à poids ouverts comme Wan ou Minimax. u/tuckken2 (3 points) partage une méthode concrète : Wan 2.2 et MiniMax H3 sont gratuits sur cnaps studio, avec des crédits réinitialisés toutes les cinq heures.
- Côté closed source, GPT Image 2.5 Flare est au centre des discussions. Dans le fil #3 « GPT Image 2.5 Flare — is this actually the best AI image generating model right now? » (92 points, 62 commentaires, 2026-09-16, https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/), u/oldboi777 (4 points) le considère comme une amélioration remarquable, tandis que u/Dependent_Quit_3730 (3 points) préfère continuer à utiliser KREA 2. u/SeaworthinessFresh16 (2 points) estime que le résultat dans ComfyUI avec Krea2 paraît identique.
- DeepSeek, à poids ouverts, combine croissance rapide et insuffisance de l’offre. Dans le fil #6 « some deepseek news, if you care » (206 points, 36 commentaires, 2026-09-21, https://www.reddit.com/r/DeepSeek/comments/1wmcgex/), le nombre d’utilisateurs actifs quotidiens passe de 120 à 200 millions (+66,7 %), alors que la puissance de calcul n’augmente que de 8,3 %, ce qui expliquerait les baisses de qualité et les problèmes de régénération. Le texte évoque une commande de 160 000 Ascend 960DT à Huawei. u/Equivalent-Grass-527 (6 points) souligne que le décalage entre demande et calcul est l’élément le plus important.
- L’appréciation des techniques visant à effacer le rendu « IA » est partagée. Le fil #8 « I stopped prompting for clean shots and my AI video finally stopped looking like AI » (63 points, 56 commentaires, 2026-09-20, https://www.reddit.com/r/aivideos/comments/1wl6op9/ ; Seedance 2.5) partage des techniques de prompting détaillées, mais les commentaires sont sceptiques. u/TCristatus (9 points) juge la vidéo toujours manifestement générée par IA ; u/Biscuits4u2 (6 points) estime qu’il faut des personnes 5 % moins parfaites pour rendre le résultat réaliste.
- Des images IA se retrouvant dans des lieux réels provoquent des controverses. Dans le fil #7 « AI generated image on MSEE wall » (61 points, 13 commentaires, 2026-09-21, r/Purdue, https://www.reddit.com/r/Purdue/comments/1wmq43f/), l’absurdité du layout de circuit imprimé d’une image IA exposée sur le campus est vivement critiquée. u/j909m (11 points) écrit que la personne responsable du layout PCBA de cette puce mérite un F.
- Même dans un subreddit de plus de 1,15 million de membres, les utilisateurs se passionnent pour la détection d’images IA. Le fil #12 « AI generated images on Reddit with thousands of upvotes and comments » (2 109 points, 341 commentaires, 2026-09-18, r/Instagramreality, https://www.reddit.com/r/Instagramreality/comments/1wk0euk/) est de loin celui ayant généré le plus d’engagement dans la collecte. u/Smart-Membership-117 (405 points) relève des incohérences dans les plinthes et la végétation hors de la fenêtre ; u/Negative-Raise-8286 (275 points) se plaint de ne pas avoir pu signaler ces problèmes dans le fil original.
- Plusieurs utilisateurs jugent aussi les crédits gratuits généreux, ce qui nuance le pessimisme. Dans le fil #9 (r/aivideomaking, 3 points, 26 commentaires, 2026-09-15, https://www.reddit.com/r/aivideomaking/comments/1wh80z3/), u/Chance-Business (2 points) apprécie les 50 crédits gratuits quotidiens de Google Flow, chaque vidéo coûtant 6 à 12 crédits. Dans le fil #4 (https://www.reddit.com/r/aivideomaking/comments/1wled0f/), u/MrBoondoggles (1 point) cite aussi les généreux crédits quotidiens de Google Flow pour Nanobanana et Veo.
- La même promotion par code de parrainage apparaît dans plusieurs fils. u/MeatStickMcFapperton publie dans les fils #2 (4 points) et #5 (1 point) des commentaires presque identiques faisant la promotion du code Meta « Muse »
42JB8Ket de « 1 milliard de tokens gratuits ».
Signaux
- Tendance haussière : les références à la génération vidéo locale ou à poids ouverts (Wan, MiniMax H3, FramePack, ComfyUI) surgissent spontanément dans la plupart des fils sur le désir de gratuité. La forte hausse du nombre d’utilisateurs de DeepSeek (+66,7 %) est également un signal clair.
- Scepticisme et rejet : l’idée même de demander gratuitement de la vidéo IA reçoit un accueil hostile. u/activematrix99 (2 points) du fil #4 compare cela au fait d’exiger de manger gratuitement au restaurant. Plusieurs commentaires très appréciés sermonnent les utilisateurs qui veulent une vidéo gratuite, révélant un changement d’ambiance.
- Point inattendu : le même code de parrainage (
42JB8K) et un discours promotionnel très similaire apparaissent à plusieurs reprises dans des fils différents, ce qui suggère que des commentaires publicitaires ou artificiels se mélangent aux discussions organiques. Les chiffres doivent être interprétés avec prudence. - Opposition : les partisans de l’idée que « la vidéo IA gratuite est désormais une illusion » (plusieurs commentaires bien notés dans les fils #2, #9 et #10) s’opposent frontalement à ceux qui jugent généreux les crédits gratuits de Google Flow/Veo/Muse/Nanobanana (fils #4, #5 et #9). Les deux camps s’appuient sur leur expérience, sans qu’une conclusion simple soit possible.
- L’écart ressenti entre closed et open est faible : dans le fil #3, GPT Image 2.5 Flare, modèle closed, et KREA 2, utilisé via des outils open, sont jugés visuellement identiques, ce qui suggère que la différence de qualité est désormais minime du point de vue des utilisateurs.
Limites
- L’outil de collecte n’a utilisé qu’une requête : "Image and Video Generation AI News". Face à l’objectif du brief d’analyser environ 20 posts sur chaque réseau, seuls 12 fils issus de 7 subreddits ont été trouvés. Des recherches supplémentaires sur "Sora", "Veo", "Kling", "Stable Diffusion", "Flux", "open source" / "closed source" auraient probablement fourni davantage de fils pertinents.
- Le fil #9 ne contient pas le texte du post dans les données collectées ; son contenu est donc déduit uniquement des commentaires.
- Conformément aux instructions du playbook de cette étape, Reddit n’a pas été parcouru ni recherché directement ; les vérifications sont limitées au contenu déjà collecté dans
output/reddit.threads.md/.json. Les discussions absentes de ces fichiers, par exemple les fils dédiés à certains modèles, ne font pas partie de ce rapport.
X
X — Actualités de l’IA de génération d’images et de vidéos
Comptes
Les 32 posts de 31 comptes présents dans output/x.posts.md ont été vérifiés, mais aucun compte ne publiait sur l’IA de génération d’images ou de vidéos. Ils se répartissent dans des domaines sans rapport avec le thème :
| Catégorie | Comptes concernés |
|---|---|
| Crypto/actions ($SDOG, $AMD, Bitcoin) | @SDOGWITHSNAP, @DeItaone, @AJM_web, @S500ALERTS, @blackwidowbtc, @0xSweep, @USronaldcarter, @TedPillows |
| Situation Ukraine-Russie | @dystoman, @sentdefender, @Polymarket, @Alex_Oloyede2, @bayraktar_1love, @AlaskanTzar, @SomaliSasuke, @gmanredux, @idkmypronouns, @Katauroraaa, @AbotGrenfield, @jaccocharite |
| Gossip people/politique (lié à Lauren) | @Rach_delauren, @fvslaurs, @LimeriTweets, @karignejauregui |
| Sport/combat (lié à Muhammad) | @CylinderAnalyst, @bullyb170 (2 posts) |
| Religion | @TaymiFawaid |
| Comptes personnels liés à la tendance Zagreb | @slimey34, @AlphaGainer, @enafriedric2372, @Earldormancy |
Certains comptes cumulent l’audience grâce à une publication énorme, comme @AlaskanTzar avec 34 704 likes sur un seul post, d’autres via de petites publications répétées ; dans tous les cas, aucun ne diffusait d’actualité ou d’outils de génération d’images et de vidéos par IA.
Posts
Aucun post de la collecte n’étant pertinent pour le thème, il est impossible de produire les habituelles 5 à 12 observations relatives à l’IA de génération d’images ou de vidéos. À titre indicatif :
- #8 @TedPillows (2 829 likes, 293 reposts, environ 486 000 vues, 2026-09-20, https://x.com/TedPillows/status/2101642897535762562) — analyse du cours du Bitcoin, sans lien avec l’IA.
- #30 @AlaskanTzar (34 704 likes, 1 083 reposts, environ 1 500 000 vues, 2026-09-20, https://x.com/AlaskanTzar/status/2101819330703032636) — mème sur l’Ukraine et la Russie ; plus fort engagement de la collecte, mais sans lien avec l’IA.
- #22 @Katauroraaa (2 840 likes, environ 309 000 vues, 2026-09-20, https://x.com/Katauroraaa/status/2101716186132087180) — plaisanterie sur la Russie et les pays baltes.
Aucun de ces contenus ne mentionne l’IA de génération d’images ou de vidéos, ni dans sa version closed source ni open source.
Signaux
- Le seul signal que permettent d’extraire les données est que les termes de recherche de cette étape n’étaient pas liés au thème. Les tendances Explore de X ont été employées telles quelles, et les résultats se sont concentrés sur la crypto, la géopolitique, les célébrités et le sport.
- Aucun débat concret, positif ou sceptique, sur l’IA de génération d’images ou de vidéos n’a été observé dans ces données.
Limites
-
Les requêtes n’étaient pas liées au thème : comme l’indique le début de
output/x.posts.md, les requêtes réellement utilisées étaient"$SDOG", "Bitcoin", "Zelensky", "Lauren", "Muhammad", "Russians", "Zagreb", "Ukraine", "Weeknd", "USSR". Elles reproduisaient la liste Explore de X ci-dessous, sans inclure « génération d’images IA », « génération vidéo IA », « Sora », « Midjourney » ou « Stable Diffusion ».# Tendance Lieu (tel qu’indiqué par X) 1 $SDOG Tendance en Croatie 2 Bitcoin Économie et finance · Tendance 3 Zelensky Politique · Tendance 4 Lauren Tendance en Croatie 5 Muhammad Politique · Tendance 6 Russians Politique · Tendance 7 Zagreb Tendance en Croatie 8 Ukraine Politique · Tendance 9 Weeknd Tendance en Croatie 10 USSR Tendance en Croatie Cette liste Explore est vraisemblablement liée à la localisation géographique du serveur de la session, autour de la Croatie, et non aux tendances mondiales.
-
Le critère de complétion n’est pas atteint : le brief exigeait l’analyse d’environ 20 posts par réseau. Sur les 32 posts collectés, zéro concernait l’IA de génération d’images ou de vidéos. Ce rapport ne peut donc fournir aucune information substantielle sur ce thème pour X.
-
La session était valide et la collecte a bien été effectuée ; le problème ne vient pas d’une panne de recherche ou de navigation de X, mais du choix des requêtes lors de la collecte.
-
Lors d’une prochaine exécution, il faudra relancer la collecte avec des requêtes pertinentes : "AI image generation", "AI video generation", "Sora 2", "Midjourney", "Stable Diffusion", "Nano Banana", "Veo", etc.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos (closed source/open source)
Chaînes
- Matt Wolfe (@mreflow) — chaîne d’actualités IA de plus de 925 000 abonnés, publiant régulièrement des tests rapides de produits closed source comme Nano Banana Pro et Nano Banana 2. (https://www.youtube.com/@mreflow)
- Theoretically Media — chaîne spécialisée dans les tests et revues d’outils vidéo IA open source, notamment LTX-2 / LTX-2.3 et HunyuanVideo. (https://theoreticallymedia.com/videos/)
- Aitrepreneur — spécialiste des workflows ComfyUI, qui traite de l’installation locale de modèles vidéo open source récents tels que LTX-2.3. (Avec Patreon : https://www.patreon.com/aitrepreneur)
- D’autres chaînes de taille intermédiaire testent Z-Image Turbo, Flux.2 ou HunyuanVideo 1.5 ; leurs noms ne sont visibles que dans les titres des vidéos et leurs nombres d’abonnés n’ont pas été confirmés — voir Limites.
Vidéos
-
Google won image generation (it's not even close) — NANO BANANA PRO BREAKDOWN
date : 2025-11-26 | vues : non confirmées | https://www.youtube.com/watch?v=UV9GqinedQ8
Cette revue closed source affirme que Nano Banana Pro (Gemini 3 Pro Image) de Google DeepMind dépasse largement les générateurs existants, notamment pour le rendu de texte et le photoréalisme. -
Google's Nano Banana Pro is raising concerns over realistic AI image generation
date : fin novembre 2025 | vues : non confirmées | https://www.youtube.com/watch?v=RmmrVCUGYp8
Vidéo d’actualité sur les inquiétudes liées aux deepfakes et à la désinformation causées par un photoréalisme devenu trop convaincant. -
GPT Image 2.5 Is AMAZING: Full Breakdown of OpenAI's New Image Model
date : vers le 2026-09-08 (publication deux semaines auparavant) | vues : non confirmées | https://www.youtube.com/watch?v=DY6TkI8XtkQ
Présentation complète de GPT Image 2.5 d’OpenAI : latence réduite de 50 % et fonction Sketch transformant les dessins à main levée en images IA. -
Sketch with ChatGPT Images 2.5
date : début septembre 2026 | vues : non confirmées | https://www.youtube.com/watch?v=imPtIEAEHSU
Démonstration de la nouvelle fonctionnalité de ChatGPT : saisir « @Sketch » et convertir un dessin directement en image IA. -
State of AI Video in 2026: Sora 2, Veo 3.1, Kling 3.0 & Cinematic Prompting Workflows
date : 2026-03-20 | vues : non confirmées | https://www.youtube.com/watch?v=vtJzDgmWVWc
Bilan comparatif de Sora 2, Veo 3.1 et Kling 3.0, les trois grands modèles vidéo closed source, avec des techniques de prompting cinématographique. -
Seedance 2.5 REVIEW: ByteDance's New AI Video Model Explained
date : 2026-08-01 | vues : non confirmées | https://www.youtube.com/watch?v=LTAOvsH6cjM
Seedance 2.5 de ByteDance propose des plans-séquences de 30 secondes et jusqu’à 50 images de référence, et attire l’attention grâce à une durée supérieure à Sora 2 et Veo 3.1. Closed source. -
Kling 2.6 Pro DESTROYS Competition - Veo 3.1 & Sora 2 Pro
date : 2025-12-19 | vues : non confirmées | https://www.youtube.com/watch?v=-vRsjX9seUU
Comparatif soutenant que Kling 2.6 Pro dépassait déjà Veo 3.1 et Sora 2 Pro avant Kling 3.0. La dynamique se poursuit avec Kling 3.0, publié le 2026-02-05 et premier avec un score ELO de 1 243. -
Z Image Turbo (FREE): This Open-Source AI Changed Image Generation Forever! (Like nano banana pro)
date : 2025-11-27 | vues : non confirmées | https://www.youtube.com/watch?v=sPQQPpQ9X4E
Modèle Apache-2.0 de 6 milliards de paramètres publié par l’équipe Tongyi-MAI d’Alibaba. Il permet une inférence rapide en huit étapes sur GPU grand public de 16 Go et est présenté comme comparable à Nano Banana Pro. -
New Open-Source Model DESTROYS Flux 2 — Z-Image + Promptus Tutorial
date : 2025-12-11 | vues : non confirmées | https://www.youtube.com/watch?v=JF4Q5hXh-_Q
Tutoriel comparatif affirmant que Z-Image dépasse Flux.2. -
FLUX.2 EL MEJOR MODELO OPEN SOURCE, EN LOCAL Y GGUF
date : vers novembre-décembre 2025 | vues : non confirmées | https://www.youtube.com/watch?v=t4eVxZPP0b0
Guide d’exécution locale dans ComfyUI de la série FLUX.2 de Black Forest Labs, qui comprend Pro, Flex, Dev et Klein, sous licence Apache-2.0. Ses atouts sont la sortie jusqu’à 4 MP et la cohérence multi-référence jusqu’à 10 images. -
The "Holy Grail" of Open Source AI Video is Here (LTX-2)
date : début janvier 2026 | vues : non confirmées | https://www.youtube.com/watch?v=27UAb_Tlv4E
LTX-2, lancé par Lightricks le 2026-01-06, est salué comme le premier modèle vidéo open source de qualité production, avec 4K native, synchronisation audio, poids ouverts et code d’entraînement publié. -
Tencent HunyuanVideo 1.5 has been officially open-sourced!
date : première moitié de 2026 | vues : non confirmées | https://www.youtube.com/watch?v=MJShdc8tkkA
Tencent publie HunyuanVideo 1.5, réduit de 13B à 8,3B paramètres sans perte de performances, et apprécié pour son fonctionnement sur GPU grand public. -
Qwen-Image 2.1 | Early Access Showcase
date : vers le 2026-09-20 (publication deux jours auparavant) | vues : non confirmées | https://www.youtube.com/watch?v=tP_gGGJzEqg
Démonstration en accès anticipé de Qwen-Image-2.1 d’Alibaba, sorti le 2026-09-20 : générateur visuel réduit à 7B, génération et édition unifiées, sortie RGBA transparente. Sa licence est toutefois réservée à la recherche non commerciale.
Signaux
- La concurrence closed source sur la vitesse et le photoréalisme s’intensifie : GPT Image 2.5 (2026-09-08, latence réduite de 50 %) et Nano Banana Pro puis Nano Banana 2 (2026, vitesse doublée) montrent OpenAI et Google se répondant par des mises à jour toutes les quelques semaines. En vidéo, les comparaisons Sora 2/Veo 3.1/Kling 3.0 sont devenues un format classique.
- Sora va être arrêté, API comprise : le web et l’application Sora ont déjà fermé le 2026-04-26, et l’API doit totalement disparaître le 2026-09-24, deux jours après la rédaction de ce rapport. Un coût d’exploitation estimé à 1 million de dollars par jour pour environ 2,1 millions de dollars de recettes cumulées est avancé comme explication, illustrant les limites du modèle « winner takes all » de la vidéo closed source.
- L’open source se tourne vers des modèles plus légers et rapides : Z-Image Turbo (6B, Apache-2.0), Qwen-Image-2.1 (générateur réduit à 7B) et HunyuanVideo 1.5 (13B → 8,3B) suivent tous la même direction : réduire les paramètres sans dégrader les performances et tourner sur GPU grand public.
- La frontière entre poids ouverts et licence commerciale fait débat : une partie de Flux.2, Klein, est totalement ouverte sous Apache 2.0, tandis que Qwen-Image-2.1 publie ses poids sous une licence explicitement réservée à la recherche non commerciale. Commentaires et vidéos se demandent donc s’il est légitime de le qualifier d’open source.
- LTX-2 devient un benchmark potentiel de la vidéo open source : l’association de 4K native, synchronisation audio et code d’entraînement publié est inédite, et plusieurs chaînes le comparent localement à Wan 2.2 et HunyuanVideo 1.5.
- ComfyUI est la base commune de fait : Flux.2, Z-Image, LTX-2, Wan et HunyuanVideo bénéficient tous d’un support immédiat dans ComfyUI et de nombreuses vidéos de workflows ; presque toutes les revues open source y effectuent leurs tests pratiques.
Limites
- Les pages de résultats YouTube (
/results?search_query=...) et les pages vidéo (/watch?v=...) sont rendues en JavaScript. WebFetch n’a pu récupérer que les liens de navigation du pied de page ; les vues, noms de chaînes, dates exactes de publication et contenus de sous-titres/commentaires n’ont donc pas pu être obtenus directement. Les dates indiquées sont des estimations déduites de snippets de recherche ou d’articles liés, et les vues restent non confirmées. - Cette limite a empêché d’ouvrir et analyser individuellement environ 20 vidéos selon la procédure idéale du playbook. La collecte a été remplacée par une recherche de titres, indices de chaînes et périodes de publication via WebSearch. Plus de 30 titres ont été trouvés au total ; les 13 ci-dessus sont représentatifs.
- Les vidéos concernant Qwen-Image-2.1 n’avaient que deux jours d’existence ; leur nombre devrait probablement augmenter dans les semaines à venir.
Bluesky
Bluesky — Actualités de l’IA de génération d’images et de vidéos
Comptes
- Ed Zitron (
edzitron.com) — critique de l’industrie tech/IA (Where's Your Ed At) ; a révélé la fermeture de Sora sur Bluesky avec un fort pic d’engagement. - Simon Willison (
simonwillison.net) — chercheur IA indépendant, testant régulièrement les nouveaux modèles, y compris les générateurs d’images, notamment avec ses tests « pelican ». - Adina Yakup (
adinayakup.bsky.social) — défenseuse de l’open source ML chez Hugging Face ; de loin la chroniqueuse la plus active des sorties de modèles image/vidéo à poids ouverts sur Bluesky. - useapi.net (
useapi.bsky.social) — revendeur d’API REST pour la génération IA de vidéos, d’images et de musique (Veo, Kling, Seedance, Runway, MiniMax, etc.) ; publie de fréquentes comparaisons de modèles. - GPT Image Prompt (
gptimageprompt.bsky.social) — compte de partage de prompts centré sur ChatGPT/GPT Image d’OpenAI. - Stable Diffusion online AI (
stablediffusion.bsky.social) — ancien compte communautaire de partage de prompts Stable Diffusion et de défis d’art IA. - Stability AI (officiel) — silencieux sur l’image et la vidéo depuis environ novembre 2025 ; ses posts récents portent presque tous sur Stable Audio et les partenariats avec les labels Warner et Universal.
Posts
-
Ed Zitron — OpenAI arrête Sora (2026-03-24, 👍 3 572 · 🔁 984)
Il annonce que le Wall Street Journal et The Information confirment qu’OpenAI arrête Sora, l’application comme l’accès développeur à son modèle de génération vidéo, et y voit un geste révélateur de difficultés.
https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
(Cela correspond aux informations selon lesquelles l’application Sora a fermé le 26 avril 2026 et l’API doit être retirée le 24 septembre 2026, deux jours après cette collecte.) -
Simon Willison — créer avec ChatGPT Images 2.5 (2026-09-10, 👍 56 · 🔁 5)
Il présente un modèle Blender d’un œuf Fabergé sur le thème de Pluribus, construit par GPT-6 Astra à partir d’une image conceptuelle générée avec ChatGPT Images 2.5.
https://bsky.app/profile/simonwillison.net/post/3mv4su6pfzk24 -
Adina Yakup — HyperFlow (distillation vidéo ouverte) (2026-09-19, 👍 6 · 🔁 1)
HyperFlow est une nouvelle variante MiniMax-H3 de Video Rebirth : LoRA à poids ouverts en huit étapes, trois fois plus rapide grâce à une auto-distillation sans données, tout en préservant la vidéo et l’audio stéréo.
https://bsky.app/profile/adinayakup.bsky.social/post/3mvunely5222b -
Adina Yakup — Lance de ByteDance (2026-05-19, 👍 48 · 🔁 5)
ByteDance publie Lance, un modèle 3B pouvant générer et modifier des images et des vidéos, tout en comprenant images et vidéos.
https://bsky.app/profile/adinayakup.bsky.social/post/3mm6xqsryf22b -
Adina Yakup — ERNIE-Image de Baidu (2026-04-14, 👍 1)
Baidu publie ERNIE-Image sur Hugging Face : DiT 8B, Image/Image Turbo, Apache 2.0.
https://bsky.app/profile/adinayakup.bsky.social/post/3mjhrc3y7u22i -
Adina Yakup — Matrix-Game 3.0 de Skywork (2026-03-27, 👍 13 · 🔁 2)
Matrix-Game 3.0 est un modèle de monde interactif en temps réel de Skywork, proposant du 720p à 40 FPS avec un modèle 5B.
https://bsky.app/profile/adinayakup.bsky.social/post/3mi2efsyp7k2x -
Adina Yakup — LongCat-Video-Avatar 1.5 (2026-05-22, 👍 16 · 🔁 3)
Modèle de génération de vidéos d’avatars pilotées par l’audio.
https://bsky.app/profile/adinayakup.bsky.social/post/3mmglm72zn22i -
Adina Yakup — HiDream-O1-Image (2026-05-19, 👍 10 · 🔁 2)
HiDream-O1-Image attire beaucoup d’attention.
https://bsky.app/profile/adinayakup.bsky.social/post/3mm73u27jek26 -
useapi.net — alternatives API à Sora 2 (2026-09-21, 👍 0)
Comparaison avec code de Seedance 2.5, Omni Flash, MiniMax H3 et Kling v3.
https://bsky.app/profile/useapi.bsky.social/post/3mvyugq6wgz27 -
useapi.net — MiniMax H3 contre Seedance 2.0 (2026-07-31, 👍 0)
Comparaison directe de MiniMax H3 et Seedance 2.0 utilisant les mêmes références omni.
https://bsky.app/profile/useapi.bsky.social/post/3mrw5xyd4zk2x -
GPT Image Prompt — partage de prompt mème (2026-05-07, 👍 0)
Partage de prompt « Text to Meme » avec invitation à consulter gptimageprompt.io.
https://bsky.app/profile/gptimageprompt.bsky.social/post/3mlaa6swzc226
Signaux
- La fermeture de Sora est le récit closed source dont Bluesky parle réellement. Le post d’Ed Zitron est l’élément le plus engagé de toute cette recherche (3,5 k likes), très loin devant les lancements de modèles. Le public IA de Bluesky semble privilégier les récits et critiques sur l’industrie plutôt que le marketing des laboratoires.
- Les nouvelles open source sur Bluesky constituent presque le domaine d’une seule personne. Presque chaque sortie concrète à poids ouverts trouvée — ERNIE-Image de Baidu, Lance de ByteDance, Matrix-Game 3.0 de Skywork, LongCat-Video-Avatar, HyperFlow et HiDream-O1-Image — provient d’Adina Yakup de Hugging Face. Le motif est fortement porté par les laboratoires chinois (Baidu, ByteDance, Alibaba/Qwen, Ant Group, Skywork, Tencent) publiant sous des licences de type Apache-2.0.
- Les grands laboratoires closed source ne maintiennent pas de présence active sur Bluesky pour annoncer leurs lancements image/vidéo. Aucun compte officiel d’OpenAI, Google DeepMind, Adobe ou Midjourney n’a émergé ; la couverture provient plutôt de testeurs indépendants comme Simon Willison ou de revendeurs d’API comme useapi.net.
- Les posts techniques liés à un outil génèrent très peu d’engagement — 0 à 13 likes pour les comparaisons de useapi.net et la plupart des sorties signalées par Adina Yakup — contrairement aux récits sur le destin d’une entreprise, comme l’histoire Sora qui atteint des milliers de likes.
- Plusieurs hubs évidents de l’art IA sont morts ou inactifs sur Bluesky : les comptes officiels et robots de Civitai, le compte ComfyUI et celui de Stability AI, lequel s’est déplacé vers Stable Audio et les labels de musique et ne publie plus sur les modèles d’images Stable Diffusion depuis mi-2025.
Limites
- L’API publique de recherche par mots-clés est bloquée.
app.bsky.feed.searchPostsa renvoyéHTTP 403 Forbiddenà chaque essai, y compris avec des requêtes formulées différemment. L’interfacebsky.app/search, rendue côté client en JavaScript, n’a renvoyé aucun contenu de post. Il n’était donc pas possible d’effectuer une véritable recherche d’actualité ; les résultats proviennent de comptes trouvés par recherche web puis de la lecture de leurs historiquesgetAuthorFeedvia l’API publique AT Protocol. - Plusieurs comptes prometteurs se sont révélés vides ou inactifs :
civitai.bsky.social(feed vide),civitai-bot.bsky.social(dernier post en mai 2024),real-comfyui.bsky.social(feed vide),runwayml.bsky.social(compte personnel sans rapport, un post en 2024),midjourney-api.bsky.social(revendeur non officiel, un post de novembre 2024),qwen1.bsky.social(compte de fan, un post de février 2025). - Qwen-Image-2.1 d’Alibaba, modèle unifié de génération/édition d’images 7B à poids ouverts, apparemment sorti le 2026-09-20, n’est apparu dans aucun post Bluesky trouvé. Il est possible que les comptes suivis ne l’aient pas encore relayé ou qu’il se trouve hors du périmètre accessible sans API de recherche.
- Ethan Mollick (
emollick.bsky.social) et Tanishq Abraham (iscienceluvr.bsky.social) ont été examinés puis écartés : leurs feeds portent respectivement sur les LLM généralistes et les anciens travaux universitaires, pas sur les actualités récentes de génération d’images/vidéos. - Avec la recherche bloquée, l’objectif d’échantillonnage d’environ 20 posts a été atteint de façon agrégée en lisant les historiques complets de plusieurs auteurs — environ 30 posts d’Adina Yakup, 15 de useapi.net, 20 de Stable Diffusion, ainsi que les feeds récents de Simon Willison et Ed Zitron. Il s’agit d’un échantillon ciblé par compte, et non d’un balayage exhaustif par mots-clés.
Lemmy
Lemmy — Tendances récentes de l’IA de génération d’images et de vidéos
Communautés
- !«メールアドレス» (5 713 membres) — principale communauté de discussion technique sur la génération d’images et de vidéos IA open source. Les nouveaux outils GitHub/HuggingFace y sont publiés presque chaque jour.
- !«メールアドレス» (2 361 membres) — espace de partage d’œuvres créées avec Stable Diffusion et d’autres modèles à poids ouverts.
- !«メールアドレス» (1 599 membres) — dédié à l’art IA de style anime, uniquement SFW.
- !«メールアドレス» (52 membres, 157 actifs mensuels) — miroir de fils Reddit sur l’IA. Les actualités closed source concernant Sora ou Midjourney passent souvent par cette communauté.
- !«メールアドレス» (204 membres, avec des posts mêlés depuis l’instance lemmy.bestiver.se) — miroir de Hacker News ; on y retrouve les articles de sortie de modèles, comme Qwen-Image et Nano Banana.
- !«メールアドレス» — communauté satirique et critique sur l’industrie IA. Les nouvelles sur les errements de Midjourney y trouvent leur origine.
- !«メールアドレス» (8 265 membres) — grande communauté critique de l’IA générative. Elle n’est pas une source d’actualité à proprement parler, mais donne une indication de l’ambiance générale sur Lemmy.
- !stable_diffusion_furry / _witches / _mycology / «メールアドレス» — communautés de créations SD très spécialisées. Elles publient régulièrement, mais obtiennent surtout des scores à un chiffre ou négatifs.
Posts
Liés au closed source
- OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !«メールアドレス», 2026-09-20, score 1. Post opposant l’arrêt de l’API Sora à une importante levée de fonds d’un concurrent chinois.
- Midjourney AI pivots to Theranos: Ultrasonic CT — !«メールアドレス», 2026-06-19, score 40. Sujet selon lequel Midjourney se serait brutalement réorienté de la génération d’images vers des appareils médicaux de CT à ultrasons ; le post Midjourney le plus populaire de Lemmy.
- Midjourney Ultrasonic CT Scanner — !hackernews, 2026-06-18, score 2. Miroir HN de la source primaire citée ci-dessus, midjourney.com/medical.
- Midjourney wants Hollywood studios to reveal AI usage details via un post — !«メールアドレス», 2026-07-05, score 73. Présentation d’un article TechCrunch, avec un score relativement élevé dans une communauté technologique.
- Google quietly discontinues its Earth AI feature a day after its rollout after users made no-no images — !ai_reddit, 2026-08-07, score 1.
- Seedream 5.0 Pro is here: an honest comparison and technical breakdown — !ai_reddit, 2026-07-10, score 1. Analyse du modèle d’images closed source Seedream 5.0 Pro de ByteDance.
- Nano Banana 2 Lite — !hackernews, 2026-06-30, score 1. Annonce de la version allégée du modèle d’images de Google DeepMind.
- Microsoft's MAI-Image-2.5 Pulls Even With Google's Nano Banana 2 on Benchmarks — !ai_reddit, 2026-05-28, score 1.
Liés à l’open source
- Qwen-Image-2.1: Compact, efficient, and unified image creation — !hackernews, 2026-09-20, score 1. Dernière version du modèle à poids ouverts de génération d’images d’Alibaba Qwen.
- supElement/ComfyUI_MinimaxH3_AutoContext — !«メールアドレス», 2026-09-16, score 1. Nœud MiniMax H3 pour la génération de vidéos longues au-delà des limites de mémoire.
- Adudeguyman/ComfyUI-Fantastic-MiniMaxH3-PromptBuilder — même communauté, 2026-09-16, score 3. Constructeur de prompts MiniMax H3.
- nazgut/ComfyUI-MiniMaxH3-CLSS — même communauté, 2026-09-01, score 0. Génération de vidéos avec audio de longueur arbitraire sur 16 Go de VRAM.
- filliptm/ComfyUI-FL-MiniMaxH3 — même communauté, 2026-08-30, score 5.
- Luisacaotica/ComfyUI-MiniMaxH3Mod — même communauté, 2026-08-20, score 7. Adaptateur de compression d’images/vidéos de référence ne nécessitant pas d’entraînement.
- I've been testing Wan for AI video generation — !«メールアドレス», 2026-09-10, score -9 (mal reçu / discussion agitée). Test de génération vidéo avec le modèle à poids ouverts Wan.
- Boogu-Image-0.1 — Efficient Image Generation Foundation Model — !«メールアドレス», 2026-06-17, score 5. Nouveau modèle fondation open de génération d’images.
Signaux
- L’écosystème ComfyUI autour de MiniMax H3 grandit continuellement entre août et septembre. Au moins cinq nœuds ou outils associés ont été publiés dans !«メールアドレス» entre le 2026-08-07 et le 2026-09-16, sans interruption de rythme. Dans cette communauté, « MiniMax H3 » est le principal mot-clé de la dynamique de la vidéo open source.
- Les nouvelles closed source suscitent peu de débats natifs sur Lemmy : elles sont presque toutes des reprises via les miroirs Reddit (!ai_reddit) ou Hacker News (!hackernews), et obtiennent généralement des scores de 1 à 3. Les discussions de première main sont pratiquement absentes.
- Le seul sujet closed source qui a vraiment décollé est la réorientation de Midjourney de la génération d’images vers les scanners médicaux CT à ultrasons (!techtakes, score 40), devenue virale dans une communauté au ton satirique et critique.
- Les communautés de partage d’œuvres (stable_diffusion_art, share_anime_art, etc.) publient très fréquemment, souvent plusieurs fois par jour, mais avec des scores généralement limités à un ou une dizaine de points ; elles privilégient le partage de créations plutôt que l’actualité.
- La taille de !«メールアドレス» (8 265 membres) dépasse celle de la communauté favorable à l’IA générative stable_diffusion (5 713 membres), ce qui suggère une forte hostilité structurelle à la génération IA dans l’écosystème Lemmy.
Limites
- L’API de recherche de Lemmy n’offre qu’une recherche plein texte avec un faible classement par pertinence. Des mots tels que « Sora » ou « Veo » ramènent beaucoup de nouvelles politiques sans rapport, par exemple de latam ou pravda_news. Quinze à vingt résultats par mot-clé, soit plus de 100 résultats au total, ont été examinés, mais seuls une douzaine de posts pertinents ont été retenus.
- Lemmy est distribué entre instances et ne permet pas de recherche sur toutes les instances à la fois. L’analyse a privilégié lemmy.world, lemmy.dbzer0.com, lemmy.durstig.online, awful.systems, lemmy.bestiver.se et lemmy.today ; des discussions sur de petites instances fermées peuvent donc manquer.
- Pour Runway, Kling, Ideogram, Recraft, Grok Imagine, Flux.2, HunyuanImage et d’autres modèles majeurs mentionnés ailleurs, aucune publication Lemmy significative n’a été trouvée : soit aucun résultat, soit uniquement des résultats sans rapport.
- Dans l’ensemble, Lemmy est un espace modeste pour l’actualité rapide de génération d’images et de vidéos IA. Il dépend des miroirs Reddit/Hacker News pour les nouvelles, tandis que son contenu propre porte principalement sur le partage d’outils permettant d’exécuter des modèles à poids ouverts dans ComfyUI.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
Thèmes visuels
- Le mot-symbole « AI » néon et les robots/circuits lumineux sont le raccourci visuel Pinterest par défaut pour « IA » : puces brillantes, têtes et mains robotiques holographiques, circuits de particules, utilisés comme couvertures génériques plutôt que pour illustrer un outil ou une actualité précise
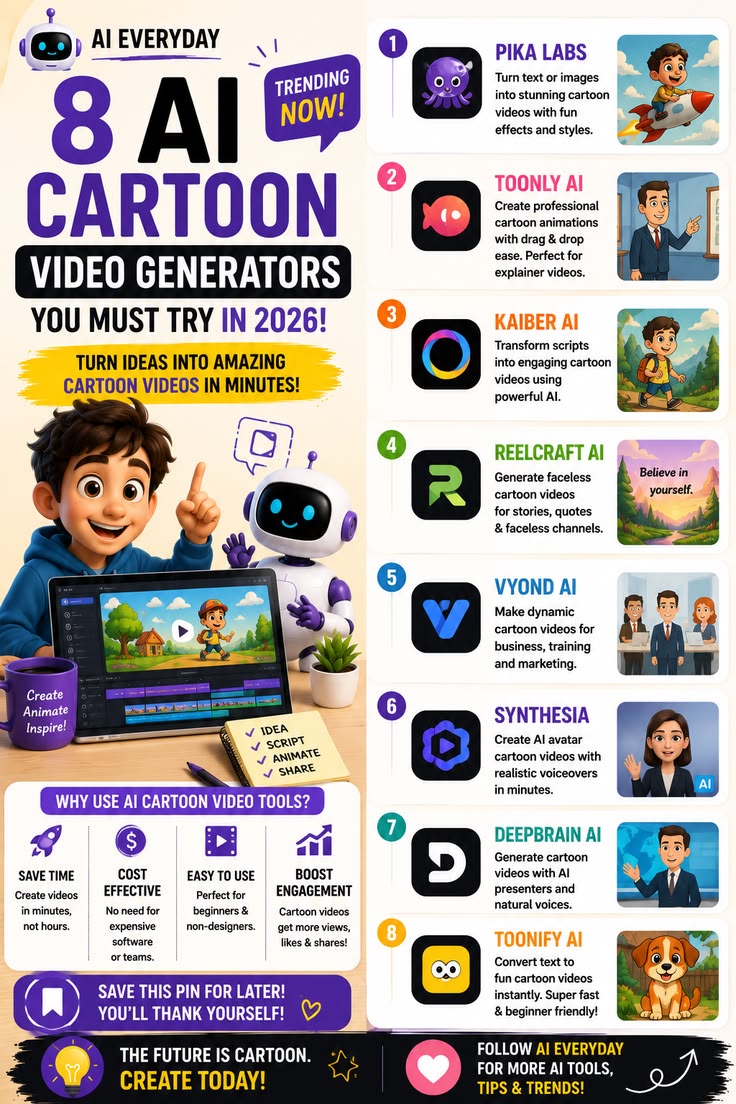
[1, 2, 8, 22, 25, 28, 29, 31, 39, 49]. - Les miniatures de listes numérotées « Best AI Video/Image Generator » — titres massifs et grilles de logos d’applications (Runway, Pika, Kling AI, Luma Dream Machine, Canva, Hailuo AI, Synthesia, HeyGen, D-ID, CapCut, InVideo, Adobe Firefly) — constituent de loin le format le plus fréquent
[7, 13, 20, 30, 32, 33, 41, 43]. - Les miniatures à visage de réaction de YouTuber anonyme — homme barbu surpris, casque, arrière-plan d’explosion flou — accompagnées de logos de grandes entreprises, servent à vendre des vidéos récapitulatives « AI NEWS »
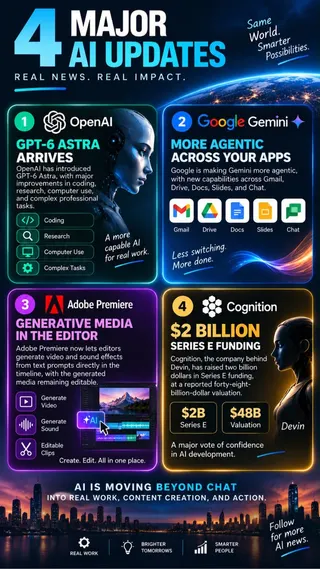
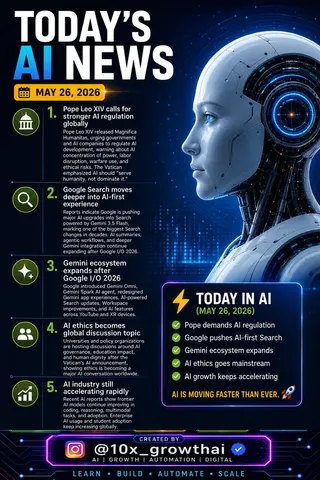
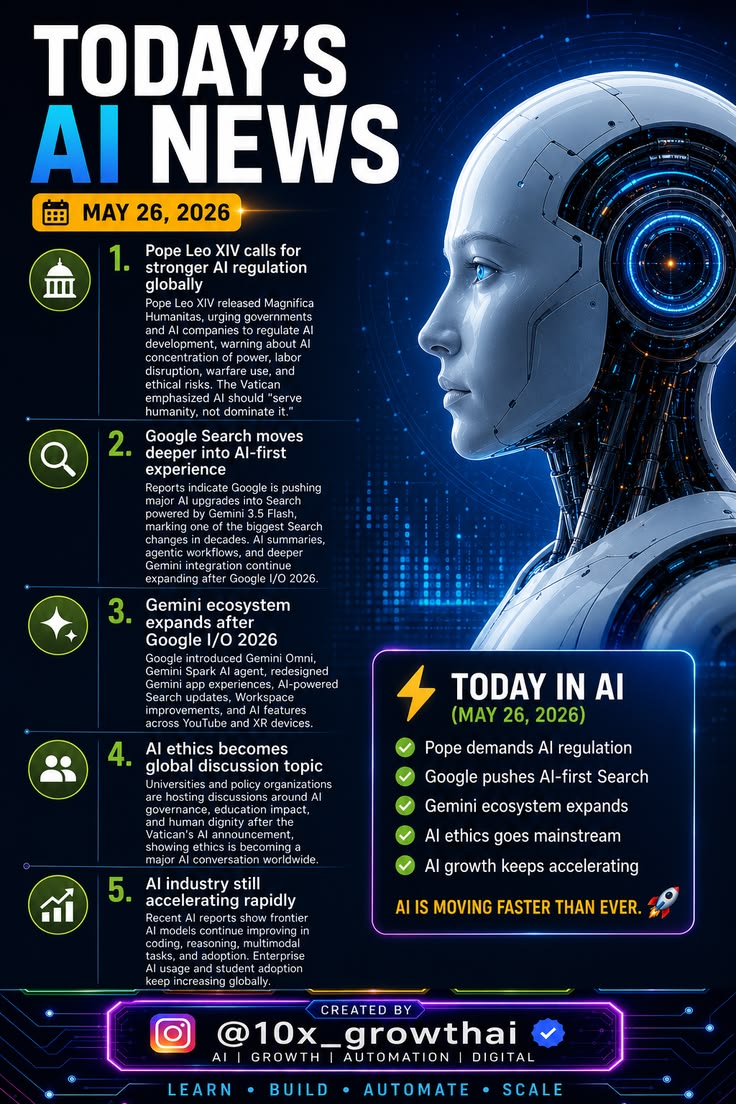
[6, 19, 40]. - Les cartes datées « Actualités IA d’aujourd’hui / de la semaine », conçues comme des mini-unes de journaux ou des carrousels Instagram, résument plusieurs titres réels par carte
[17, 35, 44, 47]. - Les démonstrations « Spot the AI » / de réalisme — joueur de tennis photoréaliste accompagné de la légende « This is AI », photo de chat marquée « FAKE » — vendent le réalisme du média généré plutôt qu’un produit précis
[5, 23]. - Les démonstrations de transfert de style à personnage cohérent — un pin Lumalabs transforme une même vidéo source en quatre styles : blocs de bois, origami, briques jouets et fleurs — reprennent le format viral « transformer ceci en matière X »
[10]. - Les publicités de services freelance / side hustle proposant des « vidéos IA pour votre marque », avec un numéro WhatsApp et une adresse Gmail intégrés au visuel
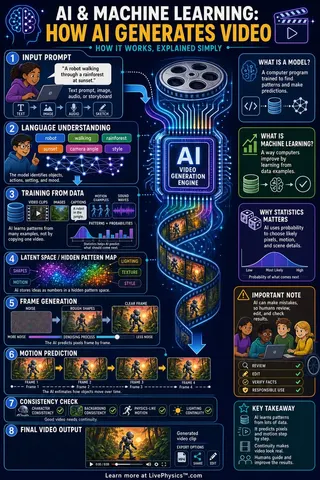
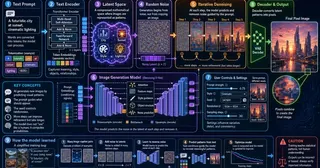
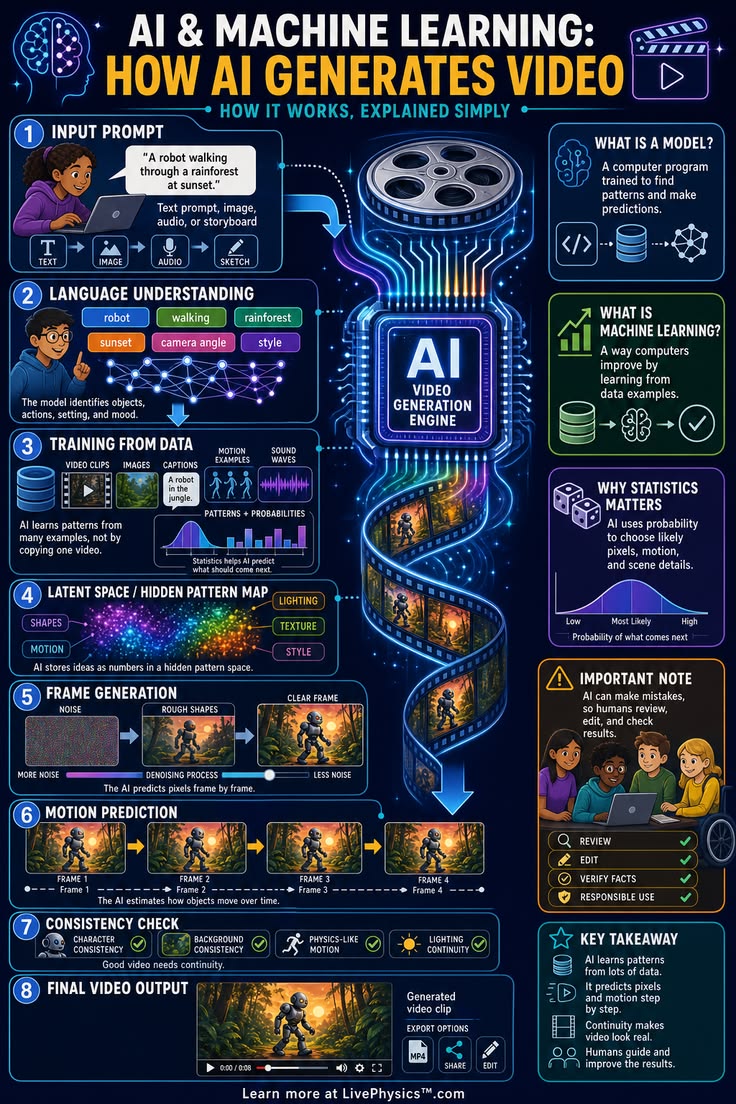
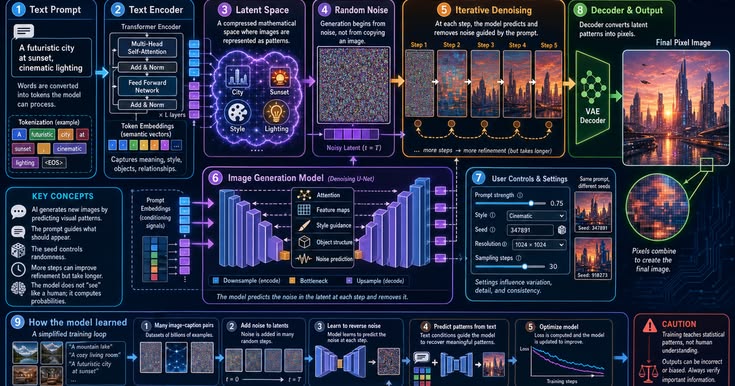
[24]. - Les infographies explicatives pour débutants décrivant le pipeline en étapes — prompt → espace latent → débruitage → images → sortie — pour des publics ne connaissant pas encore le fonctionnement de la génération
[3, 36].
Pins notables
- #9 — Page produit officielle de Veo 2 (« Our state-of-the-art video generation model », appel à inscription à VideoFX). Marketing réel d’un produit closed source, et non liste SEO. https://www.pinterest.com/pin/716705728243313502/
- #10 — Lumalabs : « Made of wooden blocks / origami folded paper art / colorful toy bricks / flowers » ; une vidéo source est restylée de manière cohérente en quatre rendus. https://www.pinterest.com/pin/308144799526598925/
- #17 — « 4 Major AI Updates: Real News. Real Impact. » rassemble GPT-6 Astra d’OpenAI, le renforcement des capacités agentiques de Gemini dans Gmail/Drive/Docs/Slides/Chat, la génération vidéo et sonore intégrée à Adobe Premiere et la série E de 2 milliards de dollars de Cognition, valorisée 48 milliards. https://www.pinterest.com/pin/982558843745608433/
- #20 — Tableau de décision « AI Image Video: Best Quality vs Best Free », la carte la plus claire des outils payants (ChatGPT Plus, Gemini Advanced, Midjourney, Adobe Firefly, Recraft, Runway Gen-3, Luma, Pika Pro, Kaiber, Synthesia) face aux gratuits (Ideogram, Gemini Free, SeaArt, Playground, Krea, Canva, Inkscape, CapCut, Pika Free, Runway Free). https://www.pinterest.com/pin/37295503160959330/
- #26 — Carte d’actualité : « ByteDance and Hollywood reach global deal on AI copyright » ; ByteDance et la Motion Picture Association concluent un accord mondial pour renforcer la protection de la propriété intellectuelle sur les outils de génération image/vidéo de ByteDance. https://www.pinterest.com/pin/1074530792376376121/
- #27 — Infographie d’éthique IA / détecteur vocal signalant un résultat « 97 % probablement généré par IA », à côté de panneaux sur les générateurs vidéo IA et l’éthique/prompt engineering : illustration de l’inquiétude grand public sur la fiabilité des médias générés. https://www.pinterest.com/pin/951104015101996491/
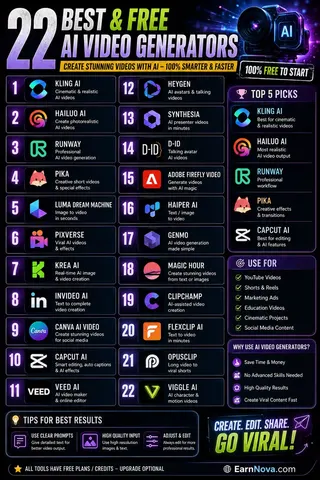
- #32 — « 22 Best & Free AI Video Generators », le plus grand comparatif de l’échantillon ; ses « Top 5 Picks » classent Kling AI et Hailuo AI devant Runway et Pika pour le réalisme. https://www.pinterest.com/pin/128493395623874987/
- #35 — « Today's AI News, May 20 2026 » : récapitulatif de Google I/O 2026, avec Gemini 3.5 Flash, Gemini Omni, l’agent Gemini Spark et les lunettes intelligentes Android XR. https://www.pinterest.com/pin/652670171044638578/
- #44 — Faux journal « This Week in AI News » du 15 août 2026, avec les rubriques « Open Models / Open weights », « Sovereign AI » et « Agent Harness » ; seul pin de l’ensemble mentionnant des modèles à poids ouverts, uniquement comme teaser de titre. https://www.pinterest.com/pin/644577765463965693/
- #48 — « Amuse 3.0 », lancement d’un outil local de création d’art IA soutenu par AMD ; l’un des rares pins à nommer un produit nouvellement lancé au lieu d’une liste générique ou d’une carte d’actualité. https://www.pinterest.com/pin/4601060441986715264/
Signaux
- Kling AI et Hailuo AI ont rejoint le premier rang aux côtés de Runway, Pika et Luma dans presque toutes les listes collectées (
[7, 13, 30, 32, 41, 43]) — un ensemble de recommandations phare plus large que le duopole Runway/Pika d’il y a un an. - L’offensive Veo/Gemini de Google est le récit closed source le plus visible sur cette plateforme, revenant dans des pins d’actualité indépendants — lancement de Veo 2, Gemini 3.5/Omni/Spark et lunettes Android XR à I/O 2026 — plutôt que via un unique post viral.
- OpenAI apparaît surtout comme un assemblage de logos, avec une seule référence précise à Sora-2 (#4, enregistrement d’écran flou d’un outil tiers, « zeely.ai », utilisé en mode « sora-2-video-ad »), une présence faible par rapport aux autres plateformes.
- L’anxiété concernant les deepfakes et l’authenticité constitue un sous-texte récurrent : pin marqué « FAKE », résultat de détection vocale à 97 % et visuel « Human Journalism vs. Machine-Generated Media » apparaissent séparément (
[5, 16, 27]). - Le cadrage monétisation / side hustle est explicite : publicités de services vidéo IA freelance avec coordonnées visibles (#24), argumentaires sur les chaînes sans visage et le content marketing (#23, #25). L’audience Pinterest de la vidéo IA semble orientée vers les créateurs souhaitant vendre ou industrialiser leur contenu, non vers les chercheurs.
- L’open source est pratiquement absent. Parmi les 50 pins, aucun ne mentionne Stable Diffusion, Flux, ComfyUI, Wan, HunyuanVideo, LTX, Mochi, GitHub ou HuggingFace. La seule trace est le titre « Open Models. Open weights. » dans une fausse une d’actualité IA (#44), jamais dans un pin, logo d’outil ou démonstration distincte. Pour ce thème, Pinterest est presque entièrement dominé par le marketing SaaS closed source et les listes SEO « best-of » ; une personne ne consultant que cette plateforme ne découvrirait pas que la génération open source d’images et de vidéos existe comme écosystème.
Limites
- Le tableau
pinterest.pins.mdproduit par le worker ne comportait pas de sections par genre : une liste unique de 50 pins sous un genre implicite. Tous les pins ont donc été analysés ensemble, et non par genre comme le prévoit le playbook pour les exécutions multi-genres. - Plusieurs titres de pins ne correspondaient pas à ce que montraient réellement leurs images. Conformément au playbook, Pinterest n’a pas été parcouru directement pour vérification ; ils sont donc signalés comme non confirmés plutôt que présentés comme résultats : #42 (« Nvidia #NEW AI Tools ») montre seulement une photo générique de Jensen Huang sans texte visible sur un outil ; #45 (« Grok 5: Elon Musk's AI Revolution ») et #50 (« Discover how Grok is revolutionizing video ») ne montrent que des visuels génériques de stock ou de présentateur d’actualités IA ; #40 (« GPT 5.2, realtime video editor... ») est uniquement une miniature de réaction générique « huge AI news ».
- Plusieurs pins sont des graphiques de stock génériques presque dupliqués, sans contenu informatif distinct (
[2, 8, 22, 29, 39, 45, 49]) : ils sont comptés parmi les 50, mais ne sont pas traités comme des signaux séparés. - Aucun contenu open source de génération d’images ou de vidéos n’a été trouvé sur Pinterest pour ce thème. Cette absence constitue la conclusion principale de la plateforme, et non une lacune de la recherche.
Actions recommandées
- Suivre la destination du trafic API Sora après le 2026-09-24 : Seedance 2.5, MiniMax H3 ou Kling v3.
- Surveiller tout changement de la licence de recherche non commerciale de Qwen-Image-2.1, compte tenu du débat actif sur son caractère open source.
- Utiliser la fréquence des publications de nœuds ComfyUI pour MiniMax H3 sur Lemmy comme indicateur avancé de l’adoption de la vidéo à poids ouverts.
- Refaire l’étape de collecte X avec des termes propres au thème au lieu des tendances régionales.
- Refaire la collecte Reddit avec des recherches par modèle afin d’atteindre l’objectif d’environ 20 posts.
- Vérifier la réorientation de Midjourney vers le CT médical à ultrasons auprès de sa source primaire avant de la considérer comme confirmée.
Images collectées

























Note sur la qualité des données
X a produit zéro post pertinent sur les 32 collectés à cause d’une inadéquation des termes de recherche, et Reddit n’a collecté que 12 des quelque 20 fils ciblés avec une seule requête ; l’API de recherche de Bluesky était bloquée (403) et a dû être contournée par un échantillonnage de feeds de comptes ; les nombres de vues YouTube et les dates exactes n’ont pas pu être confirmés à cause des pages rendues en JavaScript.