Actualités de l’IA de génération d’images et de vidéos — 2026-09-18
Les modèles propriétaires sont dominés par la génération d’images Nano Banana de Google, désormais ancrée dans les usages personnels, tandis que Sora 2 décline avec la fin de son API le 24/09. Côté open source, MiniMax-H3 et Qwen-Image règnent sur la sphère ComfyUI.
Récapitulatif des actualités de l’IA de génération d’images et de vidéos — 2026-09-18
Eh bien, cette édition était incroyablement dense 🔥 En bref, côté modèles propriétaires, la famille Nano Banana de Google (génération d’images Gemini) est clairement devenue la vedette, tandis que Sora 2, avec l’arrêt de son application et de son API (24/09), commence très symboliquement à donner l’impression d’appartenir au passé 🤖📉. Côté open source, c’est un duel entre MiniMax-H3 (génération vidéo) et Qwen-Image (génération d’images) ; la communauté ComfyUI était en particulier saturée de discussions autour de MiniMax-H3 😳. Autre constat très net : les sujets éthiques et juridiques, tels que la légalisation des générations sans consentement ou le procès Disney contre Midjourney, suscitent davantage de buzz que les comparatifs de performances entre outils ⚖️🔥. X (anciennement Twitter) a complètement raté son coup cette fois, donc je l’indiquerai honnêtement comme « aucune donnée » 🙏
Sur l’ensemble des plateformes
Voici uniquement les informations recoupées sur plusieurs plateformes 📝✨
- 🍌 Nano Banana (génération d’images Gemini) est devenu un outil du quotidien pour les créateurs individuels. Sur Bluesky, des utilisateurs comme dfl ou triflingtree publient chaque jour des créations Nano Banana 2 (https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i), tandis que YouTube regorge de vues pour des contenus tels que « Ultimate Nano Banana Pro Guide 2026 » sur des chaînes comptant 327K abonnés (chaînes autour de https://www.youtube.com/watch?v=Q7SiipUCjro). Nano Banana figurait aussi parmi les intégrations évoquées dans un fil Riverside sur Reddit (https://www.reddit.com/r/RiversideFM/comments/1wiweik/).
- 🌊 Sora 2 est de plus en plus un sujet de rétrospective, plutôt qu’un produit tourné vers l’avenir. Sur Bluesky, un post conseille de passer à Runway/Kling/Veo en raison de la fin de l’application autonome (https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l), et sur YouTube, Sora 2 sert désormais davantage de référence dans des vidéos comparatives de type « State of AI Video » que dans des présentations de nouveautés. La fin de l’API est prévue pour le 2026-09-24. C’est précisément le moment où la tendance bascule 😮
- 🧩 Les modèles propriétaires privilégient désormais une stratégie de « plateforme intégrée ». Reddit (Adobe Firefly Boards et Riverside, qui agrègent plusieurs modèles) et Pinterest (nombreuses infographies comparant Runway, Pika, Kling, Luma, Veo, Hailuo et CapCut) confirment la même tendance. Il ne s’agit plus de promouvoir un seul modèle, mais de laisser les utilisateurs choisir 🛠️
- 🐉 Les figures de proue de l’open source sont MiniMax-H3 et Qwen-Image. Au début et au milieu de septembre, la communauté ComfyUI de Lemmy était presque entièrement remplie de publications sur les outils autour de MiniMax-H3 (par exemple : https://github.com/filliptm/ComfyUI-FL-MiniMaxH3, score 5). Selon des retours d’utilisateurs, il peut aussi fonctionner localement sur un PC équipé d’une RTX 3090 (score 12 commentaires). Qwen-Image a été mentionné à la fois sur YouTube (notamment des vidéos de benchmark sur 700 générations) et Bluesky (aperçu de Qwen3.8-Flash : https://bsky.app/profile/primereports.bsky.social/post/3mub3pkd2rf2s).
- ⚖️ Les questions éthiques et juridiques font davantage parler que la technologie elle-même. Reddit (fil sur la légalisation de la génération sans consentement, près de 900 commentaires au total : https://www.reddit.com/r/CriticalState/comments/1wisk2n/), Bluesky (suite du procès Disney contre Midjourney : https://bsky.app/profile/ai.bots.law/post/3mvqwgixvkm2n), Lemmy (Midjourney qui pivote de la génération d’images vers des dispositifs médicaux et se fait traiter de « Theranos » : https://awful.systems/post/8731127), et Pinterest (épingles sur l’accord de droits d’auteur entre ByteDance et Hollywood) : sur quatre plateformes, les sujets juridiques et éthiques étaient les plus animés.
- 😤 Le rejet de l’« AI slop » reste systématiquement fort. Reddit (r/aitubers, où les vidéos sans visage entièrement automatisées à partir d’un script ont été vivement critiquées) et Lemmy (une publication de r/fuck_ai affirmant que « les entreprises rendent l’IA pire », score 63) affichent le même état d’esprit. Nulle part on ne trouve un enthousiasme sans réserve.
Plateforme par plateforme
Reddit — Comme un seul terme de recherche a été utilisé, des subreddits spécialisés dans la génération d’images comme r/StableDiffusion n’ont pas été trouvés. À la place, des fils liés à l’éthique et à la culture (utilisation abusive d’images IA par le DHS, débat sur la légalisation des générations sans consentement) ont concentré l’engagement. Les opinions sur les outils individuels (Google Flow, Wan, Minimax) étaient partagées, sans consensus simple sur « le meilleur outil » 😐
X — Désolé, ici c’est un échec total 🙅♂️. Les 40 publications collectées portaient toutes sur la politique, les paris sportifs ou les cryptomonnaies : pas une seule ne concernait l’IA de génération d’images ou de vidéos. Les termes de recherche semblent avoir récupéré les tendances X (Africa, Serbia, Zcash, etc.) plutôt que des thèmes liés à l’IA. Comme c’est une des six plateformes demandées dans le brief qui n’a tout simplement pas fonctionné, il faut le signaler comme une lacune réelle.
YouTube — Côté modèles propriétaires, de nouvelles informations apparaissent presque chaque semaine. ChatGPT Images 2.5 d’OpenAI (sorti le 08/09) ainsi que Nano Banana Pro/2 de Google ont immédiatement reçu des critiques et généré du buzz sur des chaînes moyennes comptant 30 000 à 330 000 abonnés. Côté open source, la couverture est dominée par des chaînes techniques comme SECourses et des vidéos explicatives japonaises sur Qwen-Image, avec des audiences environ dix fois inférieures à celles des modèles propriétaires. Fait étonnant : Seedance 2.0/2.5 de ByteDance est le modèle de génération vidéo le plus couvert cette année 📹
Bluesky — Les créations Nano Banana 2 de créateurs individuels défilent chaque jour, tandis que les bots d’actualité ont également permis de repérer LTX-2.5 (Lightricks), des LoRA FLUX et la publication de modèles entièrement ouverts à Abou Dabi. Toutefois, les recherches de phrases comme « Stable Diffusion », « Wan 2.5 » et « Qwen Image » ont été plusieurs fois bloquées par des erreurs 403 de l’API, ce qui a limité l’accès aux retours directs sur la génération vidéo open source 😑
Lemmy — La plateforme la plus riche cette fois 🎯. !«メールアドレス» était rempli de publications concernant des extensions ComfyUI pour MiniMax-H3, ce qui en faisait l’endroit le plus révélateur de l’état actuel de la génération vidéo open source. À l’inverse, les modèles propriétaires ont surtout été associés à des « nouvelles de dérive », comme le pivot de Midjourney vers des dispositifs médicaux. Le ton général de Lemmy est très sceptique.
Pinterest — Une étude basée sur des images précollectées par un worker a révélé une prolifération d’infographies SEO/affiliation comparant Runway, Pika, Kling, Luma, Veo, Hailuo et CapCut 🖼️. Les contenus d’éducation aux médias du type « distinguez le vrai de l’IA » constituent aussi une catégorie à part entière. L’open source est très peu présent : Stable Video Diffusion apparaît tout au plus comme logo dans des listes d’outils.
À surveiller
- 🔥 L’expansion de l’écosystème ComfyUI pour MiniMax-H3 — Lemmy, https://github.com/filliptm/ComfyUI-FL-MiniMaxH3
- 📉 La fin de l’API de Sora 2 (prévue le 2026-09-24) et les destinations de migration des utilisateurs — Bluesky, https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l
- 🍌 L’adoption durable de Nano Banana Pro/de la génération d’images Gemini chez les créateurs individuels — Bluesky, https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i
- 🎬 La présence de ByteDance Seedance 2.0/2.5 dans la génération vidéo et son accord de droits d’auteur avec Hollywood — YouTube (tutoriel de Dan Kieft) et épingle Pinterest ByteDance-MPA
- ⚖️ L’évolution du débat sur la légalisation des générations IA sans consentement — Reddit, https://www.reddit.com/r/CriticalState/comments/1wisk2n/
- 🐦⬛ La montée en importance de Qwen-Image parmi les modèles à poids ouverts — YouTube (vidéos de benchmark sur 700 générations) et publication Bluesky sur Qwen3.8-Flash
Recommandations
- Lors de la prochaine collecte, relancer les recherches sur X avec des mots-clés directement liés à l’IA, tels que Sora, Nano Banana, Kling, Qwen, Flux et ComfyUI (cette fois, les tendances sans rapport ont été récupérées).
- Continuer de suivre MiniMax-H3 et Qwen-Image comme les deux principaux indicateurs de l’open source.
- Suivre les mouvements des utilisateurs vers Runway/Kling/Veo autour de la fin de l’API de Sora 2 (24/09).
- Accorder une priorité plus élevée au suivi des sujets juridiques et éthiques, tels que le procès Disney contre Midjourney et le débat sur la légalisation des générations sans consentement, qu’aux seuls comparatifs de performances.
- Ajouter dans la collecte Reddit des requêtes ciblant des subreddits spécialisés en génération d’images, tels que r/StableDiffusion et r/aiArt.
- Pinterest repose uniquement sur des inférences visuelles : la prochaine fois, ouvrir réellement les articles liés afin de les vérifier.
Qualité des données
X (anciennement Twitter) ne contient aucune donnée exploitable : les 40 publications collectées sont toutes sans rapport avec le thème de l’IA. Reddit a manqué les communautés spécialisées dans la génération d’images à cause d’un terme de recherche unique, et 5 des 12 fils collectés ont un score de 0 point, signe d’un faible engagement. Sur YouTube, des erreurs 401/CAPTCHA ont empêché de vérifier environ deux tiers des informations ; les chiffres de visionnage de nombreuses vidéos open source restent non confirmés. Sur Bluesky, l’API publique a bloqué à répétition les recherches de phrases par des erreurs 403, empêchant de recueillir des données directes sur « Stable Diffusion », « Wan 2.5 », etc. Lemmy ne couvre que les publications indexées sur lemmy.world, les autres instances (comme lemmy.ml) n’ayant pas été étudiées. Pinterest repose uniquement sur des images précollectées par un worker, sans aucune vérification en direct.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
12 fils ont été collectés dans 11 subreddits à l’aide du terme de recherche « Image and Video Generation AI News ».
| Subreddit | Nombre de membres | Nombre de fils collectés |
|---|---|---|
| r/generativeAI | 154,407 | 1 |
| r/CriticalState | 35,134 | 2 |
| r/aifilmmaking | 8,038 | 1 |
| r/aitubers | 28,687 | 1 |
| r/agi | 123,187 | 1 |
| r/AIToolTalks | 6,513 | 1 |
| r/ContentCreators | 88,168 | 1 |
| r/AIContentAutomators | 9,387 | 1 |
| r/AIDangers | 53,842 | 1 |
| r/popculturechat | 6,680,224 | 1 |
| r/RiversideFM | 728 | 1 |
Les grands subreddits spécialisés dans la génération d’images, tels que r/StableDiffusion et r/aiArt, n’apparaissent pas dans les résultats. Avec ce terme de recherche, l’échantillon est donc biaisé vers les subreddits liés aux outils IA, à la culture et aux controverses éthiques.
Ce que disent les utilisateurs
- Fil 1 (r/generativeAI · 13 pt · 41 commentaires · 2026-09-16) https://www.reddit.com/r/generativeAI/comments/1whtesl/ — À la question « Quels outils gratuits de génération vidéo IA peut-on utiliser ? », u/RioMetal répond : « Si vous pouvez l’exécuter localement, il existe une tonne de Wan et de Minimax », tandis que u/juzellicious indique : « Wan donne 3 secondes gratuites par jour, Google Veo 3 en donnait encore plus ». La réduction des quotas gratuits dans le cloud et le retour vers les modèles locaux/open source sont au cœur de la discussion.
- Fil 3 (r/aifilmmaking · 7 pt · 7 commentaires · 2026-09-14) https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — Une publication affirme que les crédits gratuits de Google Flow sont « très généreux en ce moment ». u/MechanicForward2274 estime que « 50 crédits par jour permettent d’essayer pas mal de choses si on ne les gaspille pas ». En revanche, u/Sea-Temporary-6995 juge le modèle faible sur les lois physiques et la logique, et estime que Minimax est bien meilleur ; les avis sont partagés.
- Fil 8 (r/ContentCreators · 0 pt · 6 commentaires · 2026-09-17) https://www.reddit.com/r/ContentCreators/comments/1wj380j/ — Retour d’expérience sur la création d’une publicité beauté pour un produit technique avec Adobe Firefly Boards. L’auteur dit explicitement avoir choisi Firefly Video plutôt que Veo ou Kling pour la sécurité commerciale. u/avatar0027 note que les gros plans sont beaux, mais que la continuité entre les plans donne une impression d’IA.
- Fil 12 (r/RiversideFM · 0 pt · 1 commentaire · 2026-09-17) https://www.reddit.com/r/RiversideFM/comments/1wiweik/ — Riverside, outil de production de podcasts, a lancé des fonctions de génération d’images et de vidéos intégrant plusieurs modèles, dont Seedance 2.5, Veo 3.1 et Nano Banana. Tous les forfaits payants reçoivent 2 000 crédits.
- Fil 4 (r/aitubers · 0 pt · 40 commentaires · 2026-09-14) https://www.reddit.com/r/aitubers/comments/1wg3duk/ — Une demande visant à « créer automatiquement des vidéos YouTube sans visage à partir d’un script » a suscité une forte opposition. u/RobJames007 écrit : « YouTube essaie de réduire l’AI slop, et vous cherchez un outil pour en produire davantage », et u/-NearlyThere- annonce : « Si j’en trouve, je les signale et je leur mets un vote négatif ».
- Fil 9 (r/AIContentAutomators · 0 pt · 11 commentaires · 2026-09-11) https://www.reddit.com/r/AIContentAutomators/comments/1wdm1n4/ — Affirmation selon laquelle 300 $ de crédits cloud gratuits offerts aux nouveaux comptes Google auraient permis de réduire les coûts de vidéos IA et de gagner 5 000 $ par mois. Le commentaire le plus soutenu, de u/Truegentlehat, met la crédibilité de l’auteur en doute : « Il y a une heure, il écrivait dans un autre post qu’il commençait à peine à gagner de l’argent avec 120 € par mois. C’est faux, non ? »
- Fils 2 et 5 (r/CriticalState · 0 pt/1 pt · 421/475 commentaires · 2026-09-17) https://www.reddit.com/r/CriticalState/comments/1wisk2n/ , https://www.reddit.com/r/CriticalState/comments/1wiwhm4/ — Deux fils de vote demandent s’il faut légaliser ou interdire la génération d’images IA sans consentement. Dans les deux cas, les commentaires les mieux notés soutiennent l’interdiction. u/AwarenessOk7862 déclare que cela « falsifie la réalité et rend encore plus difficile la distinction entre vérité et fiction ».
- Fil 11 (r/popculturechat · 448 pt · 22 commentaires · 2026-09-11) https://www.reddit.com/r/popculturechat/comments/1wd49kb/ — Le Département américain de la sécurité intérieure (DHS) a utilisé une image d’Optimus Prime générée par IA pour promouvoir une campagne d’expulsions, mettant Hasbro dans une situation délicate. u/Jerkrollatex commente : « Optimus est aussi un personnage réfugié de guerre ; ceux qui ont fait ça viennent-ils d’arriver sur Terre ? »
- Fil 7 (r/AIToolTalks · 12 pt · 35 commentaires · 2026-09-13) https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — Publication exprimant des inquiétudes générales vis-à-vis de l’IA, notamment sur la consommation d’eau et les pertes d’emplois, dans un contexte qui inclut l’IA de génération d’images et de vidéos. u/EstablishmentRare276 réplique : « Les centres de données existent depuis les années 1950 ; une vidéo YouTube de deux heures équivaut à 50 requêtes IA lourdes ».
- Fil 10 (r/AIDangers · 28 pt · 31 commentaires · 2026-09-14) https://www.reddit.com/r/AIDangers/comments/1wg5y17/ — Publication affirmant que « l’IA n’est pas un outil indispensable » et que de nombreuses entreprises constatent une baisse, plutôt qu’une amélioration, de leurs performances. u/LopsidedSolution souligne l’ancienneté de l’étude : « Est-ce une étude utilisant les modèles de 2024, comme GPT-4o ? J’aimerais qu’elle soit réévaluée avec Astra ou Fable ».
Signaux
- Tendance à la hausse : intérêt pour les modèles locaux/open source de génération vidéo (Wan, Minimax). La réduction des quotas gratuits dans le cloud (fil 1) pousse les utilisateurs à exécuter leurs propres modèles afin de réduire les coûts.
- Tendance à la hausse : outils de workflow intégrant plusieurs modèles. Adobe Firefly Boards (fil 8) et Riverside (fil 12) proposent de choisir parmi des modèles propriétaires partenaires tels que Veo, Kling, Seedance et Nano Banana depuis une même plateforme.
- Fort rejet : l’automatisation de vidéos sans visage, du type « fournissez simplement un script et tout est généré », est constamment moquée comme de l’« AI slop » et perçue comme à signaler dans r/aitubers et r/ContentCreators. Même les récits de gains financiers (fil 9) sont soupçonnés d’être publicitaires ou exagérés.
- Point de fracture : les évaluations pratiques de Google Flow et de l’IA en général sont divisées (dans le fil 3, Minimax est présenté comme supérieur ; dans le fil 10, l’effet même de l’IA sur les performances des entreprises est contesté). Les commentaires de praticiens ne relèvent ni d’un enthousiasme ni d’un rejet simpliste.
- Point surprenant : les fils portant sur la légalisation des générations sans consentement (fils 2 et 5, près de 900 commentaires cumulés) ou sur l’usage abusif d’images générées par IA par le DHS (fil 11, 448 pt) génèrent un engagement d’un tout autre ordre de grandeur que les débats sur les performances techniques. Les fils de comparaison d’outils restent presque tous à des scores faibles (0 à 13 pt).
Limites
- La recherche Reddit a été entièrement menée avec le seul terme « Image and Video Generation AI News ». Aucune requête séparant « open source » et « propriétaire », ni aucune recherche par modèle comme Stable Diffusion, ComfyUI ou Flux, n’a été effectuée. Les principaux subreddits spécialisés dans la génération d’images (r/StableDiffusion, r/aiArt, etc.) sont donc absents des résultats.
- Parmi les 12 fils collectés, 5 ont un score de 0 pt, ce qui signifie qu’un certain nombre de fils ont suscité peu de réactions. Les voix provenant de petites communautés (r/RiversideFM : 728 membres, r/AIToolTalks : 6 513 membres, etc.) ne constituent qu’un échantillon limité.
- En raison des contraintes du playbook, cet agent n’a pas navigué lui-même sur Reddit et s’est limité aux 12 fils précollectés par le worker. Les informations hors de cet échantillon, par exemple les nouvelles publications des dernières heures ou les fils associés non inclus dans le terme de recherche, ne sont pas reflétées.
- La période de collecte couvre environ une semaine, du 2026-09-11 au 2026-09-17 ; l’évolution des discussions antérieures n’a pas été observée.
X
X — Actualités de l’IA de génération d’images et de vidéos
Comptes
Les 40 publications collectées proviennent de 39 comptes distincts (output/x.posts.md), dont aucun n’est associé à l’IA de génération d’images ou de vidéos (aucun compte Midjourney, OpenAI/Sora, Runway, Stability AI, Black Forest Labs, ByteDance/Kling, Pika, Luma ou similaire n’apparaît dans l’ensemble). Les comptes présents mêlent commentaires politiques (@GunterFehlinger, @AntiTrumpCanada, @Rusia_HD), pronostiqueurs de paris sportifs (@BDreamz37398, @thekasik, @TheRealCEOAmber), comptes de promotion crypto/NFT (@Hasan_NFTOX, @0xHeatt, @jubjubcommunity, @patlandcrypto, @AltcoinSherpa) et comptes de commentaires généraux ou de mèmes (@Keegan59992745, @LeeLovesBey, @Captian_Loden_4). Aucun ne publie sur la génération d’images ou de vidéos par IA, et aucun compte majeur n’entraîne de dynamique sur ce thème, puisqu’il n’y a aucune activité pertinente dans l’échantillon.
Publications
Aucun résultat : aucune des 40 publications collectées ne concerne l’IA de génération d’images ou de vidéos, propriétaire ou open source. La lecture de chaque publication et de son texte complet au regard du brief a révélé zéro élément pertinent. Exemples représentatifs hors sujet : n° 1 (https://x.com/TicTocTick/status/2100319322682134729, 16,936 likes, « Xi of China and Ramaphosa of Africa suffered from ischemic stroke... »), n° 35 (https://x.com/GunterFehlinger/status/2100099276672040971, 13,824 likes, « Russia is collapsing in Donbas »), n° 38 (https://x.com/Keegan59992745/status/2100583905204326909, 159,030 likes, une blague sur un burrito et Israël) : les trois publications les plus engagées de l’ensemble, toutes sans rapport avec l’IA.
Signaux
Rien à signaler sur les tendances de l’IA de génération d’images ou de vidéos, propriétaire ou open source, sur X lors de cette collecte. Le seul motif observable concerne les termes de recherche eux-mêmes : « Africa », « Serbia », « Zcash », « Germany », « $JubJub », « Canada », « Zagreb », « #CyberSecurity », « Russia », « Israel ». Ils correspondent à des thèmes tendance d’Explore pour la session et sa géolocalisation (Croatie) dans output/x.posts.md, et non à des mots-clés du brief. L’étape de collecte a donc recherché les tendances de X plutôt que le thème de l’IA de génération d’images et de vidéos.
Limites
- Les données collectées ne répondent pas au brief.
output/x.posts.mdetoutput/x.posts.jsoncontiennent 40 publications trouvées en recherchant « Africa », « Serbia », « Zcash », « Germany », « $JubJub », « Canada », « Zagreb », « #CyberSecurity », « Russia », « Israel » : du contenu politique, de paris sportifs et de cryptomonnaies correspondant aux tendances Explore géolocalisées en Croatie, et non au thème « Image and Video Generation AI News ». - Selon le playbook, cette étape ne navigue pas directement sur X, les lectures anonymes ne renvoyant rien, et s’appuie uniquement sur la collecte préalable du worker. Comme aucun des termes n’est lié au brief (Sora, Veo, Midjourney, Runway, Kling, Stable Diffusion, Flux, ComfyUI, LoRA, Nano Banana, etc.), il est impossible de répondre au brief à partir de ce fichier. Une nouvelle collecte avec des termes adaptés est nécessaire.
- Aucun terme pertinent pour le brief n’ayant été utilisé, il est impossible de dire ce que X dit ou ne dit pas sur l’IA de génération d’images et de vidéos cette fois-ci.
YouTube
YouTube — Actualités de l’IA de génération d’images et de vidéos
Chaînes
- Paul J Lipsky — testeur généraliste d’outils IA ; sa vidéo « ChatGPT Images 2.5 Is Here (And It's A LOT Of Fun) » a atteint 277K vues en 9 jours (watch).
- Kevin Stratvert — grande chaîne de tutoriels technologiques grand public ; « ChatGPT Images 2.5 Tutorial for Beginners » a obtenu 58K vues en une journée.
- AI Master — 327K abonnés ; « Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI », 76,658 vues depuis le 17 janvier 2026.
- JohnnyTube — 30.6K abonnés ; « Nano Banana 2 Is INSANE! Everything You Need To Know (Full Course) », 26,162 vues depuis le 6 mars 2026.
- AffContent — 262K abonnés ; contenu de comparaison/affiliation, tel que « BEST AI Image Generator in 2026 (Don't Choose Wrong!) », 14,694 vues depuis le 9 avril 2026.
- Dan Kieft — 295K abonnés, spécialisé dans la réalisation avec IA ; « Seedance 2.0 is CRAZY for AI Filmmaking - Full Course », 179,589 vues depuis le 24 avril 2026, sa vidéo récente la plus performante au regard de sa base d’abonnés.
- SECourses — 53.7K abonnés, tutoriels denses sur ComfyUI local/open source ; « Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models », 6,649 vues (publiée le 18 août 2025, hors de la fenêtre de 60 jours, conservée ici seulement comme contexte concernant une chaîne open source active).
- Des chaînes plus petites et de longue traîne ressortent régulièrement dans les recherches sur Qwen-Image et Wan (titres uniquement, métriques non confirmées) : chaînes japonaises consacrées aux outils IA avec « Qwen-Image完全ガイド » et des tutoriels « Qwen-Image-2512 », ainsi que des chaînes anglophones publiant « ComfyUI Text-to-Image Models Compared (Local): Qwen 2512, Z-Image, FLUX.2 klein, Ovis, LongCat ».
Vidéos
- « ChatGPT Images 2.5 Is Here (And It's A LOT Of Fun) » — Paul J Lipsky, environ 9 jours, 277K vues. https://www.youtube.com/watch?v=Q7SiipUCjro — Réagit au lancement par OpenAI de ChatGPT Images 2.5 le 8 septembre 2026 (croquis vers image, latence réduite d’environ 50 %, modèles API Flare/Sunburst) et présente la cohérence d’identité comme l’amélioration majeure.
- « ChatGPT Images 2.5 Tutorial for Beginners » — Kevin Stratvert, environ 1 jour, 58K vues. Guide un public grand public à travers la fonction de croquis et l’édition en plusieurs étapes qui conserve enfin le contexte entre les modifications.
- « Everyone's Lying to You About GPT Image 2.5 » — Joseph Martin, environ 2 jours, 10K vues. Point de vue contraire : le « bond en avant » concerne principalement la vitesse et la latence, plutôt que la qualité brute de l’image, par rapport à GPT-Image-1.
- « Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI » — AI Master, depuis le 17 janvier 2026, 76,658 vues. Guide en six étapes de structure de prompt (Sujet+Action+Environnement+Style artistique+Éclairage+Détails) pour le modèle Gemini 3 Pro Image de Google, destiné aux usages de marque et de photographie produit.
- « Nano Banana 2 Is INSANE! Everything You Need To Know (Full Course) » — JohnnyTube, depuis le 6 mars 2026, 26,162 vues. Présente Nano Banana Pro 2 comme un outil unique de génération d’images et de vidéos, comparé de manière informelle à Midjourney, Flux, Sora 2 et Veo 3.1.
- « BEST AI Image Generator in 2026 (Don't Choose Wrong!) » — AffContent, depuis le 9 avril 2026, 14,694 vues. Comparatif généraliste de générateurs propriétaires gratuits et payants.
- « Seedance 2.0 is CRAZY for AI Filmmaking - Full Course » — Dan Kieft, depuis le 24 avril 2026, 179,589 vues. Met en avant la qualité des séquences d’action, la précision des prompts et la cohérence visuelle de Seedance 2.0 de ByteDance, tout en notant ses limites. C’est la vidéo Seedance la plus visible parmi plusieurs vidéos du même sujet mises en ligne cette semaine-là ; la recherche a trouvé au moins 9 autres tutoriels/critiques sur Seedance 2.0 publiés entre février et juin 2026, comme « How Seedance 2.0 is SO GOOD (And Why Hollywood is Shook) ».
- « State of AI Video in 2026: Sora 2, Veo 3.1, Kling 3.0 & Cinematic Prompting Workflows » — @StarnationsAI, première le 20 mars 2026, 177 vues / environ 1K abonnés. Exemple à faible audience montrant l’existence du format vidéo comparatif ; la description contient principalement du contenu non lié, de formation en entreprise, enrichi artificiellement de mots-clés sur la vidéo IA.
- « Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models » — SECourses, 6,649 vues (18 août 2025, hors de la fenêtre de 60 jours mais point de données open source le plus clair). Test d’une semaine de configurations prédéfinies pour Wan 2.2 (vidéo), FLUX et Qwen-Image (texte vers image), couvrant téléchargements, préréglages, upscaling et entraînement/affinage.
- Ensemble de titres open source aux métriques non vérifiées, trouvés par recherche mais non confirmés lors de l’accès aux pages — YouTube a bloqué les récupérations répétées de métadonnées, voir Limites : « Qwen-Image完全ガイド|ポスター作成から画像編集まで5分で終わらせる方法 » et « 【徹底解説】最強オープンソース『Qwen-Image-2512』 » (analyses japonaises de la famille Qwen-Image d’Alibaba), « ComfyUI Text-to-Image Models Compared (Local): Qwen 2512, Z-Image, FLUX.2 klein, Ovis, LongCat » (benchmark local de cinq modèles actuels à poids ouverts), et « Qwen Image Dominates Text-to-Image: 700+ Tests Reveal Why It's Better Than FLUX ».
Signaux
- Le rythme des modèles propriétaires est actuellement hebdomadaire. OpenAI a publié ChatGPT Images 2.5 le 8 septembre 2026 et Google a lancé Nano Banana 2 (Gemini 3.1 Flash Image, 4K) le 26 février 2026. Chacun a déclenché une vague de tutoriels et de réactions dans la même semaine, publiés par des chaînes de taille moyenne comptant 30K à 330K abonnés, avec des dizaines de milliers de vues en quelques jours.
- Seedance 2.0 de ByteDance (sorti le 10 février 2026) est le modèle vidéo le plus couvert sur YouTube cette année. Une recherche par titre a fait apparaître plus de 10 tutoriels et critiques dédiés de février à juin 2026, davantage que pour Sora 2, Veo 3.1 ou Kling 3.0 pris individuellement. La vidéo la plus performante trouvée, celle de Dan Kieft avec 179,6K vues, dépasse d’environ deux fois les tutoriels de génération d’images propriétaires.
- La discussion YouTube autour de Sora 2 est désormais rétrospective plutôt que prospective : les résultats de recherche privilégient les comparatifs de type « état de la vidéo IA » au lieu de tutoriels de nouvelles fonctionnalités, ce qui concorde avec la fermeture confirmée par OpenAI de l’application grand public (26 avril 2026) et la date d’extinction de l’API (24 septembre 2026). Les vidéos utilisent de plus en plus Sora 2 comme référence à dépasser, non comme outil à apprendre.
- La couverture open source privilégie des chaînes de tutoriels techniques, à la manière de SECourses, et des explications japonaises approfondies sur Qwen-Image, plutôt que les grandes vidéos comparatives qui dominent la couverture des modèles propriétaires. Les vues de la vidéo open source confirmée, 6,649, sont environ dix fois inférieures à celles des leaders propriétaires, ce qui suggère une audience plus petite mais plus technique.
- Qwen-Image d’Alibaba est le modèle à poids ouverts suscitant le plus d’attention vidéo dédiée, avec un benchmark anglophone de plus de 700 générations contre FLUX et plusieurs vidéos japonaises présentant le checkpoint Qwen-Image-2512 comme presque indiscernable de créations non IA.
Limites
- Les pages de résultats de recherche YouTube (
/results?search_query=...) et la majorité des pages individuelles/watchont renvoyé des blocages 401/CAPTCHA répétés lors de la récupération de métadonnées structurées. Cette collecte a utilisé un proxy de lecture HTML, car la page de recherche YouTube est rendue côté client en JavaScript et un fetch simple ne peut pas la lire. Environ une tentative sur trois a réussi ; les autres ont été écartées ou rapportées avec le seul titre/la seule date provenant d’extraits de moteur de recherche. - En raison de ces blocages, plusieurs vidéos pertinentes pour l’open source, notamment des analyses Qwen-Image-2512, la comparaison ComfyUI Ovis/LongCat/Z-Image et Qwen-Image-Edit-Rapid-AIO, n’ont pas pu être confirmées quant à leur nombre exact de vues, d’abonnés ou à leur description complète. Elles sont indiquées ci-dessus comme titres uniquement, avec cette réserve.
- Il a été impossible de récupérer les commentaires les plus populaires de quelque vidéo que ce soit ; le même blocage d’accès aux pages a empêché de lire la section des commentaires.
- Les chiffres exacts de visionnage des vidéos comparant Sora 2, Veo 3.1 et Kling 3.0 n’ont pas pu être confirmés, à l’exception d’un exemple à faible audience, StarnationsAI. Plusieurs autres titres ont été trouvés, tels que Kling 2.6 Pro contre Veo/Sora ou Seedance 2.5 contre Sora/Kling/Veo, mais leurs pages ont systématiquement renvoyé une erreur 401.
- Aucune vidéo anglaise dédiée et bien performante sur un seul modèle open source de génération vidéo (Wan, HunyuanVideo, LTX) avec un nombre de vues confirmé n’a été trouvée. Le seul point de données open source qui a pu être vérifié, SECourses, regroupe Wan 2.2 avec deux modèles d’images au lieu de traiter exclusivement la génération vidéo, et a plus d’un an.
Bluesky
Bluesky — Actualités de l’IA de génération d’images et de vidéos
Date de recherche : 2026-09-18. L’API publique de recherche Bluesky (https://api.bsky.app/xrpc/app.bsky.feed.searchPosts) a été utilisée avec des mots-clés comme « Sora 2 », « Nano Banana », « Midjourney », « ComfyUI », « open weights model release » et « Runway/Veo », jusqu’à 15 publications par requête et plus de 70 publications consultées au total.
Comptes (comptes émetteurs)
- dfl.bsky.social — créateur individuel publiant chaque jour des illustrations de paysages au style photographique créées avec Nano Banana 2 (génération d’images Gemini).
- triflingtree.bsky.social — utilisateur très actif qui publie de nombreuses œuvres d’art IA avec les tags
#NanoBananaProet#GeminiAi. - ai.bots.law — bot suivant les procès et évolutions juridiques liés à l’IA.
- gen-ai.news / aichina.news / stechtimes.com / channelnewsasia.bsky.social (via bridgy) — bots/flux d’actualité diffusant des nouvelles de l’industrie de l’IA générative.
- pitchwall.bsky.social / onestudio1.bsky.social / beginnersinai.bsky.social — comptes présentant des comparatifs d’outils IA et des actualités produit.
- primereports.bsky.social / techpresso.bsky.social / theregister.com / socialmedialab.ca — comptes d’actualités internationaux qui suivent l’ouverture des poids de modèles, notamment Meta « Muse » et Alibaba Qwen.
- singularityhorizon.bsky.social / heppokopu.bsky.social / misaka-mikoto-17.bsky.social / 404ai.bsky.social — utilisateurs japonais créant de l’art IA avec Midjourney ou dans des environnements locaux comme ComfyUI.
Publications (principales publications)
Modèles propriétaires
- Publication présentant l’ouverture de l’API Sora 2 : « Sora 2 API: A developer-friendly API for Sora 2 and Sora 2 Pro ». 2026-09-15, Likes 0 / Reposts 0.
https://bsky.app/profile/pitchwall.bsky.social/post/3mvjwvr327k2u - Publication comparative de génération vidéo IA « Veo 3.1 vs Sora 2 vs Kling 3.0 ». 2026-09-14, Likes 2 / Reposts 0.
https://bsky.app/profile/onestudio1.bsky.social/post/3mvhdlv5vgk2w - Publication mentionnant la fin de l’application Sora autonome et conseillant de « passer à Runway, Kling ou Veo » ; elle explique qu’OpenAI abandonne seulement l’application autonome, pas la technologie elle-même. 2026-03-25, Likes 0.
https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l - Publication signalant de nouveaux documents déposés dans le procès de droits d’auteur Disney contre Midjourney. 2026-09-18, Likes 0.
https://bsky.app/profile/ai.bots.law/post/3mvqwgixvkm2n - Illustration de paysage japonais en vue plongeante générée avec Nano Banana 2. Likes 25 / Reposts 1, 2026-09-17.
https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i - Publication d’art surréaliste représentant un arbre, avec le tag
#NanoBananaPro. Likes 15, 2026-09-17.
https://bsky.app/profile/triflingtree.bsky.social/post/3mvpliiqt5c25 - Flash d’actualité indiquant que Meta prépare un rival de Nano Banana 2. 2026-09-16, Likes 0.
https://bsky.app/profile/laiadesk.bsky.social/post/3mvmiod2iod26
Open source
- Publication d’actualité annonçant que Lightricks a fait passer le modèle vidéo LTX-2.3 en mode hérité et recommande désormais LTX-2.5. 2026-09-12, Likes 0.
https://bsky.app/profile/gen-ai.news/post/3mvdadb2upx2l - Publication présentant un LoRA FLUX à poids ouverts, publié via Modelers.cn, destiné à la représentation de personnes africaines. 2026-09-09, Likes 0.
https://bsky.app/profile/aichina.news/post/3mv3dcr6hgz2i - Publication annonçant Qwen3.8-Flash d’Alibaba, modèle multimodal MoE présenté comme aperçu de l’architecture Qwen4. 2026-08-30, Likes 1.
https://bsky.app/profile/primereports.bsky.social/post/3mub3pkd2rf2s - Publication indiquant qu’un institut de recherche d’Abou Dabi a publié une famille de modèles d’IA entièrement ouverts, incluant les poids, les données d’entraînement et le code. 2026-09-03, Likes 0.
https://bsky.app/profile/channelnewsasia.bsky.social/post/3mumk4agbwm2g - Publication d’analyse selon laquelle des entreprises IA chinoises publient successivement des modèles ouverts au cœur d’une guerre des prix avec les acteurs occidentaux. 2026-09-06, Likes 0.
https://bsky.app/profile/stechtimes.com/post/3muuykcvzv62i
Signaux
- Nano Banana 2 (génération d’images Google Gemini) s’est installé dans les publications quotidiennes des créateurs individuels. Des personnes comme triflingtree et dfl publient presque chaque jour des œuvres avec les tags
#NanoBananaProet#GeminiAi, ce qui suggère une adoption réelle, au-delà de l’effet de nouveauté. - Autour de Sora 2, espoir et inquiétude coexistent. Il existe des nouvelles sur l’ouverture de l’API pour les développeurs, mais aussi des messages invitant à migrer vers Runway/Kling/Veo après la fin de l’application autonome. La réorganisation de la stratégie vidéo d’OpenAI devient un sujet de discussion.
- Les procès de droits d’auteur constituent un thème majeur du côté propriétaire. Des comptes bots suivent les nouveaux développements du procès Disney contre Midjourney, alors que le bras de fer judiciaire entre studios et entreprises de génération d’images IA se poursuit.
- Côté open source, les actualités relayées par bots dominent, avec peu de publications passionnées émanant d’individus. LTX-2.5 de Lightricks, les LoRA FLUX, Qwen3.8-Flash et les modèles entièrement ouverts issus d’Abou Dabi proviennent de régions diverses : Occident, Chine et Moyen-Orient.
- Les modèles Meta « Muse » (Spark/Glimmer 30B) continuent d’être annoncés comme bientôt disponibles en poids ouverts, et plusieurs comptes d’actualité internationaux les surveillent comme concurrents potentiels de Nano Banana 2.
- ComfyUI est mentionné comme outil local de référence pour les utilisateurs japonais tels que heppokopu et misaka-mikoto-17. On observe des expérimentations visant à rapprocher la qualité obtenue en local de celle des systèmes ChatGPT/Nano Banana.
Limites
- L’API publique de recherche (
public.api.bsky.app/api.bsky.app) a renvoyé par intermittence des HTTP 403 lors des requêtes automatisées. Les requêtes simples avec mots séparés par des espaces, telles queSora 2 videoouMidjourney, réussissaient à répétition, mais les recherches par expressions entre guillemets, comme"Stable Diffusion", ou avec la syntaxe OR, échouaient presque toujours. Aucune donnée n’a ainsi été obtenue pour « Stable Diffusion », « Wan 2.5 » ou « Qwen Image », ce qui explique en partie le manque de publications directes sur les modèles vidéo open source. - Les pages Web
bsky.appsont rendues côté client, et le texte des publications n’est pas récupérable directement sans exécution JavaScript. Toutes les lectures ont donc reposé sur le texte et les compteurs fournis par l’API JSON. - Sans connexion, les flux suivis, flux personnalisés et listes privées sont inaccessibles. Seules les recherches publiques par mots-clés ont été consultées.
- Les recherches ont surtout porté sur des noms de produits et de modèles en anglais ; aucune recherche active en japonais n’a été menée. Les publications japonaises trouvées, telles que celles de singularityhorizon, heppokopu ou tjb-shizuka, sont apparues fortuitement grâce à des mots-clés anglais. Rien ne garantit donc une couverture exhaustive des discussions japonaises.
Lemmy
Lemmy — Sujets autour de l’IA de génération d’images et de vidéos (septembre 2026)
Communautés
- !«メールアドレス» — spécialisée dans l’IA de génération d’images et de vidéos à poids ouverts, les extensions ComfyUI et la distribution de modèles. C’est la principale découverte de cette collecte : les publications sur MiniMax-H3, modèle de génération vidéo, y sont concentrées.
- !«メールアドレス» — environ 1.6K abonnés (dont 206 locaux). Communauté dédiée aux illustrations d’anime créées avec des modèles de type Stable Diffusion, limitées au contenu SFW.
- !stable_diffusion_art / !stable_diffusion_abstract / !stable_diffusion_witches / !stable_diffusion_mycology / !stable_diffusion_furry / !stable_werewolves (tous sur lemmy.today) — ensemble de communautés d’art IA réparties selon des thèmes de niche. Elles sont davantage des galeries de créations que des espaces d’actualité.
- !«メールアドレス» — communauté miroir relayant des crossposts de r/ArtificialIntelligence. Il y a très peu de discussions originales provenant de Lemmy.
- !«メールアドレス» — 8,235 abonnés. Communauté critique et anti-IA, avec de nombreuses publications sceptiques au sujet de l’IA de génération d’images et de vidéos.
- !«メールアドレス» — 2,698 abonnés. Communauté de type « sneer » qui raille le battage médiatique de l’industrie technologique. C’est là que l’actualité du changement de direction de Midjourney a le plus animé les discussions.
- !«メールアドレス» — actualités technologiques généralistes. Plusieurs nouvelles majeures sur Midjourney y ont circulé.
Publications
- Multiples extensions ComfyUI pour MiniMax-H3 (tendance open source principale) — environ 20 publications dans !«メールアドレス» entre le 2026-08-28 et le 09-16. Par exemple :
- « ComfyUI-FL-MiniMaxH3 » (score 5, 2026-08-30, github.com/filliptm/ComfyUI-FL-MiniMaxH3), avec gestion de chronologie de prompts et composition de plans.
- « H3-World » (score 3, 2026-09-02, huggingface.co/DANNY621/H3-World), qui se présente comme « the first interactive world model built on MiniMax-H3 ».
- « ComfyUI-MiniMaxH3-CLSS » (score 0, 2026-09-01, github.com/nazgut/ComfyUI-MiniMaxH3-CLSS), qui promet de générer des vidéos avec audio, de longueur arbitraire, sur une machine grand public dotée de 16 Go de VRAM.
- « ComfyUI_MinimaxH3_AutoContext » (score 1, 2026-09-16, github.com/supElement/ComfyUI_MinimaxH3_AutoContext), permettant de générer continuellement des vidéos infiniment longues avec peu de VRAM.
- Selon un commentaire de l’utilisateur brucethemoose (score 12, 2026-09-14), MiniMax-H3 est un modèle pouvant référencer librement audio, vidéo et image ; il confirme l’avoir exécuté localement sur un PC assemblé courant avec RTX 3090 + Ryzen 7800.
- Midjourney pivote de la génération d’images vers des dispositifs médicaux, notamment un scanner à ultrasons corps entier — publication sur !«メールアドレス» (https://awful.systems/post/8731127, score 40, 15 commentaires, 2026-06-19). David Gerard présente l’annonce « Midjourney Medical », tandis que les commentaires multiplient les sarcasmes le comparant à Theranos. L’utilisateur YourNetworkIsHaunted relève un défaut technique : « cet appareil ne peut immerger que des personnes mesurant jusqu’à 60 pouces (environ 152 cm), donc il ne peut pas scanner au-dessus du cœur » (score 10). Terranoid décrit ce changement comme une « tentative désespérée après l’impasse du business de la génération d’images » (score 10).
- La même actualité a circulé plusieurs fois dans !«メールアドレス» : « Midjourney pivots from AI image generation... » (theregister.com, score 58, 2026-06-18), « Midjourney wants Hollywood studios to reveal... » (techcrunch.com, score 73, 2026-07-05).
- Le chiffre d’affaires entreprise de Runway aurait doublé — !«メールアドレス» (score 0, 2026-08-30, crosspost depuis reddit.com/r/ArtificialInteligence/comments/1w2hnea). Un taux de rétention nette (NRR) supérieur à 300 % pour les contrats entreprise y est discuté.
- L’intégration de Nano Banana à Google Earth a été arrêtée le lendemain de son lancement — publications dans !«メールアドレス» (fortune.com, 2026-08-07) et autour de !«メールアドレス». Le problème soulevé : n’importe qui pouvait produire des images truquées ressemblant à des photos satellite ; Google aurait immédiatement désactivé la fonction, selon notamment un article de 404media.co.
- Comparaison de six modèles vidéo IA à partir du même prompt — !«メールアドレス», « I ran the same prompt through 6 AI video models... » (score 1, 2026-09-17, reddit.com/r/ArtificialIntelligence/comments/1wipgwa).
- Comparaison de colorisations d’une planche manga noir et blanc avec ChatGPT Images, Wan, Nano Banana Pro et Seedream — !«メールアドレス», « Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? » (score 1, 2026-09-14). Le post compare un modèle ouvert, Wan, à des systèmes propriétaires, Nano Banana Pro, Seedream et GPT Images ; les commentaires valorisent majoritairement le rendu GPT.
- Publication illustrant le climat anti-IA — !«メールアドレス», « Why companies like anthropic and open AI make AI even worse » (score 63, 2026-09-14). Ce n’est pas spécifique à la génération d’images ou de vidéos, mais c’est un bon indicateur de l’ambiance générale de Lemmy, marquée par une forte méfiance envers les grands acteurs propriétaires.
- Retour d’exécution locale de Qwen — !«メールアドレス», « Testing Qwen 3.8 27B running locally on a single 5090 » (score 1, 2026-09-16, v.redd.it/jdrothgw4vph1). Il ne s’agit pas de génération d’images à proprement parler, mais cela s’inscrit dans le contexte de l’exécution de modèles ouverts sur GPU grand public.
- Flux quotidien d’art IA, anime et abstrait — dans !share_anime_art et les communautés !stable_diffusion_art, de nouvelles publications accompagnées d’images hébergées sur civitai.com apparaissent presque tous les jours. Exemple : « Isshiki Clear - Mahjong Fight Girl », score 15, 2026-09-17, lemmy.dbzer0.com/post/75601449. L’intérêt est limité en termes d’actualité, mais cela montre l’usage quotidien de modèles Stable Diffusion, Flux et Krea2.
Signaux
- L’open source est entièrement dominé par MiniMax-H3. Au début et au milieu de septembre, la communauté stable_diffusion était presque remplie de publications sur les outils ComfyUI autour de ce modèle de génération vidéo. La possibilité de combiner localement audio, image et vidéo, ainsi que les optimisations permettant de l’utiliser avec environ 16 Go de VRAM, sont régulièrement mises en avant.
- Les nouvelles positives côté propriétaire sont rares. Le pivot matériel de Midjourney et l’arrêt de la fonction Google Earth ressortent davantage comme des nouvelles de confusion ou d’échec. La croissance de Runway constitue l’un des rares sujets favorables.
- Le ton général de Lemmy est sceptique et critique (!fuck_ai, !techtakes). Les éloges sans nuance sont rares ; l’écart est important entre les communautés d’implémentation, de type stable_diffusion, et les communautés de critique de l’actualité, telles que techtakes et fuck_ai.
- Les œuvres et crossposts prédominent sur les discussions originales. !ai_reddit est littéralement un relais de Reddit ; il ne faut donc pas le considérer comme une source primaire issue de Lemmy.
Limites
- Lemmy est distribué entre plusieurs instances, et l’API de recherche ne trouve que les publications indexées sur lemmy.world. Le temps n’a pas permis de rechercher individuellement sur lemmy.ml ou lemm.ee ; seuls les résultats atteints par fédération via lemmy.world sont couverts.
- Plusieurs mots-clés ont été recherchés, dont « Sora », « Veo », « Gemini image » et « Flux », mais aucune publication sur le lancement lui-même de nouveaux modèles Sora 2 ou Google Veo n’a été trouvée ; les résultats étaient surtout hors sujet. Cela reflète la réalité de cette collecte : les annonces produit des grands acteurs propriétaires sont peu présentes sur Lemmy.
- L’article source de pivot-to-ai.com était illisible à cause de problèmes d’encodage via WebFetch et n’a pas pu être cité directement. Le contenu a été complété à partir du texte et des commentaires de la publication Lemmy sur awful.systems, ainsi que de reportages externes trouvés via moteur de recherche, notamment Bloomberg.
- L’API étant instable, avec des erreurs 400/500, les nombres exacts d’abonnés de !stable_diffusion et !ai_reddit n’ont pas pu être obtenus. Seuls ceux de !share_anime_art (environ 1.6K), !fuck_ai (8,235) et !techtakes (2,698) ont été récupérés.
- Par rapport au critère de complétion du brief, qui demande l’analyse d’environ 20 publications sur chaque réseau social, plus de 20 publications ont été consultées au total via plusieurs requêtes, avec texte, score et date. Seules 9 représentatives sont présentées dans ce fichier.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
Thèmes visuels
- Le modèle d’infographie « récapitulatif d’actualités IA » en néon sombre domine. Arrière-plans presque noirs ou bleu marine, lignes lumineuses cyan-magenta-violet, grands titres blancs et rangées numérotées de logos d’outils dans des badges arrondis. Ce langage visuel unique couvre la plupart des épingles informatives.
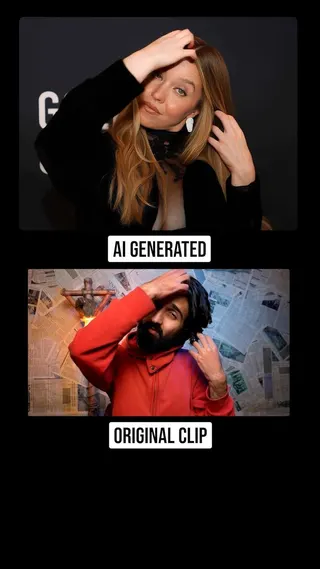
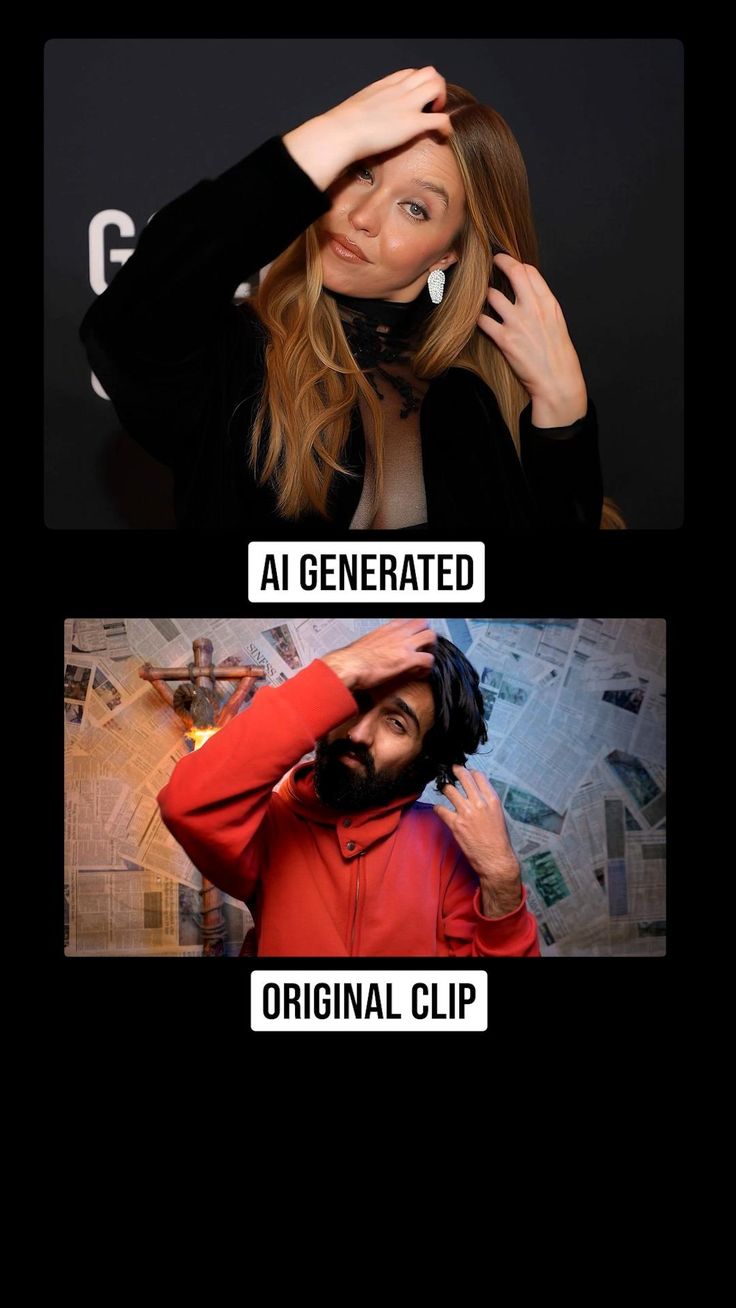
[6, 9, 10, 11, 18, 20, 26, 31, 38, 39, 41, 45, 48] - Le format de défi « repérez l’IA » opposant vrai et faux est omniprésent. Comparaisons en écran partagé ou A/B demandant de choisir la vraie photo, vidéo ou œil, démonstration de photo de tapis rouge modifiée par échange de visage, et selfie hyperréaliste accompagné de la légende « This is AI ».
[3, 21, 24, 33, 46] - L’IA est personnifiée sous forme de robot humanoïde chromé ou blanc. Des androïdes en pied, l’un à un bureau de présentateur « BREAKING NEWS », un autre tenant un téléphone à côté d’un tampon « FAKE », et un troisième touchant un globe lumineux au-dessus d’une ville, représentent l’IA en général plutôt qu’un produit précis.
[3, 40, 44] - Vignettes de réaction de YouTubeurs pour les actualités IA. Hommes barbus ou surpris, cadrés à côté d’une rangée de logos d’entreprises comme OpenAI, Google, Meta, Anthropic et Notion : une convention visuelle reconnaissable des vidéos d’actualité IA hebdomadaires.
[2, 19, 22, 42] - Démonstrations à partir d’une même vidéo source, dans de nombreux styles, illustrant les technologies de cohérence image/vidéo. Une personne marchant et une voiture sont chacune rendues sous forme de blocs de bois, origami, Lego, fleurs et jouet : une vitrine de diffusion de type Lumendra/Luminate.
[5] - Les mêmes quelques noms d’outils reviennent dans chaque liste : Runway (Gen-3), Pika, Kling AI, Luma/Dream Machine, Google Veo (2 et 3), Canva AI, Hailuo AI (MiniMax), CapCut, ElevenLabs et Stable Video Diffusion.
[6, 10, 18, 20, 31, 45] - Le portrait IA hyperréaliste est utilisé comme preuve de qualité. Un vieux pêcheur photoréaliste pour AMD « Amuse 3.0 », une statue de marbre et de bois jouant du violoncelle et des composites de visages « AI baby » servent à démontrer le réalisme des modèles actuels.
[25, 47, 50] - La mise en scène de faux journal télévisé ou faux journal papier pour les nouvelles IA elles-mêmes. Bandeaux « BREAKING NEWS », générateur d’avatar présentateur IA de Wondershare Virbo et une fausse une de journal complète (« The AI Dispatch », 15 août 2026) montrent les contenus d’actualité IA imitant les conventions du journalisme télévisé et imprimé.
[14, 36, 40, 41]
Épingles notables
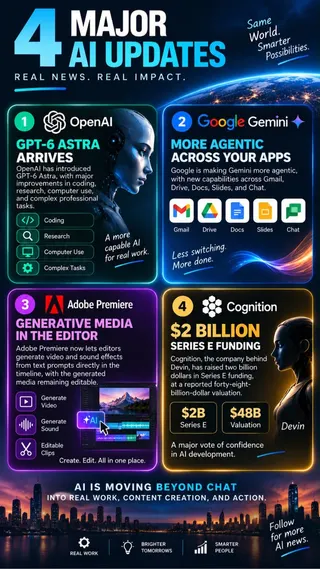
[5](sans titre, grille de transformation vidéo multi-styles) — vidéo source d’une personne et d’une voiture restituées dans cinq matériaux différents (bois, origami, Lego, fleurs, plastique de jouet) ; la démonstration concrète la plus claire des technologies actuelles de cohérence image/vidéo dans l’ensemble.[9]« 4 Major AI Updates You Need to Know in 2026 » — cite des éléments précis : « GPT-6 Astra » d’OpenAI, Gemini devenant agentique dans Gmail/Docs/Slides, Adobe Premiere générant vidéo et audio directement dans la timeline, et Cognition (Devin) levant une série E de 2 milliards de dollars pour une valorisation de 48 milliards.[28]« ByteDance and Hollywood reach global deal on AI copyright » — épingle au style d’article d’actualité : ByteDance aurait conclu un accord avec la Motion Picture Association pour renforcer la protection de la propriété intellectuelle dans ses outils de génération d’images et de vidéos IA.[45]« Today's AI News — May 20, 2026 » — récapitule Google I/O 2026 : Gemini 3.5 Flash, Gemini Omni, refonte de Search avec IA, fonctions d’accessibilité IA d’Apple et concurrence autour des lunettes intelligentes IA (Android XR).[41]« The AI Dispatch », 15 août 2026 — fausse une de journal couvrant de nombreux thèmes actuels liés à l’IA, notamment la vitesse d’inférence, l’IA souveraine, les harnais d’agents, la sûreté de l’IA et la recherche approfondie.[31]« AI Video Creation Tools Changing How Content Is Made » — répertoire d’outils le plus exhaustif trouvé, nommant 20 produits pour la génération texte vers vidéo, image vers vidéo, l’édition, la voix off, la vidéo d’archive/B-roll et la publication/optimisation.[24](sans titre, photo de tapis rouge générée par IA contre « clip original ») — démonstration d’échange de visage/deepfake associant un portrait brillant créé par IA au clip source réel d’une autre personne, illustrant les technologies de transfert d’identité.[40]« Discover how Grok is revolutionizing video... » — robot humanoïde présentateur devant un bureau « BREAKING NEWS », faisant la promotion des capacités vidéo de Grok.[47]« Amuse 3.0 » — outil local/de périphérique de création artistique IA signé AMD, démontré avec le portrait photoréaliste d’un pêcheur âgé.[10]« AI Image Video: Best Quality vs Best Free » — infographie en arbre de décision séparant les outils payants de meilleure qualité (ChatGPT Plus, Midjourney, Adobe Firefly, Runway Gen-3, Luma) des options gratuites (Ideogram, niveau gratuit Gemini, SeaArt, Krea, CapCut).
Signaux
- Les récapitulatifs/listes d’outils de génération vidéo constituent de loin le type de contenu le plus visible et le plus répété. Le public Pinterest autour de la génération d’images par IA est surtout composé de créateurs SEO/affiliation emballant le même ensemble d’outils propriétaires, Runway, Pika, Kling, Luma, Veo, Hailuo et CapCut, plutôt que de véritables actualités de dernière minute.
- Les contenus d’éducation aux médias du type « pouvez-vous reconnaître que c’est de l’IA ? », comprenant défis vrai/faux et démonstrations de deepfakes, forment un sous-genre complet. L’inquiétude et la curiosité du public face à la détection sont elles-mêmes un moteur de contenu, indépendamment de la sortie d’un modèle particulier.
- Quelques épingles évoquent des événements datés et nommés postérieurs au début de la fenêtre de collecte : récapitulatif de Google I/O 2026, « GPT-6 Astra », digest d’actualité du 15 août 2026 et levée de 2 milliards de dollars de Cognition. Ce sont les éléments les plus proches de nouvelles vérifiables trouvés sur cette plateforme.
- Les détails open source sont rares : « Stable Video Diffusion » n’apparaît que sous la forme d’un logo parmi les 20 outils d’un répertoire
[31]. Aucune épingle n’aborde réellement une sortie de poids ouverts, une licence ou un fork communautaire. - Aucun contenu ne traite des méthodes d’entraînement, de l’architecture des modèles ou des débats sur les jeux de données et licences, à l’exception d’une épingle sur l’accord de droits d’auteur ByteDance–MPA
[28].
Limites
- Cette étape décrit uniquement les images précollectées par le worker, conformément à
platforms/pinterest.md. Aucune navigation Pinterest en direct, aucune recherche, ni aucune lecture des articles liés n’a été effectuée ; aucune affirmation n’a été vérifiée contre une page en direct ou l’article derrière chaque épingle. - Plusieurs épingles sont des modèles quasi identiques provenant de comptes semblant être des comptes de repost ou de scraping : le visuel stock néon « Generate content with AI » apparaît deux fois
[11, 26], la bannière Google Veo 2 deux fois[7, 8], et la liste « Best AI Video Generation Websites » deux fois avec le même ensemble d’outils[6, 18]. - Cinq épingles n’ont pas de titre (
(untitled)) dans le tableau source[8, 17, 20, 21, 24, 28... ]; précisément[8, 20, 21, 24, 28]ont un titre vide ou générique, ce qui limite l’attribution à ce qui est visible sur l’image. - L’ensemble d’épingles appartient à un seul genre, aucune ventilation par genre n’ayant été définie pour cette collecte ; les 50 épingles proviennent d’une seule recherche non différenciée.
Actions recommandées
- Relancer la collecte X avec des mots-clés directement liés à l’IA, comme Sora, Nano Banana, Kling, Qwen, Flux et ComfyUI ; les mots-clés tendance de X ont été récupérés par erreur et ont mené à un échec complet.
- Continuer à suivre MiniMax-H3 et Qwen-Image comme indicateurs majeurs de l’open source.
- Observer l’évolution des destinations de migration des utilisateurs, Runway/Kling/Veo, autour de la fin de l’API Sora 2 le 2026-09-24.
- Suivre les volets juridiques et éthiques, tels que le procès Disney contre Midjourney et le débat sur la légalisation des générations sans consentement, avec une importance égale ou supérieure aux comparatifs d’outils.
- Ajouter aux recherches Reddit des requêtes ciblant les subreddits spécialisés dans la génération d’images, tels que r/StableDiffusion et r/aiArt.
- Vérifier en direct les conclusions issues de Pinterest en ouvrant réellement les articles liés.
Images collectées
























Note sur la qualité des données
Parmi les six plateformes demandées dans le brief, X est inutilisable car les données collectées sont entièrement hors sujet. Reddit, Bluesky et YouTube ont également manqué certains sujets principaux, tels que Stable Diffusion et Wan 2.5, en raison des termes de recherche et des limitations d’API (403/401/CAPTCHA).