Actualités de l’IA de génération d’images et de vidéos — 2026-09-16
Alors que les utilisateurs lassés de la censure se tournent vers des modèles vidéo chinois à poids ouverts comme MiniMax H3, Wan et LTX-2, les acteurs fermés — Google, OpenAI et ByteDance — continuent d’annoncer de nouveaux modèles à raison d’un à deux par mois via Replicate. La réduction de Sora (API arrêtée le 2026-09-24) et les litiges liés au droit d’auteur constituent toutefois des risques croissants.
Actualités de l’IA de génération d’images et de vidéos — 2026-09-16
Les acteurs à code source fermé — notamment Google, OpenAI, ByteDance et Kuaishou — continuent de lancer de nouveaux modèles à raison d’un à deux par mois. Nano Banana Pro, Veo 3.1, Seedance 2.0 et Kling 3.0 dominent les annonces récentes. À l’inverse, les modèles vidéo locaux chinois, tels que MiniMax H3, Wan, LTX-2 et HunyuanVideo, servent de solution de repli aux utilisateurs fatigués de la censure et des filtres des services cloud ; tout un écosystème de tutoriels autour de ComfyUI s’est développé. La fermeture de fait de Sora (avec une fin d’API prévue le 2026-09-24) et des procès tels que Disney v. Midjourney assombrissent toutefois la dynamique des acteurs fermés. Cette collecte présente aussi des limites : X (Twitter) a récupéré des tendances sans rapport avec le sujet et n’a donc produit pratiquement aucun résultat, tandis que Reddit et Pinterest n’ont pas atteint le critère de complétude de 20 éléments analysés.
Ce qui ressort toutes plateformes confondues
- Le mécontentement face à la censure et aux restrictions favorise la génération open source et locale. Sur Reddit (#1, #5, #9), les utilisateurs évoquent leur passage à Minimax H3, Wan, LTX Video ou Seedance 2.5 après avoir été bloqués par les filtres de Google Flow ou Gemini. Sur Lemmy (!stable_diffusion), les publications sur les outils autour de MiniMax H3 ont été quasi quotidiennes entre le 2026-09-08 et le 13. Les tutoriels YouTube liés à ComfyUI couvrent continuellement ces mêmes modèles.
- Les modèles chinois — ByteDance Seedance/Seedream, Alibaba Wan/Qwen, Tencent Hunyuan, Kuaishou Kling et MiniMax — gagnent en présence, dans l’open comme dans le fermé. Cette opposition entre les États-Unis et la Chine revient sur YouTube, Bluesky via Replicate, et Pinterest avec Vidu/ShengShu.
- L’intérêt se déplace de la « génération » vers l’édition et le contrôle de cohérence. Reddit (#7, #8) met en avant la cohérence des personnages et la valeur de corriger les 10 % manquants d’une image déjà réussie à 90 %. YouTube traite également de modèles d’édition comme Qwen Image Edit.
- Les « nouvelles de l’ombre » chez les acteurs fermés sont les procès et les réductions de voilure. La fermeture de fait de Sora (Lemmy), Disney v. Midjourney (Bluesky, Lemmy), ainsi que les demandes de communication de Midjourney contre Hollywood (Lemmy) ressortent davantage que les annonces de fonctionnalités.
- L’étiquette « open source » demeure confuse. YouTube et Bluesky signalent que certaines vidéos Seedream de ByteDance se présentent comme open source alors que leur disponibilité repose surtout sur des API fermées.
Par plateforme
Reddit — 11 fils issus de sept subreddits, dont r/generativeAI, r/aivideomaking et r/aifilmmaking. On y retrouve, avec des citations directes d’utilisateurs, l’adoption de la génération locale, une forte demande pour des outils gratuits ou peu coûteux, le débat autour de l’« AI slop », et des comparaisons de génération d’images entre Gemini et OpenAI. La collecte, limitée à un seul terme de recherche, n’atteint toutefois pas l’objectif de 20 éléments.
X — Parmi les 40 publications de 37 comptes collectées, aucune ne portait sur la génération d’images ou de vidéos par IA. Les requêtes provenaient non pas du thème étudié, mais directement de la liste de tendances de X (#Uranium, Clarity Act, etc.). Les quatre éléments les plus proches, liés à « Dario », concernaient la politique de sécurité de l’IA et non le sujet. La collecte est donc un échec de fait.
YouTube — 12 vidéos de grandes chaînes telles que TheAIGRID, Matt Wolfe et Theoretically Media ont été examinées. Elles couvrent à la fois les modèles fermés (Nano Banana Pro, Veo 3.1, Runway Gen-4.5, Seedance 2.0 contre Kling 3.0) et ouverts (HunyuanImage 3.0, FLUX.2, LTX-2, Wan2.2/2.7, MiniMax H3 et Ideogram 4). Il existe toutefois peu d’annonces de modèles entièrement nouveaux au cours des 60 derniers jours ; de nombreuses vidéos sont antérieures à la période étudiée.
Bluesky — 14 publications ont été relevées, principalement à partir des flux officiels de Replicate, TestingCatalog et Simon Willison. Les annonces concernent surtout des acteurs fermés : Nano Banana Pro, Gemini 3 Pro, Veo 3.1, ChatGPT Images 2.5, Muse Video et Orbis. Côté ouvert, seuls FLUX.2 et Wan 2.2 Animate ressortent clairement ; Stability AI est silencieuse depuis novembre 2025. Les nombreuses erreurs 403 de l’API de recherche ont biaisé la collecte vers des comptes connus.
Lemmy — Les communautés !stable_diffusion fonctionnent de fait comme un fil d’actualité dédié à l’open source : le bot Even_Adder publie presque quotidiennement des nouveautés de modèles et de LoRA pour MiniMax H3 et LTX-2. Les nouvelles concernant les acteurs fermés apparaissent surtout dans des communautés généralistes comme !technology, à raison d’un ou deux sujets par mois, principalement sous l’angle des polémiques, des procès ou des retraits. Plus de dix éléments open source ont été observés, mais seulement cinq ou six du côté fermé.
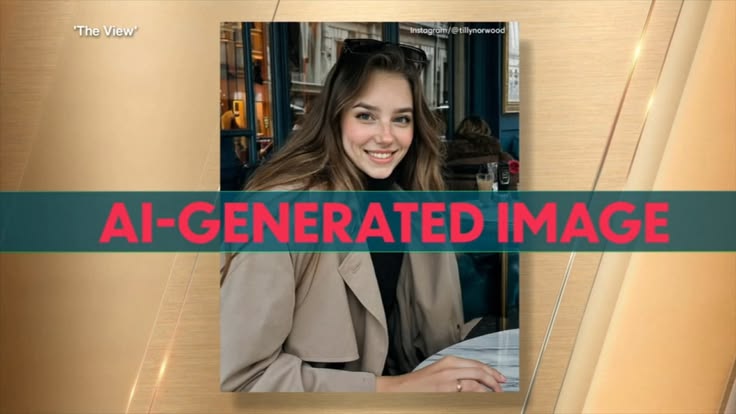
Pinterest — Les 50 épingles issues d’une seule requête ont toutes été examinées. Les acteurs fermés y dominent visuellement : promotion de Veo 2, infographies de classement d’outils et contenu lié à l’actrice IA Tilly Norwood. L’open source y est pratiquement absent, à l’exception d’une mention de Stable Video Diffusion dans une liste d’outils. L’absence de catégorisation, les contenus recyclés à partir de modèles et la répétition d’infographies font soupçonner une production gonflée pour le référencement.
Cinq plateformes sur six, hors X, ont fourni des publications ou des œuvres pertinentes. La lacune de X ne peut pas être comblée dans cette exécution, puisque la collecte elle-même dépendait de termes sans rapport avec le thème.
Points à surveiller
- Nano Banana 2 : uniquement des informations au stade de fuite ; aucune annonce officielle confirmée. YouTube — https://www.youtube.com/watch?v=SJvnEvOvEYk
- Fin de l’API de Sora 2, prévue le 2026-09-24 : l’application autonome est déjà arrêtée. Lemmy — https://lemmy.world/post/45568787
- Rythme de développement des outils autour de MiniMax H3 : plusieurs outils dérivés ont été publiés entre le 2026-09-08 et le 13. Lemmy — https://lemmy.dbzer0.com/post/75382764
- Évolution du procès Disney v. Midjourney : de nouveaux documents sont déposés presque tous les jours. Bluesky — https://bsky.app/profile/ai.bots.law/post/3mvlvjpygwl27
- Génération vidéo en temps réel d’Orbis (Visko) : modèle émergent promettant de la 4K/24 ips et des mises à jour sous la seconde. Bluesky — https://bsky.app/profile/testingcatalog.com/post/3muf3e5zh3y2f
- Question de l’étiquette « open source » de Seedream : une vérification auprès de sources primaires est nécessaire. YouTube — https://www.youtube.com/watch?v=3Hmj05sE1V8
Actions recommandées
- Pour la nouvelle collecte sur X, utiliser des requêtes liées au thème, par exemple « Nano Banana », « Seedance », « Wan 2.2 » et « Sora », plutôt que de s’appuyer sur les tendances.
- Suivre régulièrement les flux !stable_diffusion de Lemmy comme indicateur avancé des modèles vidéo open source.
- Suivre l’annonce officielle de Nano Banana 2 et la fin de l’API de Sora 2 le 2026-09-24 comme points d’inflexion chez les acteurs fermés.
- Surveiller les litiges en cours, dont Disney v. Midjourney, car ils peuvent influencer les orientations futures des entreprises à code source fermé.
- Pour une nouvelle collecte Reddit et Pinterest, utiliser plusieurs requêtes thématiques afin d’atteindre le critère de 20 éléments analysés.
- Vérifier auprès de sources primaires telles que Hugging Face ou les blogs officiels les modèles se présentant comme « open source » avant de les citer.
Qualité des données
X dépendait d’une liste de tendances sans lien avec le sujet et n’a produit pratiquement aucune publication pertinente sur la génération d’images ou de vidéos par IA ; c’est la principale lacune de ces données. Reddit s’est limité à 11 fils avec une seule requête, et Pinterest à 50 épingles sans catégorisation issues d’une seule requête ; aucun des deux ne respecte le critère de 20 éléments analysés. Lemmy ne comptait que cinq ou six mentions directes des modèles fermés, ce qui reflète la taille limitée de la plateforme. YouTube et Bluesky étaient relativement plus riches, mais les annonces YouTube totalement nouvelles dans les 60 derniers jours étaient rares ; Bluesky dépendait des flux de comptes connus à cause des erreurs 403 de l’API de recherche.
Récapitulatif par plateforme
Reddit — Actualités de l’IA de génération d’images et de vidéos
Où
| Subreddit | Nombre de membres | Nombre de fils collectés |
|---|---|---|
| r/generativeAI | 153,596 | 3 éléments (#1, #7, #9) |
| r/AIToolTalks | 6,131 | 2 éléments (#2, #8) |
| r/aivideomaking | 7,038 | 2 éléments (#4, #5) |
| r/aifilmmaking | 7,833 | 1 élément (#3) |
| r/GeminiAI | 373,910 | 1 élément (#6) |
| r/AIDangers | 53,008 | 1 élément (#11) |
| r/politicalstress | 14 | 1 élément (#10) |
Les sujets pratiques liés à la génération d’images et de vidéos par IA se concentrent dans r/generativeAI, r/aivideomaking, r/aifilmmaking et r/AIToolTalks. Les deux sujets issus de r/AIDangers et r/politicalstress relèvent davantage des inquiétudes générales et des débats réglementaires autour de l’IA.
Ce que disent les utilisateurs
-
Mouvement vers la génération locale pour éviter la censure du cloud — Fil #1, « Need a good video generation AI for image to video of people » (r/generativeAI, 2 pt, 2026-09-15, https://www.reddit.com/r/generativeAI/comments/1wh1y9d/). L’auteur indique que des images réalisées avec Nano Banana Pro dans Google Flow ont été bloquées par le filtre 60 fois de suite. u/f5alcon recommande « Minimax H3 is the best local generator », et u/Liberation2020 recommande « Wan, mini max H3 and LTX Video » ; l’exécution locale dans ComfyUI est plébiscitée chez les propriétaires de RTX 5090.
-
Les avis divergent sur le généreux quota gratuit de Google Flow, jugé faible en physique — Fil #3, « Google Flow is giving creators a surprisingly generous amount of free AI video generation right now » (r/aifilmmaking, 8 pt, 2026-09-14, https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/). u/Sea-Temporary-6995 estime : « It's weak at physics and logic. Even Minimax is far better IME. » À l’inverse, u/Rollertoaster7 le considère plutôt bon pour un outil gratuit.
-
La demande pour des outils gratuits ou peu coûteux est très forte — Fil #4 (r/aivideomaking, 0 pt, 9 commentaires, 2026-09-15, https://www.reddit.com/r/aivideomaking/comments/1wh80z3/) et fil #5, « Looking for free/credit-based AI tools for highly realistic image & video generation » (r/aivideomaking, 5 pt, 31 commentaires, 2026-09-09, https://www.reddit.com/r/aivideomaking/comments/1wbxpdf/). u/Fluffybabyyoda indique que Google Flow offre parfois 50 crédits quotidiens, deux fois par jour, et que Google Gemini offrirait trois vidéos par jour.
-
La demande de modèles non censurés est exprimée avec des noms de marques précis — Dans le fil #5, u/zeroludesigner conseille cyberbara et indique que Seedance 2.5 y est non censuré et prend en charge les vrais visages. u/senorfavela explique même comment obtenir des crédits gratuits grâce au programme de parrainage de reRAW.ai.
-
Gemini est jugé inférieur à OpenAI en génération d’images — Fil #6, « Image generation Gemini vs OpenAI » (r/GeminiAI, 9 pt, 2026-09-14, https://www.reddit.com/r/GeminiAI/comments/1wgjjco/). u/damaged_terror écrit : « The gemini one looks like it gave up halfway through and just slapped some text on there. »
-
La critique de l’« AI slop » concerne davantage l’absence d’histoire que la qualité technique — Fil #7, « Is there a way to make AI video that does not look like AI slop? » (r/generativeAI, 0 pt, 24 commentaires, 2026-09-14, https://www.reddit.com/r/generativeAI/comments/1wgjjzu/). L’auteur rapporte que le temps de visionnage a été multiplié par environ neuf après le passage à un format de quatre parties avec le même personnage et la même voix. argil est cité pour la cohérence du visage des présentateurs, kling pour les personnages qui dérivent après quelques plans, et runway pour la facilité du travail de caméra. u/RioNReedus estime que « AI Slop » est désormais une expression employée contre tout contenu IA, quelle que soit sa qualité.
-
L’intérêt se déplace de la génération vers l’édition — Fil #8, « AI image editing is becoming more interesting than image generation » (r/AIToolTalks, 10 pt, 2026-09-14, https://www.reddit.com/r/AIToolTalks/comments/1wgbie5/). u/SethWorks20 considère que pouvoir prendre une image correcte à 90 % et réparer les 10 % restants est bien plus utile au quotidien.
-
Une seule invite et des images de référence suffisent désormais à créer une vidéo virale — Fil #9, « HOW IS THIS MADE?! » (r/generativeAI, 0 pt, 31 commentaires, 2026-09-10, https://www.reddit.com/r/generativeAI/comments/1wced4g/). u/lagbit_original recommande d’utiliser son modèle d’image préféré pour créer le personnage, puis Seedance 2.5, une seule invite et les bonnes références.
-
Les inquiétudes générales face à l’IA se propagent dans les subreddits de génération — Fil #2, « Are all of you also anxious about recent news about AI? » (r/AIToolTalks, 13 pt, 35 commentaires, 2026-09-13, https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/). Les avis sont partagés au sujet de la consommation d’eau et de l’emploi ; u/Big-Pops78 rétorque notamment qu’une voiture consomme 13 000 à 20 000 gallons et un jean 3 000 gallons.
-
Les débats sur l’AGI et le risque d’extinction humaine ont atteint le grand public — Fil #10, « AI news is really hard right now » (r/politicalstress, 4 pt, 15 commentaires, 2026-09-12, https://www.reddit.com/r/politicalstress/comments/1wecrrc/). u/Fil_77 cite le scénario prospectif « AI 2027 » afin de souligner l’urgence d’une régulation.
-
Le scepticisme selon lequel l’IA n’améliore pas les résultats progresse aussi — Fil #11, « Biggest AI news of 2026: AI is not a necessary tool... » (r/AIDangers, 23 pt, 30 commentaires, 2026-09-14, https://www.reddit.com/r/AIDangers/comments/1wg5y17/). u/presentofai répond que les chiffres affirmant que l’IA a empiré les choses mesurent surtout des déploiements maladroits, et non les modèles eux-mêmes.
Signaux
- En hausse : les fils #1, #5 et #9 montrent de façon cohérente un soutien aux flux locaux et ouverts — Minimax H3, Wan, LTX Video, Seedance 2.5 et ComfyUI — nourri par le rejet de la censure et des restrictions des outils cloud fermés tels que Google Flow/Veo et Gemini. L’intérêt pour l’édition et le contrôle de cohérence, davantage que pour la seule génération, est également net (#7, #8).
- Délaissé ou contesté : le text-to-video ponctuel à partir d’une seule invite est facilement qualifié de « slop » (#7), et la génération d’images de Gemini est explicitement jugée moins bonne qu’OpenAI dans le fil #6.
- Désaccords : le quota gratuit de Google Flow divise entre ceux qui le trouvent généreux (u/Rollertoaster7 dans #3) et ceux qui le considèrent inutilisable en pratique (u/Sea-Temporary-6995 dans #3). Le terme même d’« AI slop » oppose les partisans d’une critique de la faiblesse technique et ceux qui le voient comme une étiquette vide employée par les détracteurs de l’IA (u/RioNReedus, u/Myg0t_0 dans #7).
- Élément surprenant : bien que la recherche portât sur les actualités de génération d’images et de vidéos, deux des onze fils recueillis (#10, #11) ont dérivé vers l’AGI et le risque d’extinction humaine. Cela suggère que la recherche d’informations sur la génération visuelle est étroitement liée aux récits d’inquiétude générale envers l’IA.
Limites
- La recherche n’a utilisé que l’expression « Image and Video Generation AI News » et n’a recueilli que 11 fils provenant de sept subreddits. Elle n’atteint pas l’objectif d’environ 20 éléments par réseau social et risque donc d’avoir manqué des résultats ; aucune exploration avec des requêtes supplémentaires n’a été menée.
- Le corps des publications des fils #4 et #11 n’a pas été enregistré dans le fichier ; l’analyse repose uniquement sur le titre et les commentaires.
- r/politicalstress, qui ne compte que 14 membres, est une communauté très marginale, et sa publication ne traite pas spécifiquement de la génération d’images ou de vidéos, mais de l’anxiété générale liée à l’IA.
X
X — Actualités de l’IA de génération d’images et de vidéos
Comptes
Parmi les 40 publications collectées auprès de 37 comptes, aucun compte ne publiait sur l’IA de génération d’images ou de vidéos. À titre de référence, les comptes qui ont suscité le plus d’engagement dans les données collectées sont listés ci-dessous.
| Compte | Nombre de publications | Total de j’aime | Contenu |
|---|---|---|---|
| @tonypraysick | 1 | 36,091 | Position politique d’Ed Sheeran, ragots musicaux |
| @Omolomo_o | 2 | 9,157 | Ragots religieux et politiques nigérians |
| @TheSirRobotto | 2 | 10,608 | Football et discussion sur la dévolution au Royaume-Uni |
| @SenLummis | 1 | 8,909 | Sénatrice américaine, Clarity Act sur les cryptomonnaies |
| @realwangjyunhao | 1 | 7,671 | Influenceur taïwanais, publication d’anniversaire de couple |
| @RippleXrpie | 1 | 7,513 | Communauté cryptomonnaie XRP, Clarity Act |
| @AshCrypto | 1 | 2,508 | Influenceur cryptomonnaie, Clarity Act |
| @NFT_Chen / @wquguru / @bluetouff / @BPIV400 | 1 à 2 chacun | 75 à 1,106 | Position de Dario Amodei, PDG d’Anthropic, sur la Chine et politique de l’IA |
Aucun compte ne publiait massivement : il s’agit dans tous les cas de publications isolées ou de quelques publications devenues virales. @Omolomo_o est le seul compte dont les deux publications ont obtenu plusieurs milliers de j’aime, mais il traite d’antagonismes religieux et n’a aucun rapport avec l’IA générative.
Publications
Les 40 éléments collectés ont tous été vérifiés, mais aucun ne concernait la génération d’images ou de vidéos par IA. Les quatre éléments les plus proches ont été trouvés avec « Dario » et mentionnent Dario Amodei, PDG d’Anthropic ; ils traitent néanmoins de sécurité et de politique chinoise de l’IA, sans rapport avec la dynamique open source/fermée des modèles d’images ou de vidéos. Ils sont consignés ici à titre de référence.
-
@bluetouff (153 j’aime, 35 republications, 19 réponses, environ 7 300 vues, 2026-09-14)
https://x.com/bluetouff/status/2099399733127078156The interesting thing about Dario, Sam, and Elon's sudden love affair with the handbrake might not even be the extinction of humanity. It's that AI cybersecurity is turning into a U.S. industrial policy...
→ Discussion sur la sécurité de l’IA et la politique industrielle ; la génération d’images ou de vidéos n’est pas évoquée. -
@BPIV400 (1,106 j’aime, 46 republications, 9 réponses, environ 78 000 vues, 2026-09-14)
https://x.com/BPIV400/status/2099336990478958724Dario complaining that AI research is progressing dangerously fast
→ Inquiétude concernant la vitesse du progrès de l’IA, et non les modèles génératifs eux-mêmes. -
@NFT_Chen (75 j’aime, 21 republications, 55 réponses, environ 85 000 vues, 2026-09-14)
https://x.com/NFT_Chen/status/2099348095612109306Anthropic CEO Dario Amodei openly admits to being a hawk on China, pushing to treat Chinese AI like Soviet nuclear missiles...
→ Débat sur la rivalité États-Unis–Chine en IA, sans rapport avec la génération d’images ou de vidéos. -
@wquguru (176 j’aime, 22 republications, 22 réponses, environ 84 000 vues, 2026-09-14)
https://x.com/wquguru/status/2099340572519460928Dario Amodei's relationship with China in this lifetime is truly a tangled mess...
→ Même sujet, autour du parcours de Dario Amodei.
Les 36 autres éléments — issus de recherches telles que #Uranium, #sweepstakes, Clarity Act, LMEOW, #chance, Serbia, Ed Sheeran, England et Church — concernaient des actions minières d’uranium, des concours, un projet de loi américain sur les cryptomonnaies, des memecoins, des thèmes amoureux, le football et la dévolution britannique, une controverse sur la tournée d’Ed Sheeran ou encore des antagonismes religieux au Nigeria. Ils étaient entièrement hors sujet.
Signaux
- En hausse ou suivi : impossible à déterminer à partir de ces données. Aucun élément ne permet de décrire l’évolution des discussions sur la génération d’images ou de vidéos par IA sur X.
- Délaissé : sans objet, car aucune publication sur le thème n’existe dans l’échantillon.
- Élément surprenant : les dix requêtes (#Uranium, #sweepstakes, Clarity Act, LMEOW, #chance, Dario, Serbia, Ed Sheeran, England, Church) correspondent presque exactement aux tendances affichées dans « What X says is happening » pour une session en Croatie. Il semble donc que la collecte ait utilisé directement les tendances de X plutôt que les termes du brief. Le seul thème lié de loin à l’IA, « Dario », relevait d’un contexte de sécurité nationale et non de génération visuelle.
Limites
- Les dix termes recherchés dans cette session — #Uranium, #sweepstakes, Clarity Act, LMEOW, #chance, Dario, Serbia, Ed Sheeran, England et Church — ne sont pas directement liés au thème de la recherche : l’IA de génération d’images et de vidéos, open source ou fermée. Les 40 publications recueillies ne contiennent donc aucune information pertinente sur ce sujet.
- La collecte s’appuyait sur les tendances visibles dans Explore pour une session croate. Aucune recherche n’a été effectuée avec des termes adaptés, tels que « image generation AI », « Nano Banana », « Seedance », « Sora », « Midjourney », « Stable Diffusion » ou « open source video model ».
- Le critère de complétude d’environ 20 publications analysées par réseau social n’est donc pas respecté sur X pour les publications liées à la génération d’images ou de vidéos par IA. Les sections Publications et Signaux rapportent essentiellement l’absence de découverte pertinente ; une nouvelle collecte avec des termes adaptés est nécessaire.
YouTube
YouTube — Dernières actualités de l’IA de génération d’images et de vidéos, fermée et open source
Chaînes
- TheAIGRID(@TheAiGrid) — Chaîne d’actualité hebdomadaire qui couvre des modèles d’image et de vidéo tant fermés qu’ouverts. youtube.com/@TheAiGrid
- Matt Wolfe(@mreflow) — Environ un million d’abonnés. Traite des outils IA en général, avec de nombreuses explications sur Sora, Veo et Nano Banana. youtube.com/@mreflow
- Theoretically Media(@TheoreticallyMedia) — Des créateurs vidéo en activité y évaluent des outils IA dans une optique de production réelle. La chaîne couvre régulièrement des outils open source comme LTX-2, Wan et Hunyuan. youtube.com/@TheoreticallyMedia
- Créateurs de tutoriels ComfyUI, dont plusieurs chaînes n’ont pas pu être identifiées dans les résultats de recherche — publient presque chaque semaine des procédures d’installation locale pour MiniMax H3, FLUX.2, Wan2.2 et LTX-2.
Vidéos
-
« VEO 3.1 Camera Controls, Nano Banana 2 Leaks, Open-Source QWEN Image Edit & Sora 2 Update »
2025-11-10 / youtube.com/watch?v=SJvnEvOvEYk
Une vidéo couvrant simultanément modèles fermés et ouverts. Elle présente les contrôles de caméra ajoutés à Veo 3.1, une fuite non confirmée sur Nano Banana 2 — une note « temporal coherence mapping » pouvant laisser supposer une adaptation à la diffusion vidéo —, les progrès de Qwen Image Edit open source, et une mise à jour de Sora 2. -
« Google won image generation (it's not even close) NANO BANANA PRO BREAKDOWN »
2025-11-26 / youtube.com/watch?v=UV9GqinedQ8
Analyse de Nano Banana Pro, basé sur Gemini 3 Pro. La vidéo insiste sur le passage de la limite 1024×1024 de Nano Banana à la génération en 2K/4K et à un rendu de texte plus précis, en affirmant que Google a pris la tête de la génération d’images. -
« Ultimate Runway Gen 4.5 Tutorial For New Users in 2026 »
2026-03-29 / youtube.com/watch?v=IUge3u4ZrqQ
Tutoriel sur Runway Gen-4.5, modèle fermé précédemment connu sous les noms de code Whisper Thunder et David. Il est présenté comme difficile à distinguer d’images réelles et son influence potentielle sur l’industrie de la vidéo de stock est discutée. -
Série de comparaisons « Seedance 2.0 vs Kling AI 3.0 » (plusieurs chaînes publiées à la même période)
Début 2026 / exemple : plusieurs explications YouTube reliées par cet article de comparaison de modèles fermés chinois
Seedance 2.0 de ByteDance — 2K, jusqu’à 12 entrées et génération audio en une passe — et Kling 3.0 de Kuaishou — 4K/60 ips et spécialisé dans la synchronisation labiale — sont sortis presque au même moment. Cela accentue le contraste Chine contre États-Unis, avec OpenAI et Google parmi les acteurs américains. -
« HunyuanImage 3.0 : Open Source Text To Image Model (Forget Nano Banana & Seedream 4) »
2025-09-28 / youtube.com/watch?v=32lhiZKhgOY
La vidéo rapporte que Tencent a publié un modèle d’image MoE open source de plus de 80 milliards de paramètres, présenté comme concurrentiel face aux modèles fermés Nano Banana et Seedream. -
« China's Seedream 4.0 Just Outperformed Google's Nano Banana (And It's Open Source) »
2025-09-24 / youtube.com/watch?v=3Hmj05sE1V8
Cette vidéo traite de Seedream 4.0 de ByteDance. Son titre le présente comme open source, alors que Seedream est surtout proposé par API fermée ; les informations sont contradictoires, comme précisé dans les limites. -
« Is FLUX 2.0 The New Open Source King? » / « FLUX 2 Dev Released -GGUF 16GB Vram... »
2025-11-25 à 27 / youtube.com/watch?v=YQuTkPVkCS8 , youtube.com/watch?v=yR6TYLlPP-s
Vague d’évaluations suivant l’annonce de FLUX.2, le modèle open weight de 32 milliards de paramètres de Black Forest Labs. L’utilisation possible sur des GPU grand public avec 16 Go de VRAM grâce à la quantification GGUF a particulièrement attiré l’attention. -
« LTX-2 by Lightricks: Open-Source 4K Video Generation With Audio (50 FPS) »
Vers le 2026-01-10 / youtube.com/watch?v=t5X5JR_CAv4
Présentation de LTX-2, modèle vidéo open source de Lightricks. La génération native 4K à 50 ips avec audio synchronisé, ainsi que la publication du code d’entraînement, sont décrites comme une étape majeure pour la vidéo IA open source. Le modèle a été rapidement intégré à ComfyUI, Fal et Replicate. -
« Wan2.2 AI Video Tutorial & Demo | The best open-source video generation model to date just dropped! »
2025-07-28 / youtube.com/watch?v=Tqf8OIrImPw
Tutoriel et démonstration du Wan 2.2 open source d’Alibaba, présenté comme une alternative entièrement gratuite à Runway et Pika. Des vidéos ultérieures développent des pipelines le combinant à Qwen Image et FLUX (youtube.com/watch?v=qMda40fB_m0). -
« HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model? »
2026-06-25 / youtube.com/watch?v=4GNT4-QYekg
Comparaison approfondie de deux modèles vidéo open source : HunyuanVideo 1.5 de Tencent et Wan 2.7 d’Alibaba. L’évaluation porte sur leur exécution locale et leur gratuité. -
« How To Use MiniMax H3 in ComfyUI: Best FREE AI Video Model of 2026! »
Août 2026 / youtube.com/watch?v=d_wEd-fZcdg
Procédure d’exécution locale de MiniMax H3, modèle vidéo open source issu de Hailuo AI, dans ComfyUI. L’absence d’abonnement et l’exécution entièrement sur le PC de l’utilisateur sont mises en avant. Le modèle a suscité de nombreux tutoriels dérivés sur les images clés multiples et le vidéo-à-vidéo. -
« Ideogram 4 in ComfyUI: The Best Open-Source AI Image Model for Text, Logos & Design? »
Vers le 2026-06-05 / youtube.com/watch?v=rRiQDMZTPiQ
Présentation d’Ideogram 4 dans ComfyUI. Le modèle auparavant fermé serait devenu open weight avec Ideogram 4 et est décrit comme proche des performances de la frontière fermée, en particulier pour le texte et les logos.
Signaux
- Côté fermé, la réaction « annonce puis comparaisons immédiates » est extrêmement rapide. Nano Banana Pro, Veo 3.1, Sora 2, Runway Gen-4.5, Seedance 2.0 et Kling 3.0 ont tous donné lieu à des comparaisons par plusieurs chaînes dans les jours suivant leur annonce. Des chaînes hebdomadaires comme TheAIGRID jouent un rôle de hub.
- Côté open source, l’écosystème de tutoriels autour de ComfyUI est puissant. Wan 2.2/2.7, Qwen-Image et Qwen-Image Edit, FLUX.2, LTX-2, HunyuanVideo 1.5 et MiniMax H3 sont rapidement suivis de nombreuses vidéos expliquant leur usage dans ComfyUI. Les besoins en VRAM, notamment dans les gammes 16 Go et 24 Go, sont un sujet central dans les titres et les commentaires.
- Les modèles chinois — Alibaba Wan/Qwen, Tencent Hunyuan, ByteDance Seedance/Seedream, Kuaishou Kling et MiniMax — progressent dans la génération d’images comme de vidéos, en open comme en fermé. La comparaison avec les acteurs américains — OpenAI, Google, Runway, Black Forest Labs et Lightricks — revient régulièrement.
- L’étiquette « open source » crée de la confusion. Certaines vidéos sur Seedream le qualifient d’open source alors que sa disponibilité repose surtout sur des API fermées. Toute analyse devrait vérifier les sources primaires, notamment les blogs officiels et Hugging Face.
- Sora 2 est en phase de réduction. L’application et le site autonome auraient pris fin le 2026-04-26 et l’API doit se terminer le 2026-09-24. Les vidéos de type « Sora 2 Update » prennent déjà un ton de rétrospective de fin de produit.
Limites
- Les pages de résultats et de visionnage YouTube sont rendues en JavaScript : WebFetch n’a pu récupérer que les liens de navigation du pied de page. Les noms de chaînes, nombres d’abonnés et vues n’ont donc pas pu être confirmés directement. L’analyse dépend des extraits de recherche Web, et certains éléments (#4, #6, #7, #8, #11, #12) ne permettent pas de confirmer précisément la chaîne, le nombre d’abonnés ou le nombre de vues.
- Malgré l’instruction de privilégier les mises en ligne des 60 derniers jours, de nombreuses vidéos sur les lancements majeurs — Sora 2, Nano Banana Pro, HunyuanImage 3.0, Seedream 4.0, FLUX.2 ou LTX-2 — datent de septembre 2025 à juin 2026, donc avant la période cible qui commence le 2026-07-18. Les seuls sujets plus récents observés sont MiniMax H3 en août 2026, Midjourney V8.2 devenu version par défaut le 2026-07-24, et la comparaison HunyuanVideo 1.5 contre Wan 2.7 du 2026-06-25. Aucun lancement de modèle entièrement nouveau n’a été trouvé entre juillet et septembre.
- Les commentaires des vidéos n’ont pas pu être récupérés, les pages de visionnage n’étant pas accessibles au rendu ; il n’est donc pas possible de citer directement les réactions des spectateurs.
- Nano Banana 2 reste au stade de fuite : aucune annonce officielle n’a été confirmée.
Bluesky
Bluesky — Dernières évolutions de l’IA de génération d’images et de vidéos
Comptes
- @replicate.com — Compte officiel de Replicate, société d’hébergement de modèles. Il publie chaque ajout de modèle de génération d’images ou de vidéos à son API, ouvert ou fermé, et a constitué la source la plus dense de cette recherche.
- @testingcatalog.com (🚨 AI News | TestingCatalog) — Compte d’actualité IA spécialisé dans les fuites et les nouvelles fonctionnalités. Il publie presque quotidiennement et couvre fréquemment les nouveaux modèles d’image et de vidéo.
- @simonwillison.net — Expérimentateur IA reconnu. Il évalue les nouveaux modèles avec ses tests d’images de pélicans et obtient de loin les engagements les plus élevés.
- @stabilityai.bsky.social — Compte officiel de Stability AI, créateur de Stable Diffusion. Il n’a plus publié depuis le 2025-11-19 et s’est surtout consacré aux modèles audio Stable Audio au cours de l’année écoulée ; il ne publie presque rien sur la génération d’images.
- @ai.bots.law (AI Cases Bot) — Bot publiant automatiquement les nouveaux documents déposés dans les affaires liées à l’IA, utile notamment pour suivre Disney v. Midjourney.
- @mjsrefs.bsky.social et @un1v3rse.bsky.social — Comptes artistiques publiant quotidiennement des créations Midjourney. Ils témoignent davantage de l’activité de la communauté que de l’actualité.
Publications
- Nano Banana Pro (Google) — Replicate a publié un rapport après 24 heures de tests intensifs : « pushing Nano Banana Pro to its limit ». 2025-11-21, ♥2 🔁0. link
- Gemini 3 Pro — Replicate a annoncé sa disponibilité API comme le modèle de raisonnement multimodal le plus avancé de Google. 2025-11-19, ♥2. link
- Veo 3.1 (Google DeepMind) — Replicate a publié ses résultats de test : « We've spent some time testing Veo 3.1 ». 2025-10-17, ♥3. link
- FLUX.2 [klein] 9b (Black Forest Labs) — Un modèle open weight distillé en quatre étapes a été ajouté à Replicate, avec des performances qualifiées d’excellentes. 2026-01-23, ♥1. link
- Wan 2.2 Animate (Alibaba, open source) — Une mise à jour de la fonction Replace réduit le temps d’exécution de sept minutes à moins de deux minutes. Publication accompagnée d’une vidéo intégrée. 2026-01-29, ♥2. link
- Kling 3.0 (Kuaishou) — Replicate le présente comme une génération 4K multi-plans avec audio synchronisé. 2026-02-17, ♥2. link
- Runway Gen-4.5 — Replicate annonce la création de vidéos cinématographiques impressionnantes. 2026-02-18, ♥2. link
- Seedream 4.5 (ByteDance) — Replicate met en avant sa riche connaissance du monde et une compréhension spatiale renforcée. 2025-12-03, ♥2. link
- ChatGPT Images 2.5 (OpenAI) — TestingCatalog annonce une génération d’images plus rapide, des sorties plus nettes et un contrôle d’édition plus précis ; les modèles Flare et Sunburst auraient également été ajoutés pour l’API. 2026-09-09, ♥2 🔁1. link
- Muse Video (Meta) — TestingCatalog publie un rapport exclusif d’accès anticipé, mentionnant une génération de vidéos de dix secondes de haute qualité avec audio natif et un déploiement prévu sur Instagram et Facebook. 2026-08-19, ♥2. link
- Orbis (Visko, modèle vidéo en temps réel) — TestingCatalog présente ce modèle d’une jeune pousse, qui promet de la 4K/24 ips avec des mises à jour sous la seconde et arrive premier dans un test de suivi d’invite. 2026-09-01, ♥0. link
- Création Blender réalisée avec GPT-6 Astra (Simon Willison) — Publication décrivant un flux de production : génération d’une image conceptuelle avec ChatGPT Images 2.5, puis transmission à Codex pour créer un fichier Blender. 2026-09-05, ♥405 🔁30, de très loin le plus fort engagement observé. link
- Disney v. Midjourney (procès) — AI Cases Bot publie automatiquement le dernier document déposé, Doc #195, une preuve de signification. Disney poursuit Midjourney pour violation du droit d’auteur et génération de personnages. 2026-09-16, ♥0. link
- Exemple de publication de la communauté Midjourney — Un compte personnel a publié une image générée par IA, avec ♥15 🔁5, engagement élevé parmi les publications artistiques personnelles consultées. Il ne s’agit pas d’une actualité, mais d’un indicateur de l’activité de la communauté. 2026-09-16. link
Signaux
- Le principal terrain de communication des acteurs fermés passe par les annonces d’intégration via Replicate. Google — Nano Banana Pro, Veo 3.1, Gemini 3 Pro —, OpenAI — ChatGPT Images 2.5, GPT Image 2 —, ByteDance — Seedream/Seedance —, Kuaishou — Kling —, Runway et xAI — Grok Imagine Image — ont continué à être annoncés par l’intermédiaire de Replicate presque une à deux fois par mois d’octobre 2025 à avril 2026. Les modèles vidéo chinois de ByteDance, Kuaishou et Alibaba sont particulièrement fréquents.
- L’open source est porté par Black Forest Labs avec FLUX.2 et Alibaba avec Wan 2.2, mais suscite peu de discussions organiques sur Bluesky. Stability AI, autrefois centrale, est silencieuse depuis le 2025-11-19 et sa présence dans la génération d’images open source a presque disparu sur Bluesky.
- Les litiges de droit d’auteur constituent la principale actualité négative des acteurs fermés. Disney v. Midjourney et Alcon Entertainment v. Tesla, autour d’une possible utilisation non autorisée de Blade Runner 2049, sont toujours en cours ; AI Cases Bot rapporte de nouveaux documents très fréquemment.
- Le nombre de j’aime demeure généralement modeste, de quelques unités à quelques centaines, sans l’ampleur virale observée sur Twitter ou Reddit. L’exception est Simon Willison, dont les publications de tests pratiques et de première main recueillent le plus de réactions.
- Les publications générales retrouvées par recherche sur Bluesky sont surtout des œuvres quotidiennes de comptes personnels accompagnées de #midjourney, #AIart ou #AIイラスト, et non des discussions techniques sur les modèles.
Limites
- L’API officielle de recherche de publications de Bluesky (
app.bsky.feed.searchPosts) retournait des erreurs 403 intermittentes. Les requêtes « Sora », « Nano Banana », « Flux.2 » et « Runway AI » échouaient souvent, tandis que « Midjourney » n’a fonctionné qu’une fois. L’analyse a donc privilégié les flux de comptes connus, tels que Replicate, TestingCatalog, Stability AI et Simon Willison. - bsky.app est rendu en JavaScript : WebFetch ne permettait pas de récupérer le contenu des publications directement sur les pages et l’analyse s’est limitée aux API publiques.
- Les recherches ciblées sur Wan 2.2, FLUX.2 et d’autres modèles n’ayant pas été utilisables de façon stable, le volume réel de discussions organiques sur l’ensemble de Bluesky n’a pas pu être mesuré.
- Des modèles open source importants comme Qwen-Image, HunyuanImage et Ideogram n’ont pas donné lieu à des publications vérifiables pendant le temps imparti ; ils ont donc été exclus du rapport.
- Les comptes Bluesky japonais liés à la génération d’images, notamment gigazine.net et aitry.bsky.social, ont été examinés, sans publication récente pertinente.
Lemmy
Lemmy — Dernières actualités de l’IA de génération d’images et de vidéos
Communautés
- !«メールアドレス» — 5,711 abonnés. Créée en 2023, elle constitue le principal lieu de discussion sur la génération d’images par IA sur Lemmy.
- !«メールアドレス» — 2,361 abonnés. Dédiée surtout aux œuvres. Le bot Even_Adder y republie presque quotidiennement les nouveaux modèles et LoRA de Hugging Face et GitHub, ce qui en fait de fait un fil d’actualité pour les modèles open source d’image et de vidéo.
- !«メールアドレス» (50 abonnés), !«メールアドレス» (104 abonnés), !«メールアドレス» (52 abonnés), !«メールアドレス» (97 abonnés) — Petites communautés spécialisées par thème.
- !«メールアドレス» — 51 abonnés. Communauté automatisée qui reflète les flux RSS de Reddit, notamment /r/ArtificialInteligence.
- !«メールアドレス», ainsi que les communautés généralistes fédérées de lemmy.zip, lemmy.today, awful.systems (!techtakes) et lemmy.bestiver.se (!hackernews) — les nouvelles concernant les entreprises à code source fermé s’y concentrent presque toutes. Les abonnements sont répartis entre instances et n’ont pas pu être additionnés de façon fiable.
- !«メールアドレス» (reflétée notamment sur piefed.social) — Communauté explicitement anti-IA, utile pour apprécier le niveau de rejet envers l’IA générative.
Publications
Open source
- Série de publications sur les outils dérivés de MiniMax H3 (2026-09-08 à 09-13, !«メールアドレス», auteur Even_Adder)
circlestone-labs/MiniMax-H3-Image-Training-Adapter(score 5, 2026-09-12) https://lemmy.dbzer0.com/post/75382765Speach1sdef178/ComfyUI-VDN-H3-24GB(implémentation accélérée pour 24 Go de VRAM, score 6, 2026-09-12) https://lemmy.dbzer0.com/post/75382764F16/krea2-turbo-sda(score 2, 2026-09-10) etlvladikov/Krea2-Turbo-Distill-4step-LoRA(score 2, 2026-09-08) https://lemmy.dbzer0.com/post/75284619 / https://lemmy.dbzer0.com/post/75150626- MiniMax H3 est un modèle vidéo open weight de 33 milliards de paramètres, annoncé le 2026-07-31 en API limitée puis dont les poids ont été publiés sur Hugging Face le 08-03. Il produit de la 2K/24 ips, jusqu’à 15 secondes, avec génération audio simultanée, et se classe premier en édition vidéo chez Artificial Analysis. La succession de publications sur Lemmy montre que son écosystème d’outils est resté actif en septembre.
Lightricks/LTX-2.5-22b-IC-LoRA-Ingredients(score 3, 2026-09-12, !stable_diffusion) https://lemmy.dbzer0.com/post/75382763 — LoRA de contrôle par image de référence pour le modèle vidéo ouvert LTX de Lightricks. Une publication miroir existe également sur lemmy.world : https://lemmy.world/post/51841873.- Présentation de l’article « Uncertainty DMD » (SIGGRAPH Asia 2026, score 3, 2026-09-12, !stable_diffusion) https://lemmy.dbzer0.com/post/75382766 — Recherche sur la restauration de diversité dans la génération vidéo autorégressive en peu d’étapes.
- Publications quotidiennes d’œuvres sur !stable_diffusion_art (2026-09-11 à 09-16, scores de 1 à 21) ; exemples : « Watch at the Burning Falls » (score 16, 09-15) https://lemmy.dbzer0.com/post/75490978 et « Shining Bay Steps » (score 21, 09-13) https://lemmy.dbzer0.com/post/75414322. Les descriptions indiquent un recours fréquent aux modèles Krea2 et Flux.
Code source fermé
- Midjourney se réoriente de la génération d’images IA vers un « spa médical de scan corporel » (score 66/DL3, 10 commentaires, vers le 2026-06-18, !technology, article de The Register) https://lemmy.zip/post/66397234 — L’entreprise aurait lancé un service de diagnostic par scan corporel sous « lumière dorée », sans autorisation FDA. Les commentaires le comparent fortement à Theranos. Publication miroir : https://lemmy.bestiver.se/post/1175129
- Midjourney exige que les grands studios d’Hollywood révèlent leur utilisation de l’IA (score 76/DL2, 2 commentaires, 2026-07-05, !technology, article TechCrunch) https://lemmy.today/post/56011946 — Dans le contexte des litiges avec les studios, Midjourney réclame des informations sur leur propre usage de l’IA.
- OpenAI ferme de fait Sora (plusieurs publications, 2026-03 à 05)
- « How OpenAI scrapping Sora video-generation app points to one of the biggest problems facing technology companies » (score 2, !openai) https://lemmy.world/post/45568787
- « Sora losing $1 million daily » (score 1, 2026-03-30, !kotaku) https://ibbit.at/post/214890 — Le déficit quotidien d’un million de dollars est présenté comme l’une des raisons de la fermeture.
- « OpenAI shutting down Sora just killed a $30M AI movie » (score 1, 2026-05-27, !ai_reddit) https://lemmy.durstig.online/post/34669 — Un projet de film IA de 30 millions de dollars en cours sur Sora aurait été affecté.
- Adobe ajoute un chatbot IA et de l’audio génératif Firefly à Photoshop/Premiere (score 22, 2025-10-29, !boycottus) https://alternativeto.net/news/2025/10/adobe-adds-ai-chatbots-to-photoshop-premiere-ai-masking-and-generative-audio-in-firefly/ — Information plus ancienne, mais encore mentionnée dans le contexte de l’intégration des outils IA directement dans les applications fermées.
Signaux
- Les communautés Lemmy liées à l’IA générative sont presque exclusivement orientées open source. Le centre de gravité se situe autour de !stable_diffusion sur lemmy.dbzer0.com, avec des œuvres quotidiennes et des republications automatisées de modèles et de LoRA depuis Hugging Face et GitHub par Even_Adder.
- Sur la seule période du 09-08 au 09-16, les outils dérivés de MiniMax H3 se succèdent, ce qui en fait le principal sujet d’intérêt pour les modèles vidéo open source. Les LoRA d’accélération autour de Krea2 Turbo sont également actives.
- Les acteurs fermés, notamment OpenAI, Midjourney, Adobe, Google et xAI, sont presque absents de Lemmy. Lorsqu’ils apparaissent dans les communautés généralistes, à raison d’un ou deux sujets par mois, il s’agit davantage d’échecs, de polémiques et de procès que d’annonces de fonctionnalités : fermeture de fait de Sora, virage médical de Midjourney et conflit judiciaire avec Hollywood.
- Le rejet de l’IA générative est fort sur Lemmy : une communauté anti-IA distincte, !fuck_ai, existe, et plusieurs témoignages font état de bannissements après des publications liées à l’IA dans d’autres communautés.
Limites
- Lemmy reste une petite plateforme : même ses principales communautés liées à l’IA ne comptent que quelques milliers d’abonnés. Elle n’a ni la réactivité ni la couverture de Reddit ou X.
- L’API de recherche retournait par intermittence des erreurs 503/500. Des requêtes comme Midjourney, « Nano Banana », « Veo 3 » OR « Sora 2 » et les recherches directes dans !stable_diffusion_art ont échoué ou nécessité plusieurs tentatives.
- Aucune publication mentionnant directement Nano Banana, Seedream, Grok Imagine, Kling ou Veo 3.1 n’a été trouvée. Les seuls résultats relevaient de sites externes de présentation d’outils IA, ce qui suggère que ces sujets circulent très peu sur Lemmy.
- Une publication pointait vers un article néerlandais affirmant qu’Elon Musk/xAI avait réalisé un film IA de l’Odyssée avec Grok Imagine, mais le contenu de ad.nl n’a pas pu être récupéré et vérifié ; l’information a donc été exclue du corps du rapport.
- Le critère d’environ 20 publications analysées par réseau social n’est pas atteint. Plus de dix éléments open source ont été vérifiés, mais les mentions directes du côté fermé ne sont que de l’ordre de cinq à six, ce qui reflète la petite taille de la plateforme.
Pinterest — Actualités de l’IA de génération d’images et de vidéos
Les 50 épingles recueillies avec l’unique requête « Image and Video Generation AI News » sont présentées sans catégorisation (output/pinterest.pins.md). Elles ont toutes été inspectées visuellement ; voici les résultats.
Thèmes visuels
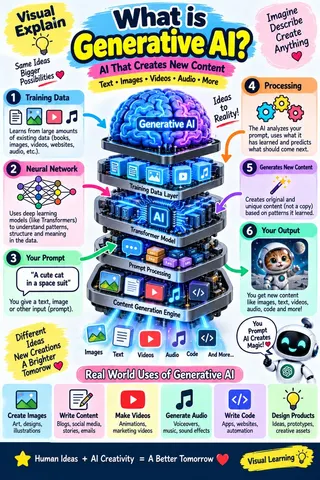
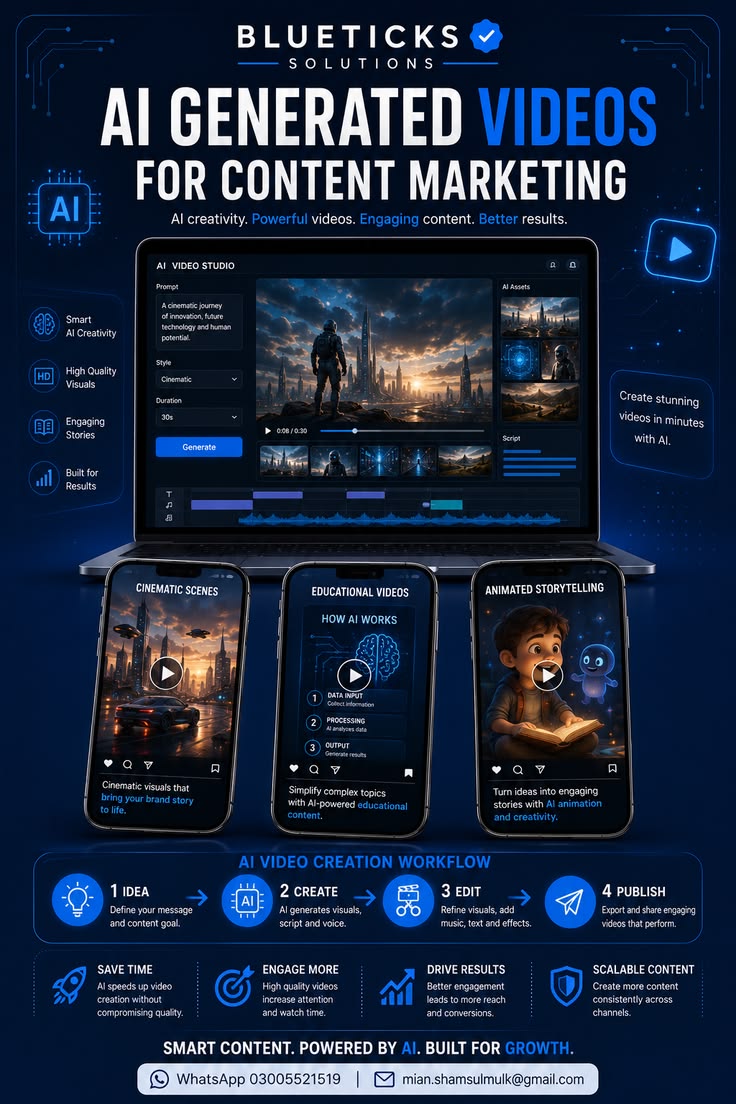
- Les arrière-plans techno de science-fiction sombres et néon dominent largement — Des fonds bleu marine ou noirs, des circuits bleu-violet lumineux, des hologrammes et le mot « AI » en lettrage lumineux couvrent presque la moitié des épingles
[1, 3, 4, 7, 13, 14, 17, 23, 24, 25, 26, 27, 32, 34, 37, 38, 40, 42, 44, 46, 50]. - Les visages d’androïdes ou de cyborgs blancs anthropomorphisés sont répétés comme symbole de l’IA — Robot présentateur en costume derrière un bureau
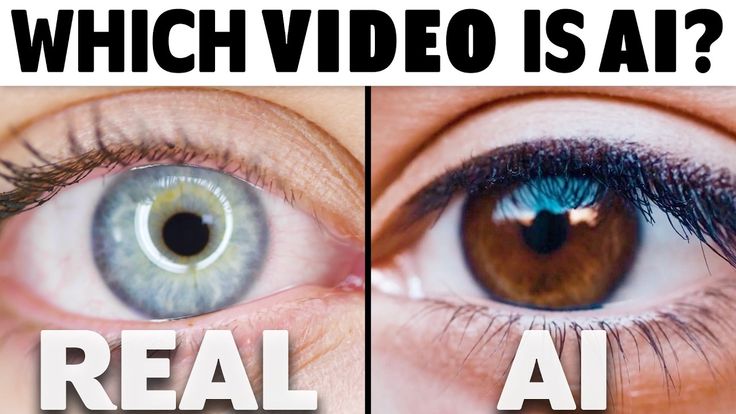
[27], androïdes féminins en gros plan de profil[32, 37], robot pensif[26]et robot regardant un téléphone[3]: le visuel d’une IA humaine est devenu un modèle graphique. - Le format quiz « lequel est généré par IA ? » est récurrent — Comparaison A/B de paysages de montagne
[11], gros plan d’œil REAL contre AI[35]et photo de chat accompagnée d’un tampon « FAKE »[3]. - De nombreuses vidéos d’actualité IA sous forme de miniatures YouTube sont reprises telles quelles — Hommes barbus au visage surpris ou déconcerté avec logos d’OpenAI, Google, Microsoft, Meta, Anthropic et Notion
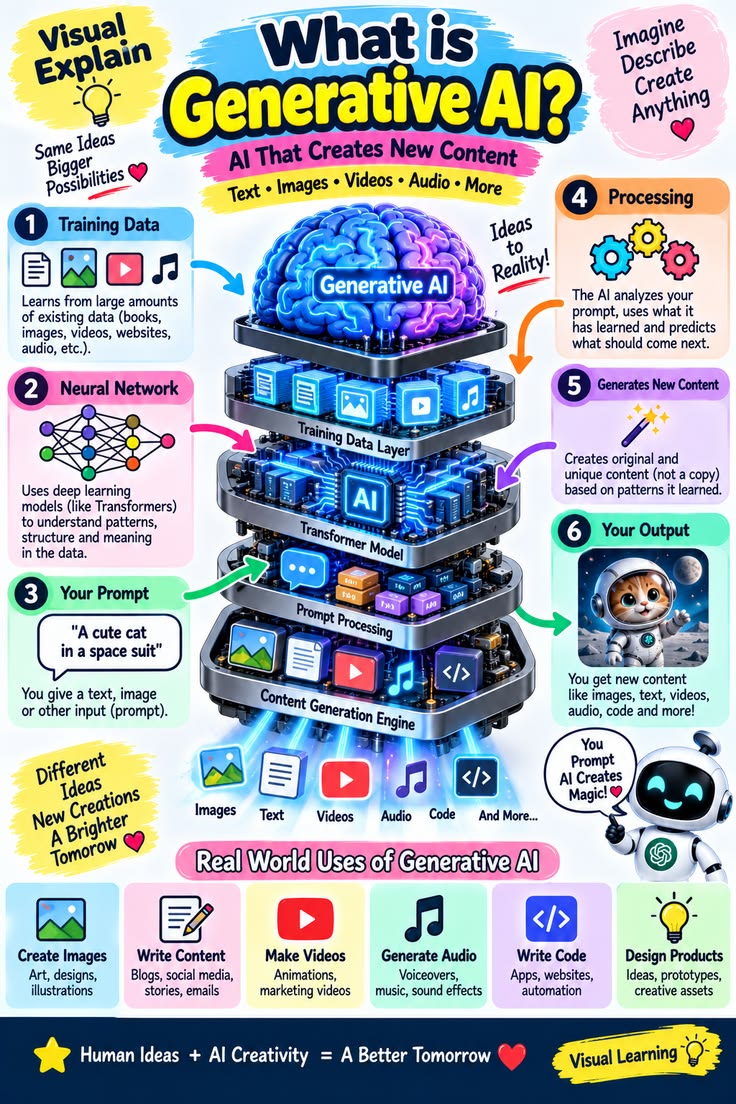
[4, 18, 41], titres dramatiques comme « MIND BLOWING AI NEWS » et « TOP 5 AI NEWS »[19, 40]. Il s’agit souvent de miniatures de vidéos YouTube repostées, non de contenus Pinterest originaux. - Infographies de classement des outils IA recommandés — Un même classement Runway, Pika, Kling AI, Luma/Dream Machine, Canva et Hailuo aux places 1 à 6 apparaît en double
[9, 28]. On trouve aussi un grand tableau de 20 outils payants par fonction — texte-vers-vidéo, image-vers-vidéo, édition, audio, ressources et publication —[36], ainsi qu’un tableau opposant outils payants et gratuits[12]. - Vitrines de contenus effectivement générés — Une promotion Google Veo 2 présentant une femme en imperméable jaune, un chien nageant dans une piscine, un flamant rose et une jeune fille de style animé est dupliquée presque à l’identique
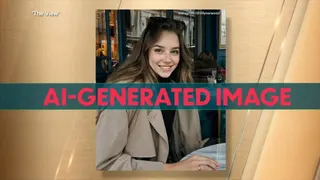
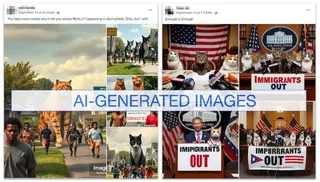
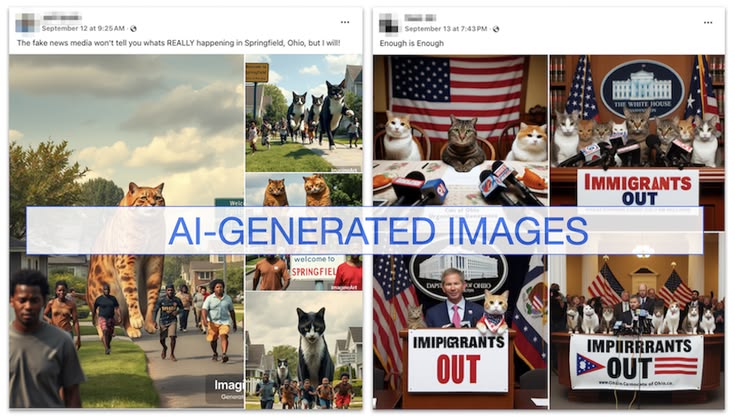
[6, 8]. S’y ajoutent une démonstration de génération interactive en temps réel de Vidu S1[39]et une démo de transformation d’une vidéo de personne en blocs de bois, origami, Lego et fleurs[10]. - Visuels alertant sur les faux et la désinformation — Capture Facebook portant la mention « AI-GENERATED IMAGES » avec un chat géant à Springfield et un montage d’une manifestation anti-immigration utilisant des chats
[45]. On retrouve aussi un indicateur audio « 97% likely AI generated »[37]et des infographies avantages/inconvénients[26]. - Références à des présentateurs synthétiques et à des acteurs IA — Capture de Hollywood Reporter au sujet de l’actrice IA Tilly Norwood dans l’émission télévisée The View
[2], publicité de type direct pour un présentateur synthétique de Wondershare Virbo[22], et publicité pour un outil de création de chaînes d’actualité avec synchronisation labiale IA[48].
Épingles notables
[10](sans titre) — Grille transformant une vidéo de personne en blocs de bois, origami, Lego et fleurs. Sa démonstration de transformation cohérente d’une même vidéo en plusieurs matériaux a un fort impact visuel.[45]AI creations give life to harmful Springfield,... — Présentation à visée d’alerte d’images de chat géant et de manifestations anti-immigration générées par IA, rappelant la désinformation de 2024 autour de Springfield et des chats.[2]Hollywood Reporter Interviews the First AI Actress... — Capture d’écran de la discussion de l’actrice IA Tilly Norwood dans une émission nationale, signe que le sujet des talents IA a gagné l’actualité grand public.[39]ShengShu Technology Unveils Vidu S1... — Visuel promotionnel d’un modèle chinois promettant une génération interactive en temps réel. Il rappelle que le paysage des modèles fermés ne se limite pas aux entreprises américaines.[47]Transform your ideas into stunning visuals! — Œuvre IA photoréaliste montrant une statue de marbre jouant du violoncelle, illustration d’un haut niveau de réalisme visuel.[36]AI Tools for Video Editing — Grande infographie récapitulant 20 outils pour la génération, l’édition, l’audio et la publication ; utile pour appréhender la pile d’outils actuelle.[31]Today's AI News (May 20 2026) — Infographie d’actualité sur Google I/O 2026, avec Gemini 3.5 Flash/Omni, lunettes IA et fonctionnalités d’accessibilité d’Apple.[33]This Week in AI News - Aug 15 2026 — Mise en page rétro de journal accumulant des expressions comme Sovereign AI et Agent Harness. Les titres manquent de précision et illustrent la standardisation et le gonflement des contenus d’actualité IA.[6]/[8]Promotion Veo 2, presque dupliquée — Les exemples du modèle vidéo de Google, avec chien nageur, flamant rose et jeune fille animée, sont régulièrement repartagés sur Pinterest.[9]/[28]« Best AI Video Generation Websites », presque le même modèle — Le classement Runway/Pika/Kling AI/Luma/Canva/Hailuo semble réemployé, ce qui suggère une forte présence de listes affiliées sur Pinterest.
Signaux
- Les annonces et comparatifs d’outils fermés — Google Veo 2/3, Gemini, OpenAI, Nvidia et Vidu/ShengShu — constituent la majorité des épingles. Pinterest semble particulièrement orienté vers la recherche pratique d’outils et de modes d’emploi.
- L’open source est presque absent : Stable Video Diffusion n’apparaît qu’une fois dans le grand tableau d’outils
[36]. L’ambiance des communautés de génération locale et open source autour de Wan, HunyuanVideo et ComfyUI, visible sur Reddit et X, n’est pratiquement pas présente sur Pinterest. - Les formats « vrai ou généré par IA ? »
[3, 11, 35], les alertes contre la désinformation[45]et la détection audio[37]montrent une certaine défiance et un intérêt pour la culture critique, pas seulement une célébration de l’IA. - L’intérêt pour les présentateurs, talents et acteurs synthétiques — Tilly Norwood, présentateur Virbo et outils de synchronisation labiale IA — apparaît dans plusieurs épingles. Le contenu vidéo sans interprète humain semble devenir un mot-clé tendance.
- Les quasi-duplications d’infographies, comme la promotion Veo 2
[6][8]et le classement d’outils[9][28], imposent de lire les résultats avec prudence : les repins et les modèles réutilisés amplifient probablement des contenus produits pour le référencement. - Aucun contenu japonais ou lié au Japon n’a été observé : l’échantillon semble entièrement issu du monde anglophone, principalement américain.
Limites
- Le collecteur a regroupé 50 éléments à partir d’une seule requête, sans les classer par genre, par exemple entre open source et fermé. Cette section ne peut donc pas reprendre la structure par catégories prévue dans le guide de collecte ; elle présente l’ensemble à plat.
- Environ huit épingles ont des titres vides ou très pauvres, parfois seulement « AI »
[6, 11, 15, 19, 31(qui reste globalement lisible), 38, 46]. Certaines interprétations reposent donc seulement sur l’image. - Les pages Pinterest individuelles n’ont pas été ouvertes pour vérifier le nombre d’enregistrements, les commentaires ou les articles liés. Les métriques d’engagement et la fiabilité des URLs sources n’ont pas été vérifiées.
- Aucune recherche directe dans le navigateur n’a été effectuée : seules les images déjà collectées par le collecteur ont été utilisées, conformément aux instructions du guide.
Actions recommandées
- Lors de la nouvelle collecte sur X, privilégier des recherches thématiques — Nano Banana, Seedance, Wan 2.2, Sora, etc. — au lieu de s’appuyer sur la liste de tendances.
- Continuer à suivre les flux stableDiffusion de Lemmy comme indicateur avancé des modèles vidéo open source.
- Suivre l’annonce officielle de Nano Banana 2 et la fin de l’API de Sora 2 le 2026-09-24 comme points de bascule pour les acteurs fermés.
- Surveiller les procès en cours, dont Disney v. Midjourney, comme facteurs susceptibles d’influencer l’évolution des stratégies des entreprises à code source fermé.
- Utiliser plusieurs requêtes thématiques lors de nouvelles collectes Reddit et Pinterest afin d’atteindre le critère de 20 éléments analysés.
- Vérifier la réalité des modèles se présentant comme open source auprès de sources primaires telles que Hugging Face avant toute citation.
Images collectées














Note sur la qualité des données
La recherche sur X, dépendante de la liste de tendances, a abouti à pratiquement zéro publication liée à la génération d’images ou de vidéos par IA. Reddit, avec 11 éléments, Pinterest, avec 50 éléments issus d’une seule requête, et le versant fermé de Lemmy, avec cinq à six éléments, n’ont pas non plus atteint le critère de 20 analyses. YouTube comportait peu de nouvelles annonces au cours des 60 derniers jours, et Bluesky a dépendu des flux de comptes connus en raison de problèmes avec l’API de recherche.